핵심 요약
- TradingAgents는 LLM 에이전트 12개가 증권사 회의를 흉내 내 매수·매도 의견을 내는 오픈소스입니다. 필자가 v0.7.1을 설치해 ChatGPT 요금제 로그인으로 돌려 보니 API 키 없이 돌아갔고, 한 종목에 NVDA 226초, 삼성전자 196초가 걸렸습니다.
- 삼성전자(005930.KS)는 재무제표 없이 결론이 났습니다. 손익계산서, 재무상태표, 현금흐름표, 기업 개요, 내부자 거래가 모두 "보류(withheld)"로 돌아왔습니다. 데이터 공급원(야후 파이낸스)이 공시일을 주지 않거나 현재 시점 값만 줘서 분석일 이후 정보가 섞이지 않는다고 보장할 수 없다는 이유였고, 도구가 낸 최종 등급은 비중 축소(Underweight)였습니다. 시세 입력이 같은 11월 3일 분석일로 다시 돌려도 등급은 같았습니다.
- 분석 날짜를 최신 거래일로 잡으면 데이터가 어긋납니다. 미국 장중에 돌린 NVDA는 장중 가격을 "종가"로 썼습니다. 삼성전자는 야후에 11월 4일 시세가 아직 없었는데, 도구가 빈 날짜를 "거래일 아님"으로 표시했고 시장 분석가도 그대로 적었습니다. 네이버 증권에는 그날 3,482만 주가 거래된 기록이 있습니다.
- "한국어로 써라"는 지시도 매번 지켜지지는 않았습니다. NVDA의 펀더멘털 보고서 하나가 몽골어로 나왔습니다. 분석일을 11월 3일로 바꿔 NVDA를 두 번 더 돌리니 최종 등급은 두 번 다 보유(Hold)로 같았지만 감성 점수 같은 세부는 달랐습니다.
- 연구용 도구로 보는 편이 맞습니다. 논문의 3개월 백테스트는 단순 보유를 크게 앞섰지만, 다른 연구진이 1년으로 다시 돌린 실험에서는 비용을 빼자 단순 보유보다 낮아졌습니다. README도 투자 조언이 아니라고 적고 있습니다.
목차
- TradingAgents란: LLM 에이전트 12개가 증권사 회의를 흉내 낸다
- 설치와 ChatGPT 요금제 로그인
- NVDA를 돌려 보니: 226초, 도구 호출 26번
- 같은 설정으로 두 번 더 돌리면
- 한국어로 시켰는데 몽골어 보고서가 나왔다
- 삼성전자는 재무제표 없이 판단했다
- 분석 날짜를 최신 거래일로 두면 생기는 일
- 논문의 수익률과 반론
- 직접 돌려 볼 때 챙길 것
- 출처
TradingAgents란: LLM 에이전트 12개가 증권사 회의를 흉내 낸다
TradingAgents는 LLM에 애널리스트, 연구원, 트레이더, 리스크 관리자 역할을 나눠 맡겨 한 종목의 매매 의견을 내게 하는 멀티 에이전트 프레임워크입니다. UCLA와 MIT 연구진이 2024년 12월 arXiv에 논문 "TradingAgents: Multi-Agents LLM Financial Trading Framework"를 올렸고(arXiv 2412.20138), 코드는 Tauric Research의 GitHub 저장소에 Apache-2.0 라이선스로 공개돼 있습니다(TradingAgents GitHub). 2026년 11월 5일 GitHub API로 확인한 별은 12만 570개, 최신 릴리스는 10월 27일의 v0.7.1입니다(GitHub API).
회의는 다섯 단계로 흘러갑니다. 시장(기술적 지표), 감성(뉴스·StockTwits·Reddit), 뉴스·거시, 펀더멘털 분석가 4명이 동시에 보고서를 쓰고, 강세·약세 연구원이 그 보고서를 두고 토론하면 연구 매니저가 방향을 정합니다. 트레이더가 진입가와 손절가를 담은 계획을 내면 공격·중립·보수 리스크 분석가 3명이 다시 토론하고, 마지막으로 포트폴리오 매니저가 등급을 매깁니다. 실행 화면의 "Agents: 0/12"가 이 12개 역할입니다. 프레임워크는 LangGraph로 만들어졌습니다.
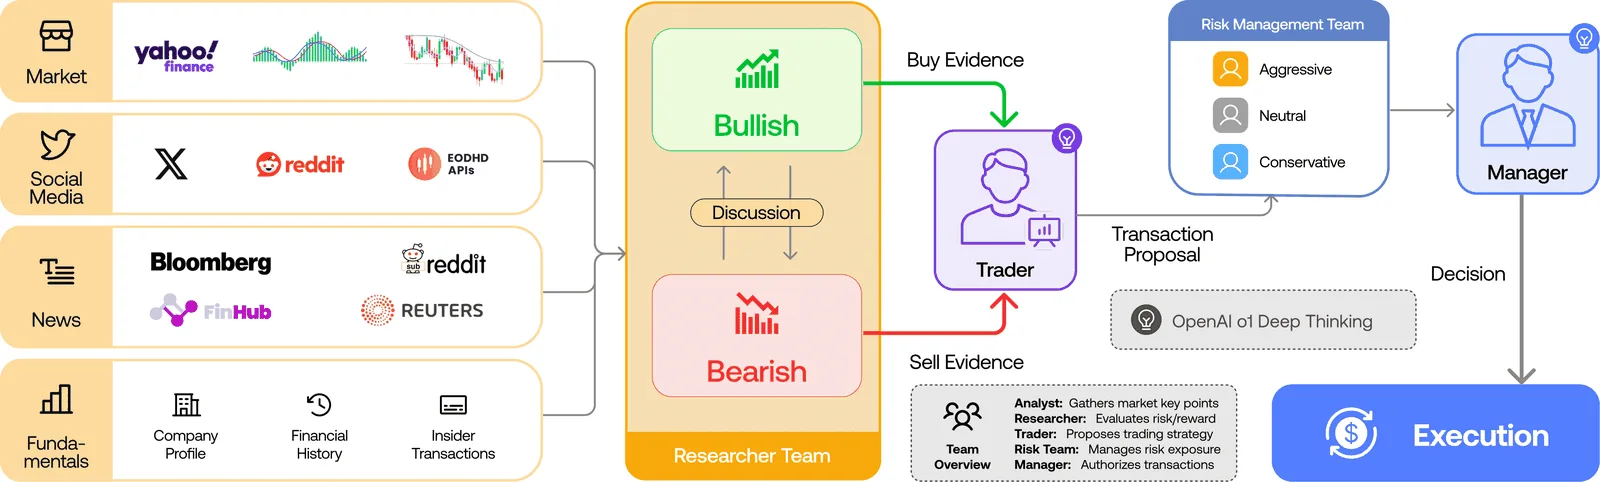
README는 프레임워크 소개 첫머리에서 이 프레임워크가 연구용이며 결과가 모델, 온도, 기간, 데이터 품질 같은 비결정적 요인에 따라 달라질 수 있고 투자 조언이 아니라고 밝힙니다. 이 글도 같은 전제로 읽어 주세요. 필자의 실행 결과는 도구가 어떻게 움직이는지 보여 주는 기록이지 매매 추천이 아닙니다.
설치와 ChatGPT 요금제 로그인
설치는 Python 3.11 이상 가상 환경에 저장소를 받아 pip install . 한 줄이면 끝납니다. 필자는 uv로 Python 3.13 환경을 만들었습니다. 비용 면에서 가장 눈에 띄는 변화는 10월 16일 나온 v0.7.0의 chatgpt 공급자입니다. API 키 대신 ChatGPT Plus·Pro 요금제로 로그인해 돌릴 수 있고(CHANGELOG), 실행은 요금제 사용 한도에 포함됩니다(README).
git clone https://github.com/TauricResearch/TradingAgents.git
cd TradingAgents
uv venv --python 3.13 && uv pip install .
.venv/bin/tradingagents login chatgpt   # 브라우저에서 ChatGPT 로그인
login chatgpt를 실행하면 OpenAI 로그인 주소가 나오고, 브라우저에서 승인하면 이 컴퓨터의 127.0.0.1:1455로 돌아와 로그인이 끝납니다. 필자는 처음에 주소를 열지 않고 두었다가 시간 초과로 한 번 실패했습니다. 로그인 뒤 요금제가 제공하는 모델은 GPT-6.1 Sol, GPT-6 Sol, GPT-6 Luna 등 8개가 목록으로 나왔습니다. 기본값은 깊이 생각하는 매니저 단계에 gpt-6-sol, 빠르게 처리하는 나머지 단계에 gpt-6-luna입니다.
새 터미널에서 가상 환경을 켜지 않으면 설치한 패키지를 못 찾는 오류가 나기 쉽다는 국내 설치 글의 주의처럼(깜희IT정보꾼 네이버 블로그), 필자는 경로를 직접 적었습니다. 대화형 화면 대신 플래그와 환경 변수로 질문을 모두 건너뛸 수 있습니다. 필자가 쓴 설정은 아래와 같습니다. 출력 언어는 한국어, 토론과 리스크 토론은 기본값인 1라운드, 분석가는 4명 전부입니다.
export TRADINGAGENTS_LLM_PROVIDER=chatgpt
export TRADINGAGENTS_QUICK_THINK_LLM=gpt-6-luna TRADINGAGENTS_DEEP_THINK_LLM=gpt-6-sol
export TRADINGAGENTS_OUTPUT_LANGUAGE=Korean
export TRADINGAGENTS_MAX_DEBATE_ROUNDS=1 TRADINGAGENTS_MAX_RISK_ROUNDS=1
# 필자가 쓴 날짜 그대로다. 왜 피해야 하는지는 뒤에 적었다
.venv/bin/tradingagents --ticker NVDA --date 2026-11-04 \
  --analysts market,social,news,fundamentals --save --show --html
거시 지표는 FRED API 키가 있어야 받아 옵니다. 필자는 키 없이 돌렸고, 뉴스 분석가가 부른 거시 지표 조회 6번은 전부 "DATA_UNAVAILABLE"로 돌아왔습니다. 키는 FRED 사이트에서 무료로 받을 수 있다고 오류 메시지가 안내합니다. 다만 도구에 기본으로 등록된 지표는 미국과 유로 지역뿐이어서 기본 별칭으로는 한국 금리·물가를 받을 수 없습니다(fred.py). 미국 밖 종목의 거시 근거가 비는 문제는 GitHub 이슈로도 올라와 있습니다(이슈 #1355).
NVDA를 돌려 보니: 226초, 도구 호출 26번
NVDA 한 종목 분석은 226초 걸렸고, 끝나기 약 15초 전 화면 기준으로 LLM 호출 16번, 도구 호출 26번, 입력 토큰 약 10만 3천 개가 쓰였습니다. 분석가 4명은 병렬로 돌아 시장 49.55초, 감성 47.76초, 뉴스 45.51초, 펀더멘털 67.65초가 걸렸습니다. 나머지 2분 남짓은 토론과 결정 단계입니다. ChatGPT 요금제로 돌렸기 때문에 따로 청구된 금액은 없습니다. 논문은 예측 한 번에 LLM 호출 약 11번과 도구 호출 20번 이상이 필요해 백테스트 기간을 짧게 잡았다고 적었는데(arXiv 2412.20138), 필자가 본 호출 수도 같은 자릿수입니다. 논문 구조를 Claude 요금제로 다시 구현한 국내 후기는 분석 한 번에 보통 10~20분이 걸렸다고 적었으니(퍼플앤트 네이버 블로그), 구현과 모델에 따라 시간 차이가 큽니다.
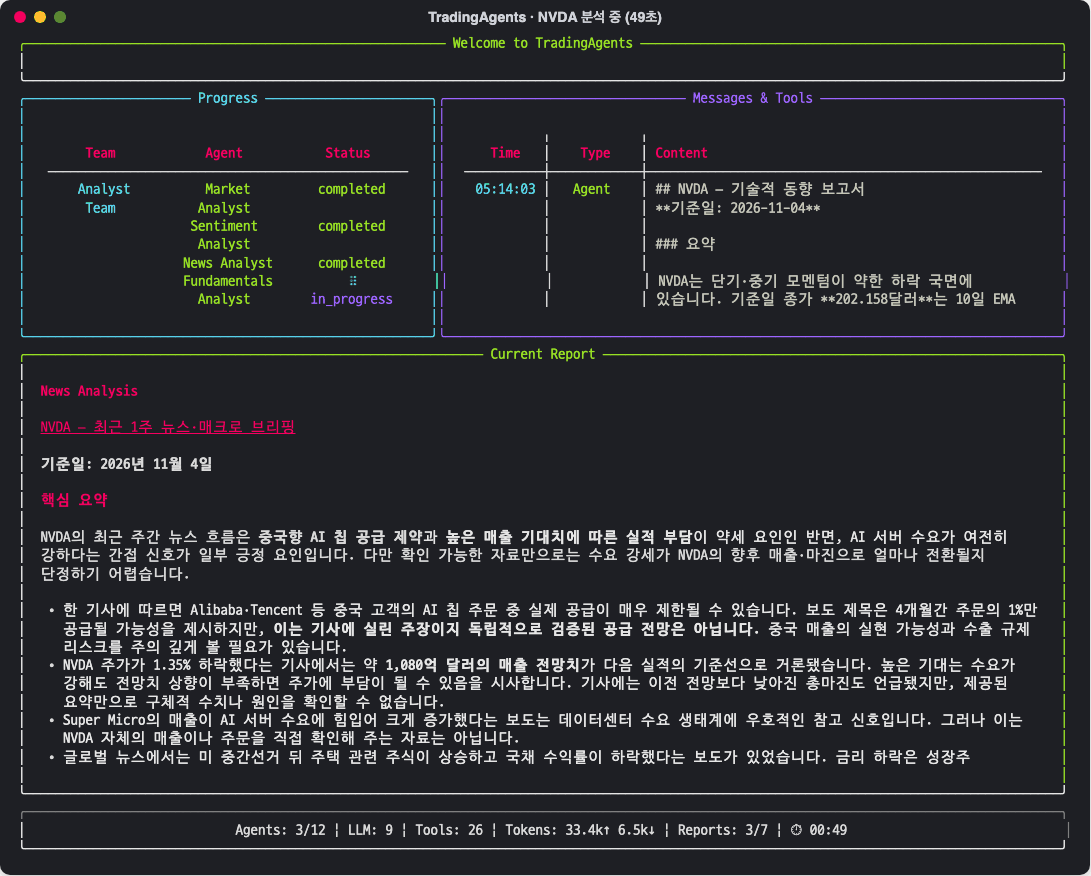
도구 호출 26번의 내역도 볼 만합니다. 기술적 지표 8번, 거시 지표 6번, 예측시장 배당률 3번, 재무제표·뉴스·주가 같은 나머지가 1번씩입니다. 예측시장(Polymarket) 3번과 내부자 거래 1번, 기업 개요 1번은 "보류"로 돌아왔습니다. Polymarket은 지금 열린 시장의 배당률만 주므로 과거 날짜 분석에 넣으면 그 뒤의 정보가 섞인다는 이유였습니다. v0.4.0부터 고쳐 오다 v0.5.0에서 모든 날짜 경로로 넓힌 "그 날짜에 알 수 있던 정보만 쓴다(point-in-time)" 원칙이 이렇게 동작합니다.
감성 분석가는 NVDA를 "혼조(Mixed), 4.8/10"으로 봤습니다. StockTwits 30건 가운데 강세 표시 12건, 약세 11건, 무표시 7건이었다고 적었습니다. 다만 받아 온 뉴스 헤드라인 20개 가운데 대부분은 NVDA와 무관하다고 스스로 지적했고, 실제로 포드의 3분기 판매 기사 같은 것이 섞여 있었습니다.
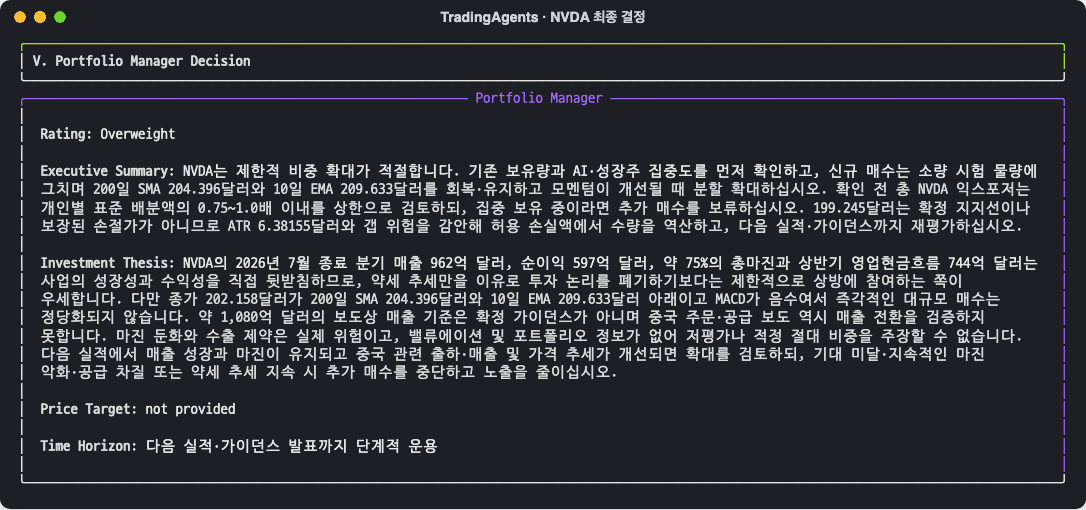
강세·약세 연구원의 토론은 같은 숫자를 다르게 읽는 식으로 진행됐습니다. 강세 쪽은 2026년 7월 말로 끝난 분기 매출 962억 달러, 순이익 597억 달러, 약 75%의 매출총이익률을 근거로 들었고, 약세 쪽은 "강한 실적은 사업의 질을 보여주지만 주식의 안전마진까지 증명하지는 않는다"고 받아쳤습니다. 이 재무 수치는 펀더멘털 분석가가 SEC 공시(EDGAR)에서 받아 온 값을 에이전트들이 인용한 것입니다.
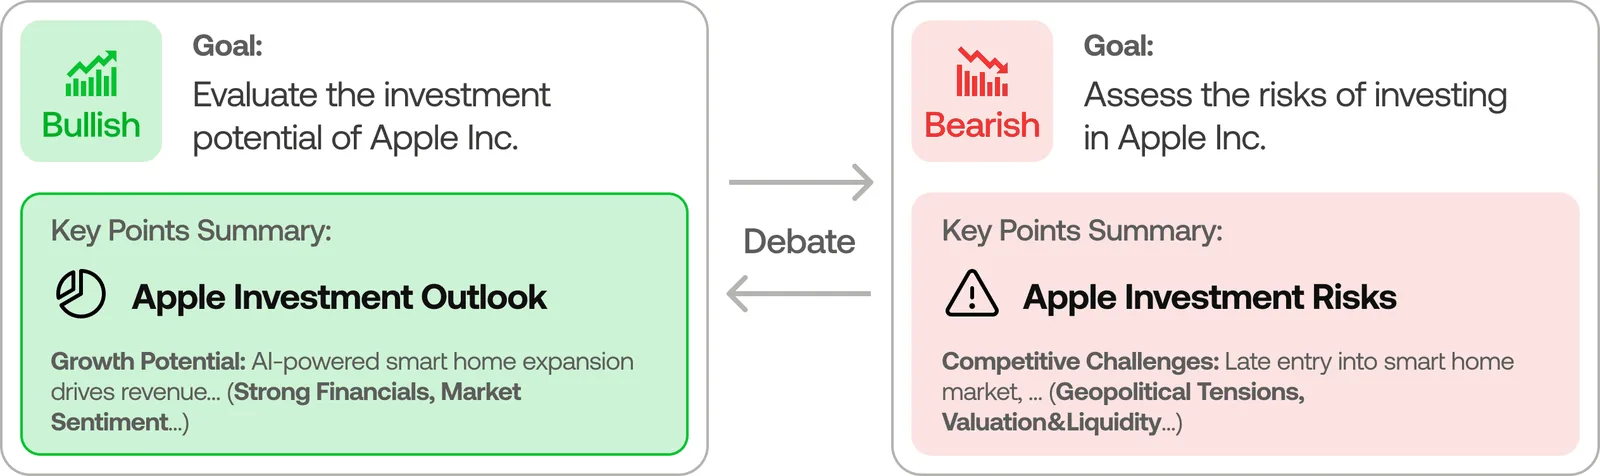
연구 매니저는 제한적 비중 확대(Overweight)이며 공격적인 매수는 아니라고 정리했고, 트레이더는 매수(Buy) 계획에 진입가 209.633달러, 손절가 199.245달러, 표준 배분의 0.75~1.0배를 상한으로 적었습니다. 진입가는 10일 지수이동평균, 손절가는 볼린저 밴드 하단 값입니다.
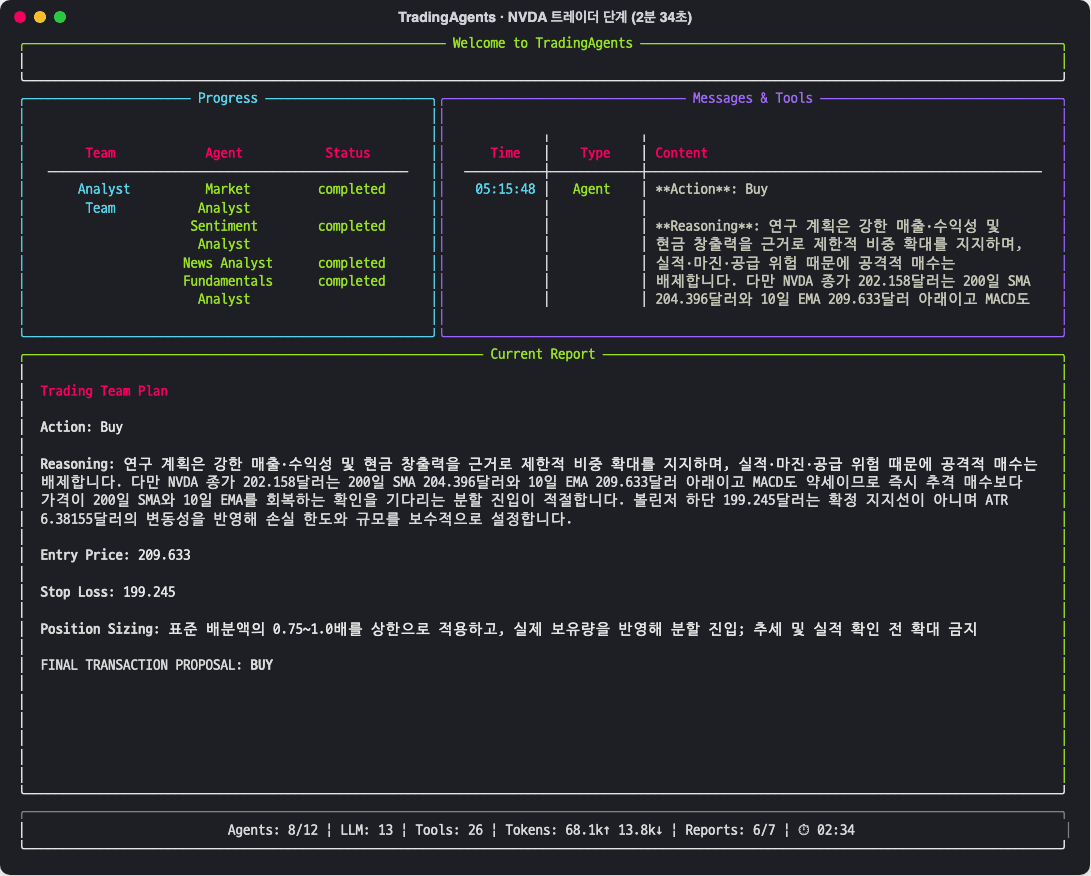
리스크 토론에서 공격 분석가는 확인을 모두 기다리면 초기 반등을 놓칠 수 있다고, 보수 분석가는 아직 추세 회복이 확인되지 않았다고 맞섰고, 중립 분석가는 소량 분할 매수를 제안했습니다. 포트폴리오 매니저의 최종 등급은 비중 확대(Overweight)였고 목표가는 내지 않았습니다.
같은 설정으로 두 번 더 돌리면
분석일을 장이 끝난 11월 3일로 바꿔 NVDA를 두 번 더 돌렸더니, 두 번 모두 보유(Hold)가 나왔습니다. 두 실행은 결정 기록(메모리) 파일을 따로 써서 앞 실행의 결론이 뒤 실행에 참고 자료로 들어가지 않게 했습니다. 걸린 시간은 213초와 218초였습니다.
| 항목 | 첫 번째 | 두 번째 |
|---|---|---|
| 연구 매니저·트레이더·포트폴리오 매니저 | 보유(Hold) | 보유(Hold) |
| 감성 분석 | 중립 5.0/10(자료 없음, 기본값) | 혼조 4.8/10(Reddit 8건) |
| 도구 호출 / 감성 분석가 시간 | 22번 / 17.03초 | 23번 / 30.62초 |
등급은 같았지만 감성 분석의 판정과 도구를 부른 횟수는 달랐습니다. 감성 판정이 갈린 것은 같은 명령인데도 입력부터 달랐기 때문입니다. 야후 뉴스와 StockTwits는 두 번 다 비었고, Reddit 글은 첫 번째에는 없고 두 번째에는 8건 들어왔습니다. 그래서 첫 번째의 5.0은 판정이 아니라 세 출처가 모두 빈 경우의 기본값입니다. 보고서도 이를 "중립 심리로 해석해서는 안 됩니다"라고 적었습니다. 도구 횟수 차이는 뉴스 분석가가 실업률 조회를 한 번 더 고른 결과입니다.
두 번은 표본이 작아 "늘 같은 등급이 나온다"고 말할 수는 없습니다. GitHub에는 같은 입력에 한 시간 간격으로 반대 등급이 나왔다는 보고도 있는데, 일부는 SEC 데이터 기간 정렬 버그였고 나머지는 LLM 샘플링과 실시간 데이터 때문이라는 설명이 붙었습니다(이슈 #1517).
11월 4일 실행의 비중 확대(Overweight)와 11월 3일 실행의 보유가 다른 이유는 이 실험으로 가를 수 없습니다. 날짜가 달라 주가, 뉴스, StockTwits 자료가 모두 바뀌었고, 11월 4일 실행은 뒤에서 설명할 장중 가격 문제까지 겹쳐 있기 때문입니다.
한국어로 시켰는데 몽골어 보고서가 나왔다
출력 언어를 한국어로 정했는데 NVDA 펀더멘털 보고서 하나가 몽골어로 나왔습니다. 제목부터 "NVDA фундаментал шинжилгээний тайлан"이었고, 나머지 보고서는 모두 한국어였습니다. 코드를 보면 영어가 아닌 언어를 고르면 모든 에이전트의 프롬프트 끝에 "응답 전체를 Korean으로 쓰라"는 문장이 붙습니다(context.py). 지시는 들어갔는데 모델(gpt-6-luna)이 다른 언어로 답한 것입니다.
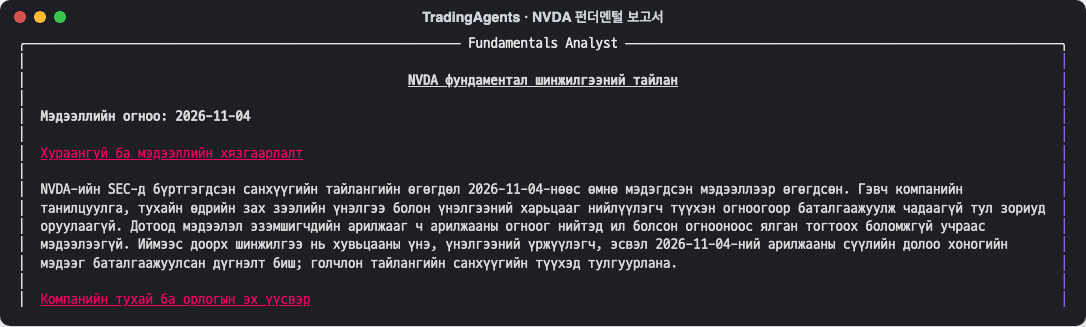
토론과 결정은 그대로 진행됐습니다. 연구원들은 이 몽골어 보고서의 숫자(매출 962억 달러 등)를 한국어로 인용했으니 내용 전달에는 문제가 없었던 셈입니다. 그래도 사람이 읽을 보고서라면 저장된 파일의 언어를 한 번 훑어보는 편이 안전합니다.
삼성전자는 재무제표 없이 판단했다
삼성전자(005930.KS)를 같은 설정으로 돌리자 재무제표가 한 줄도 들어오지 않았습니다. 손익계산서, 재무상태표, 현금흐름표, 기업 개요(시가총액·밸류에이션), 내부자 거래 5가지 조회가 모두 "보류"로 돌아왔습니다. 재무제표에 대해 도구가 남긴 이유는 "이 공급원은 재무제표를 보고 기간으로만 날짜를 매기고 공시일을 주지 않는다"였고, 기업 개요는 현재 시점 값만 준다는 이유였습니다. 미국 종목은 SEC 공시에서 제출일과 함께 받아 오지만, 한국 종목은 야후 파이낸스만 남는데 공시일이 없으니 분석일 이후에 나온 숫자가 섞이는지 확인할 수 없다는 뜻입니다. 기본 설정의 재무 데이터 공급원도 "sec_edgar,yfinance" 순서입니다.
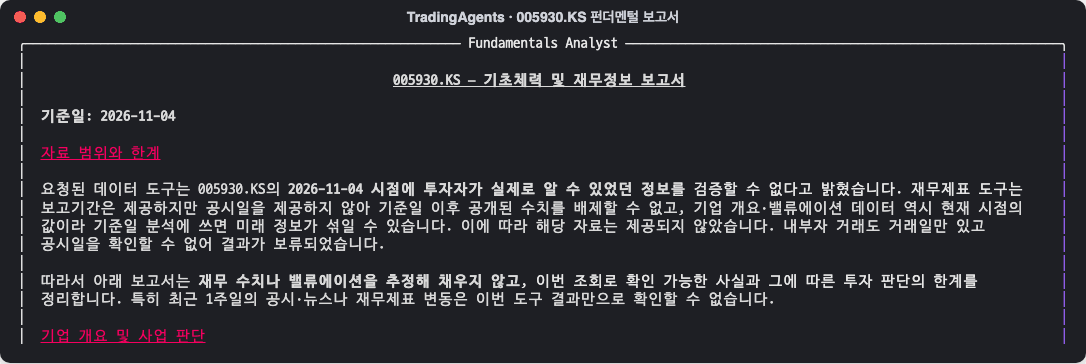
펀더멘털 분석가는 숫자를 지어내지 않고 "재무 수치나 밸류에이션을 추정해 채우지 않는다"고 한계를 먼저 밝혔습니다. 국내에서 논문 구조를 따라 한국 종목용 시스템을 직접 만든 한 블로거는 AI가 실적 숫자를 지어내서 매매 근거를 증권사 API 실데이터로 한정했다고 적었는데(w1ntersky 네이버 블로그), TradingAgents 원본은 적어도 이번 실행에서는 빈칸을 빈칸으로 남겼습니다.
감성 쪽도 비었습니다. StockTwits는 HTTP 오류로 받아 오지 못했고 Reddit의 지정 게시판에는 언급이 0건이었습니다. 남은 재료는 야후 파이낸스의 영어 헤드라인(메모리 공급 부족 전망, 미국 텍사스 공장 고객 확보 보도, OpenAI 협력 논의 보도 등)이었고, 감성 분석가는 "혼조, 5.1/10, 신뢰도 낮음"으로 봤습니다.
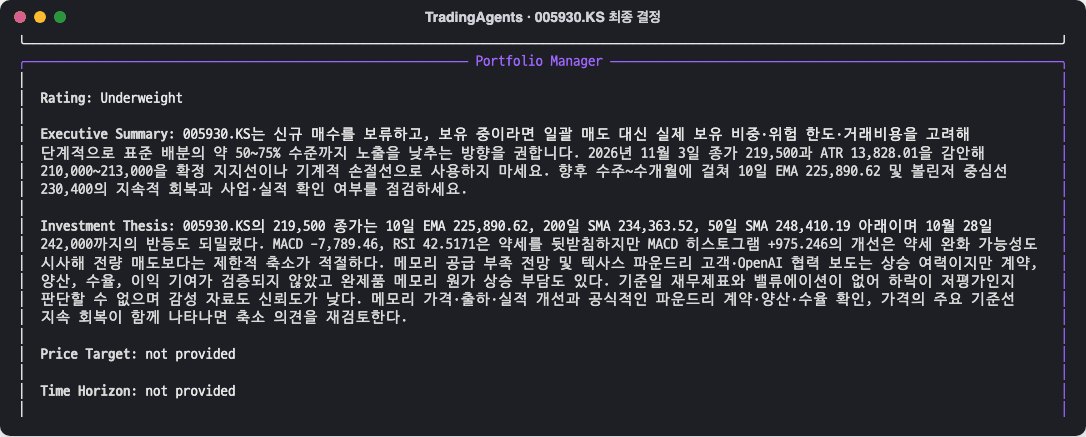
분석가 단계의 결론은 조심스러웠습니다. 펀더멘털 분석가는 등급을 "Not Rated", 제안을 "No trade"로 적었고 시장과 뉴스 분석가는 중립(Neutral)이었습니다. 그런데 연구 매니저 단계에서 비중 축소(Underweight)로 넘어갔고, 트레이더는 매도(Sell, 보유분을 표준 배분의 50~75%로 단계 축소), 포트폴리오 매니저는 비중 축소를 냈습니다. "No trade" 제안은 NVDA 11월 4일 실행의 펀더멘털 보고서에도 있었으니 삼성전자만의 현상은 아니고, 등급 자체를 "Not Rated"로 둔 것이 다릅니다. 포트폴리오 매니저 스스로 "기준일 재무제표와 밸류에이션이 없어 하락이 저평가인지 판단할 수 없다"고 적었습니다. 기술적 지표와 영어 뉴스만으로 나온 등급이라는 점을 감안해 읽어야 합니다.
분석일을 11월 3일로 바꿔 삼성전자를 한 번 더 돌려도 흐름은 같았습니다. 이 실행도 결정 기록 파일을 따로 썼습니다. 실행 시간은 196초에서 223초로 늘었고, 재무 자료 5가지가 다시 보류됐으며, 펀더멘털 분석가는 또 "Not Rated", 연구 매니저 비중 축소, 트레이더 매도, 포트폴리오 매니저 비중 축소가 나왔습니다. 11월 4일 실행도 11월 3일 행을 썼으니 두 실행의 종가와 지표 입력은 같습니다. 거래가 있던 11월 4일이 들어가면 어떻게 될지는 이 실험으로 알 수 없고, 삼성전자 실행은 두 번뿐이라 표본도 작습니다.
한국 종목이 아예 안 되는 것은 아닙니다. 티커에 .KS를 붙여 돌려 보니 주가와 기술적 지표는 들어왔고, 성과를 비교할 기준 지수도 기본 설정에 코스피(^KS11), 코스닥(^KQ11)으로 잡혀 있습니다. 코스닥(.KQ) 종목은 필자가 돌려 보지 않았습니다. 한 국내 사용법 글은 README에 한국 상장 종목 예시가 없어 되는지 확인하지 못했다고 적었는데(노빠꾸테크토닉 네이버 블로그), 재무제표가 SEC 공시 우선이라 국내 종목은 재료가 적을 수 있다고 추정한 글도 있습니다(파즈베어 네이버 블로그). 삼성전자로 직접 돌려 본 답은 "돌아는 가지만 펀더멘털 근거가 빠진다"입니다.
한국 시장에서 펀더멘털까지 보려면 DART 오픈API처럼 공시 접수일자를 확인할 수 있는 경로(DART 공시검색 개발가이드)로 재무 데이터를 따로 붙여야 한다고 필자는 봅니다. 재무 데이터는 아니지만 KRX 수급과 한국투자증권 현재가, 모의투자를 붙여 원본을 확장한 국내 적용기도 있습니다(끄적 네이버 블로그).
분석 날짜를 최신 거래일로 두면 생기는 일
분석 날짜를 최신 거래일로 두면 장이 아직 열려 있거나 데이터 공급원에 시세가 올라오지 않아 에이전트가 틀린 전제를 깔 수 있습니다. 필자의 두 실행에서 방향이 다른 문제가 하나씩 나왔습니다.
첫째, NVDA는 장중 가격을 종가로 썼습니다. 실행 시각은 한국 시각 11월 5일 오전 5시 13분, 뉴욕 시각으로는 11월 4일 오후 3시 13분이라 미국 장이 아직 열려 있었습니다. 도구는 11월 4일 행을 최신 거래일로 받아 왔고, 이 가격을 인용한 보고서들은 202.158달러를 "종가"라고 불렀습니다.
| 야후 11월 4일 행을 읽은 때(한국 시각) | 종가 칸 | 거래량 |
|---|---|---|
| 5시 13분 20초, 주가 조회 | 202.23달러 | 9,954만 주 |
| 5시 13분 32초, 시세 스냅샷 | 202.158달러 | 9,956만 주 |
| 6시 12분, 장 마감 뒤 | 200.13달러 | 1억 4,237만 주 |
에이전트가 본 값은 하루치 거래의 약 70%만 반영된 값이었고, 이동평균과 볼린저 밴드도 이 장중 값으로 계산됐습니다. v0.7.1의 "확정 종가로만 채점한다"는 수정은 지난 결정의 성과를 매기는 쪽 이야기라, 분석 입력에 장중 값이 들어가는 것까지 막지는 않았습니다(CHANGELOG).
둘째, 삼성전자는 하루가 통째로 빠졌습니다. 야후 파이낸스에는 실행 시점(한국 장 마감 약 14시간 뒤)까지 11월 4일 시세가 올라와 있지 않았고, 도구는 11월 3일 행을 썼습니다. 문제는 표시입니다. 지표 조회 코드는 자료에 없는 날짜를 모두 "N/A: Not a trading day (weekend or holiday)"로 채우고(market.py), 시장 분석가는 이 표시를 받아 보고서에 "2026-11-04는 거래일이 아니어서"라고 적었습니다. 실행 시점에 시세가 없는 날과 쉬는 날을 코드가 구분하지 못한 것입니다. 네이버 증권의 일별 시세에는 11월 4일 시가 225,500원, 저가 208,000원, 종가 221,500원, 거래량 3,482만 주가 남아 있습니다(네이버 증권 삼성전자 시세). 거래량이 전날(1,339만 주)의 2.6배인 날을 통째로 빼고 판단한 셈입니다.
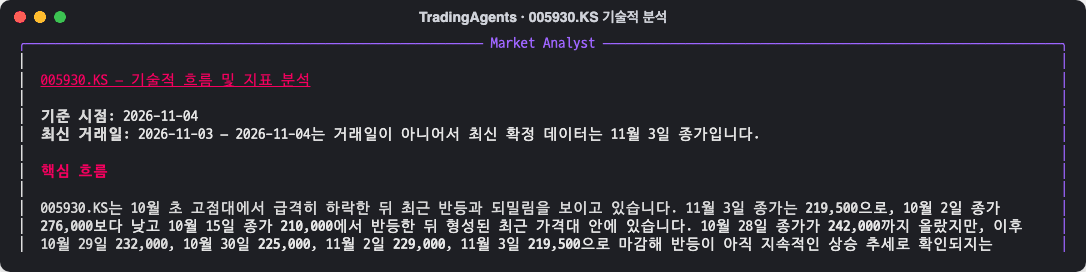
분석일을 11월 3일로 둔 실행에서는 이 두 문제가 나오지 않았습니다. NVDA는 확정 종가 206.69달러를 받았고, 삼성전자는 "거래일이 아니어서" 같은 문장 없이 11월 3일 종가로 분석했습니다. 실행 시점 시세를 보는 실험이 아니라면 장이 끝나고 야후에 시세가 올라온 날로 두는 편이 낫습니다.
논문의 수익률과 반론
논문은 2024년 1월부터 3월까지 약 3개월 백테스트에서 누적 수익률 AAPL 26.62%, GOOGL 24.36%, AMZN 23.21%를 보고했습니다. 같은 기간 단순 보유는 AAPL -5.23%, GOOGL 7.78%, AMZN 17.1%였습니다(arXiv 2412.20138). 당시 빠른 모델은 gpt-4o-mini와 gpt-4o, 깊은 모델은 o1-preview였습니다. 저자들은 기간이 짧은 이유로 예측당 LLM·도구 호출 부담을 들었습니다. 한 국내 논문 정리 글은 같은 모델로 돌린 단일 에이전트나 토론을 뺀 버전과의 비교가 없어, 높은 수익률이 무엇 덕분인지 나누기 어렵다고 짚었습니다(lee1995 티스토리).
반론도 나와 있습니다. 2026년 5월 arXiv에 올라온 입장 논문 "The Alpha Illusion"은 TradingAgents를 TSLA, NVDA, KO, XOM, MSTR 다섯 종목에 10만 달러로 2025년 1월부터 2026년 1월까지 1년 동안 다시 돌렸습니다. 비용을 빼기 전 TradingAgents는 10만 6,400달러로 단순 보유의 10만 4,800달러보다 높았지만, 비용을 빼자 10만 2,300달러로 낮아졌습니다(arXiv 2605.16895). 논문은 LLM 트레이딩 에이전트가 보고한 초과수익을 실제 운용 근거로 삼으면 안 된다고 주장합니다.
또 하나의 쟁점은 모델의 기억입니다. TradingAgents는 데이터 쪽에서 미래 정보를 막는 수정을 여러 번 했지만, 메인테이너는 GitHub 이슈에서 모델이 학습 때 본 결과를 기억하는 문제는 "코드 수정으로 완전히 없앨 수 없는 별개의 근본적 한계"라고 답했습니다(이슈 #805). 과거 날짜로 백테스트할수록 모델이 이미 답을 알고 있을 가능성이 커집니다.
전략 하나의 승률을 실제 시세로 검증해 본 과정은 종가베팅 전략 검증에, 같은 일을 여러 번 시켜 "매번 해내는가"로 에이전트를 재는 방법은 로컬 LLM 에이전트 비교에 정리했습니다.
직접 돌려 볼 때 챙길 것
필자가 이번 실행에서 얻은 체크리스트입니다.
- 분석 날짜는 장이 끝나고 야후에 시세가 올라온 날로 둔다. 미국 종목은 뉴욕 장 마감 뒤에 돌리고, 한국 종목은 야후에 그날 시세가 있는지 먼저 확인합니다.
- FRED 키를 넣는다. 키가 없으면 거시 지표 조회가 모두 비고, 뉴스 분석가가 금리·물가 없이 판단합니다. 넣어도 한국 지표 별칭은 없습니다.
- 한국 종목은 재무 데이터를 따로 마련한다. 원본 그대로는 재무제표 없이 기술적 지표와 영어 뉴스로만 판단합니다.
- 같은 설정으로 여러 번 돌려 본다. 필자의 NVDA 11월 3일 두 번은 등급이 같았지만 표본이 작습니다. 실행마다 등급이 갈리면 종목에 대한 신호가 아니라 도구의 변동으로 봅니다.
- 저장된 보고서를 훑는다. 언어가 바뀌거나, 무관한 뉴스가 섞이거나, 데이터 공백을 그럴듯하게 해석한 문장이 있는지 봅니다. 보고서는
complete_report.html한 페이지로도 저장됩니다. - 결정 기록(메모리)을 관리한다. 결정은
~/.tradingagents/memory/trading_memory.md에 쌓이고 다음 실행의 참고 자료가 됩니다. 실험을 서로 섞고 싶지 않으면TRADINGAGENTS_MEMORY_LOG_PATH로 파일을 나눕니다.
정리하면 TradingAgents는 "에이전트들이 어떤 근거로 어떻게 다투는지"를 3~4분 만에 보여 주는 잘 만든 연구 도구입니다. 미국 종목에서는 SEC 공시까지 끌어와 꽤 그럴듯한 토론을 하지만, 한국 종목에서는 재무 근거가 없다고 스스로 밝히면서도 같은 형식의 등급을 냅니다. 등급 한 줄보다 그 등급이 무엇을 보고 나왔는지를 읽는 데 쓰는 편이 맞다고 필자는 봅니다. 이번에 나온 문제 대부분은 모델 바깥의 데이터 연결에서 생겼는데, 모델을 둘러싼 코드가 결과를 얼마나 바꾸는지는 AI 하네스 뜻에 정리했습니다.
출처
- arXiv 2412.20138: arxiv.org/abs/2412.20138
- TradingAgents GitHub: github.com/TauricResearch/TradingAgents
- GitHub API: api.github.com/repos/TauricResearch/TradingAgents
- CHANGELOG: raw.githubusercontent.com/TauricResearch/TradingAgents/main/CHANGELOG.md
- README: github.com/TauricResearch/TradingAgents
- 깜희IT정보꾼 네이버 블로그: m.blog.naver.com/info2016han/224458086013
- fred.py: github.com/TauricResearch/TradingAgents/blob/main/tradingagents/dataflo…
- 이슈 #1355: github.com/TauricResearch/TradingAgents/issues/1355
- 퍼플앤트 네이버 블로그: m.blog.naver.com/purpleant33/224343727037
- 이슈 #1517: github.com/TauricResearch/TradingAgents/issues/1517
- context.py: github.com/TauricResearch/TradingAgents/blob/main/tradingagents/agents/…
- w1ntersky 네이버 블로그: m.blog.naver.com/w1ntersky/224354765688
- 노빠꾸테크토닉 네이버 블로그: m.blog.naver.com/noppaku/224463513577
- 파즈베어 네이버 블로그: m.blog.naver.com/pazbear-home/224464705178
- DART 공시검색 개발가이드: opendart.fss.or.kr/guide/detail.do?apiGrpCd=DS001&apiId=2019001
- 끄적 네이버 블로그: m.blog.naver.com/fifabell/224415850634
- market.py: github.com/TauricResearch/TradingAgents/blob/main/tradingagents/dataflo…
- 네이버 증권 삼성전자 시세: m.stock.naver.com/domestic/stock/005930/price
- lee1995 티스토리: lee1995.tistory.com/6
- arXiv 2605.16895: arxiv.org/abs/2605.16895
- 이슈 #805: github.com/TauricResearch/TradingAgents/issues/805