핵심 요약
- RTX 3090 한 장에서 돌린 gemma4 26B가 Claude Sonnet 5.5와 비겼습니다. BFCL v4 다단계 도구 호출 과제 100개를 모델마다 5번씩 시킨 실험에서, 5번 다 성공한 과제는 gemma4 60개, Sonnet 57개였습니다. 필자가 공개된 실행 기록 8,825줄을 다시 집계해 과제끼리 짝지어 비교해 보니 이 차이는 우연과 구분되지 않았습니다(p=0.73).
- 평균 성공률과 "5번 다 성공"은 순위가 다릅니다. qwen3.8 27B는 한 번이라도 푼 과제가 83개로 가장 많았지만 5번 다 푼 과제는 42개였습니다. gpt-oss 20B는 평균이 Haiku 5.5보다 높았지만 5번 다 푼 과제는 28개로 Haiku(36개)보다 적었습니다.
- 실패는 무작위로 흩어지지 않고 과제에 몰립니다. 실패가 동전 던지기였다면 평균 71.4%인 gemma4가 5번 연속 성공할 과제는 19개 안팎이어야 하는데 실제로는 60개였습니다. 문제는 "가끔 실패하는 과제"이고, 그 수가 gemma4는 20개, qwen3.8은 41개, gpt-oss는 48개였습니다.
- 설정이 숫자를 움직입니다. 모델이 "진행할까요?"라고 물었을 때 "예"라고만 답해 주면 Sonnet의 5번 다 성공은 57개에서 43개로 떨어졌고, 과제끼리 짝지어 봐도 우연으로 보기 어려웠습니다(p=0.001). LFM2.5 24B는 온도를 카드 권장값 0.1로 두면 55개, 1.0이면 45개였는데, 짝지어 보면 p=0.052로 경계선입니다.
- 에이전트에 맡길 모델은 평균 점수가 아니라 자기 일을 여러 번 돌려 본 결과로 고르는 편이 맞습니다. 이 실험은 영어 과제 100개, 기본 설정 한 벌로 잰 것이라 한국어 지시나 다른 설정에서는 결과가 달라질 수 있습니다.
목차
- 로컬 LLM 에이전트 비교, 무엇을 쟀나
- 평균 순위와 '5번 다' 순위는 다르다
- pass^k란: k번 시켜 k번 다 성공할 확률
- 실패는 무작위가 아니라 과제에 몰린다
- 1위 gemma4와 2위 Sonnet은 비겼다
- "진행할까요?" 한마디가 점수를 바꾼다
- 온도만 바꿔도 '5번 다'가 55개에서 45개로
- 양자화와 런타임도 점수를 바꾼다
- 틀리고도 "충분하다"고 답하는 조용한 실패
- RTX 3090에 맡길 일, 맡기기 전에 잴 것
- 출처
로컬 LLM 에이전트 비교, 무엇을 쟀나
이 로컬 LLM 에이전트 비교는 같은 도구 호출 과제를 모델마다 5번씩 시켜, 평균이 아니라 "매번 해내는가"를 본 실험입니다. 실험은 bric.pe.kr에 2026년 11월 3일 올라온 글 "같은 일을 5번 시켰더니: 로컬 LLM 4종과 Claude 2종, 도구 호출 100과제 «매번 해내나» 채점"이고(bric.pe.kr 원문), 같은 날 긱뉴스에도 소개됐습니다.
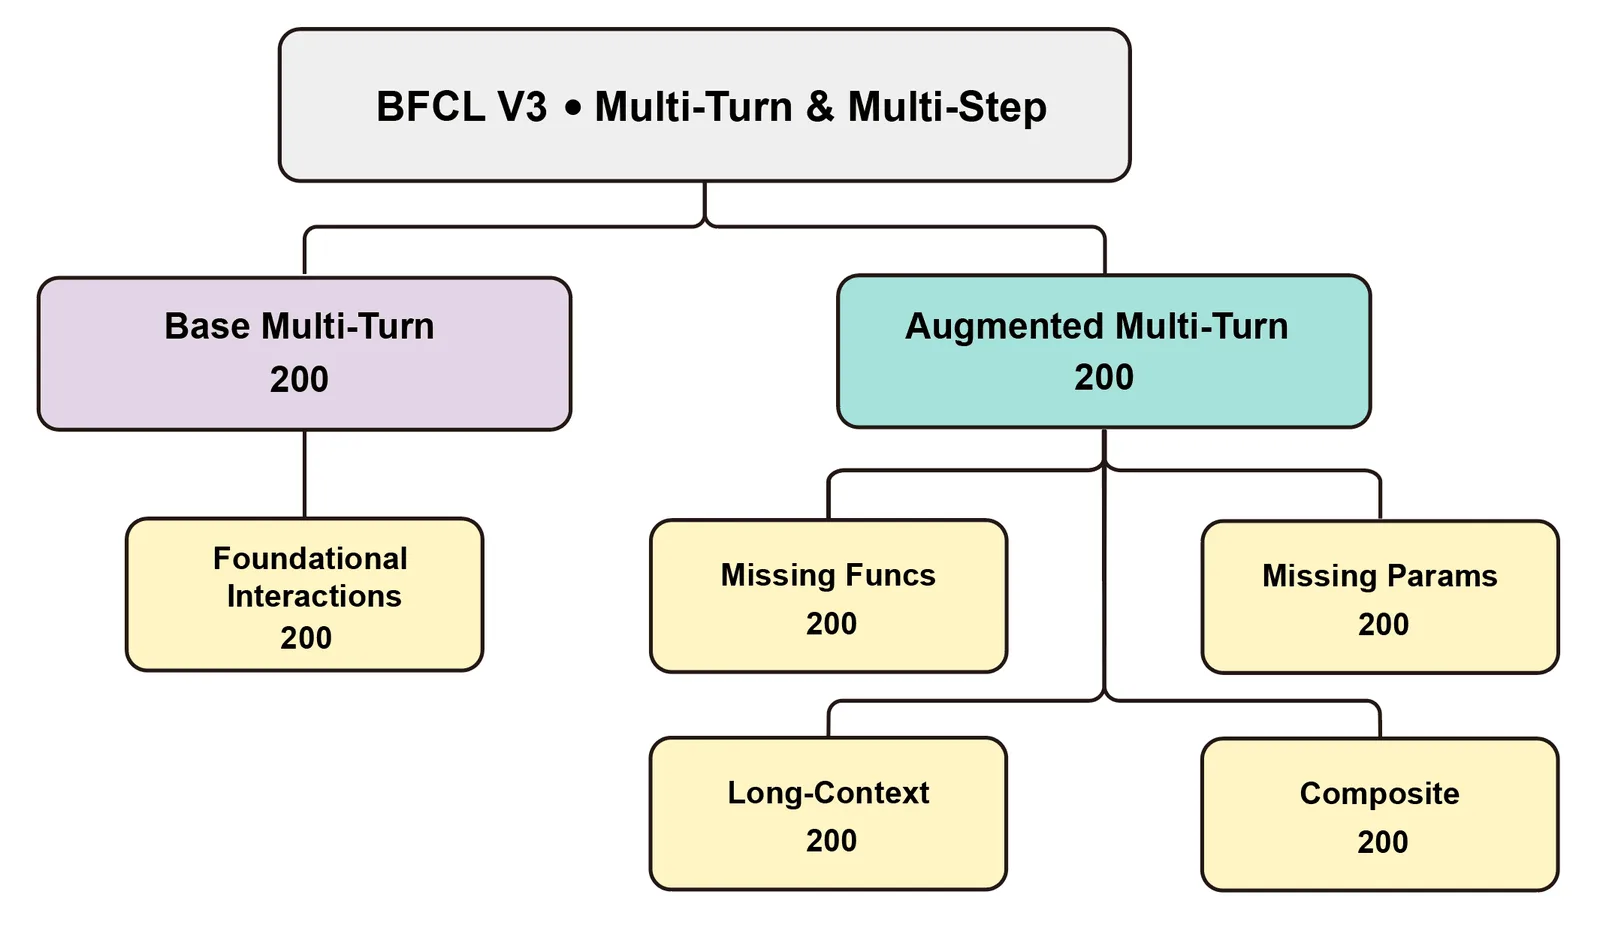
과제는 UC 버클리 Gorilla 팀이 만든 함수 호출 벤치마크 BFCL의 다단계 범주 multi_turn_base입니다. 원문은 BFCL v4에 들어 있는 이 범주를 썼고, 다단계 범주는 V3 때 처음 나왔습니다. BFCL V3 블로그에 따르면 기본 다단계(Base Multi-Turn) 과제는 200개이고, 필요한 정보가 모두 주어진 상태에서 사용자 요청이 여러 번 이어집니다(BFCL V3 블로그). 원문은 이 200개 가운데 짝수 번호 100개를 골랐습니다. 모델은 파일 시스템, 주식 거래, 여행 예약, 메시지, 게시판, 차량 제어 같은 가짜 시스템의 함수를 불러 일을 처리합니다.
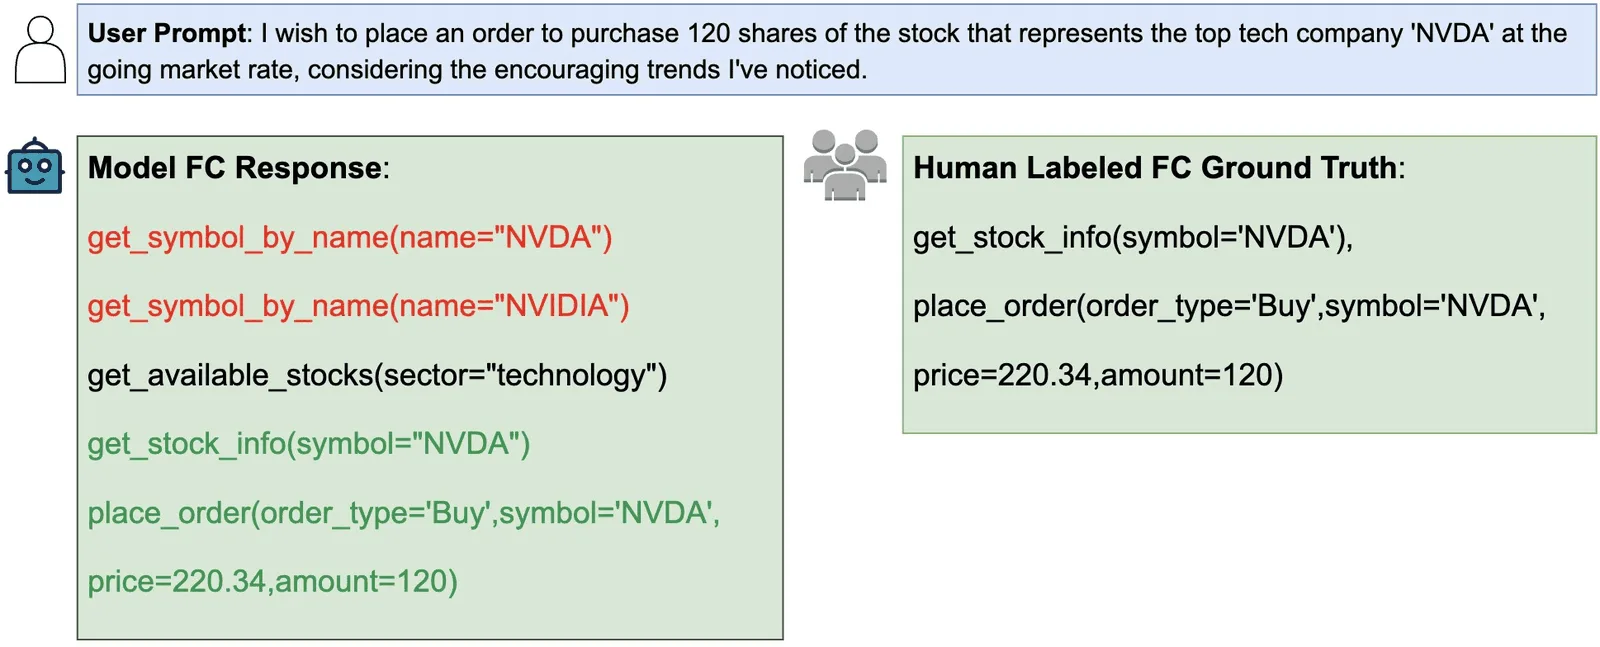
채점은 말이 아니라 결과를 봅니다. BFCL V3 블로그는 다단계 채점이 매 턴이 끝날 때 백엔드 시스템의 상태를 정답과 비교하는 검사와, 모델의 실행 경로에 정답의 최소 실행 경로가 들어 있는지 보는 검사로 이뤄진다고 설명합니다. 그래서 모델이 "완료했습니다"라고 답해도 파일이나 잔고, 연료량 같은 상태가 정답과 다르면 실패입니다. 원문은 BFCL 공식 채점기 bfcl-eval 2026.3.23으로 채점했고, 이 버전은 PyPI에 2026년 3월 23일 올라온 판입니다(PyPI bfcl-eval).
로컬 모델 네 개는 RTX 3090 한 장에서 Ollama 0.40.13으로 돌렸습니다. 문맥은 32k, 가중치는 4비트 양자화(Q4_K_M, gpt-oss만 MXFP4)입니다. 원문 재현 자료의 실행 기록에 남은 모델 태그는 gemma4:26b, lfm2.5:24b, qwen3.8:27b, gpt-oss:20b이고, 실행마다 시드를 1001부터 1005까지 바꿨습니다(재현 자료). Claude 두 개(Sonnet 5.5, Haiku 5.5)는 Anthropic API로 기본 온도 1.0에 확장 사고 없이 돌렸습니다. 로컬 모델의 사고(thinking) 모드는 따로 켜거나 끄지 않고 Ollama 기본값 그대로 두었다고 실행 스크립트에 적혀 있어, 사고 설정이 양쪽에서 완전히 같은 조건은 아닙니다.
원문은 실행 스크립트와 실행 기록 전체를 압축 파일로 공개했습니다. 필자는 이 파일을 내려받아 스크립트는 실행하지 않고 기록(JSONL 8,825줄)만 읽는 집계 코드를 따로 써서 숫자를 다시 셌습니다. 원문 표의 평균 성공률, 한 번 이상 성공, 5번 다 성공 수치는 모두 기록과 일치했습니다. 이 글의 과제별 분포, 짝지은 비교, 동전 던지기 가정 계산은 원문에 없는 필자 집계입니다.
평균 순위와 '5번 다' 순위는 다르다
평균 성공률 순위와 5번 다 성공한 과제 수 순위는 같지 않았습니다. 아래는 원문 표를 3열로 줄인 것입니다. 괄호 안은 다섯 번 중 한 번이라도 성공한 과제 수입니다.
| 모델 (실행 위치) | 평균 성공률 | 5번 다 성공 (한 번이라도) |
|---|---|---|
| gemma4 26B (3090) | 71.4% | 60개 (80개) |
| Claude Sonnet 5.5 (API) | 67.0% | 57개 (76개) |
| LFM2.5 24B, 온도 1.0 (3090) | 63.8% | 45개 (78개) |
| qwen3.8 27B (3090) | 62.8% | 42개 (83개) |
| gpt-oss 20B (3090) | 53.8% | 28개 (76개) |
| Claude Haiku 5.5 (API) | 52.0% | 36개 (69개) |
순위가 뒤집히는 곳이 두 군데 있습니다. qwen3.8은 한 번이라도 푼 과제가 83개로 여섯 모델 가운데 가장 많았지만, 5번 다 푼 과제는 42개로 4위였습니다. gpt-oss는 평균 성공률(53.8%)이 Haiku(52.0%)보다 높았지만 5번 다 푼 과제는 28개로 Haiku(36개)보다 8개 적었습니다. 원문 글쓴이도 "평균과 «5번 다»는 다릅니다"라고 정리했습니다.
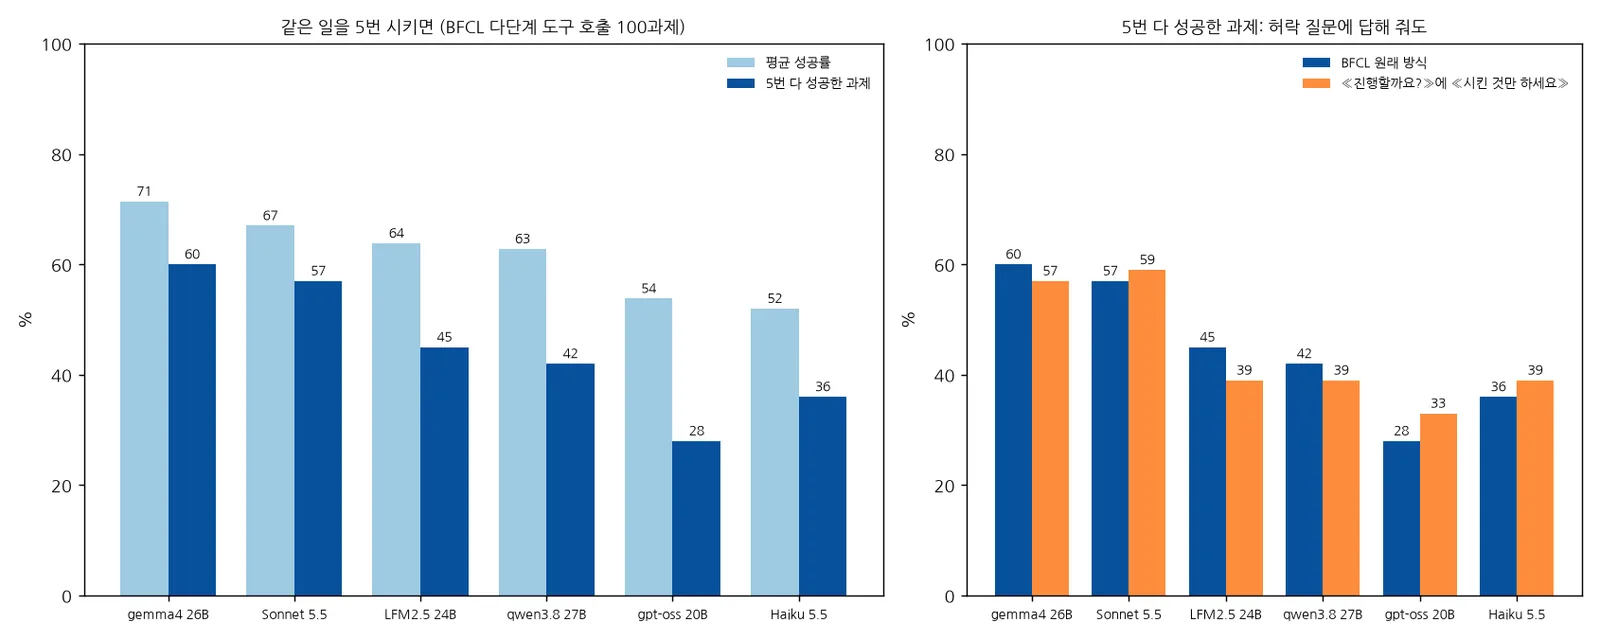
이 차이가 왜 중요한지는 에이전트를 어떻게 쓰는지 생각하면 바로 보입니다. 사람이 옆에서 한 번 시켜 보고 틀리면 다시 시키는 대화라면 "한 번이라도 푸는가"가 의미 있습니다. 매일 밤 같은 업무를 무인으로 돌리는 에이전트라면 "매번 푸는가"가 의미 있습니다. 같은 과제를 다섯 번 시켜 다섯 번 다 맞힌 비율에는 이름이 있습니다. pass^k입니다.
pass^k란: k번 시켜 k번 다 성공할 확률
pass^k는 같은 과제를 k번 시켰을 때 k번 모두 성공할 확률을 과제 전체에 대해 평균한 값입니다. 이 지표는 Sierra 연구진이 2024년 6월 낸 에이전트 벤치마크 τ-bench 논문에서 정의했습니다. 논문은 과제마다 n번 시도해 c번 성공했을 때 pass^k를 C(c,k)/C(n,k)의 과제 평균으로 계산하고, 이것을 "the chance that all k i.i.d. task trials are successful, averaged across tasks"라고 설명합니다(τ-bench 논문). 흔히 보는 pass@k는 반대로 k번 중 한 번이라도 성공할 확률입니다.
n=5, k=5이면 pass^5는 그대로 "5번 다 성공한 과제의 비율"입니다. 원문 표의 오른쪽 열이 곧 실측 pass^5인 셈입니다. τ-bench 논문은 당시 gpt-4o 기반 에이전트가 소매 상담 과제에서 pass^8이 25% 아래로 떨어진다고 보고했고, Sierra 블로그는 이를 pass^1 대비 큰 폭의 하락으로 설명했습니다(Sierra 블로그).
Anthropic도 2026년 1월 에이전트 평가 가이드에서 같은 지표를 다뤘습니다. 가이드는 "pass^k measures the probability that all k trials succeed"라고 정의하고, 한 번 성공률이 75%라면 세 번 연속 성공할 확률은 "(0.75)³ ≈ 42%"라는 예를 들었습니다(Anthropic 에이전트 평가 가이드). 시도를 늘리면 pass@k는 100%에 다가가고 pass^k는 0%로 떨어진다는 설명도 붙였습니다.
여기까지가 교과서의 설명입니다. 그런데 (0.75)³ 같은 계산은 모든 과제의 성공 확률이 똑같이 75%라는 가정을 깔고 있습니다. τ-bench 공식은 과제마다 따로 계산하므로 이 가정이 없고, 아래 실측도 그 공식으로 낸 값입니다. 평균 하나를 거듭제곱한 값을 실제 기록에 대 보면 숫자가 전혀 맞지 않습니다.
실패는 무작위가 아니라 과제에 몰린다
실제 5번 연속 성공률은 "실패가 동전 던지기"라는 가정으로 계산한 값보다 약 3~9배 높았습니다. 평균 성공률을 다섯 번 곱하면 gemma4는 0.714의 5제곱으로 약 18.6%, gpt-oss는 0.538의 5제곱으로 약 4.5%입니다. 실측은 각각 60%, 28%였습니다.
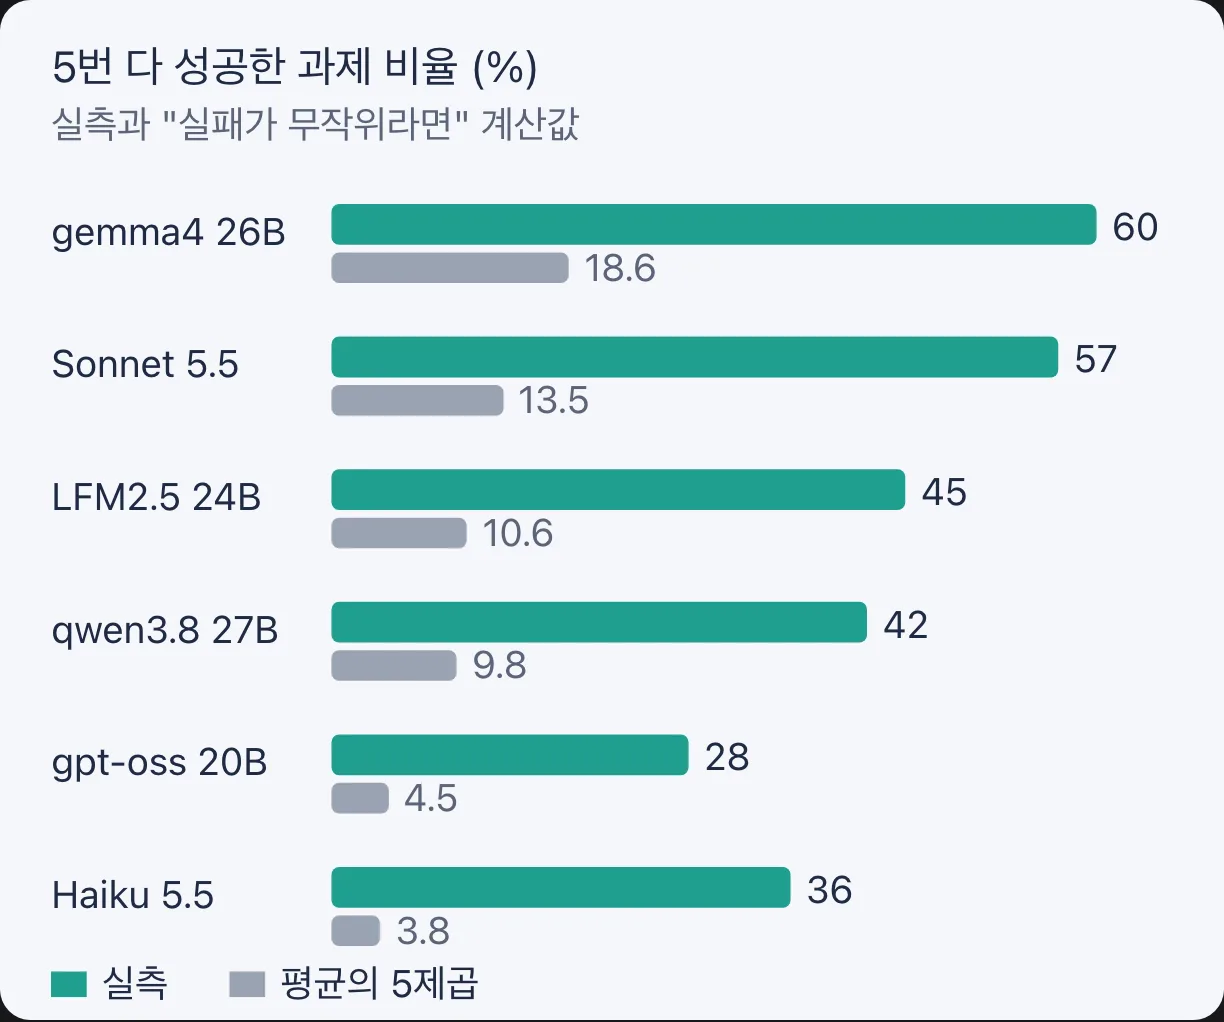
이 간격이 생기는 이유는 과제마다 성공 확률이 크게 다르기 때문입니다. 과제를 "5번 다 실패", "1~4번 성공", "5번 다 성공"으로 나눠 보면 모양이 분명해집니다.
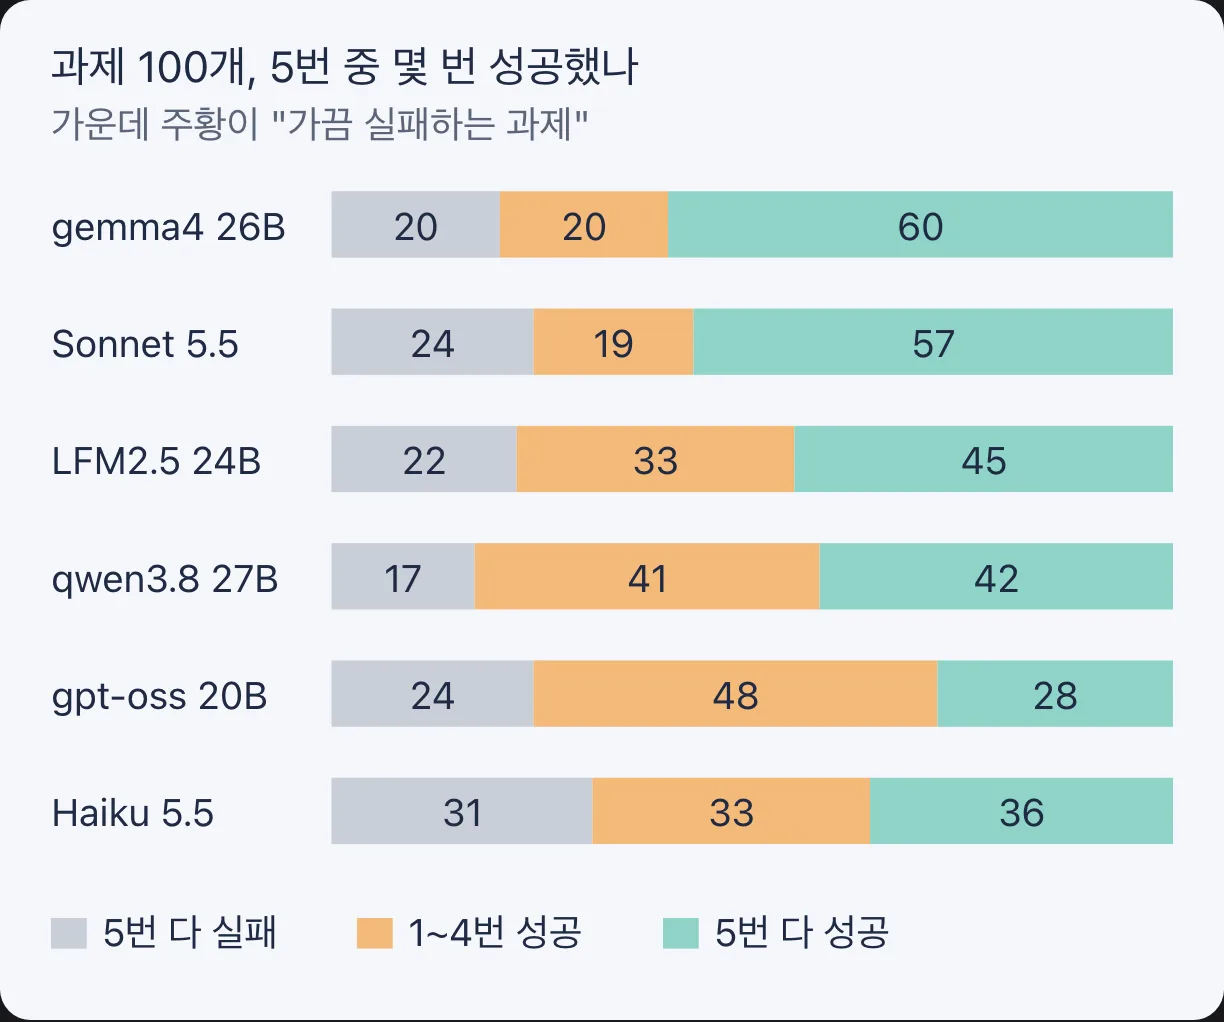
회색은 모델이 아예 못 하는 과제이고, 초록은 안정적으로 하는 과제입니다. 평균 성공률은 이 둘과 가운데 주황을 한 숫자로 섞어 버립니다. 주황 구간, 즉 "할 줄은 아는데 가끔 틀리는 과제"가 무인 에이전트에서 가장 곤란한 부분입니다. 회색 과제는 처음 몇 번 돌려 보면 안 된다는 것을 알고 다른 수단을 찾을 수 있지만, 주황 과제는 시험할 때는 되다가 운영 중에 조용히 틀립니다.
이 구간이 qwen3.8은 41개, gpt-oss는 48개로 gemma4(20개)나 Sonnet(19개)의 두 배를 넘었습니다. qwen3.8이 한 번이라도 푼 과제가 가장 많은데도 5번 다 푼 과제가 적은 이유가 여기에 있습니다. 원문 글쓴이도 qwen3.8의 문제를 매번 같은 길로 가지 않는 데서 찾았습니다.
k를 1부터 5까지 늘려 가며 계산하면 이 차이가 곡선으로 보입니다. 아래는 τ-bench의 공식으로 각 k에서의 pass^k를 다시 계산한 것입니다.
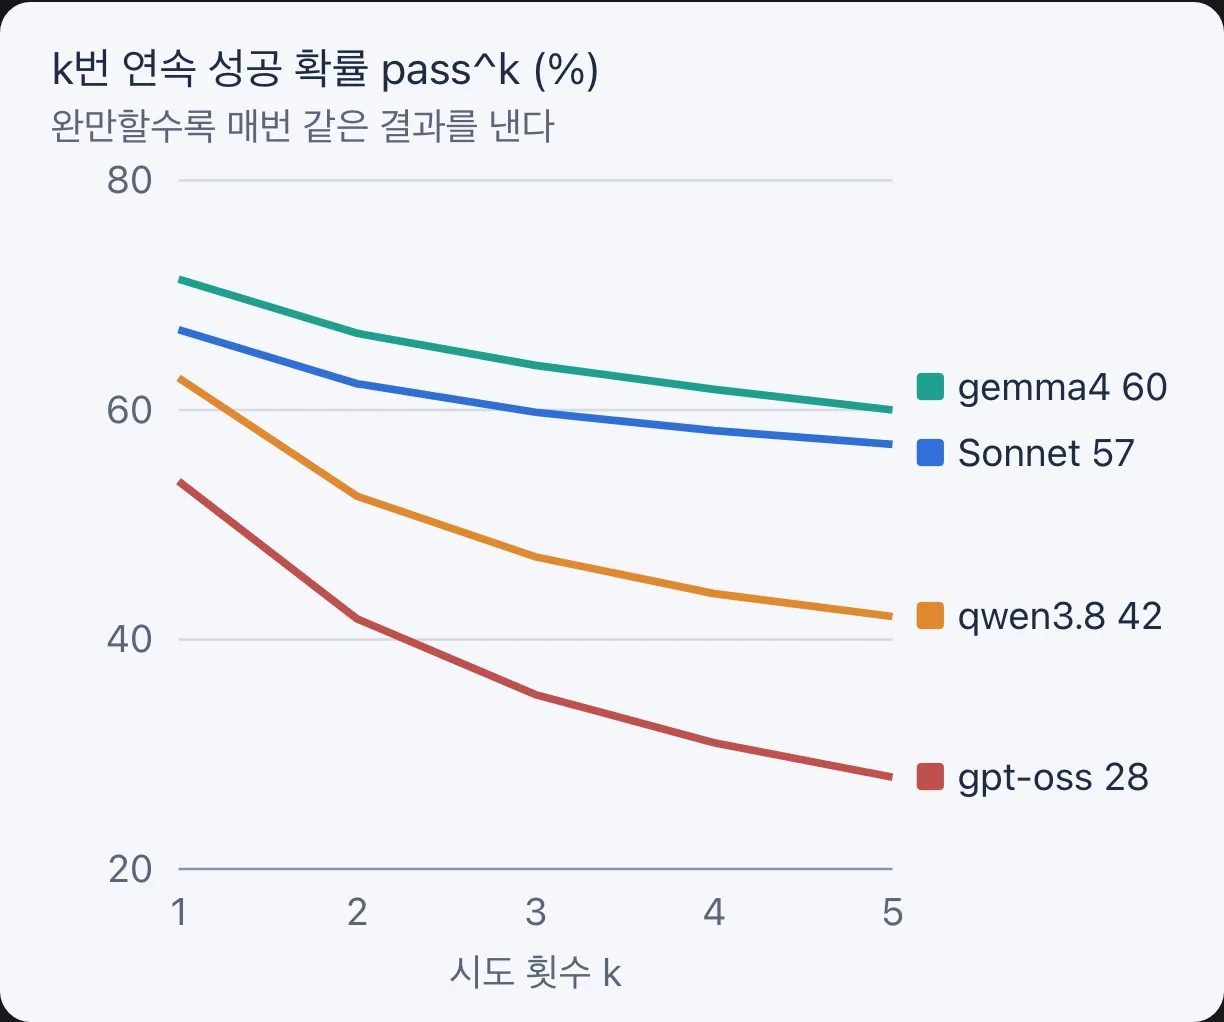
gemma4와 Sonnet의 선은 k가 늘어도 10~11포인트만 내려갑니다. qwen3.8은 21포인트, gpt-oss는 26포인트 내려갑니다. 평균(k=1)만 보면 qwen3.8과 gemma4의 차이는 8.6포인트지만, 5번 연속(k=5)에서는 18포인트로 벌어집니다.
1위 gemma4와 2위 Sonnet은 비겼다
gemma4 60개와 Sonnet 57개의 차이는 과제 단위로 짝지어 보면 우연과 구분되지 않습니다. 두 모델이 똑같이 5번 다 성공한 과제는 42개였습니다. 나머지는 gemma4만 5번 다 성공한 과제 18개, Sonnet만 5번 다 성공한 과제 15개였습니다. 같은 과제를 두 모델에 낸 결과라서 이렇게 갈린 과제만 놓고 비교하는 방법(맥니마 정확 검정)을 쓰면 18 대 15는 p=0.73으로, 동전을 33번 던져 18 대 15가 나오는 것과 다르지 않습니다.
이런 비교 방식은 필자가 고안한 것이 아닙니다. Anthropic은 2024년 11월 모델 평가 통계 글에서 점수와 함께 표준오차를 보고하고, 같은 문제를 여러 번 샘플링하고, 두 모델을 비교할 때는 같은 문제에서의 차이를 짝지어 보라고 권했습니다(Anthropic 평가 통계 글). 에이전트 평가의 무작위성을 다룬 2026년 2월 논문은 한 번만 돌린 pass@1 추정이 2.2~6.0포인트 흔들리고, 온도 0에서도 표준편차가 1.5포인트를 넘는다고 보고했습니다(On Randomness in Agentic Evals).
같은 방법으로 다른 쌍도 비교했습니다. 1·2위와 그 아래 사이는 갈렸습니다. gemma4와 qwen3.8은 gemma4만 5번 다 성공한 과제가 27개, qwen3.8만 9개로 p=0.004였고, Sonnet과 qwen3.8은 18 대 3(p=0.001)이었습니다. gemma4와 LFM2.5(온도 1.0)는 26 대 11(p=0.020), Sonnet과 LFM2.5는 20 대 8(p=0.036)이었는데, 여러 쌍을 함께 검정한 것을 감안하면 이 둘은 경계에 가깝습니다. 반면 qwen3.8과 LFM2.5는 13 대 16(p=0.71), gpt-oss와 Haiku는 9 대 17(p=0.17)로 구분되지 않았습니다. Sonnet과 Haiku는 25 대 4로 분명히 갈렸습니다.
정리하면 이 실험의 5번 다 성공 순위는 "gemma4와 Sonnet이 한 무리, 그 아래 LFM2.5와 qwen3.8이 한 무리"로 읽는 편이 정확합니다. gpt-oss는 가운데 무리와도 갈렸지만(qwen3.8과 6 대 20, LFM2.5와 7 대 24), Haiku는 가운데 무리와도 gpt-oss와도 구분되지 않았습니다. "젬마4 쏘넷 차이"가 네이버 자동완성에 뜰 만큼 궁금해하는 사람이 있는데, 적어도 이 과제 100개에서 Sonnet을 확장 사고 없이 쓴 조건이라면 매번 성공하는 과제 수로는 차이를 말하기 어렵습니다. 다만 두 모델이 잘하는 과제는 서로 달랐습니다. 원문의 시스템별 표를 보면 gemma4는 메시지(83%), 차량 제어(80%) 과제에서 앞섰고, 주식 거래에서는 75%로 여섯 모델 가운데 가장 낮았습니다. Sonnet은 주식 거래에서 84%였습니다.
여섯 모델을 함께 놓고 보면 과제 100개 가운데 모든 모델이 5번 다 실패한 과제가 7개, 모든 모델이 5번 다 성공한 과제가 13개였습니다. 적어도 한 모델이라도 5번 다 성공한 과제는 77개입니다. 하나의 모델로 전부를 맡기기보다 과제 종류에 따라 모델을 나눠 쓸 여지가 크다는 뜻이고, 원문 글쓴이도 쉬운 일은 작은 로컬 모델에, 여러 단계 결과를 이어 붙이는 일은 5번 다 성공이 높은 모델에 맡기는 방향을 제안했습니다.
"진행할까요?" 한마디가 점수를 바꾼다
BFCL 방식에서는 모델이 도구를 부르지 않고 질문으로 답을 끝내면 그 요청은 거기서 끝나고, 할 일을 안 했으니 실패로 채점됩니다. 원문 재현 자료의 README는 이 규칙을 "a reply without a tool call ends the request"라고 적었습니다. 사람과 일하는 비서라면 "이 파일을 지워도 될까요?"라고 묻는 것이 미덕일 수 있지만, 이 채점에서는 감점입니다.
원문 글쓴이는 그래서 같은 과제를 두 가지 방식으로 다시 쟀습니다. 모델이 허락을 구하는 질문으로 끝나면 한 번은 "예, 진행하세요"라고 답해 주는 방식, 다른 한 번은 "예, 시킨 것만 정확히 하고 그 이상은 하지 마세요"라고 답하는 방식입니다. 아래 표는 5번 다 성공한 과제 수입니다.
| 모델 | 원래 → "예"로 답함 | 원래 → "시킨 것만" 답함 |
|---|---|---|
| gemma4 26B | 60 → 57 | 60 → 57 |
| Sonnet 5.5 | 57 → 43 | 57 → 59 |
| LFM2.5 24B (온도 1.0) | 45 → 21 | 45 → 39 |
| qwen3.8 27B | 42 → 중단 | 42 → 39 |
| gpt-oss 20B | 28 → 측정 안 함 | 28 → 33 |
| Haiku 5.5 | 36 → 34 | 36 → 39 |
"예"라고만 답했더니 오히려 점수가 떨어졌습니다. Sonnet은 57개에서 43개로, LFM2.5는 45개에서 21개로 내려갔습니다. 과제 단위로 짝지어 보면 Sonnet은 원래 방식에서만 5번 다 성공한 과제가 16개, "예" 방식에서만 성공한 과제가 2개(p=0.001)로, 이 하락은 우연으로 보기 어렵습니다. 원문은 그 이유를 모델이 "다른 것도 해 드릴까요?" 같은 제안에도 "예"를 받아 시키지 않은 일까지 했기 때문이라고 설명합니다. 상태 기반 채점에서는 시키지 않은 파일 하나, 시키지 않은 게시글 하나도 오답입니다. qwen3.8은 이 측정이 중간(500회 중 295회)에 멈췄고 gpt-oss는 돌리지 않았습니다.
"시킨 것만"이라고 답하자 평균 성공률은 모든 모델이 원래 방식과 4포인트 안쪽이었습니다. 필자가 기록에서 센 결과, 이 방식에서 질문이 끼어든 실행은 500회 가운데 qwen3.8 322회, LFM2.5 256회, Haiku 138회, Sonnet 102회, gpt-oss 54회, gemma4 12회였습니다. 원문 글쓴이는 질문 자체가 점수를 크게 깎지는 않는다고 봤습니다. 질문이 12회로 가장 적은 gemma4가 BFCL 방식에서 1위를 한 데에는 거의 묻지 않고 바로 실행하는 성향도 한몫했을 수 있습니다. 이 부분은 기록에서 확인한 사실이 아니라 필자의 해석입니다.
시킨 것보다 더 하려는 성향은 다른 곳에서도 드러났습니다. 아이디어를 적어 둘 TeamNotes.txt 문서를 만들어 달라는 과제의 정답은 빈 파일이었습니다. Sonnet은 다섯 번 모두 파일을 만든 뒤 "TeamNotes - Fresh Ideas Tracker"라는 제목과 표 머리(한 번은 항목 양식)를 써 넣어 실패했습니다. 필자가 기록을 열어 보니 다섯 번 모두 touch 다음에 echo로 내용을 채웠습니다. 원문에 따르면 gemma4는 다섯 번 중 네 번 빈 파일만 만들었습니다.
온도만 바꿔도 '5번 다'가 55개에서 45개로
같은 LFM2.5 24B라도 온도를 0.1로 두면 5번 다 성공한 과제가 55개, 1.0으로 두면 45개였습니다. 원문은 "LFM2.5는 Ollama 기본 온도가 0.1이고(모델 카드 권장값), 다른 모델은 모두 1.0"이라서, 비교 조건을 맞추려고 LFM2.5만 1.0으로 다시 쟀다고 밝혔습니다. 0.1일 때 평균 성공률은 67.0%로 Sonnet과 같았습니다.
Liquid AI의 모델 카드는 LFM2.5-24B-A2B에 온도 0.1, top_k 50, repetition_penalty 1.05를 권장합니다(LFM2.5-24B-A2B 모델 카드). 반면 Google은 Gemma 4에 모든 용도에서 온도 1.0, top_p 0.95, top_k 64를 권장합니다(Gemma 4 모델 카드). 모든 모델을 같은 온도로 맞추는 것과 각 모델을 권장값으로 돌리는 것은 서로 다른 질문에 대한 답이고, 이 실험의 표는 앞쪽을 택한 결과입니다.
필자가 두 측정을 과제 단위로 짝지어 보니 0.1에서만 5번 다 성공한 과제가 16개, 1.0에서만 5번 다 성공한 과제가 6개였습니다(p=0.052). 우연이라고 넘기기도, 확실한 차이라고 말하기도 어려운 경계입니다. 흥미로운 것은 평균은 3.2포인트밖에 안 움직였는데 "가끔 실패하는 과제"가 23개에서 33개로 늘었다는 점입니다. 적어도 이 모델에서는 온도가 평균보다 반복 안정성 쪽을 더 크게 움직였습니다.
순위표에 따라 모델 순서가 바뀌는 일은 다른 자료에서도 보입니다. LFM2.5 모델 카드에 실린 제조사 측정 BFCLv4 점수는 LFM2.5-24B-A2B 65.01, Gemma-4-26B-A4B-it 57.09로 이번 실험과 반대입니다. 카드는 이 점수를 vLLM에서 온도 0.001로 쟀다고 적었을 뿐 어떤 범주를 넣었는지는 밝히지 않아 직접 비교할 수는 없습니다. 다만 범주, 정밀도, 런타임, 샘플링이 다른 측정끼리는 순위가 뒤집힐 수 있다는 예로는 볼 수 있습니다.
양자화와 런타임도 점수를 바꾼다
온도 말고도 양자화와 런타임이 로컬 모델의 도구 호출 점수를 움직입니다. 이 실험의 로컬 모델은 모두 4비트였습니다. 2026년 NeurIPS 워크숍 논문은 BFCL v4 다단계 과제에서 Q4_K_M 양자화가 xLAM-2-3B의 정확도를 58.00%에서 51.75%로 낮췄다고 보고했습니다(Same Quantization, Different Failures). 다만 소형 공개 모델(초록에 이름이 나온 것은 1.7B~4B)만 다룬 연구라 24~27B 모델에 그대로 적용할 수는 없습니다. 2026년 7월 τ²-bench 연구는 4비트 양자화가 표준 점수에서는 "looks free on the standard metric"처럼 보여도 특정 실패 유형을 최대 2.5배까지 늘린다고 보고했습니다(Flat Score, Amplified Failures). 평균은 그대로인데 실패의 모양이 바뀐다는 점에서, 평균이 반복 안정성을 가린다는 이 글의 관찰과 통하는 데가 있다고 필자는 봅니다.
국내 개발자들의 경험담도 비슷한 지점을 가리킵니다. 긱뉴스의 Gemma 4 로컬 실행 글에는 Ollama가 모델별 도구 호출 파서 문제와 얽혀 실패 가능성이 높다는 댓글이 달렸고(긱뉴스 Gemma 4 Codex CLI 글), Gemma 4 26B를 Codex CLI에 붙여 본 한 국내 블로그는 처음 어댑터로 만든 패치 8개는 7개가 시작 줄을 잘못 썼고 나머지 1개도 일반 diff 형식이었는데, 도구 문법을 설명에 넣은 뒤에는 같은 작은 과제를 세 번 돌려 세 번 모두 첫 호출에 성공했다며 "도구를 호출할 수 있는 상태와 유효한 패치를 쓸 수 있는 상태는 같지 않았던 것이다"라고 정리했습니다(raungni 블로그). 로컬 모델의 도구 호출 점수는 모델 가중치만이 아니라 런타임, 템플릿, 양자화, 샘플링을 합친 결과라고 보는 편이 맞습니다.
틀리고도 "충분하다"고 답하는 조용한 실패
가장 위험한 실패는 틀렸다는 말 없이 "다 됐다"고 보고하는 경우입니다. 원문은 이를 "조용한 실패"라고 불렀고, gpt-oss 20B의 차량 과제를 예로 들었습니다. 필자가 해당 기록(multi_turn_base_58의 세 번째 실행)을 열어 보니 흐름은 이렇습니다.
모델은 출발 도시와 도착 도시의 우편번호를 조회한 뒤, 거리 계산을 마치기도 전에 연료 탱크에 26갤런을 채웠습니다. 이어 거리를 약 980마일로 계산하고, 자기 답변에 연비를 갤런당 25마일로 잡아 980마일에는 약 39갤런이 필요하다고 스스로 적었습니다. 그런데 마지막 상태 보고에는 연료가 "26 gal (≈ 98 L)"이라고 적고 바로 뒤에 "plenty for the ~980-mile trip", 즉 980마일 여행에 충분하다고 썼습니다.
채점기는 이 실행을 상태 불일치로 실패 처리했습니다. 채점기가 없는 실제 업무였다면 사용자는 "충분하다"는 말을 믿고 넘어갔을 것입니다. 한 국내 블로그가 소개한 해외 개발자의 경험담에도, Ollama로 에이전트를 만들다 모델이 "도구를 호출하겠습니다"라고 글만 쓰고 실제 호출은 비어 있어 오류 없이 루프가 끝났다는 이야기가 나옵니다(alpha4ai 블로그). 둘 다 겉으로는 성공처럼 보인다는 점이 같습니다.
원문은 규칙 기반으로 조용한 실패를 골라내 보려 했지만, README에 따르면 사람이 직접 확인한 120건과 규칙의 판정이 82건(68%)만 일치해 비율은 발표하지 않았습니다. 적어도 원문의 규칙으로는 자동 판정이 사람 판정과 잘 맞지 않았습니다. 모델이 쓴 최종 답이 아니라 시스템의 실제 상태를 확인하는 검사가 필요한 이유입니다.
RTX 3090에 맡길 일, 맡기기 전에 잴 것
RTX 3090 한 장의 로컬 LLM도 정해진 도구 호출 업무에서는 클라우드 중급 모델만큼 안정적일 수 있지만, 어떤 업무에서 그런지는 직접 여러 번 돌려 봐야 압니다. 이 실험에서 gemma4 26B는 Sonnet 5.5와 5번 다 성공한 과제 수로 비겼고 Haiku 5.5보다는 분명히 앞섰습니다. 주식 거래처럼 모든 모델이 75% 이상 해낸 시스템이 있는가 하면, 게시판 과제는 Haiku 26%에서 gemma4 67%까지 벌어졌고 파일 시스템 과제에서 gpt-oss는 25%였습니다. 같은 "도구 호출"이라도 업무 종류에 따라 답이 다릅니다.
이 실험에서 실무로 가져갈 만한 점은 네 가지입니다.
- 자기 업무로 pass^k를 잰다. 평균 성공률은 공개 벤치마크로도 짐작할 수 있지만, 가끔 실패하는 과제가 몇 개인지는 자기 업무를 같은 조건으로 여러 번 돌려야 보입니다. 원문처럼 5번만 돌려도 평균과 "5번 다"의 차이는 드러났습니다. 반복을 늘리면 "5번 다" 수치는 더 내려갑니다.
- 두 모델의 차이는 과제 단위로 짝지어 본다. 60개 대 57개처럼 3개 차이는 과제 100개에서 의미가 없을 수 있습니다. 둘 중 하나만 성공한 과제를 세어 보면 차이가 진짜인지, 잘하는 영역이 다른 것인지 알 수 있습니다.
- 답변이 아니라 상태를 검사한다. 조용한 실패는 모델의 말로는 걸러지지 않습니다. 파일, 주문, 연료량처럼 결과로 남는 상태를 확인하는 검사가 있어야 무인 에이전트를 믿을 수 있습니다.
- 설정을 기록하고 바꿔 본다. 온도, 양자화, 확인 질문에 어떻게 답하는지가 모두 숫자를 움직였습니다. 로컬 모델은 모델 카드의 권장값과 런타임의 기본값이 다를 수 있으니 실제로 무엇이 적용됐는지 확인합니다.
이 실험에는 분명한 한계도 있습니다. 과제는 영어 100개뿐이라, 5번 다 성공한 비율 60%에도 대략 ±10포인트의 오차 범위가 붙습니다(필자 계산, 과제 100개 기준 95% 신뢰구간). 원문은 5번 반복이 적은 편이라 반복을 늘리면 "5번 다" 수치가 더 낮아질 수 있다고 적었습니다. Ollama 응답 처리 오류와 API 연결 오류도 실패로 셌는데, 필자가 센 오류 실행은 gpt-oss 7회, gemma4 4회, qwen3.8 3회, Sonnet 2회였습니다. Claude는 확장 사고를 끄고 돌렸고 Opus는 비용 때문에 빠졌습니다. 한국어 지시로 같은 반복 성공률을 잰 공개 자료는 찾지 못했습니다.
로컬 모델을 고르는 이유가 사내 보안이든 비용이든, 판단 기준은 같습니다. 벤치마크 평균이 아니라 내 업무를 다섯 번 시켜 다섯 번 다 해내는 비율입니다. Qwen3.8 27B의 공개 성능 주장을 검증한 내용은 Qwen 3.8 27B 성능 검증에, RTX 5090을 빌려 같은 모델을 돌렸을 때의 비용 계산은 RTX 5090 빌려 Qwen3.8 돌리기에 정리했습니다.
RTX 3090 한 장으로 돌린 gemma4가 정해진 도구 호출 과제에서 클라우드의 Sonnet 5.5와 비겼다는 실측이 나왔습니다. 구독료를 줄이고 싶다면 이제 로컬 LLM을 진지하게 검토해 볼 때라고 필자는 봅니다. 다만 모든 일을 한 번에 옮기기보다, 내 업무를 다섯 번씩 돌려 보고 매번 해내는 일부터 로컬로 옮기는 편이 안전합니다.
출처
- bric.pe.kr 원문: bric.pe.kr/blog/local-llm-tool-use-five-runs-bfcl-claude
- 긱뉴스: news.hada.io/topic?id=36515
- UC Berkeley Gorilla: gorilla.cs.berkeley.edu/blogs/13_bfcl_v3_multi_turn.html
- PyPI bfcl-eval: pypi.org/project/bfcl-eval
- 재현 자료: bric.pe.kr/files/tool-use-five-runs.zip
- τ-bench 논문: arxiv.org/abs/2406.12045
- Sierra 블로그: sierra.ai/blog/benchmarking-ai-agents
- Anthropic 에이전트 평가 가이드: anthropic.com/engineering/demystifying-evals-for-ai-agents
- Anthropic 평가 통계 글: anthropic.com/research/statistical-approach-to-model-evals
- On Randomness in Agentic Evals: arxiv.org/abs/2602.07150
- LFM2.5-24B-A2B 모델 카드: huggingface.co/LiquidAI/LFM2.5-24B-A2B
- Gemma 4 모델 카드: ai.google.dev/gemma/docs/core/model_card_4
- Same Quantization, Different Failures: neurips.cc/virtual/2026/171271
- Flat Score, Amplified Failures: arxiv.org/abs/2607.27275
- 긱뉴스 Gemma 4 Codex CLI 글: news.hada.io/topic?id=28510
- raungni 블로그: blog.naver.com/raungni/224437281132
- alpha4ai 블로그: blog.naver.com/alpha4ai/224452787936