핵심 요약
- 하네스가 Qwen 3.8 27B를 크게 끌어올린 것은 사실입니다. GVS5H는 같은 모델을 새 대화로 여러 번 불러 계획 파일과 메모 파일로 일을 나누게 하는 방식이고, LiveCodeBench 고난도 100문제에서 Qwen3.8-27B의 정답률(pass@1)을 66.8%에서 92.4%로 올렸습니다. 저자들이 공개한 데이터를 다시 채점한 외부 검증도 이 향상은 그대로 인정했습니다.
- "Fable 5를 넘었다"는 말은 저자 표에서도 통계적으로 구분되지 않는 동률입니다. 92.4% 대 90.4%의 차이 2.0점은 p = 0.88이고, LiveCodeBench 기본 채점기로 매기면 84.4% 대 87.4%로 오히려 Fable 5가 앞섭니다. 저자가 고친 채점 버그 두 가지가 Qwen 쪽에 8.0점, Fable 5에 3.0점을 더했습니다.
- 기준선 66.8%는 잘린 답이 많이 섞인 값입니다. 단일 호출 500번 가운데 150번(30%)이 출력 한도 12만 8천 토큰에서 잘렸고, 한도를 25만 토큰으로 늘리면 기준선은 70.0%입니다.
- 생각만큼 싸지도, 가볍지도 않습니다. 하네스를 씌운 Qwen은 100문제를 한 번 푸는 데 출력 토큰을 약 1,863만 개 써서 Fable 5(약 120만 개)의 약 15배를 썼고, 비용은 Fable 5의 약 78%였습니다. 측정은 H200 3장에 모델 복제본을 한 장에 하나씩 올려 했고, 소비자용 GPU 한 장에서 잰 점수는 찾지 못했습니다.
- 문제는 두 모델이 나오기 1년도 더 전의 것입니다. 2024년 12월부터 2025년 4월 사이 대회 문제로, Fable 5의 학습 데이터 마감일(2026년 1월)보다 앞서기 때문에 학습 데이터 오염을 배제할 수 없습니다. 다른 사람이 100문제 전체를 다시 돌려 확인한 결과도 10월 26일 기준으로 찾지 못했습니다.
목차
- Qwen 3.8 27B 성능, 하네스로 얼마나 올랐나
- GVS5H 하네스는 어떻게 동작하나
- Fable 5를 정말 넘었나
- 25.6점은 어디서 왔나
- 숫자는 두 번 바뀌었다
- 토큰과 비용, 정말 싸게 먹히나
- GPU 한 장으로 같은 점수가 나올까
- 오래된 문제와 오염 가능성
- 로컬 코딩 에이전트에 가져다 쓸 수 있는 것
- 출처
Qwen 3.8 27B 성능, 하네스로 얼마나 올랐나
Qwen 3.8 27B 단일 호출의 성능은 LiveCodeBench 고난도 100문제에서 66.8%이고, GVS5H 하네스를 씌우면 92.4%가 됩니다. 저자들이 같은 조건으로 잰 Claude Fable 5 단일 호출은 90.4%입니다. 2026년 9월 21일에 올라온 논문 v2의 표 1 값입니다(arXiv 2608.26480v2). 이 결과가 10월 25일 해커 뉴스에서 약 180점을 받으며 퍼졌고(Hacker News), 같은 날 긱뉴스에도 소개됐습니다(GeekNews).
숫자를 읽기 전에 시험 조건부터 봐야 합니다.
- 시험지: LiveCodeBench release_v6의 고난도(hard) 문제 중 가장 최근 100개입니다. 저자들은 이를 LCB-100이라 부릅니다. 목록은 AtCoder ABC383~ABC400 문제 47개, ARC189~ARC196 문제 26개, LeetCode 문제 27개로 고정돼 있습니다(GVS5H 문제 목록).
- pass@1의 뜻: 문제마다 최종 코드 하나를 제출하고 숨은 테스트를 모두 통과한 비율입니다. 이것을 5번 실행해 평균을 냈습니다. LiveCodeBench 공식 방식은 문제마다 10개를 생성해(temperature 0.2) pass@1을 추정하므로 계산법이 다릅니다(LiveCodeBench GitHub).
- 조건: 호출 한 번의 출력 한도 12만 8천 토큰, 추론(reasoning) 켬. Fable 5는 Anthropic API, Qwen3.8-27B는 저자가 직접 띄운 vLLM 서버에서 FP8 가중치로 돌렸습니다.
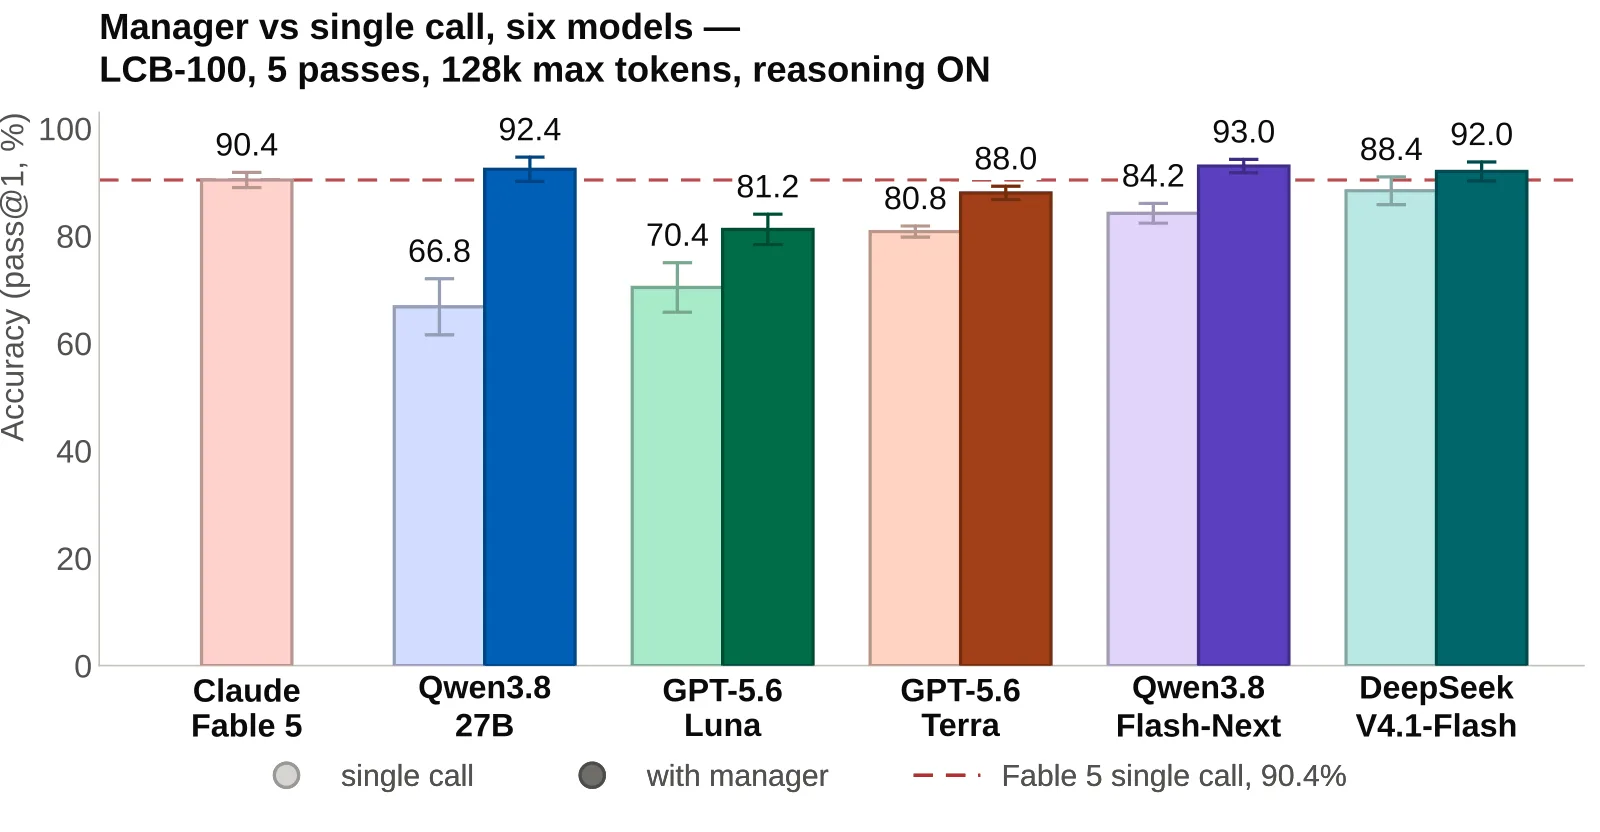
하네스가 모든 모델을 올려 준 것은 아닙니다. 저자들은 11개 구성으로 시험했고 "Gains are not universal: some models are unchanged or worse"라고 직접 적었습니다. 고정된 서버로 5번씩 돌려 하네스를 씌운 5개 모델은 모두 올랐지만, OpenRouter를 거쳐 이전 버전 하네스로 대부분 한 번만 돌린 모델 중에는 Kimi-K3(86 → 86)처럼 그대로이거나 Qwen3.6-35B(추론 끈 조건 35 → 27)처럼 떨어진 경우도 있습니다. README 그래프의 Opus 5(88 → 95)도 이전 버전 하네스로 OpenRouter를 거쳐 한 번만 돌렸다는 각주가 달려 있습니다(GVS5H README). 조건이 다르니 고정 서버 결과와 나란히 놓고 비교하기는 어렵다고 보는 편이 안전합니다(필자 해석).
GVS5H 하네스는 어떻게 동작하나
GVS5H는 모델을 다시 학습시키지 않고, 같은 모델을 매번 새 대화로 불러 "계획 세우기, 아이디어 내기, 작업 나누기, 코드 쓰기"를 역할별로 맡기는 실행 틀(하네스)입니다. 역할끼리는 대화를 주고받지 않고 디스크의 공유 파일로만 이어집니다. 이름은 "Gorilla vs. 5 Humans"의 줄임말로, 어깨를 딛고 선 아이 다섯이 고릴라 한 마리의 키에 닿는다는 그림에서 왔습니다(GVS5H README).
논문이 설명하는 작업 공간은 파일 다섯 개입니다(arXiv 2608.26480v2).
task.md: 문제 원문plan.md: 매니저의 전체 계획(최대 4,000자)tasks.json: 작업 목록 사본notes.md: 아이디어, 발견, 부분 증명(최대 8,000자)solution.py: 지금까지의 풀이
흐름은 이렇습니다. 매니저가 3~6문장짜리 전략과 첫 작업 3~6개를 쓰면, 워커가 코드 없이 접근법만 적고, 매니저가 다음 작업 하나를 골라 맡깁니다. 워커는 그 작업을 하면서 solution.py와 notes.md를 고쳐 씁니다. 새 코드가 나오면 검증 단계가 문제의 공개 예제 테스트로 그 코드를 실행하고, 통과 여부와 처음 실패한 예제를 매니저에게 돌려줍니다. 매니저와 워커의 왕복은 최대 10번입니다.
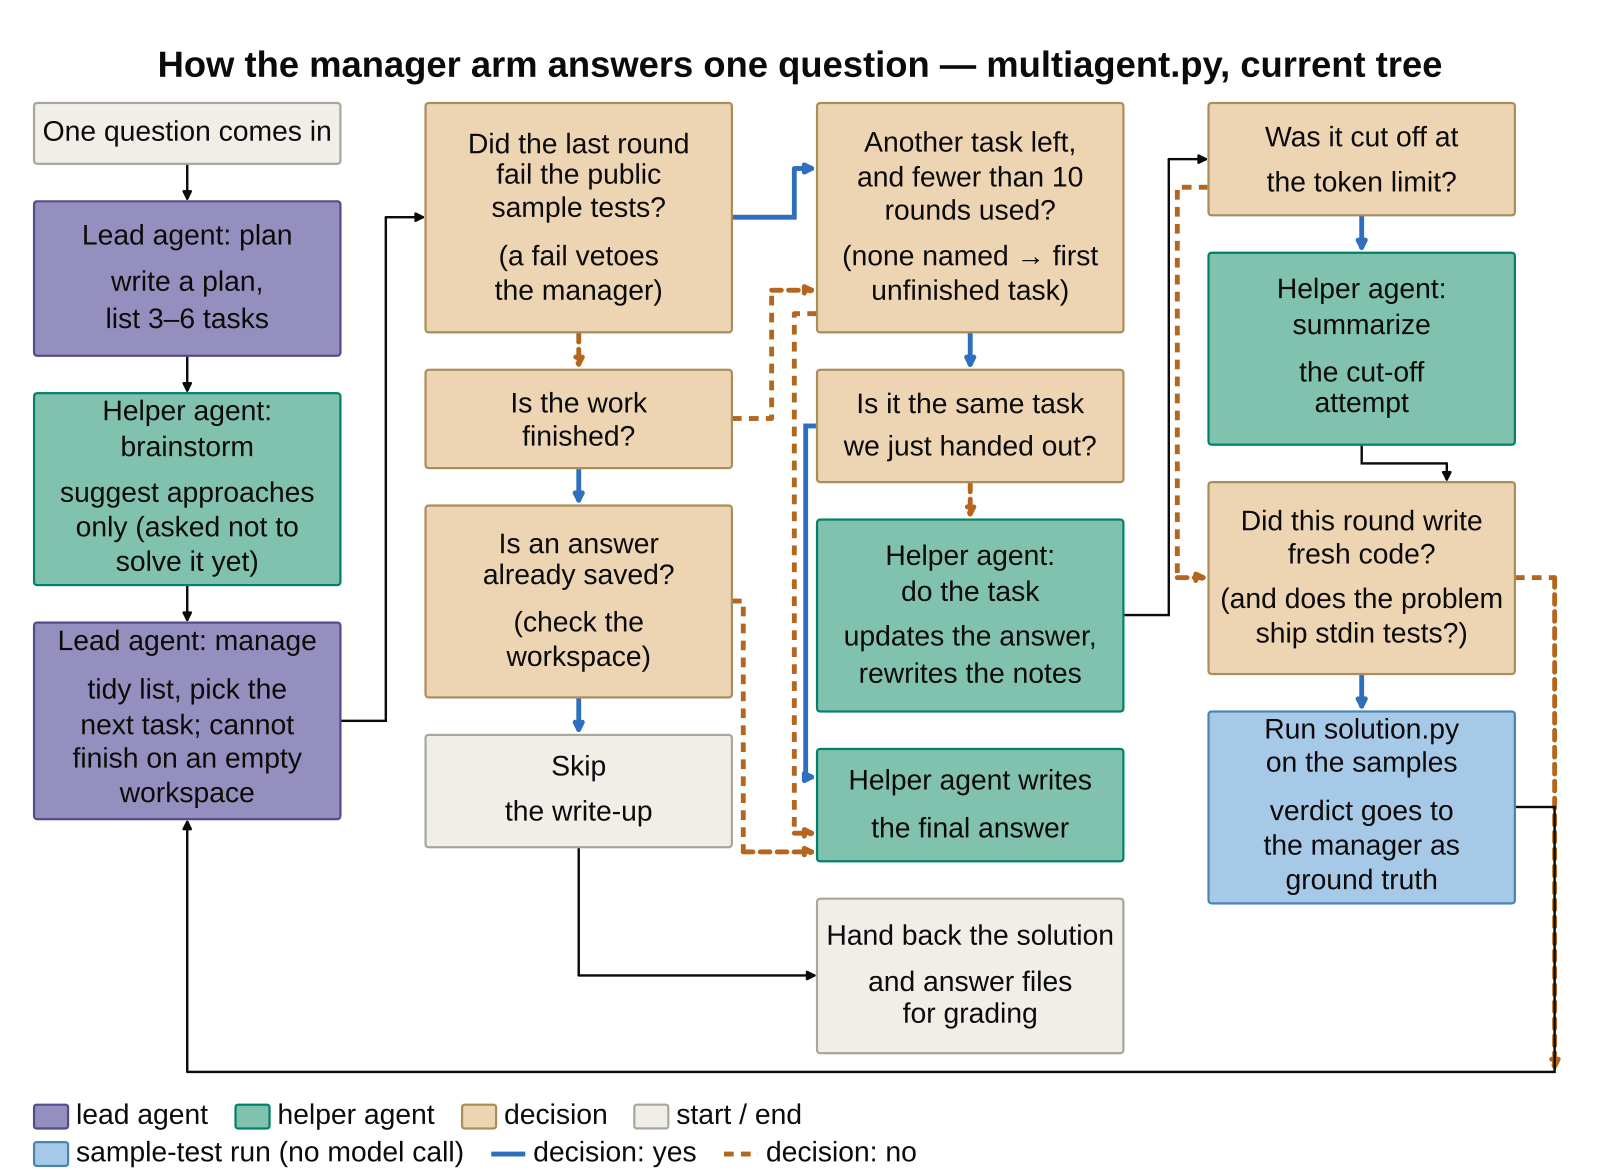
저장소 제목의 "Five Qwen3.8-27B Models"(모델 5개)는 Qwen 다섯 개를 동시에 띄운다는 뜻이 아닙니다. 같은 모델을 새 대화로 차례차례 부르는 횟수에 가깝습니다. 저장소에 공개된 결과 파일로 세어 보면 Qwen3.8-27B 매니저 쪽은 500번(100문제 × 5회)의 풀이에 모두 3,235번을 호출해 문제당 평균 6.47번, 중앙값 5번, 최대 28번을 불렀습니다(필자 계산, 논문의 호출 합계 3,235와 같습니다).
Fable 5를 정말 넘었나
저자 표에서도 "넘었다"가 아니라 "구분되지 않는다"입니다. 표 1은 Qwen3.8-27B 매니저와 Fable 5의 차이를 +2.0점, 문제 단위 순열 검정 p = 0.88, 단측 95% 하한 -0.8점으로 적었습니다. p = 0.88(비교 다섯 개에 대한 Holm 보정 후 값)은 이 데이터로는 2.0점 차이가 우연이 아니라고 볼 근거가 없다는 뜻이고, 단측 95% 하한 -0.8점은 Fable 5보다 0.8점 낮을 가능성까지 데이터가 열어 둔다는 의미입니다.
저장소 제목은 "Five Qwen3.8-27B Models Match Claude Fable 5"로 "필적"까지만 말합니다. 그런데 본문과 README 초록의 표현은 조금씩 앞서 나갑니다(필자 해석). 논문 본문은 "reaching Fable 5's single-call range"라고 쓰면서 "edges ahead of Fable 5"(조금 앞선다)라는 표현도 함께 썼습니다(arXiv 2608.26480v2). README 초록에는 한동안 "slightly exceeding Fable 5"라는 문장이 있었고, 지금 초록에도 "slightly exceed it"이라는 표현이 남아 있습니다. "넘었다"는 말은 저자들의 이런 표현에서 시작해 긱뉴스의 "웃돎" 같은 2차 소개로 퍼졌습니다. 이 글 제목의 "동률"도 두 모델이 같다는 뜻이 아니라, 이 데이터로는 어느 쪽이 낫다고 구분할 수 없다는 뜻입니다.
기본 채점기로 매기면 순서가 뒤집힙니다
LiveCodeBench에 들어 있는 채점기를 그대로 쓰면 Qwen3.8-27B 매니저는 84.4%, Fable 5는 87.4%로 Fable 5가 3.0점 앞섭니다. 보고된 92.4% 대 90.4%는 저자들이 채점기를 두 군데 고친 뒤의 숫자입니다(논문 부록 B와 보정표).
- 입력 처리 버그: LiveCodeBench 채점기는 표준 입력을 가짜 객체로 바꿔 코드를 실행하는데, 이 객체의
sys.stdin.buffer.readline()이 몇 번을 불러도 첫 줄만 돌려줬습니다. 고정 서버 결과 중 코드를 낸 5,425건 가운데 371건이 이 입력 방식을 썼고, 그중 86%가 오답 처리됐습니다(이 방식을 쓰지 않은 답은 18%). Fable 5는 이 방식을 한 번도 쓰지 않아 점수가 그대로였습니다. - 정답이 여러 개인 문제: abc396_e, arc190_a, arc195_c처럼 정답을 여러 개 인정하는 문제와 실수 답을 요구하는 abc385_f, 이렇게 4문제를 대회 규칙대로 다시 채점했습니다.
두 보정 모두 기본 채점기가 오답으로 본 답만 다시 실행하므로 정답을 오답으로 바꾸지는 않습니다. 결과로 Qwen 매니저는 +8.0점(입력 버그 +5.4, 정답 여러 개 문제 +2.6), Fable 5는 +3.0점(정답 여러 개 문제만)을 받았습니다.
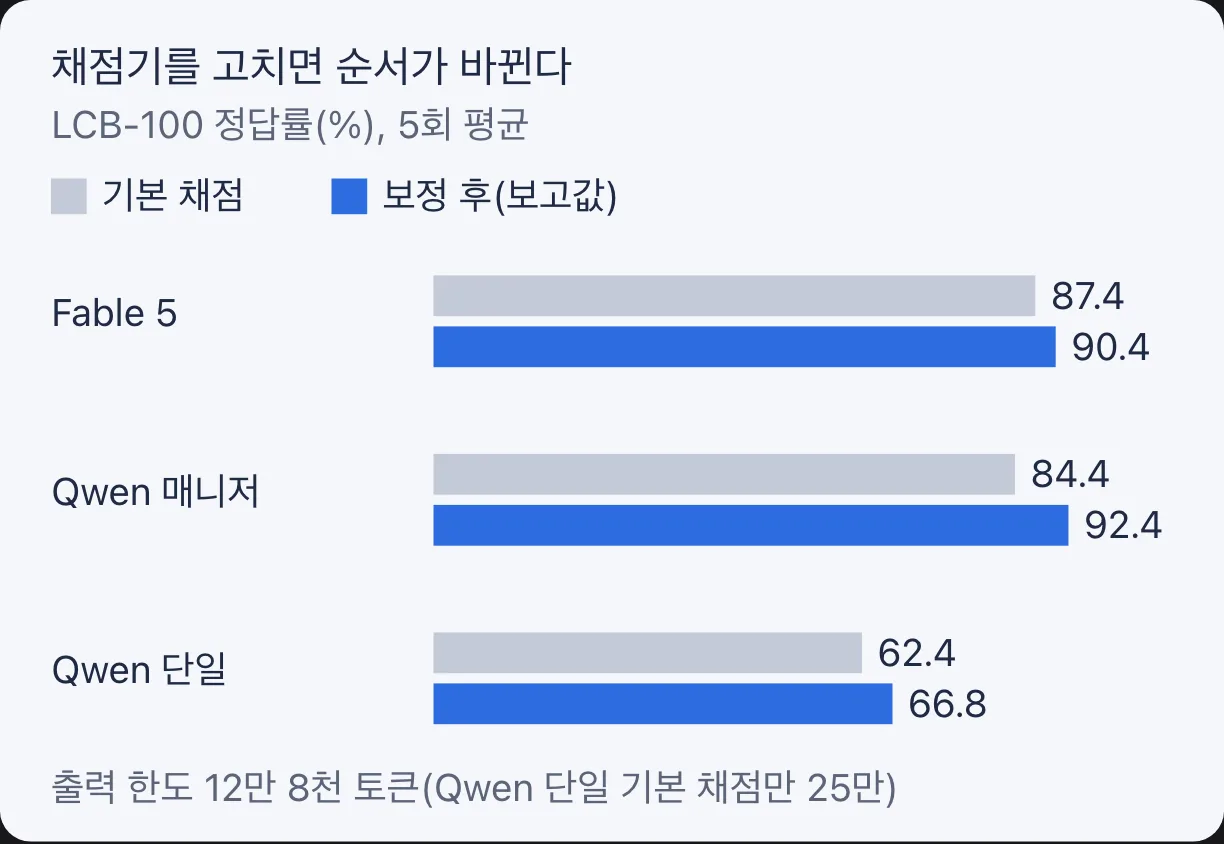
보정이 부당하다고 볼 근거는 없습니다. 저자들은 보정 전 판정을 결과 파일에 남겨 두었고, 필자가 저장소의 결과 파일로 다시 계산해 봐도 보정 전 84.4%와 87.4%, 보정 후 92.4%와 90.4%가 그대로 나왔습니다. 다만 "기본 채점기로는 Fable 5가 앞선다"는 숫자는 논문 부록 B와 보정표에만 있고, 저장소 제목과 초록에는 없습니다.
외부 재채점도 "구분되지 않는다"였습니다
CyberNative AI는 10월 25일 자체 채점기와 재현용 Docker 환경을 함께 공개한 GitHub 노트에서 저장소에 남은 풀이 2,500개를 다시 채점했습니다. 동료 심사를 거친 자료는 아니고, 모델을 다시 돌리지도 않았습니다. 결론은 "보정은 타당하지만 2.0점 차이는 0과 통계적으로 구분되지 않는다(95% 구간 -1.0 ~ +5.4)"였고, 그렇다고 두 모델이 같다는 것을 보여 주지도 않는다고 덧붙였습니다(CyberNative AI 재채점 노트). 이 노트는 몇 가지를 더 짚었습니다.
- Fable 5의 답변 거부: Fable 5는 500번 중 6번 안전 거부로 답을 내지 않았는데, 이 거부가 2.0점 차이 중 1.2점을 차지합니다. 논문도 한계 절에서 거부가 점수를 0~1.2점 낮췄다고 적었습니다.
- 실행 시간 제한: 논문은 보고 수치에 어떤 시간 제한을 썼는지 밝히지 않았고, 재채점 스크립트 기본값은 테스트당 10초입니다. LiveCodeBench의 6초 제한을 적용하면 매니저 쪽은 91.0~91.4%로 내려갑니다. 같은 조건에서 Fable 5는 90.4%로 그대로라 차이는 0.6~1.0점으로 줄어듭니다. 다만 이 값은 CyberNative AI의 장비에서 잰 것이고, 노트 스스로 자기 장비가 저자들의 채점 환경보다 느려 보인다고 적었습니다.
Fable 5 90.4%가 공식 수치가 아니라는 점도 알아 둘 만합니다. 저자들이 Anthropic API로 직접 돌린 값이고, Fable 5에는 하네스를 씌우지 않았습니다. 논문은 "Fable 5에 하네스를 씌우면 얼마나 오를지는 알 수 없다"고 썼습니다. 해커 뉴스에서도 "하네스를 씌운 Qwen을 하네스를 씌운 다른 모델과 비교해야 한다"는 지적이 나왔습니다(Hacker News 댓글).
25.6점은 어디서 왔나
향상의 일부는 "잘린 답을 피한 효과"이고, 나머지는 하네스 자체의 효과입니다. 외부 재채점은 단순히 여러 번 뽑아서 나온 점수가 아니라는 점을 데이터로 확인했습니다.
기준선 66.8%에는 잘린 답이 30% 섞여 있습니다
Qwen3.8-27B는 생각을 길게 하는 모델입니다. 단일 호출 500번 가운데 150번(30%)이 12만 8천 토큰 한도에서 잘렸고, 35번(7%)은 코드를 하나도 내지 못했습니다. 8번은 추론 도중 불안정해져 코드를 내지 못한 채 25만 토큰을 다 썼고, 그중 abc399_e에서는 한 구절을 7,743번 되풀이했습니다(논문 3.3절, 4절).
그래서 기준선은 출력 한도에 민감합니다. 저자들은 단일 호출을 원래 25만 토큰 한도로 생성했고, 매니저 쪽(호출당 12만 8천)과 맞추려고 저장된 답을 12만 8천 토큰에서 잘라 다시 채점했습니다. 25만 토큰 그대로 두면 기준선은 70.0%이고, 12만 8천 토큰 기준에서도 코드를 낸 경우만 세면 71.8%입니다. 저자들도 단일 호출이 코드를 내지 못한 35번 중 28번을 매니저가 풀었고 이것이 5.6점어치라고 적었습니다. 매니저는 호출마다 12만 8천 토큰을 쓸 수 있으니 문제 하나에 쓰는 전체 출력은 단일 호출보다 훨씬 큽니다.
공개 예제 실행은 매니저 쪽만 받습니다
매니저 쪽은 풀이 도중에 공개 예제 테스트를 실제로 돌려 결과를 받습니다. 단일 호출과 Fable 5는 한 번 답하고 끝납니다. 숨은 테스트가 새지는 않고 최종 제출도 문제당 하나지만, LiveCodeBench의 기본 시나리오인 "도구 없이 한 번에 풀기"와는 조건이 다릅니다. 해커 뉴스에서는 "도구 없이 푸는 벤치마크에 위임과 파이썬 실행을 붙여 이겼다면 그건 벤치마크 방식이 아니다"라는 비판이 나왔습니다(Hacker News 댓글).
그런데 이 피드백이 향상의 대부분을 설명하지는 못합니다. 공개 예제 실행은 표준 입력 형식 예제가 있는 73문제에서만 돌아가고, 나머지 LeetCode형 27문제에는 검증 단계가 없습니다. CyberNative AI의 재채점에 따르면 검증이 없는 27문제에서도 72.6%에서 97.8%로, 검증이 있는 73문제(64.7%에서 90.4%)와 비슷하게 올랐습니다. Fable 5와의 2.0점 차이도 대부분(1.6점) 검증 단계가 없는 이 27문제에서 나왔습니다.
여러 번 뽑은 효과만으로는 92.4%가 안 나옵니다
"모델을 여러 번 부르면 그중 하나는 맞히는 것 아니냐"는 의심도 있습니다. 같은 재채점 노트는 단일 호출 5번 중 정답을 완벽하게 골라내는 경우를 가정해도 90.0%에 그쳐 매니저의 92.4%보다 낮다고 계산했습니다. 논문의 문제 단위 비교에서도 매니저만 맞힌 경우가 134번, 단일 호출만 맞힌 경우가 6번이었습니다. "같은 모델이라도 파일로 계획과 메모를 나누고 실행 결과를 보며 고치게 하면 크게 좋아진다"는 주장은 탄탄한 편입니다.
숫자는 두 번 바뀌었다
지금의 66.8% → 92.4%, Fable 5 90.4%는 처음 공개된 숫자가 아닙니다. README의 커밋 이력과 arXiv 버전을 비교하면 같은 생성 결과를 다시 채점하면서 숫자가 바뀌어 왔습니다(GVS5H README 커밋 이력, arXiv 2608.26480v1).
| 시점 | Qwen3.8-27B 단일 → 매니저 | Fable 5 | 무엇이 바뀌었나 |
|---|---|---|---|
| 2026-08-27 논문 v1 | 63.0 → 86.4 | 87.4 | 입력 버그만 보정. Qwen은 Fable 5보다 낮았고 헤드라인은 GPT-5.6-Terra |
| 2026-09-11 README | 69.2 → 92.4 | 90.4 | 정답 여러 개인 문제 재채점 추가 |
| 2026-09-21 논문 v2 | 66.8 → 92.4 | 90.4 | 재채점 스크립트 버그 수정("fix rescore")으로 기준선 하락, 최대 향상폭 23.2 → 25.6점 |
두 번째 변경은 기준선만 내렸습니다. 12만 8천 토큰에서 자른 답 대신 25만 토큰 원본의 판정을 읽던 버그를 고친 것입니다(스크립트 주석은 이 버그로 13건이 정답으로 되살아나 있었다고 적었습니다). 그 결과 기준선이 69.2%에서 66.8%로 2.4점 내려가면서 "최대 향상폭"이 커졌습니다. "기준선 69.2%, 9개 모델, 최대 23.2점"이라는 숫자는 Chroma01 포크가 9월 12일에 복사해 둔 중간판 README 숫자이고, 독립 측정이 아닙니다. 그 포크도 9월 24일 원본과 동기화돼 지금은 같은 숫자를 보여 줍니다(Chroma01/GVS5H).
논문은 동료 심사 전 프리프린트이고 저자 소속은 Persis Capital Inc.입니다(arXiv 2608.26480). 저장소에 있는 논문 원본에는 소속지가 토론토로 적혀 있고, 받은 연구비가 없으며 이해관계도 없다는 선언이 들어 있습니다(GVS5H 논문 원본).
토큰과 비용, 정말 싸게 먹히나
하네스를 씌운 Qwen3.8-27B는 Fable 5보다 조금 싼 대신 출력 토큰을 약 15배(15.5배) 씁니다. 그리고 "싸다"는 결론은 Qwen 토큰 단가를 얼마로 잡느냐에 달려 있습니다. 논문 비용표(100문제 1회 실행 기준)를 그대로 옮기면 다음과 같습니다(arXiv 2608.26480v2).
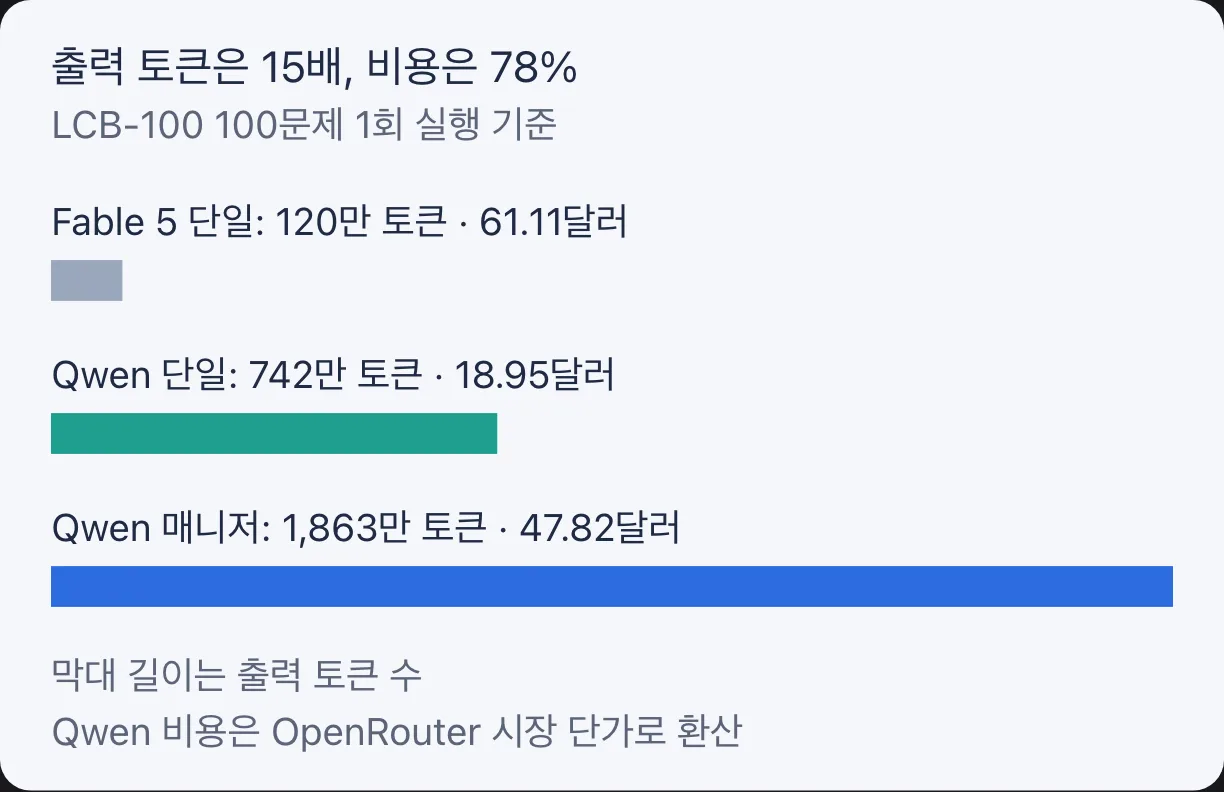
여기서 세 가지를 짚어야 합니다.
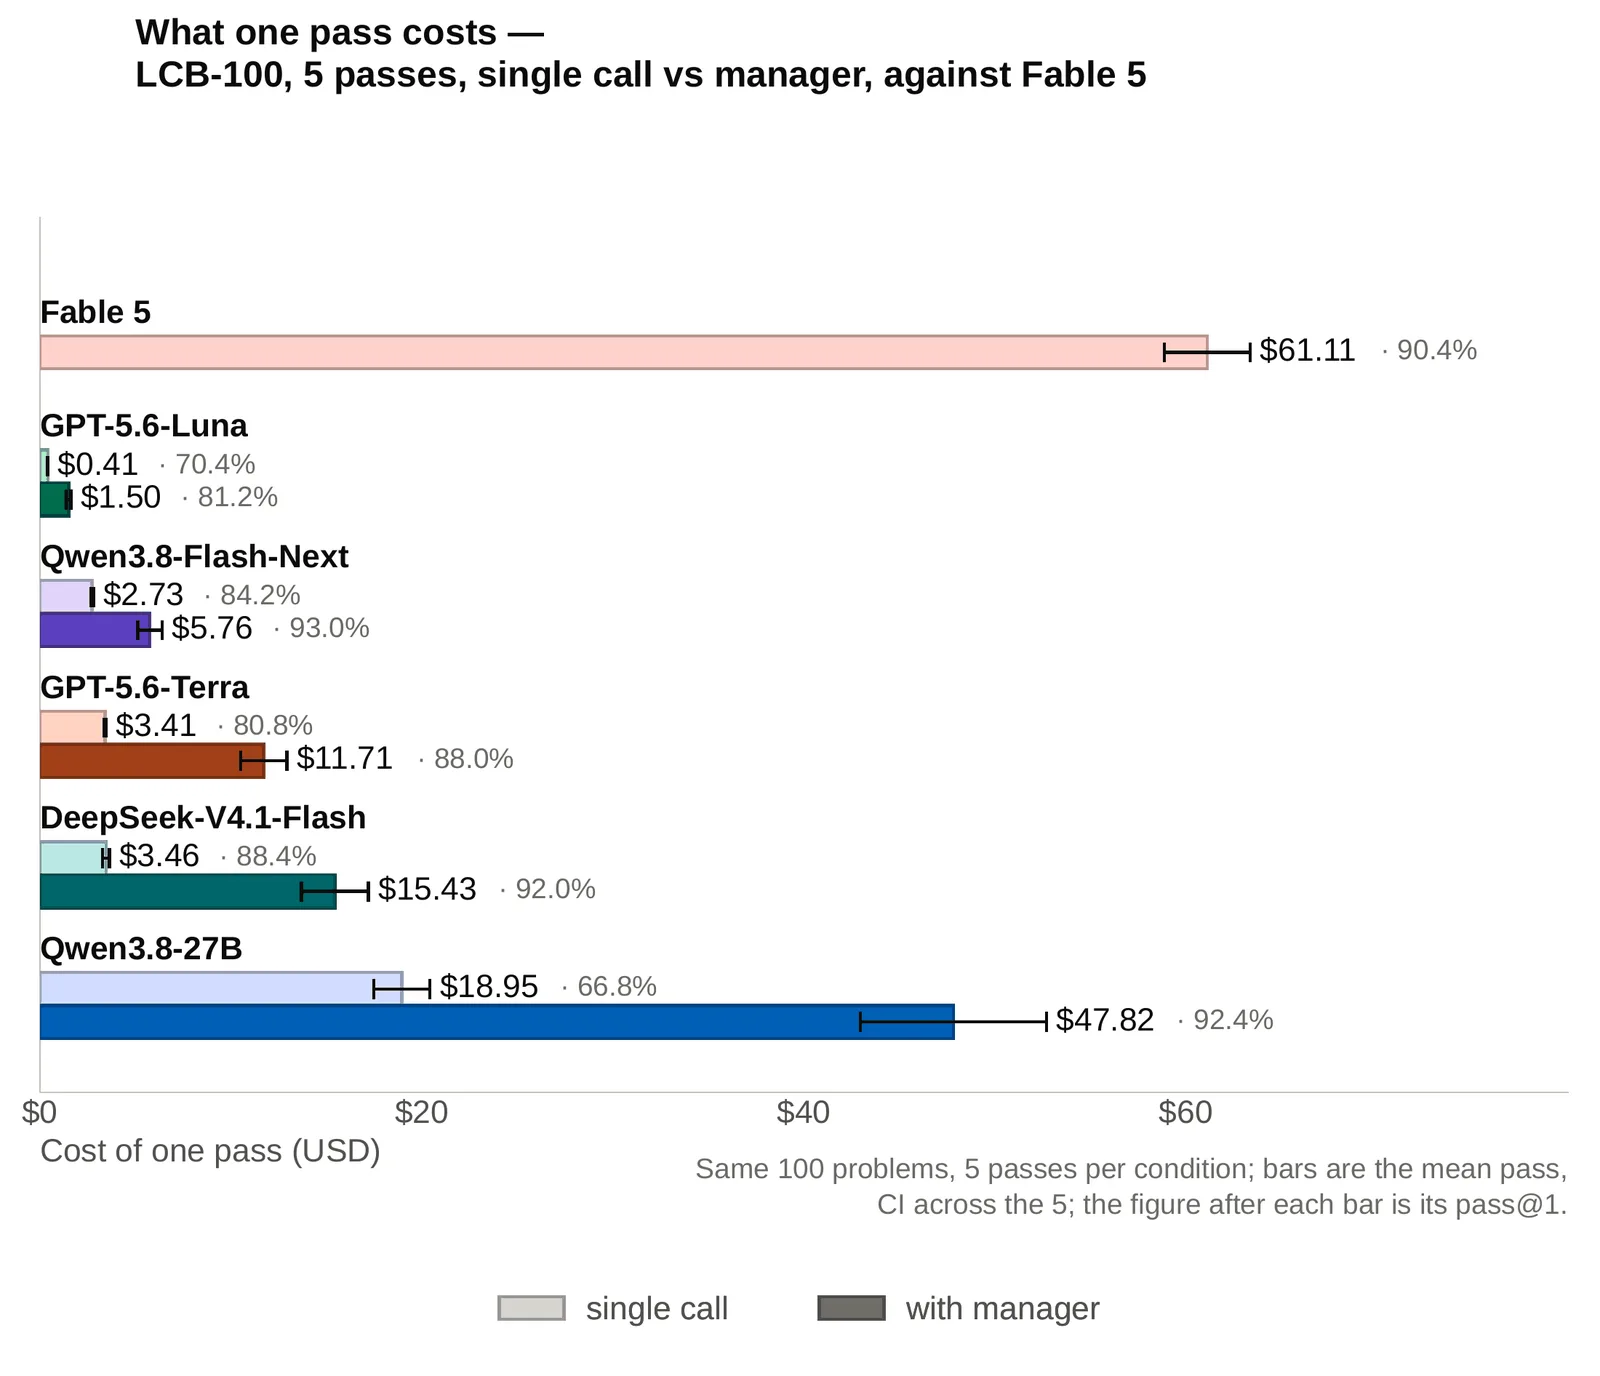
- "5분의 1 가격"과 "9%"는 Qwen3.8-27B 숫자가 아닙니다. 저장소 설명은 "Five Qwen3.8-27B Models Match…" 바로 뒤에 "Fable 5 Level Coding for a Fifth the Price"를 붙여 두어 Qwen3.8-27B의 숫자처럼 읽히지만, Qwen3.8-27B 매니저의 비용은 Fable 5의 약 78%입니다(47.82 ÷ 61.11, 필자 계산). 5분의 1보다 싼 비용으로 Fable 5 수준의 점수를 낸 것은 토큰마다 60억 개 파라미터만 쓰는 MoE 모델 Qwen3.8-Flash-Next의 매니저(5.76달러, 93.0%, Fable 5와의 차이는 p = 0.56으로 통계적으로 구분되지 않음)이고, 많이 인용되는 "Fable 5의 9% 비용"도 이 구성의 숫자입니다. "5분의 1 가격"이라는 말 자체는 처음에 GPT-5.6-Terra 매니저(11.71달러)를 두고 나왔습니다.
- Qwen 비용은 실제 GPU 비용이 아닙니다. 저자들은 직접 띄운 Qwen도 OpenRouter 시장 단가(입력 0.21달러, 출력 2.55달러/백만 토큰)로 환산했습니다. 그리고 그림 4 캡션에 "단가가 1.28배면 Fable 5 대비 비용 우위가 완전히 사라진다"고 직접 적었습니다.
- 단일 호출을 여러 번 돌리는 편이 더 비쌉니다. 단일 호출 다섯 번은 94.75달러로 매니저 한 번(47.82달러)의 약 두 배입니다(CyberNative AI 재채점 노트). 같은 돈이면 여러 번 뽑기보다 하네스가 낫다는 뜻입니다.
실행 시간은 논문 어디에도 없습니다. 참고할 만한 것은 일화뿐입니다. 이 방식을 자기 환경에 옮겨 본 해커 뉴스 사용자는 추론을 끄고 빠른 Cerebras 서버를 써도 문제 하나에 약 3분, 100문제에 약 1시간 반이 걸렸다고 했습니다(Hacker News 댓글).
GPU 한 장으로 같은 점수가 나올까
저자들이 92.4%를 잰 장비는 소비자용 GPU 한 장이 아니라 H200 3장입니다. 재현 이슈에 단 저자 측 답변을 보면, 공개된 FP8 가중치 Qwen/Qwen3.8-27B-FP8을 vLLM으로 띄웠습니다. 모델 복제본 하나를 GPU 한 장에 올리고(tensor parallel 1), 이런 복제본 3개로 요청을 나눠 처리했습니다(data parallel 3). 컨텍스트는 26만 2,144토큰이었습니다(GVS5H 이슈 #4). 저장소 설명의 "on a Single GPU"는 복제본 하나가 데이터센터 GPU 한 장에 들어간다는 의미로는 맞지만, 24~32GB 카드에서 4비트로 줄여 돌렸을 때 몇 점이 나오는지 잰 결과는 10월 26일 기준으로 찾지 못했습니다.
RTX 5090 한 장에는 원본 FP8도 사실상 들어가지 않고 4비트 버전을 써야 한다는 점은 RTX 5090 빌려 Qwen3.8 돌리기에서 정리했습니다. NVIDIA가 낸 4비트(NVFP4) 버전의 자체 측정에서도 6개 지표 중 4개가 조금씩 낮아졌습니다(GPQA 88.92에서 88.01 등)(Hugging Face, nvidia/Qwen3.8-27B-NVFP4).
속도도 따져 볼 만합니다. 비용표에 따르면 매니저 쪽은 100문제에 출력 토큰 약 1,863만 개, 문제당 평균 약 18만 6천 개를 씁니다(필자 계산). 초당 40토큰을 낸다고 가정하고 요청을 하나씩 차례로 생성하면 문제 하나에 약 78분이 걸리는 양입니다(필자 계산, 입력 처리 시간과 동시 요청은 뺀 값). 국내에서도 RTX 4080 16GB에 Qwen 3.8 27B 3비트 양자화 모델을 올려 코딩 에이전트로 쓸 만하다는 사용기가 있는 반면(클리앙), 맥 미니 M4 24GB에서는 27B가 한계에 가깝다는 사용기도 있습니다(네이버 블로그 pinaya). 개인 장비에서는 "점수"보다 "기다림"이 먼저 벽이 됩니다.
재현 상황도 같은 이야기를 합니다. L40 48GB와 RTX 4090 24GB를 묶어 재현을 시도한 사용자는 첫 5문제를 모두 통과했지만, 46번 호출에 토큰을 약 251만 개 썼고 그중 arc196_c 한 문제가 약 167만 개를 차지했습니다. 이 사용자는 5문제 결과를 "내 환경에서 하네스가 돌아간다는 증거일 뿐, 원래 서버 설정과 같다는 증거는 아니다"라고 선을 그었습니다(GVS5H 이슈 #4). 10월 26일 현재 100문제 전체를 다시 돌린 독립 재현은 찾지 못했습니다.
오래된 문제와 오염 가능성
LCB-100은 2024년 12월부터 2025년 4월 사이 대회 문제이고, 두 모델은 그보다 1년 이상 뒤에 나왔습니다. 그래서 이 시험은 학습 데이터 오염을 걸러 내지 못합니다. AtCoder 기준으로 ABC383은 2024년 12월 7일, ABC400은 2025년 4월 5일에 열렸습니다(AtCoder ABC383, AtCoder ABC400).
LiveCodeBench가 오염을 피하는 원리는 문제마다 공개 날짜를 붙이고 "모델의 학습 마감일 이후에 나온 문제로만 평가"하는 것입니다(LiveCodeBench). 논문은 최신 문제를 골라 오염을 "줄였다"고 썼지만, 모델별 학습 마감일과 문제 날짜를 대조하지는 않았습니다. Anthropic 공식 문서에 따르면 Fable 5의 학습 데이터 마감일은 2026년 1월이라(Claude Fable 5 문서) LCB-100 100문제는 모두 그보다 앞섭니다. Qwen3.8은 학습 마감일을 공개하지 않았습니다. 이 원칙대로라면 LCB-100은 적어도 Fable 5에게는 오염을 걸러 낸 시험이 아니고, 오염이 실제로 있었는지는 시험되지 않은 상태입니다.
해커 뉴스 스레드 맨 위 댓글은 이 점을 가장 세게 짚었습니다. "2025년 초의 포화된 코딩 벤치마크에서 대략 비슷했다는 것뿐이고, 오염은 사실상 확실하니 이 평가로는 하네스가 좋은지 알 수 없다"는 의견입니다(Hacker News 댓글). 벤치마크가 하나뿐이라는 점도 함께 지적됐습니다. 오염이 있었다면 Qwen 단일 호출과 매니저는 같은 모델이라 함께 영향을 받으므로, 하네스가 끌어올린 폭은 상대적으로 덜 흔들립니다. 반면 Qwen3.8은 Fable 5보다 늦게 공개된 모델이라 오염 정도가 다를 수 있다는 지적이 해커 뉴스에서 나왔습니다(Hacker News 댓글). 그래서 "Fable 5급"이라는 절대 비교는 이 문제를 피하기 어렵습니다(필자 해석). 벤치마크 점수와 실제 긴 작업 결과가 어떻게 다른지는 Opus 5.5와 GPT-6 Astra를 직접 돌려 본 글에도 정리했습니다.
로컬 코딩 에이전트에 가져다 쓸 수 있는 것
GVS5H에서 바로 가져갈 것은 점수가 아니라 구조, 요즘 말로 하네스 엔지니어링입니다. 계획과 메모를 파일에 두고, 매번 새 대화로 부르고, 실행 결과를 정답 기준으로 삼는 방식입니다. 이 구조를 이미 손으로 비슷하게 하는 사람들도 있습니다. 해커 뉴스에는 "PLAN.md에 지금 계획을 쓰고 작업은 계획 파일이나 이슈 트래커에 둔다"는 댓글이 달렸고(Hacker News 댓글), 국내에서도 계획은 상위 모델에 맡기고 실제 작업은 로컬 Qwen 3.8 27B가 TODO 파일을 따라 진행하게 해 중간 규모 작업을 해냈다는 사용기가 있습니다(클리앙). 하네스를 걷어내자 같은 실수를 수십 번 되풀이하는 루프에 빠졌다는 경험담도 있습니다(아카라이브).
직접 써 볼 때 논문에서 건질 점을 정리하면 다음과 같습니다.
- 기억은 대화가 아니라 파일에 둡니다. 매번 새 대화로 부르면 긴 대화에서 생기는 혼선과 잘림을 피할 수 있습니다. 대신
plan.md4,000자,notes.md8,000자처럼 파일 길이에 상한을 둬야 문맥이 다시 불어나지 않습니다. 에이전트가 읽을 문서를 어떻게 나눌지는 AI 코딩에 DDD가 중요한 이유에서 다뤘습니다. - "완료" 판정은 모델이 아니라 테스트가 합니다. GVS5H는 공개 예제가 실패하면 매니저가 끝났다고 해도 반복을 계속합니다. 내 프로젝트라면 단위 테스트나 타입 검사가 이 자리에 들어갑니다.
- 라운드 상한을 둡니다. GVS5H는 매니저와 워커의 왕복을 10번으로 묶었습니다. 상한이 없으면 토큰이 끝없이 나갑니다.
- 토큰과 시간을 먼저 잽니다. 같은 모델로 정답률이 오르는 대신 출력 토큰이 2.5배 늘었습니다. API로 쓰면 비용, 로컬로 쓰면 대기 시간이 그만큼 늘어나므로 내 작업 몇 개로 먼저 재 보는 편이 안전합니다.
벤치마크 하나에서 저자들이 직접 잰 결과라는 한계는 남습니다. 그래도 "작은 오픈 모델이라도 실행 틀을 잘 짜면 크게 좋아진다"는 부분은 공개 데이터와 외부 재채점이 함께 뒷받침합니다. 과장된 쪽은 "Fable 5를 넘었다"는 문구입니다. "5분의 1 가격"은 Qwen3.8-27B가 아니라 Qwen3.8-Flash-Next 같은 다른 구성의 숫자라, Qwen3.8-27B 이야기로 읽으면 안 됩니다.
출처
- arXiv 2608.26480v2: arxiv.org/html/2608.26480v2
- Hacker News: news.ycombinator.com/item?id=50228167
- GeekNews: news.hada.io/topic?id=35963
- GVS5H 문제 목록: github.com/slee-persis/GVS5H/blob/master/codebase/v2-current/escalation…
- LiveCodeBench GitHub: github.com/LiveCodeBench/LiveCodeBench
- slee-persis/GVS5H: github.com/slee-persis/GVS5H
- CyberNative AI 재채점 노트: github.com/CyberNative-AI/.github/tree/main/notes/gvs5h-independent-reg…
- Hacker News 댓글: news.ycombinator.com/item?id=50228740
- Hacker News 댓글: news.ycombinator.com/item?id=50228420
- GVS5H README 커밋 이력: github.com/slee-persis/GVS5H/commits/master/README.md
- arXiv 2608.26480v1: arxiv.org/html/2608.26480v1
- Chroma01/GVS5H: github.com/Chroma01/GVS5H
- arXiv 2608.26480: arxiv.org/abs/2608.26480
- GVS5H 논문 원본: github.com/slee-persis/GVS5H/blob/master/paper/paper_latest.tex
- Hacker News 댓글: news.ycombinator.com/item?id=50235925
- GVS5H 이슈 #4: github.com/slee-persis/GVS5H/issues/4
- Hugging Face, nvidia/Qwen3.8-27B-NVFP4: huggingface.co/nvidia/Qwen3.8-27B-NVFP4
- 클리앙: clien.net/service/board/park/19252438
- 네이버 블로그 pinaya: blog.naver.com/pinaya/224452081978
- AtCoder ABC383: atcoder.jp/contests/abc383
- AtCoder ABC400: atcoder.jp/contests/abc400
- LiveCodeBench: livecodebench.github.io
- Claude Fable 5 문서: platform.claude.com/docs/en/models/fable-5/overview
- Hacker News 댓글: news.ycombinator.com/item?id=50228389
- Hacker News 댓글: news.ycombinator.com/item?id=50234585
- Hacker News 댓글: news.ycombinator.com/item?id=50228427
- 아카라이브: arca.live/b/alpaca/180054707