핵심 요약
- AI 하네스는 LLM이 쓴 텍스트를 행동으로 바꿔 주는 실행 틀입니다. 모델은 글자만 만들 수 있습니다. 하네스가 도구 목록과 호출 문법을 알려 주고, 모델이 그 문법으로 답하면 파일을 읽거나 명령을 실행한 뒤 결과를 돌려줍니다. 그래서 "에이전트 = 모델 + 하네스"라고 부릅니다.
- Claude Code는 하네스 그 자체라기보다 하네스를 품은 인터페이스에 가깝습니다. 사람이 보는 화면과 모델이 쓰는 실행 틀이 한 제품에 묶여 있습니다. 국내에서는 CLAUDE.md, 스킬, 훅처럼 사용자가 덧붙이는 설정을 하네스라 부르는 경우가 많아 뜻이 갈립니다. 제작사가 만든 하네스와 사용자가 덧붙이는 하네스로 나눠 보면 정리됩니다.
- "하네스 차이는 3~5%뿐"이라는 Theo의 말은 OpenAI 모델과 통제 실험에서는 대체로 맞습니다. 113개 과제를 하네스 5종에서 돌린 8090 Labs 실험에서 GPT-5.6 계열 세 모델은 Claude Code와 Codex 사이 차이가 0.4~3.1점이었고, HarnessTax 실험에서 하네스가 정답률에 준 평균 효과는 ±2~5% 안쪽이었습니다.
- 다른 실험에서는 같은 모델이 수십 점씩 갈렸습니다. GLM 5.3 Flash가 하네스에 따라 24%와 59%로 갈렸고, 편집 도구 하나만 바꿨는데 Grok Code Fast 1이 6.7%에서 68.3%가 됐습니다. Claude Fable 5.1도 Claude Code에서 41%, Codex에서 61%를 받았습니다. 그런데 같은 GLM 5.3 Flash가 다른 논문에서는 노이즈 범위 안이어서, "약한 모델일수록 크다"고 단정하기도 어렵습니다.
- 정답률보다 확실하게 갈리는 것은 비용입니다. 같은 모델, 같은 과제에서 정답률이 비슷해도 하네스에 따라 비용이 최대 3~5배 차이 났습니다. "OK" 한 단어를 시킨 첫 호출의 입력 토큰도 Pi는 1,894개, Claude Code는 31,480개였습니다.
목차
- AI 하네스 뜻
- 하네스와 인터페이스, 도구, MCP의 경계
- 국내에서 하네스 뜻이 갈리는 이유
- Theo의 "하네스 차이는 3~5%" 주장
- 통제 실험과 OpenAI 모델에서는 대체로 맞다
- 다른 실험에서는 수십 점이 갈렸다
- 확실히 갈리는 것은 비용이다
- 모델은 자기 하네스에 맞춰 학습되나
- 하네스를 고르고 다듬을 때 볼 것
- 출처
AI 하네스 뜻
AI 하네스란 LLM이 낸 텍스트를 읽고, 그 안에 약속된 문법이 있으면 실제 도구를 실행해 결과를 다시 모델에게 돌려주는 실행 틀입니다. 모델 혼자서는 다음 글자를 예측하는 일밖에 하지 못합니다. 파일을 읽거나 테스트를 돌리는 일은 모두 모델 바깥의 하네스가 대신 해 줍니다.
T3 Code를 만든 Theo는 2026년 10월 22일 자기 블로그에 이 구조를 다섯 가지 부품으로 정리했습니다(Theo, What is a "harness"?).
- 실제로 일을 하는 도구(read_file, edit_file, bash, search 등)
- 텍스트로 그 도구를 부르는 특별한 문법
- 모델의 답에서 그 문법을 찾아 코드를 실행하는 장치
- 도구가 낸 결과를 모델에게 돌려주는 방법
- 쓸 수 있는 도구 목록과 각 도구의 사용 설명
글은 이 다섯 가지를 늘어놓은 뒤 "That is the harness"라고 맺고, 에이전트는 하네스와 LLM을 합친 결과라고 정의합니다. 10월 30일 영상에서는 이것을 부엌에 빗댔습니다. 아무리 뛰어난 요리사라도 칼과 불이 없는 빈 방에서는 요리를 말로 설명할 수만 있습니다. LLM이 요리사이고, 칼과 불을 갖춘 부엌이 하네스입니다(Theo 유튜브).
다른 곳의 정의도 크게 다르지 않습니다. LangChain은 3월 10일 글에서 "Agent = Model + Harness"라는 공식을 쓰고 "모델이 아니면 하네스"라고 했습니다(LangChain, The Anatomy of an Agent Harness). Anthropic은 Claude Agent SDK를 소개하며 "Claude Code를 움직이는 것과 같은 도구, 에이전트 루프, 컨텍스트 관리"를 준다고 설명합니다(Claude Agent SDK 문서). 엔지니어링 블로그에서는 아예 이 SDK를 "범용 에이전트 하네스"라고 불렀습니다(Anthropic, Effective harnesses for long-running agents).
하네스가 거창한 프로그램일 필요는 없습니다. 10월 31일 경량 하네스 Prospero를 공개한 Chris Wellons는 "코딩 하네스의 핵심은 사실상 curl을 popen()에 붙인 것"이라고 썼습니다. 모델 API를 부르는 HTTP 요청과, 모델이 요청한 명령을 실행하는 프로세스 호출만 있으면 기본 골격이 선다는 뜻입니다(nullprogram.com, Prospero).
하네스와 인터페이스, 도구, MCP의 경계
하네스는 모델이 보는 쪽이고, 인터페이스는 사람이 보는 쪽입니다. Theo의 그림이 이 구분을 가장 단순하게 보여 줍니다.
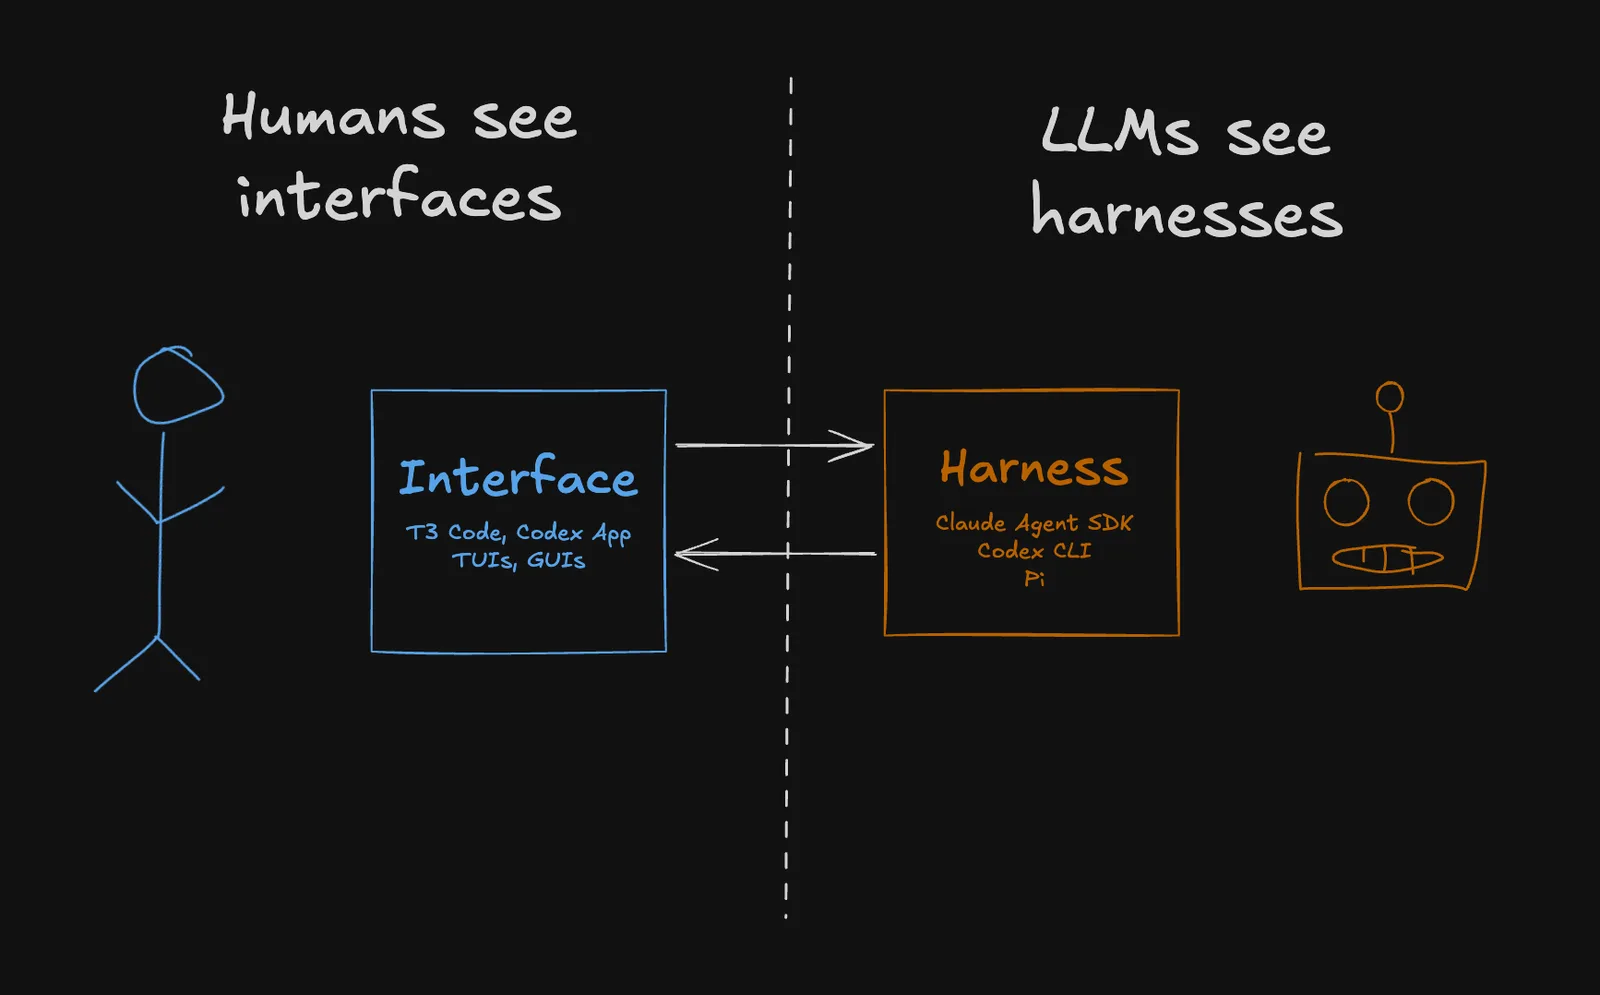
이 기준으로 보면 Claude Code는 둘을 한데 묶은 제품입니다. Theo는 블로그에서 "Claude Code는 인터페이스와 하네스, 두 부분으로 되어 있다"고 했고, 영상에서는 "하네스를 품은 인터페이스"라고 표현했습니다. 터미널 화면이 인터페이스이고, 그 아래에서 도구를 실행하는 부분이 하네스입니다. Anthropic 문서도 Agent SDK를 "Claude Code 바이너리를 실행하는 라이브러리"로 설명하고, 내장 도구, 권한, 세션, 훅을 그대로 쓸 수 있다고 적었습니다(Claude Agent SDK 문서).
| 층 | 예시 | 하는 일 |
|---|---|---|
| 모델 | Claude, GPT, Qwen | 텍스트를 받아 텍스트를 만든다 |
| 하네스 | Claude Agent SDK, Codex CLI, Pi | 도구를 실행하고 결과를 모델에게 돌려준다 |
| 인터페이스 | Claude Code 화면, Codex 앱, T3 Code | 사람이 지시하고 결과를 본다 |
T3 Code가 자기는 하네스가 아니라고 강조하는 이유도 여기서 나옵니다. T3 Code는 Claude Code, Codex, Antigravity, OpenCode, Cursor, Grok을 사용자의 기존 구독 그대로 한 화면에서 부리는 도구입니다(T3 Code). 하네스는 각 도구의 것을 빌려 씁니다. Theo는 블로그에서 "T3 Code는 하네스를 가져오지 않으면 동작하지 않는다"고 썼고, 영상 끝에서는 IDE에 빗대 "ADE(agentic development environment)"라는 이름을 붙였습니다.
도구와 MCP도 갈라 봐야 합니다. Theo의 구분으로는 도구는 하네스 안에서 직접 도는 코드(tool plane)이고, MCP는 하네스 바깥 어딘가에서 도는 코드를 부르는 연결(data plane)입니다. 그는 부엌 비유를 이어 가서, 도구는 부엌에 놓인 조리 도구이고 MCP는 부엌에 두고 가는 요리책에 가깝다고 설명했습니다. MCP 공식 문서도 MCP를 "AI 애플리케이션을 외부 시스템에 연결하는 오픈소스 표준"으로 정의합니다(MCP 문서). 도구 정의가 많아질 때 생기는 문제는 Uber MCP 게이트웨이 글에 정리했습니다.
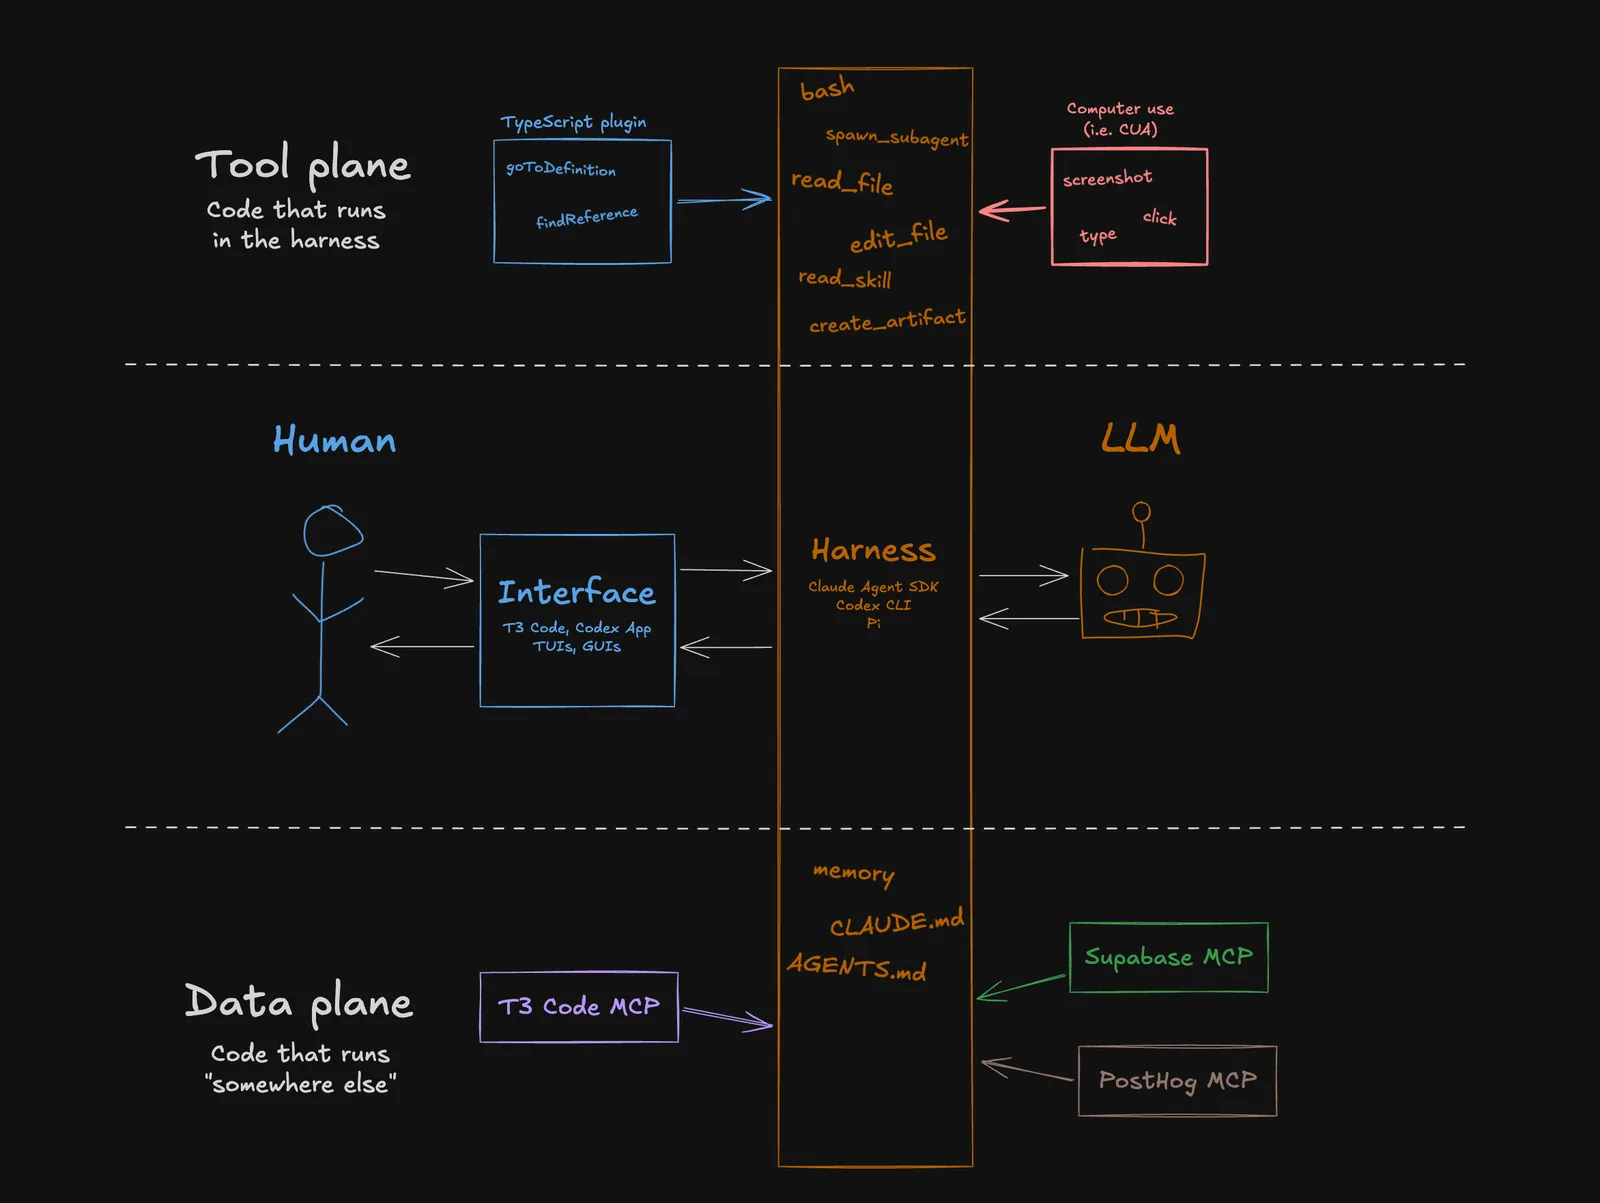
도구를 얼마나 많이 넣느냐는 하네스마다 다릅니다. Pi는 README에서 스스로를 "작고 확장 가능한 에이전트 하네스"라고 소개하고, 서브에이전트와 계획 모드를 일부러 뺐습니다. 기본 코딩 도구는 read, bash, edit, write 네 개입니다(Pi GitHub). Theo는 영상에서 Pi를 "사실상 bash뿐"이라고 했지만, 소스 기준으로는 네 개입니다. 반면 Claude Code는 서브에이전트, 스킬 읽기, 파일 편집 등 훨씬 많은 도구를 기본으로 넣습니다.
국내에서 하네스 뜻이 갈리는 이유
국내 글에서 "하네스"는 세 가지 뜻으로 쓰입니다. 실행 프로그램 자체, 그 위에 사용자가 쌓는 설정, 결과를 검사하는 검증 장치입니다. 같은 단어를 다른 뜻으로 쓰니 "Claude Code가 하네스다"와 "Claude Code로 하네스를 만든다"가 한꺼번에 돌아다닙니다.
- 실행 프로그램 자체: 전자신문 기고는 "하네스란 LLM의 실행을 통제하는 프로그램"이라며 클로드 코드와 코덱스를 대표적인 하네스로 꼽았습니다(전자신문). Theo의 정의와 같은 쪽입니다.
- 사용자가 쌓는 설정: 많은 국내 책과 강의가 CLAUDE.md, 스킬, 훅, MCP처럼 사용자가 Claude Code 위에 덧붙이는 설정을 하네스라고 부르고, 이 바깥 겹을 설계하고 다듬는 일을 하네스 엔지니어링이라고 합니다(패스트캠퍼스 인터뷰). 알라딘에서 찾아보면 2026년 5~10월에 제목이나 부제에 '하네스'가 들어간 IT 책만 15종이 넘습니다(알라딘 검색). 필자가 쓴 『클로드 코드 제대로 시작하기』도 부제에 하네스 엔지니어링을 넣었고, 이 뜻으로 썼습니다.
- 검증 장치: 테스트와 검사로 모델의 실수를 잡는 장치만 하네스로 부르는 글도 있습니다(네이버 블로그 에그코드). 아래에서 다룰 martinfowler.com 실험의 "행동 하네스(behavioral harness)"를 옮기면서 생긴 쓰임입니다.
이 혼란을 정리하는 데는 Birgitta Böckeler가 martinfowler.com에 그린 동심원이 쓸모 있습니다. 가운데에 모델이 있고, 그 바깥을 코딩 에이전트 제작사가 만든 하네스(시스템 프롬프트, 코드 검색 도구, 오케스트레이션)가 감싸고, 맨 바깥을 사용자가 자기 시스템에 맞춰 덧붙이는 하네스가 감쌉니다(martinfowler.com, Harness engineering for coding agent users).
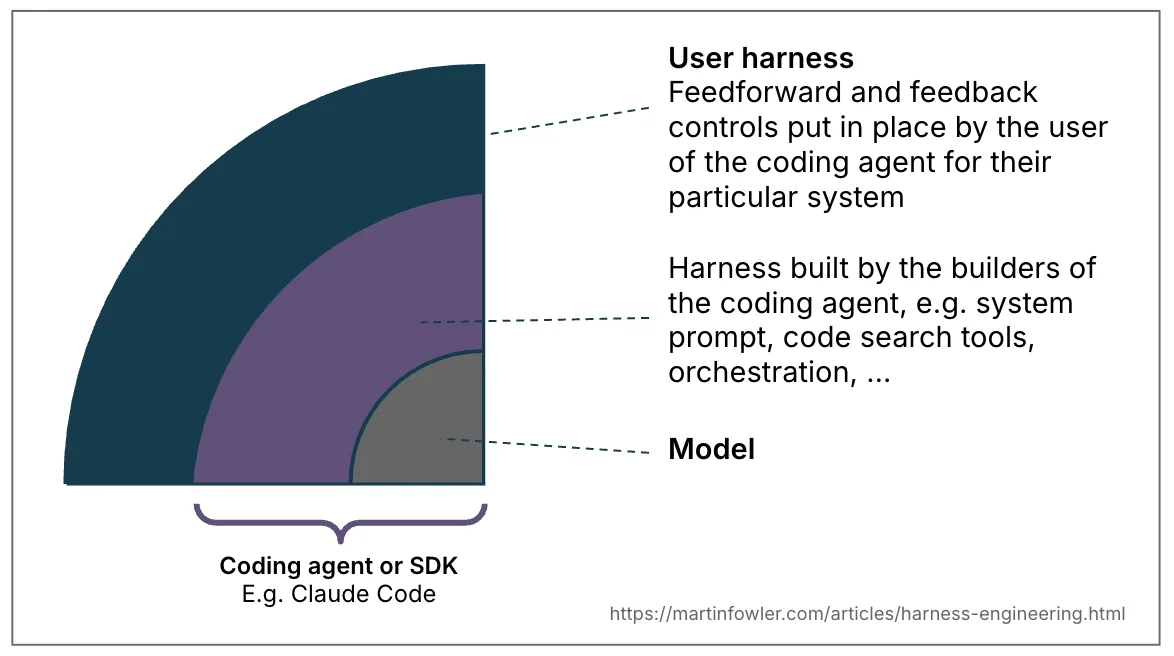
이 그림에 맞추면 Theo가 말하는 하네스는 보라색 겹이고, 국내 실무에서 "하네스를 깎는다"고 할 때는 남색 겹을 말하는 경우가 많습니다. 둘 다 틀린 말은 아닙니다. 다만 "하네스는 중요하지 않다"는 Theo의 주장은 보라색 겹, 곧 Claude Code와 Codex 가운데 무엇을 고르느냐에 대한 이야기라는 점을 기억해 두면 아래 숫자를 읽기 쉽습니다. 국내에는 Theo와 정반대 명제를 내건 책도 있습니다. 강국진의 『하네스 AI 시대의 새로운 몸』은 부제가 "AI 모델은 평준화된다, 하네스는 그렇지 않다"입니다(알라딘 검색). 이 갈림을 정면으로 다룬 국내 콘텐츠로는 신성진(Work by AX)의 영상 「하네스라는 단어, 왜 다들 다르게 쓸까」가 있습니다(유튜브).
Theo의 "하네스 차이는 3~5%" 주장
Theo의 주장은 "Codex 모델을 Claude Code와 Codex에서 쓸 때 차이는 3~5% 정도이고, 그보다 크면 모델 쪽 실패"라는 것입니다. 영상 44분 무렵의 발언이고, 측정 결과를 보여 주지는 않았습니다(Theo 유튜브).
순서는 이랬습니다. Effect를 만든 Michael Arnaldi가 10월 14일 "T3 Code를 쓰고 나서는 어떤 하네스를 쓰는지 신경 쓰지 않는다"는 트윗을 올렸고(X), Theo는 영상에서 이 트윗을 "영상을 만들게 한 트윗"으로 소개했습니다. 10월 22일에는 "지금 하네스에 신경 쓰는 건 탭이냐 스페이스냐를 따지는 것과 비슷하다"는 트윗을 올렸습니다(X). 같은 날 블로그에 하네스 설명 글을 올렸고(X에는 다음 날 올렸습니다), 10월 30일 49분짜리 영상으로 정리했습니다.
영상의 결론은 이렇습니다.
- 모델이 하네스에서 나온 데이터로 학습되고 있어서, Claude 모델은 보통 Claude Code에서 더 잘 동작한다.
- 벤치마크를 3% 이긴 하네스는 지난 세대 모델이나 Claude Code로 학습되지 않은 오픈웨이트 모델에서 이긴 것일 뿐이다.
- 그러니 식당에 갈 때 부엌을 따지지 않듯, 원하는 성능과 가격을 주는 쪽을 고르면 된다.
두 가지는 감안하고 들어야 합니다. 첫째, Theo는 하네스를 골라 쓰게 해 주는 T3 Code를 만드는 사람입니다. 영상에서 본인도 "하네스가 중요했다면 좋은 하네스를 만들어 사용자를 모았을 것"이라며 하네스에 묶이지 않는 인터페이스가 자기 전략이라고 밝혔습니다. 둘째, 정의도 일주일 사이에 조금씩 바뀌었습니다. 10월 22일 답글에서는 "Claude Code와 Codex는 하네스"라고 했다가(X), 블로그에서는 "인터페이스와 하네스 두 부분", 영상에서는 "하네스를 품은 인터페이스"가 됐습니다.
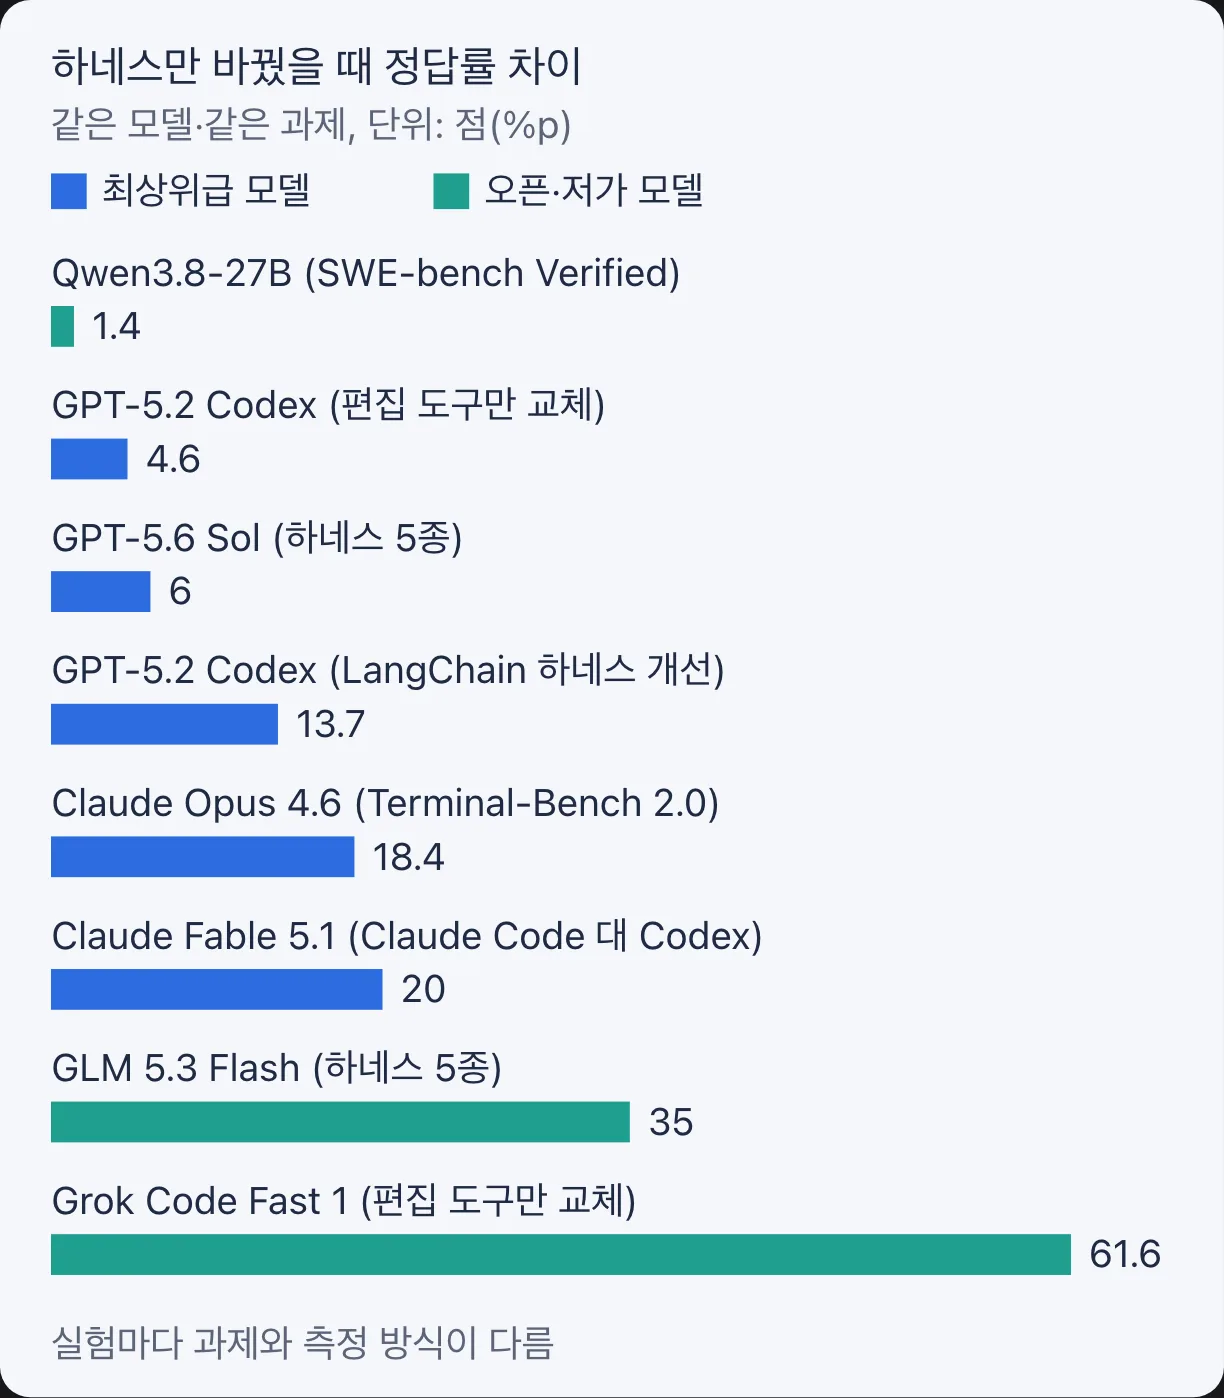
그러면 공개된 측정값은 무엇을 말할까요. 같은 모델을 두고 하네스만 바꾼 실험을 모아 보면 아래와 같습니다.
통제 실험과 OpenAI 모델에서는 대체로 맞다
같은 조건을 여러 번 돌려 흔들림까지 잰 HarnessTax, arXiv 2610.04433, METR 같은 실험에서는 하네스를 바꿔도 성능이 대체로 노이즈 범위 안에서 움직였습니다. Theo는 3~5%라는 숫자를 받칠 측정값을 대지 않았지만, 그의 감각과 같은 방향의 측정은 여럿 있습니다.
- 8090 Labs: Theo의 말에 가장 직접 닿는 결과입니다. 113개 실제 코딩 과제를 Codex, Claude Code, OpenCode, Pi, DeepSeek 하네스에서 과제당 두 번씩 돌렸습니다. 연구진은 9점 이하 차이를 노이즈로 봤는데, 페이지에 실린 그림 데이터로 계산하면 GPT-5.6 Sol, Terra, Luna의 Claude Code와 Codex 사이 차이는 각각 2.7점, 0.4점, 3.1점이었습니다. 다섯 하네스 전체로 넓히면 Sol은 6점만 움직였지만, Luna는 10.6점으로 노이즈 기준을 조금 넘었습니다(8090 Labs).
- HarnessTax: UC 버클리와 Arena 연구진이 7개 모델을 Claude Code, Codex CLI, Pi에서 벤치마크별 30개 과제씩, 과제당 3번 돌렸습니다. 하네스가 정답률에 주는 평균 효과는 SWE-bench Lite에서 ±2%, Terminal-Bench 2.0에서 약 ±5% 안쪽이었습니다(Arena, HarnessTax, HarnessTax 프로젝트 페이지).
- arXiv 2610.04433: 산둥대 연구진은 가장 무거운 Claude Code와 가장 가벼운 mini-SWE-agent, 그리고 OpenCode를 SWE-bench Verified로 비교했습니다. Qwen 두 모델로 돌린 447개 과제에서 Claude Code와 mini-SWE-agent는 5점 안에서 같았습니다(Qwen3.8-27B 기준 1.4점 차). GLM 5.3 Flash, DeepSeek V4 Flash를 포함한 다섯 모델로 돌린 어려운 45개 과제에서는 하네스를 바꿨을 때 성패가 뒤바뀐 과제 비율(13%)이 같은 하네스를 다시 돌렸을 때와 같았습니다. 노이즈를 넘은 차이는 OpenCode가 447개 과제에서 최대 9점 뒤진 것 하나였습니다(arXiv 2610.04433). 국내 보도에 따르면 그 절반가량은 OpenCode가 출력 한도(32,000토큰)에 걸려 멈춘 탓이었고, Claude Code는 한도에 이르면 이어 쓰기를 요청하는 회복 기능이 있습니다. 이 논문을 전한 국내 보도에는 "산둥대·UC버클리 연구"라고 나오지만(AI타임스), 논문의 소속 표기는 산둥대뿐입니다.
- METR: Opus 4.5와 GPT-5의 작업 시간 지평(time horizon)을 쟀을 때 Claude Code와 Codex는 METR의 기본 스캐폴드보다 통계적으로 낫지 않았습니다. Opus 4.5에서 Claude Code가 기본 스캐폴드를 이긴 부트스트랩 표본은 50.7%였습니다(METR).
이름에 Codex가 붙은 모델도 비슷합니다. 편집 도구의 형식만 바꿔 16개 모델을 비교한 실험에서 GPT-5.2 Codex는 4.6점 올랐습니다(Can Bölük). 비교 기준인 patch 형식이 원래 Codex가 쓰는 형식이라, 기준 자체가 이 모델에 유리했던 것으로 보입니다(필자 해석). Terminal-Bench 2.0에서도 OpenAI가 직접 결과를 올린 7개 모델 가운데 GPT-5-Nano를 뺀 6개는 OpenAI 에이전트(Codex CLI, GPT-5.3-Codex는 Simple Codex)가 1위이거나 1위와 2.0~3.3점 차였습니다(Terminal-Bench 2.0, 2026-08-26 보관본). 다만 이름에 Codex가 붙은 모델을 Claude Code에서 돌린 공개 측정은 찾지 못했습니다.
다른 실험에서는 수십 점이 갈렸다
반대로 같은 모델이 하네스에 따라 수십 점씩 갈린 실험도 있습니다. 실험마다 과제, 반복 횟수, 비교한 하네스 목록이 다릅니다. Theo는 영상에서 "지난 세대 모델이나 Claude Code로 학습되지 않은 오픈웨이트 모델에서 이긴 3%"라고 비꼬며 이런 사례를 스스로 언급했지만, 실제 폭은 3%보다 훨씬 큽니다.
- 8090 Labs: 앞의 GPT-5.6 Sol과 같은 실험에서 GLM 5.3 Flash는 Codex 하네스로 24%, DeepSeek 하네스로 59%를 받았습니다. 35점 차이입니다(8090 Labs).
- 편집 도구 하나: Can Bölük은 도구를 몇 개만 둔 하네스에서 편집 도구의 형식만 바꿨습니다. Grok Code Fast 1은 6.7%에서 68.3%로 올랐고, 16개 모델 중 14개가 좋아졌습니다. 그는 "가장 약한 모델이 가장 많이 얻는다"고 정리했습니다(Can Bölük).
- 검사 장치 추가: martinfowler.com에 실린 Naresh Jain의 실험에서는 값싼 GPT-6 Luna가 하네스 없이 10번 중 3번 성공했고, 명세와 실행 가능한 검사를 붙이자 10번 모두 성공했습니다. 최상위 모델 GPT-6 Sol은 하네스가 있든 없든 10번 모두 성공했습니다. Java 서비스 하나를 10번씩 만든 작은 실험이고, 글쓴이는 명세 기반 테스트 도구를 만드는 Specmatic 창업자입니다(martinfowler.com, Are Harnesses Worth the Cost?).
- 하네스를 직접 다듬은 경우: LangChain은 모델을 GPT-5.2 Codex(gpt-5.2-codex)로 고정한 채 하네스만 고쳐 Terminal-Bench 2.0 점수를 52.8%에서 66.5%로 올렸고, 순위는 30위권에서 5위권으로 뛰었습니다(LangChain). 외부 연구진이 만든 GVS5H를 aviss에서 검증해 보니, 이 하네스는 같은 Qwen3.8-27B를 매번 새 대화로 불러 역할을 나누게 해 LiveCodeBench 고난도 100문제 정답률을 66.8%에서 92.4%로 올렸습니다. 다만 출력이 잘린 답을 줄인 기준선은 70.0%였고, 하네스를 씌운 Qwen은 출력 토큰을 Fable 5의 약 15배 썼습니다. 자세한 조건은 Qwen 3.8 27B 성능 검증 글에 정리했습니다.
센 모델도 예외가 있습니다. 같은 8090 Labs 실험에서 Claude Fable 5.1은 Claude Code에서 41%, Codex에서 61%를 받았고, 연구진은 "만든 회사의 하네스에서 가장 잘한 모델은 하나도 없었다"고 결론 냈습니다. "Claude 모델은 보통 Claude Code에서 더 잘 동작한다"는 Theo의 말과 맞지 않는 결과입니다. 다만 8090 Labs는 이 실험을 퍼뜨린 Chamath Palihapitiya 쪽 회사이고(X), 과제당 두 번만 돌렸습니다. Terminal-Bench 2.0에서도 Claude Opus 4.6은 Claude Code로 58.0%, Meta-Harness로 76.4%를 받았습니다(Terminal-Bench 2.0, 2026-08-26 보관본). 리더보드에 올라온 제3자 하네스는 그 벤치마크에 맞춰 다듬었을 수 있다는 점을 감안해야 합니다.
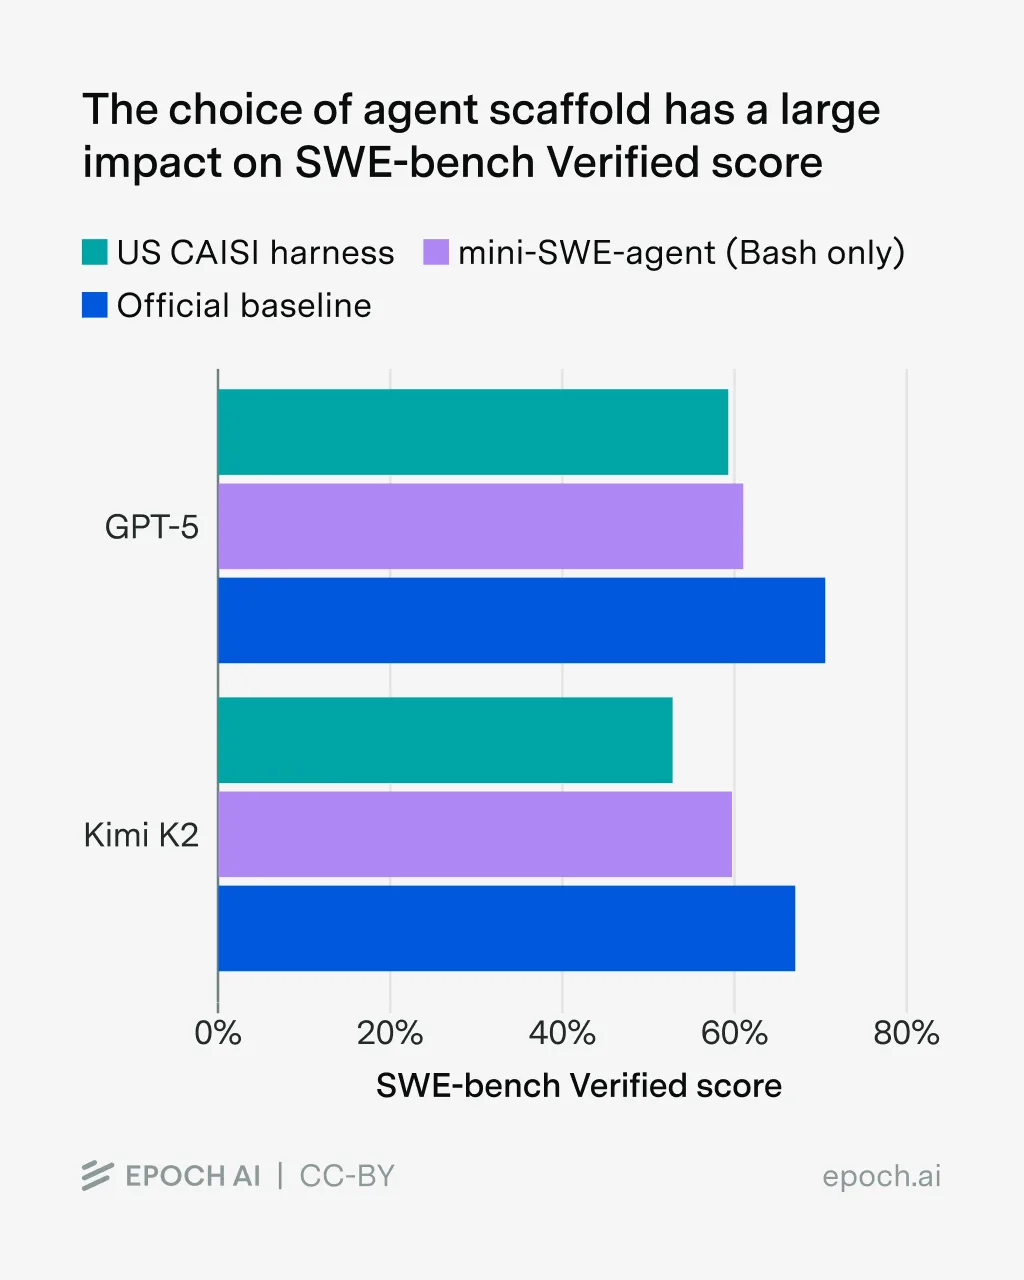
그렇다면 "약한 모델일수록 하네스가 중요하다"로 정리하면 될까요. 그렇게 단정하기도 어렵습니다. 8090 Labs에서 35점이 갈린 GLM 5.3 Flash는 arXiv 2610.04433의 어려운 45개 과제에서는 하네스 간 차이가 노이즈 범위 안이었고, 이 논문은 "가장 약한 모델이 하네스에 가장 민감한 것은 아니다"라고 적었습니다(arXiv 2610.04433). 두 실험이 정말 부딪히는지는 겹치는 하네스를 보면 알 수 있습니다. 8090 Labs의 그림 데이터에서 GLM 5.3 Flash는 arXiv와 겹치는 Claude Code(26.3%)와 OpenCode(27.0%) 사이 차이가 1점도 되지 않았습니다. 59%와 58%라는 높은 점수는 arXiv가 비교하지 않은 DeepSeek 하네스(58.8%)와 Pi(58.4%)에서 나왔고, 가장 낮은 24%는 역시 arXiv에 없는 Codex에서 나왔습니다. 겹치는 하네스끼리는 두 실험 모두 의미 있는 차이를 찾지 못한 셈입니다. 그 모델에 유난히 잘 맞거나 안 맞는 하네스가 비교 목록에 들어 있느냐에 따라 결론이 달라진다고 보는 편이 숫자에 맞습니다(필자 해석).
자주 인용되는 ARC-AGI-3의 GPT-6 Astra 사례도 조건을 확인해야 합니다. ARC Prize의 표준 하네스로는 62.7%, 추론 상태를 이어 주는 Provider Adapter 하네스로는 99.9%였는데, 앞의 것은 추론 수준 max, 뒤의 것은 high로 돌린 결과입니다. 같은 max끼리 비교해도 62.7%와 98.6%라 차이의 대부분은 하네스 쪽에서 나왔습니다(ARC Prize). 하네스 바깥의 도구 설명도 결과를 바꿉니다. Theo 자신도 10월 27일 T3 Code의 도구 설명과 스키마를 고쳐, 직접 만든 80여 개 사례 평가에서 "에이전트가 도구를 4배 더 잘 쓰고 컨텍스트는 79% 덜 쓴다"고 알렸습니다(X). 그의 구분으로는 하네스가 아니라 MCP 쪽 개선입니다.
확실히 갈리는 것은 비용이다
정답률이 비슷해도 하네스에 따라 비용은 몇 배씩 갈립니다. 하네스마다 매 호출에 붙이는 머리말의 크기와 호출 횟수가 다르기 때문입니다. 정답률 차이를 두고는 연구마다 결론이 엇갈렸지만, 비용 차이에는 대부분 동의합니다.
- HarnessTax는 같은 모델이 비슷한 정답률을 내면서 비용은 최대 5배까지 차이 날 수 있다고 했습니다. SWE-bench Lite에서 Claude Code의 비용은 Pi의 약 2배였습니다(Arena, HarnessTax).
- arXiv 2610.04433은 같은 모델, 같은 과제, 같은 단가에서 과제당 비용이 하네스에 따라 최대 3배 차이 났다고 했습니다. 매 호출에 붙는 시스템 프롬프트와 도구 정의의 크기가 Claude Code 16,581토큰, OpenCode 7,025토큰, mini-SWE-agent 829토큰이었고, 이 머리말에 호출 횟수가 곱해져 비용이 갈렸습니다(arXiv 2610.04433). 논문 제목부터 "하네스가 사 주는 것은 대부분 토큰"입니다.
- martinfowler.com 실험에서 하네스를 붙인 GPT-6 Sol은 정답률은 그대로였고 회당 비용만 약 0.406달러에서 약 2.679달러로 늘었습니다. 반대로 하네스를 붙인 GPT-6 Luna는 하네스 없는 Sol과 같은 10번 중 10번을 33% 싼 값에 냈습니다(martinfowler.com).
TestDino는 하네스 11종에 "OK 한 단어로만 답하라"는 같은 지시를 주고 첫 호출에 들어간 입력 토큰을 쟀습니다. 사용자가 보낸 말은 몇 글자인데, 하네스가 덧붙인 지시문과 도구 정의 때문에 숫자가 크게 벌어졌습니다.
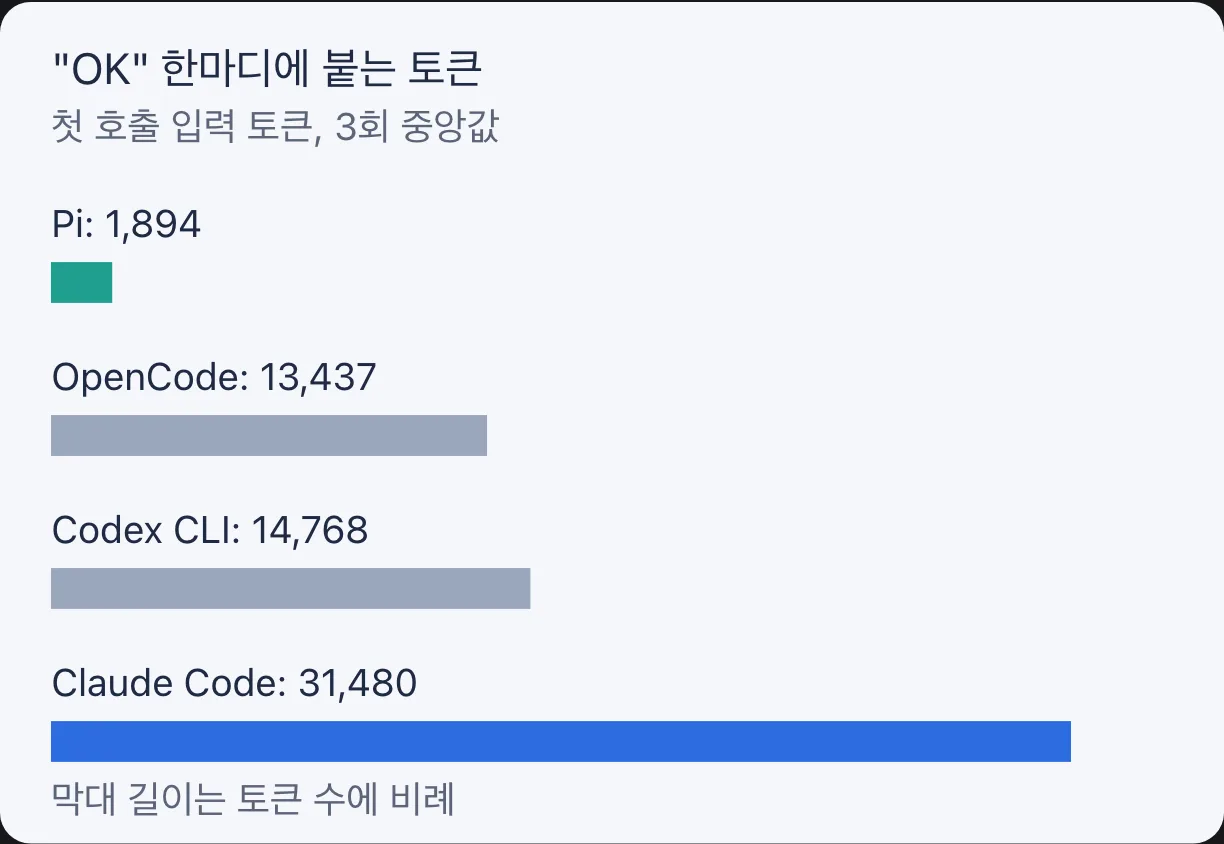
하네스 설계에 따라 비용이 수십 배까지 갈리기도 합니다. 다만 이때는 결과물도 달라집니다. Anthropic은 같은 한 줄 지시("2D 레트로 게임 메이커를 만들어 줘")를 단일 에이전트와 계획자·생성자·평가자 세 에이전트로 짠 하네스에 각각 줬습니다. 단일 에이전트는 20분에 9달러, 하네스는 6시간에 200달러가 들었습니다. Anthropic은 "하네스가 20배 넘게 비쌌지만 결과물 품질 차이는 곧바로 보였다"고 했고, 단일 에이전트가 만든 게임은 제대로 실행되지 않았습니다(Anthropic, Harness design for long-running application development). 하네스를 고르는 일은 결국 얼마를 내고 얼마나 확실하게 끝낼지를 고르는 일이 됩니다(필자 해석).
모델은 자기 하네스에 맞춰 학습되나
모델이 특정 도구 형식에 맞춰 학습된다는 공식 문장은 있습니다. 하지만 "자기 회사 하네스에서 가장 잘한다"는 것까지 보장하지는 않습니다. Theo 주장의 뼈대인 "모델과 하네스가 함께 학습된다"는 말을 따로 따져 볼 만합니다.
OpenAI의 Codex 프롬프트 가이드는 다른 하네스를 쓰는 개발자에게 "모델이 이 diff 형식에 맞춰 학습됐으니 우리 apply_patch 구현을 그대로 쓰라"고 권합니다(OpenAI Cookbook, Codex Prompting Guide). Anthropic도 bash, 텍스트 편집기 같은 도구에 대해 "스키마를 공개하고 Claude를 그 스키마로 학습시킨다"고 적었습니다(Claude 도구 사용 문서). 앞에서 본 편집 형식 실험에서 GPT-5.2 Codex의 개선 폭이 4.6점으로 작았던 것도 이 때문으로 보입니다(필자 해석). 다만 같은 실험에서 GPT-5.1 Codex Mini는 20.3점 올라, Codex 계열이 모두 그렇지는 않았습니다(Can Bölük). "Claude가 Claude Code 자체로 학습됐다"는 Anthropic의 문장은 찾지 못했고, 8090 Labs 실험의 Fable 5.1 결과는 오히려 반대였습니다. HarnessTax도 Anthropic·OpenAI 모델 6개를 두 벤치마크에서 본 12번의 비교 가운데 9번은 제작사가 아닌 하네스가 가장 높은 정답률을 냈다고 적었습니다(Arena, HarnessTax).
"모델이 하네스를 먹는다"는 말도 누가 언제 했는지 짚어 둘 만합니다. OpenAI의 노엄 브라운은 2025년 6월 팟캐스트에서 "추론 모델 위에 쌓는 스캐폴딩도 여러 면에서 추론 모델, 그리고 더 좋아진 모델로 대체될 것"이라고 했습니다(Latent Space). 2026년 7월에는 디 인포메이션 인터뷰에서 차세대 모델이 지금 하네스 대부분을 쓸모없게 만들 가능성이 높다고 했다고 AI타임스가 전했습니다(AI타임스). 구글 딥마인드의 로건 킬패트릭은 2026년 6월 "모델이 스캐폴딩을 먹어 기본 기능이 된다"며 12개월 안에 지금 같은 하네스에서 얻는 이점은 상당 부분 모델로 흡수될 것이라고 봤습니다. 다만 검색과 코드 실행처럼 바깥 스캐폴딩이 여전히 쓸모 있는 경우는 예외로 남겼습니다(Sequoia Capital).
Anthropic의 하네스 설계 글은 이 논쟁에 가장 균형 잡힌 문장을 남겼습니다. "하네스의 모든 부품은 모델이 혼자 못 하는 일에 대한 가정을 담고 있고, 그 가정은 모델이 좋아지면 금방 낡을 수 있다." 그러면서 모델이 좋아질수록 하네스로 해낼 수 있는 일의 범위도 넓어진다고 덧붙였습니다(Anthropic).
하네스를 고르고 다듬을 때 볼 것
정답률 차이는 내 과제로 직접 재 보기 전에는 알기 어렵고, 비용 차이는 먼저 확인할 수 있습니다. 숫자를 종합하면 이렇게 나눠 볼 수 있습니다(필자 해석).
- 정답률은 내 과제로 두 번 이상 잰다: 실험마다 결론이 갈린 만큼, 남의 벤치마크 순위보다 내 과제 몇십 개를 하네스별로 두 번 이상 돌려 보는 편이 낫습니다. 노이즈 기준도 잡아 두세요. 8090 Labs는 같은 조합을 두 번 돌린 결과가 평균 4점 달랐다고 했습니다(8090 Labs).
- 비용은 바로 잴 수 있다: 매 호출에 붙는 머리말 크기, 캐시가 잘 붙는지, 같은 작업에 드는 토큰은 두세 번 돌려 보면 나옵니다. TestDino는 Claude Code의
claude -p --output-format json, Codex CLI의codex exec --json처럼 하네스마다 토큰 사용량을 뽑는 명령을 정리해 두었습니다(TestDino). - 오픈·저가 모델이나 낯선 도구 형식이면 조합부터 바꿔 본다: GLM 5.3 Flash가 DeepSeek 하네스와 Pi에서 59%와 58%를 낸 것, Grok Code Fast 1이 편집 형식 하나로 6.7%에서 68.3%가 된 것처럼, 잘 맞는 조합을 만나면 크게 오르기도 합니다. 모델을 바꾸기 전에 하네스나 편집 형식을 바꿔 보는 편이 싸게 먹힐 수 있습니다.
- 사용자 하네스(맨 바깥 겹)는 옮겨지지 않을 수 있다: 한 국내 개발자는 Codex 쪽에서 하루 동안 다듬은 하네스(에이전트와 훅)가 Claude Code에서는 하나도 트리거되지 않고 MCP도 제대로 작동하지 않아 전부 지웠다고 적었습니다(네이버 블로그 minitaur). 여러 도구를 옮겨 다닌 다른 개발자는 정확도보다 "따로 지적해야 할 사이드 이슈"가 얼마나 나오는지로 하네스를 비교했습니다(네이버 블로그 lukewire129).
필자도 사용자 하네스를 직접 만들어 쓰고 있습니다. 주식 분석 리포트를 자동으로 만드는 하네스는 plan, research, draft, image, review, build 여섯 단계로 돌고, 같은 모델이라도 새 세션에서 다시 검토하게 해 처음 보는 사람의 눈을 되살리는 구조입니다. 같은 지적이 여러 결과물에서 되풀이되면 메모에 적는 데서 멈추지 않고 lint 규칙, 자동 테스트, 리뷰어 프롬프트처럼 더 강한 장치로 끌어올립니다(요즘IT, 필자 글). 앞에서 본 Anthropic의 말처럼, 이런 바깥 겹도 모델이 좋아지면 다시 덜어 낼 곳이 생깁니다. 위임과 검증을 어떻게 나누는지는 AI 네이티브 역량 정리 글에서 더 다뤘습니다.
출처
- Theo, What is a "harness"?: t3.gg/blog/post/what-is-a-harness
- Theo 유튜브: youtube.com/watch?v=ebILGCoN4UU
- LangChain, The Anatomy of an Agent Harness: blog.langchain.com/the-anatomy-of-an-agent-harness
- Claude Agent SDK 문서: code.claude.com/docs/en/agent-sdk/overview
- Anthropic, Effective harnesses for long-running agents: anthropic.com/engineering/effective-harnesses-for-long-running-agents
- nullprogram.com, Prospero: nullprogram.com/blog/2026/10/31
- T3 Code: t3.codes
- MCP 문서: modelcontextprotocol.io/docs/getting-started/intro
- Pi GitHub: github.com/earendil-works/pi
- 전자신문: etnews.com/20260812000081
- 패스트캠퍼스 인터뷰: fastcampus.co.kr/story_interview_devbrothers
- 알라딘 검색: aladin.co.kr/search/wsearchresult.aspx?SearchTarget=All&SearchWord=하네스
- 클로드 코드 제대로 시작하기: yes24.com/product/goods/194483933
- 네이버 블로그 에그코드: blog.naver.com/eggcode/224443620311
- martinfowler.com, Harness engineering for coding agent users: martinfowler.com/articles/harness-engineering.html
- 유튜브: youtube.com/watch?v=lE8fmtDMg6U
- X: x.com/MichaelArnaldi/status/2110290227021365720
- X: x.com/theo/status/2113170687401803863
- X: x.com/theo/status/2113380283865260298
- arXiv 2610.04433: arxiv.org/abs/2610.04433
- Can Bölük: stencil.so/blog/the-harness-problem
- 8090 Labs: 8090.ai/blog/same-model-different-harness
- LangChain: blog.langchain.com/improving-deep-agents-with-harness-engineering
- Terminal-Bench 2.0 리더보드(2026-08-26 보관본): web.archive.org/web/20260826113700/https://www.tbench.ai/leaderboard/te…
- Arena, HarnessTax: arena.ai/blog/coding-agents-harness-tax
- HarnessTax 프로젝트 페이지: harnesstax.github.io
- AI타임스: aitimes.com/news/articleView.html?idxno=216712
- METR: metr.org/notes/2026-02-13-measuring-time-horizon-using-claude-code-and-…
- martinfowler.com, Are Harnesses Worth the Cost?: martinfowler.com/articles/are-harnesses-worth-the-cost.html
- X: x.com/chamath/status/2109703737493344363
- Epoch AI: epoch.ai/gradient-updates/why-benchmarking-is-hard
- ARC Prize: arcprize.org/blog/astra
- X: x.com/theo/status/2114955692193054930
- TestDino: testdino.com/blog/harness-overhead-benchmark
- Anthropic, Harness design for long-running application development: anthropic.com/engineering/harness-design-long-running-apps
- OpenAI Cookbook, Codex Prompting Guide: github.com/openai/openai-cookbook/blob/main/examples/gpt-5/codex_prompt…
- Claude 도구 사용 문서: platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- Latent Space: youtube.com/watch?v=ddd4xjuJTyg
- AI타임스: aitimes.com/news/articleView.html?idxno=212582
- Sequoia Capital: youtube.com/watch?v=cMAs8z2dehs
- 네이버 블로그 minitaur: blog.naver.com/minitaur/224349027033
- 네이버 블로그 lukewire129: blog.naver.com/lukewire129/224356162668
- 요즘IT, 필자 글: yozm.wishket.com/magazine/detail/3930