핵심 요약
- 지포스의 "AI 연산 반속도" 제한은 실재합니다. NVIDIA 화이트페이퍼에서 RTX 3090의 FP16 텐서 연산은 FP16 누산일 때 142 TFLOPS, FP32 누산일 때 71 TFLOPS입니다. 같은 GA102 칩을 쓰는 전문가용 RTX A6000은 두 값이 154.8로 같습니다.
- 3090급에서 "2배"는 클럭당 처리량 이야기입니다. 해제하면 MHz당 행렬곱 처리량은 약 1.9배가 되지만, 연산이 늘면 클럭이 내려가 전력 한도를 350 W로 묶은 RTX 3090 보고에서는 1.57배였습니다. 기본 전력 170 W 그대로 둔 RTX 3060 12GB는 FP16 행렬곱이 거의 두 배(1.9배)였습니다. 헤드라인의 3090 Ti BF16 80% 증가는 순정 전력 450 W에서 개조 드라이버로 잰 값이었고, 같은 표의 FP16은 35% 증가에 그쳤습니다.
- 실제 작업은 FP16·BF16 행렬곱이 큰 쪽만 빨라집니다. 사용자 보고에서 vLLM 프리필은 33%, 같은 전력의 LoRA 학습은 20% 빨라졌지만, 토큰 생성(디코드)은 1.2%에 그쳤고 llama.cpp 양자화 모델은 변화가 없었습니다.
- 모든 RTX 30에서 되는 것은 아닙니다. 3080 Ti 20GB OEM은 해제 절차가 끝나도 절반 속도 그대로였고, 3070 노트북은 0.99% 향상, 일부 3060은 해제에 실패했습니다. RTX 50은 지원하지 않습니다.
- 펌웨어 취약점을 쓰는 비공식 도구입니다. 하드락과 해제 실패 사례가 있고, NVIDIA 드라이버 라이선스의 "기술적 제한 우회 금지" 조항과 충돌할 소지가 있습니다. 10월 28일 기준 NVIDIA 공식 입장은 없습니다.
목차
- GPU Unlock이란 무엇인가
- 지포스의 반속도는 어디에 걸려 있나
- 어떻게 푸나: 펌웨어 취약점과 레지스터 두 개
- 벤치마크 2배는 어떤 조건이었나
- 실제 작업에서는 얼마나 빨라지나
- 어떤 카드에서 되고, 어디서 안 되나
- 써도 될까: 위험과 라이선스
- 국내 반응과 중고가 이야기
- 누가 써 볼 만한가
- 출처
GPU Unlock이란 무엇인가
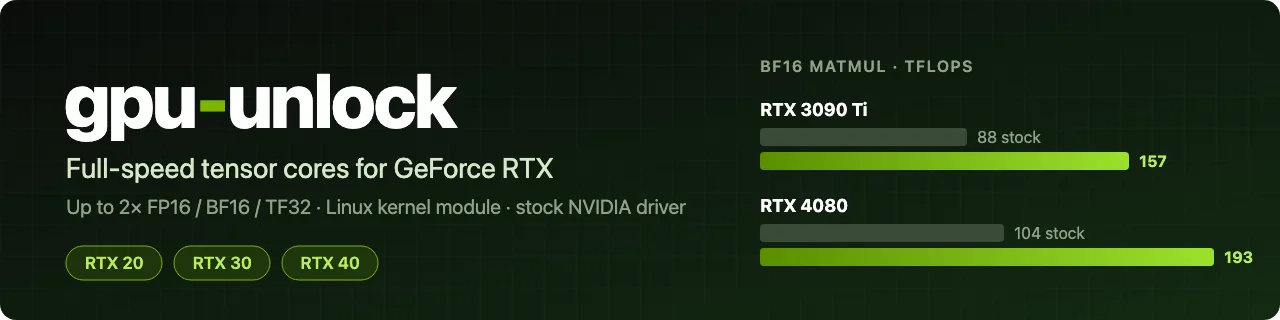
GPU Unlock(gpu-unlock)은 지포스 RTX 30에 걸린 "FP16·BF16 입력, FP32 누산 텐서 연산 반속도" 제한을 푸는 리눅스 커널 모듈입니다. 텐서 코어는 GPU 안의 행렬곱 전용 연산 장치입니다. FP32 누산은 16비트 숫자끼리 곱한 값을 더해 나갈 때 중간 합계를 32비트로 유지하는 방식으로, 학습과 BF16 추론이 주로 이 방식을 씁니다. 모듈은 이 연산의 명령 발행 속도를 전문가용 카드와 같은 값으로 바꿉니다(Zagitta/gpu-unlock).
저장소는 10월 18일 GitHub에 만들어졌고, 10월 28일 기준 별 1만 1천여 개와 포크 1,100여 개를 모았습니다. 해커 뉴스에서는 10월 24일 349점, 댓글 83개로 1면에 올랐고(Hacker News), 긱뉴스에는 10월 25일 소개됐습니다(GeekNews). 처음에는 RTX 30(Ampere)만 대상이었는데, 10월 28일(한국 시간) v2.0에서 RTX 20과 40을 "실험적(Experimental)" 지원으로 추가했습니다. 작성자(GitHub 아이디 Zagitta)는 해커 뉴스에서 익스플로잇 기법 자체는 자기 아이디어가 아니라고 밝혔습니다.
지포스의 반속도는 어디에 걸려 있나
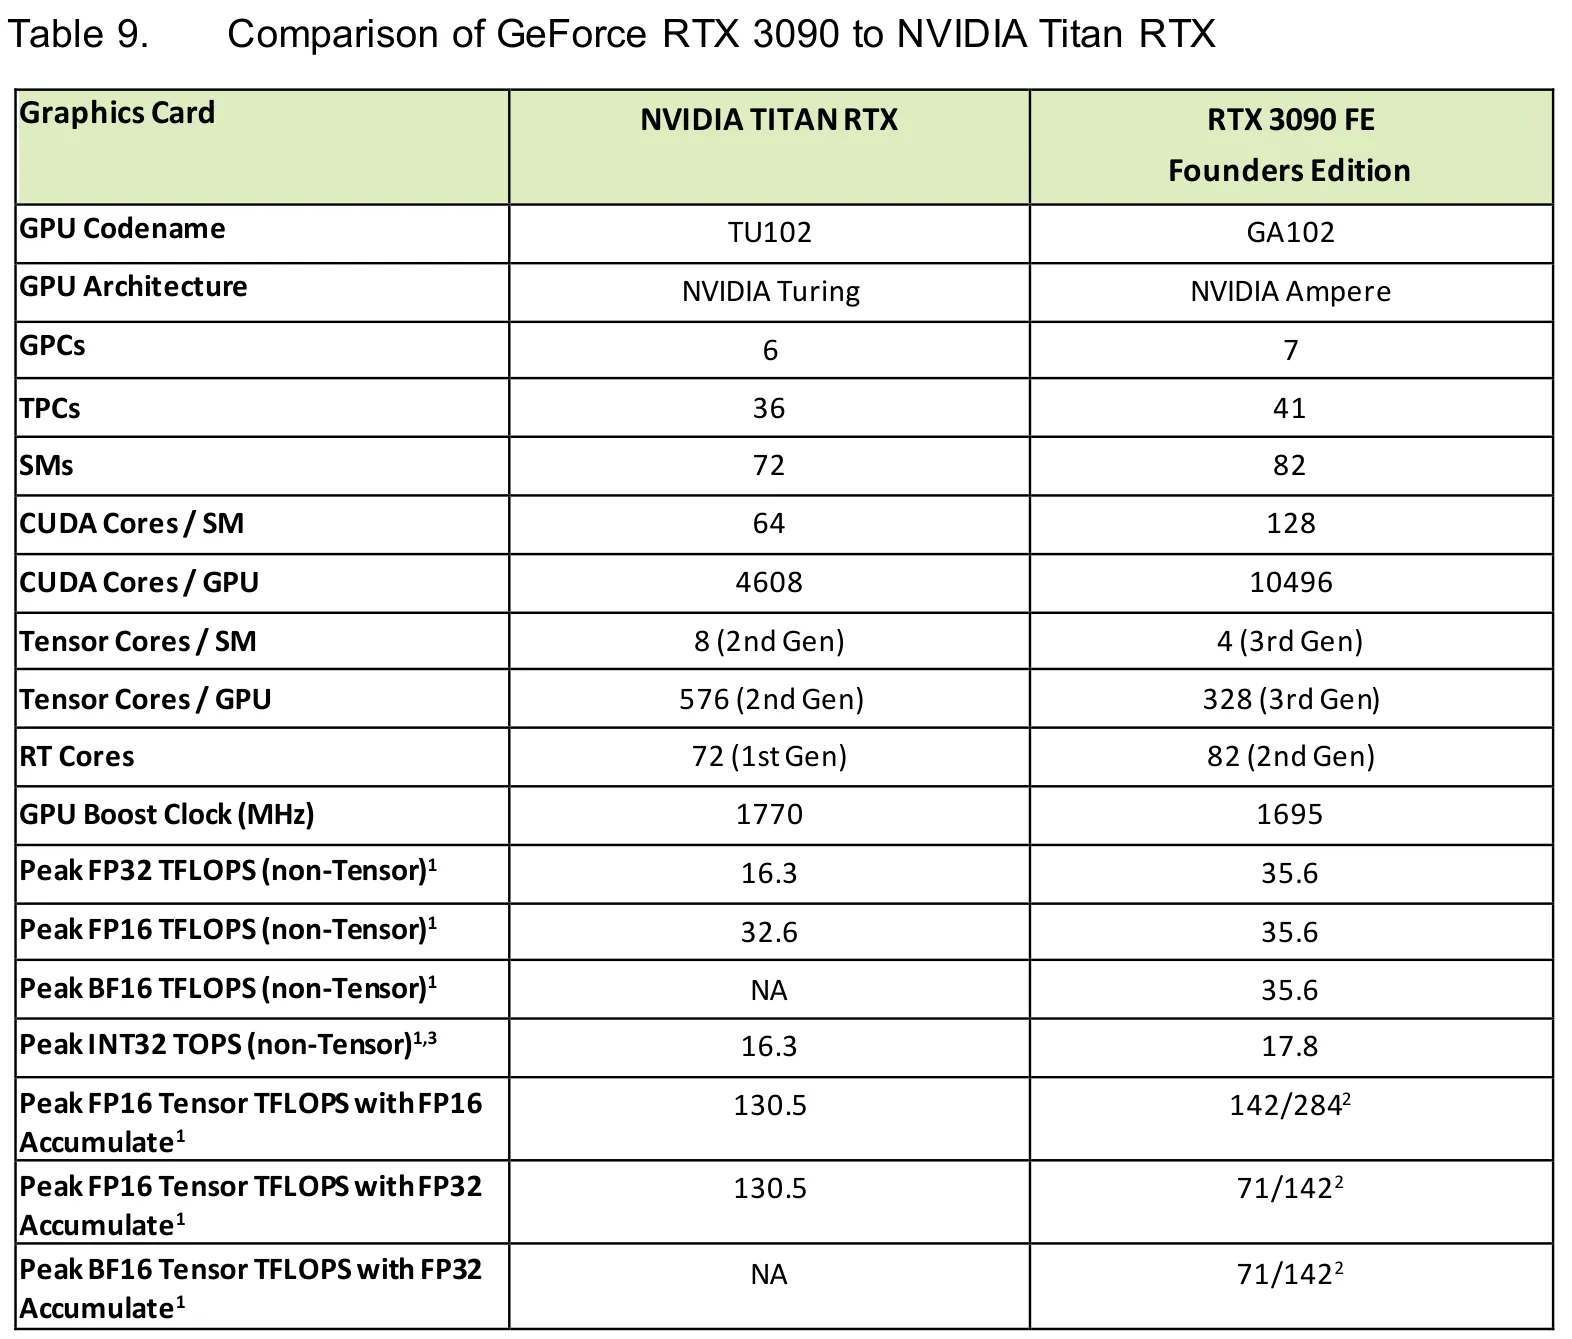
반속도는 FP16·BF16 입력을 FP32로 누산하는 텐서 연산과 TF32에만 걸려 있고, NVIDIA 공식 사양표에 그대로 적혀 있습니다. GA102 화이트페이퍼 Table 9를 보면 RTX 3090의 FP16 텐서 연산은 FP16 누산일 때 142 TFLOPS, FP32 누산일 때 71 TFLOPS입니다. BF16(FP32 누산)도 71, TF32는 35.6입니다. TFLOPS는 초당 1조 번 단위의 부동소수점 연산 횟수이고, 여기서는 희소성(sparsity) 기능을 쓰지 않은 값만 옮겼습니다(NVIDIA GA102 화이트페이퍼).
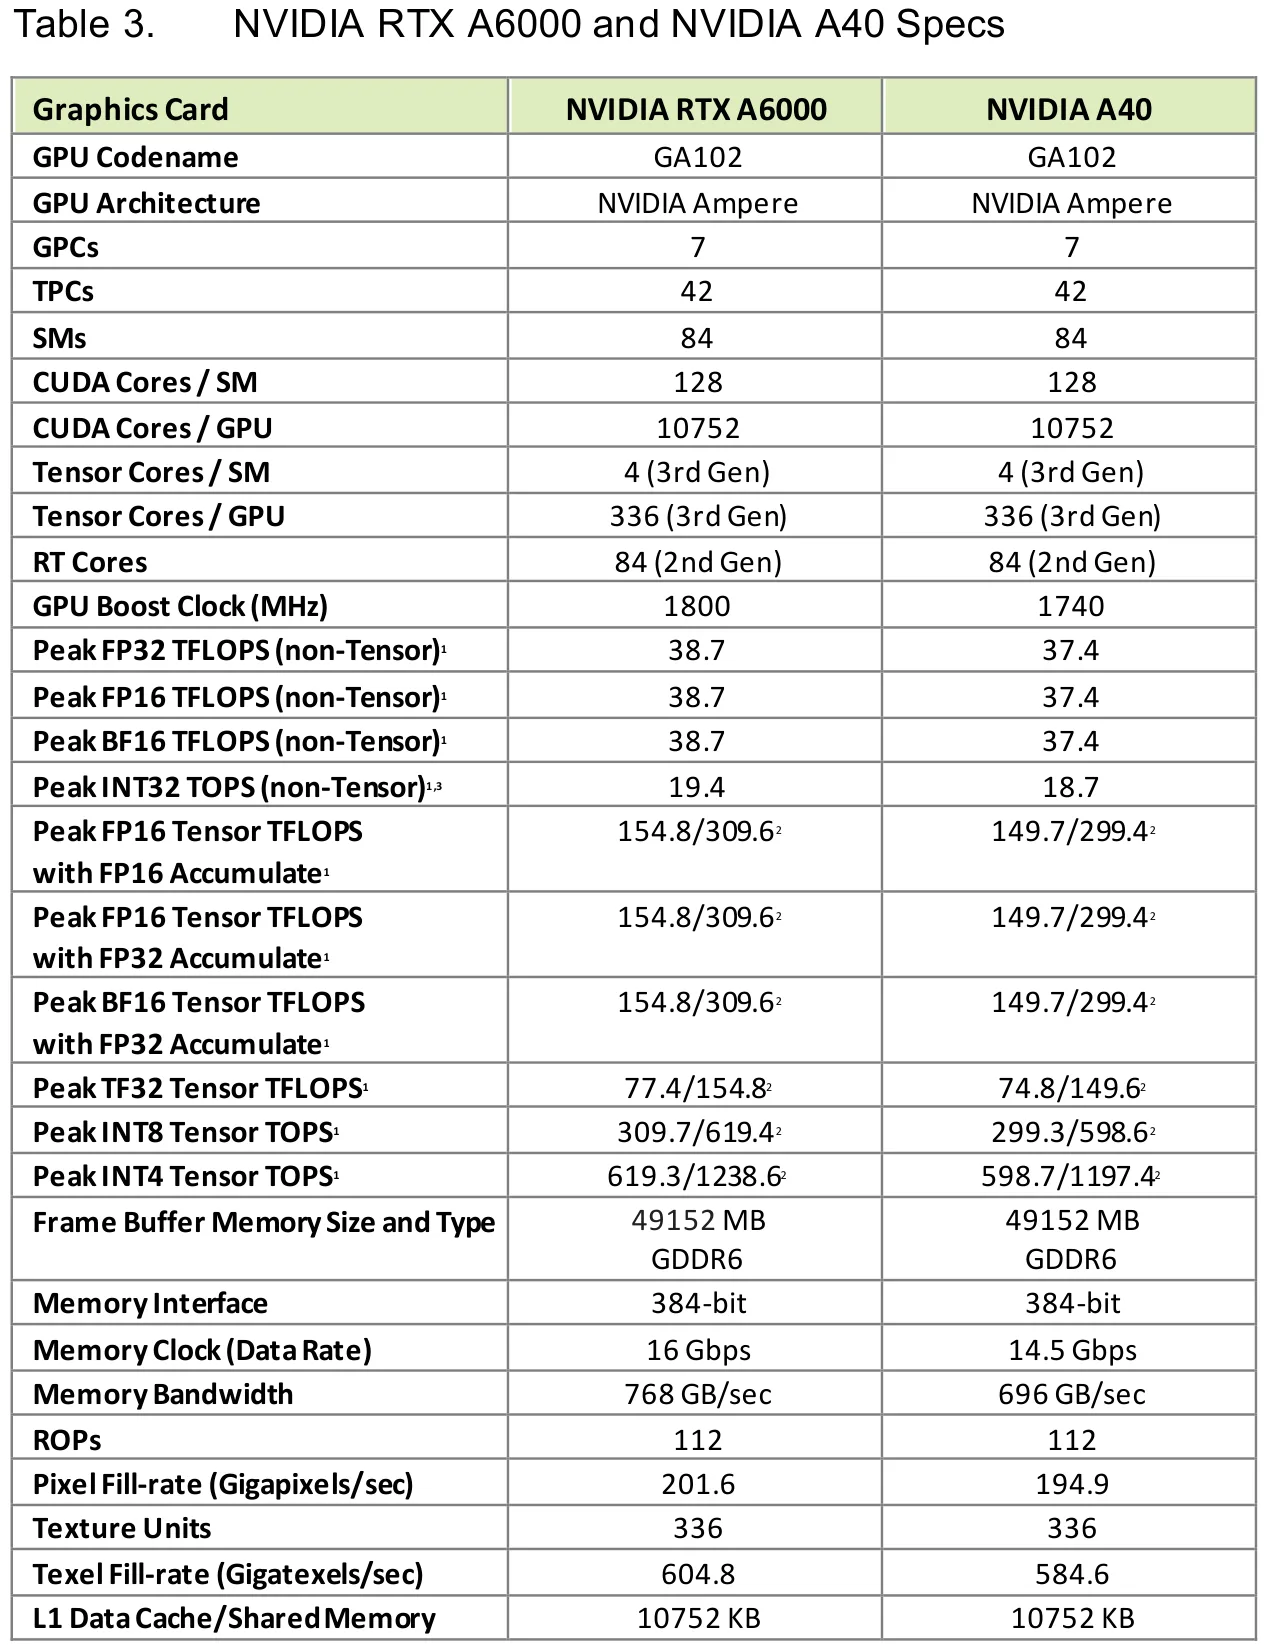
같은 문서의 Table 3에서 전문가용 RTX A6000을 보면 차이가 분명해집니다. A6000은 3090과 같은 GA102 칩(SM 84개, 부스트 1800 MHz)인데 FP16 누산과 FP32 누산이 모두 154.8 TFLOPS입니다. SM(스트리밍 멀티프로세서)은 GPU 안의 연산 묶음 단위입니다. 3090의 TF32(35.6)도 A6000(77.4)의 절반에 못 미쳐 같은 반감 대상입니다.
반감되는 범위는 좁습니다. FP16·BF16을 입력으로 받아 FP32로 더하는 텐서 연산과 TF32만 절반입니다. FP16 누산 텐서 연산, 텐서 코어를 쓰지 않는 일반 FP32 연산, INT8은 해당하지 않습니다. 해커 뉴스에 "FP32가 반감된 것"이라는 댓글이 있었지만(Hacker News 댓글) 사양표와 맞지 않습니다. 일반 FP32는 3090 35.6, A6000 38.7로 SM 수와 클럭 차이(약 8%)만큼만 차이가 납니다. 그래서 게임 성능도 바뀌지 않습니다. 저장소는 게임에 "No change"라고 적었고, Hardware Busters는 "Do not expect a single extra frame"이라고 썼습니다(Hardware Busters).
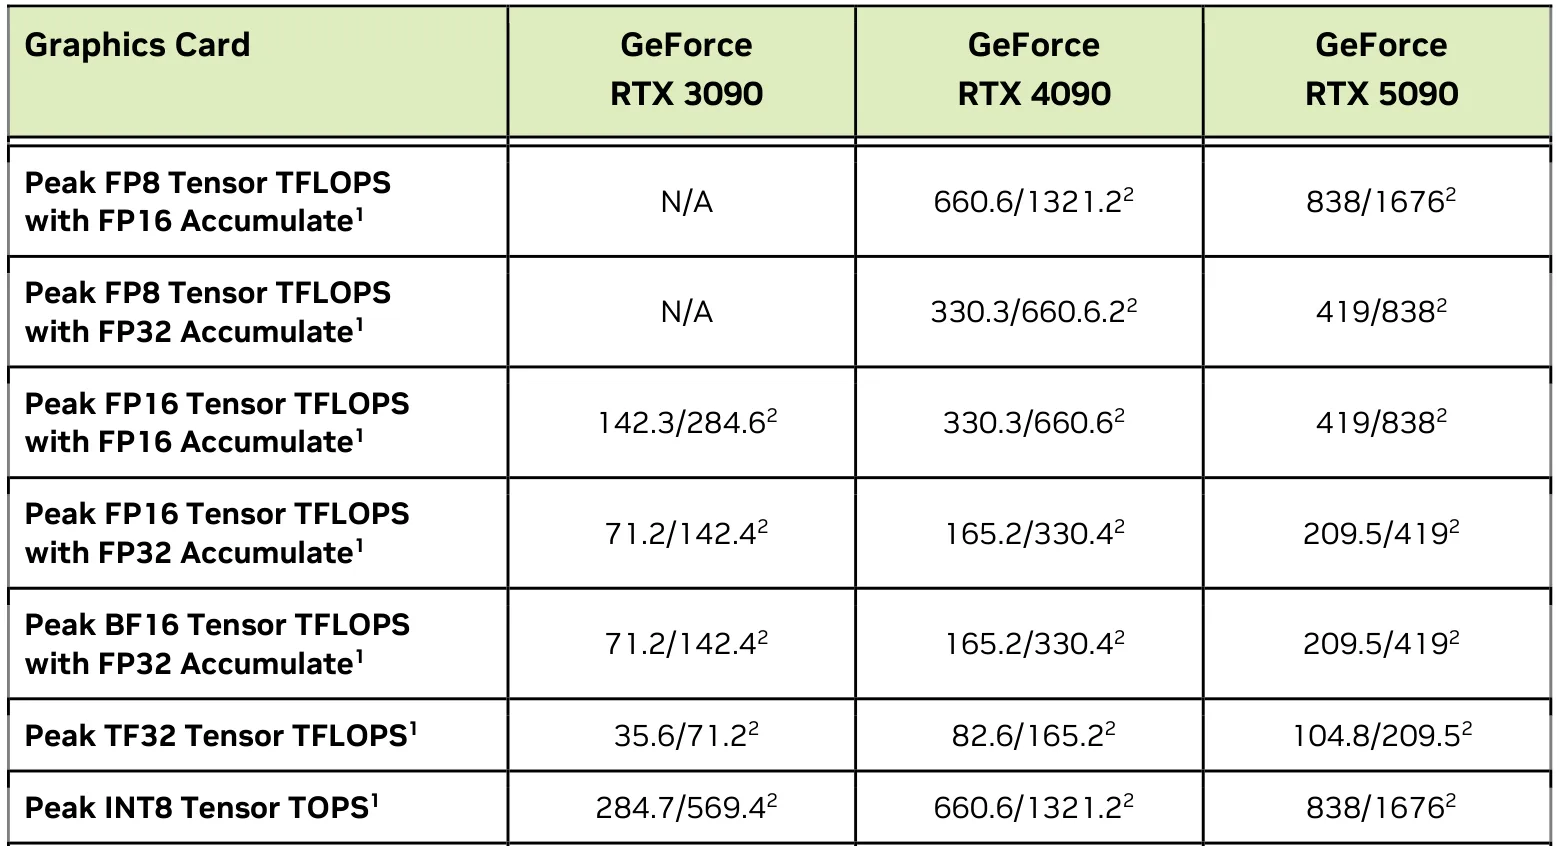
이 반감은 RTX 30만의 일이 아닙니다. 화이트페이퍼 값으로 FP32 누산 대 FP16 누산을 나눠 보면 지포스는 세대마다 모두 절반입니다(필자 계산).
| 카드 | FP16 누산 | FP32 누산 |
|---|---|---|
| RTX 3090 (지포스, GA102) | 142 | 71 |
| RTX A6000 (전문가용, GA102) | 154.8 | 154.8 |
| TITAN RTX (Turing) | 130.5 | 130.5 |
| RTX 2080 Ti (Turing 지포스) | 113.8 | 56.9 |
| RTX 3080 | 119 | 59.5 |
| RTX 3070 | 81.3 | 40.6 |
| RTX 4090 | 330.3 | 165.2 |
| RTX 5090 | 419 | 209.5 |
단위는 FP16 텐서 TFLOPS(희소성 제외)입니다. RTX 30과 TITAN RTX, A6000은 GA102 화이트페이퍼, 2080 Ti와 4090은 Ada 화이트페이퍼, 5090은 Blackwell 화이트페이퍼 값입니다(NVIDIA Ada 화이트페이퍼, NVIDIA RTX Blackwell 화이트페이퍼).
Ada와 Blackwell 세대의 전문가용 카드가 FP32 누산을 전속으로 내는지는 NVIDIA 문서에서 숫자로 확인하지 못했습니다. RTX 6000 Ada 데이터시트와 RTX PRO 6000 Blackwell 제품 페이지가 FP8, FP4 희소성 값만 적어 두었기 때문입니다(RTX 6000 Ada 데이터시트, RTX PRO 6000 제품 페이지).
어떻게 푸나: 펌웨어 취약점과 레지스터 두 개
GPU 안의 보안 처리 장치에서 도는 NVIDIA 서명 펌웨어의 취약점을 이용해, 평소 잠겨 있는 속도 선택 레지스터 두 개를 바꿉니다. 저장소 문서에 따르면 SEC2라는 보안 코어에서 도는 Booter 펌웨어에 스택 버퍼 오버플로가 있습니다. 모듈은 이를 ROP(반환 지향 프로그래밍, 펌웨어에 이미 있는 코드 조각을 이어 붙여 실행하는 기법)로 이용해 접근 권한 레지스터(FEAT_OVR_PLM)를 엽니다.
그다음 호스트가 속도 선택 레지스터 SS0에 0x88888888, SS1에 0x8을 쓰고, FLR(카드를 기능 단위로 다시 초기화하는 리셋)을 한 뒤 순정 NVIDIA 드라이버에 카드를 넘깁니다(How Ampere was unlocked, README 1.0).
작성자는 해커 뉴스에서 이를 "발행 빈도를 절반으로 만드는 비트 두 개를 뒤집는 것"이라고 설명했고(Hacker News 댓글), 서명되지 않은 코드는 실행하지 않는다고 했습니다. 공격 경로를 찾을 수 있었던 것은 NVIDIA가 디버그용 Booter를 공개된 테스트 키(index 37)로 암호화해 배포했기 때문입니다. 이를 풀어 보니 실제 제품용 펌웨어와 매우 비슷했습니다.
실제 사용 방식은 이렇습니다.
- 부팅 초기에 한 번 실행합니다. 패키지가 모듈을 initramfs(루트 파일 시스템을 올리기 전에 쓰는 초기 부팅 이미지)에 넣어 NVIDIA 드라이버보다 먼저 올립니다. 부팅이 끝난 뒤 손으로 모듈을 올리면 이미 드라이버가 잡은 카드에는 효과가 없습니다.
- 명시적으로 켜야 동작합니다. 커널 명령줄에
gpu_unlock.targets=all이나 PCI 주소를 넣지 않으면 아무 일도 하지 않습니다. - 드라이버와 VBIOS는 건드리지 않습니다. 필요한 펌웨어는 빌드할 때 NVIDIA 610.43.03 드라이버 패키지에서 사용자 PC로 직접 추출하고, 저장소는 재배포하지 않습니다(firmware/NOTICE.md).
- 영구 변경이 아닙니다. 커널 파라미터를 빼고 재부팅하면 해제하지 않은 상태로 돌아갑니다. RAM 절전에서 깨어날 때는 다시 해제하지만, 최대 절전(hibernation)은 지원하지 않습니다.
- 커널 서명 검사와 부딪힙니다. 트리 밖 모듈이라 커널에 taint(트리 밖이나 서명 안 된 모듈을 올렸다는 커널 표시)가 남습니다. 필자가 읽은 보고 대부분은 Secure Boot를 끄고 썼고, 한 보고자는 Secure Boot를 꺼야 한다고 적었습니다(GitHub #9, GitHub #25).
드라이버를 고치지 않는다는 점이 이전 해제 도구들과의 차이입니다. 소비자 카드의 NVENC 동시 인코딩 세션 제한을 푸는 nvidia-patch(2016년~), 가상 GPU 기능을 여는 vgpu_unlock(2021년), 4090 카드끼리 직접 통신(P2P)을 켜는 tinygrad 드라이버 포크(2024년)는 드라이버를 패치하거나 포크했습니다. 이번 기법은 채굴용 CMP 170HX의 제한을 푼 cmpunlocker(2026년 7월)에서 출발했고, 드라이버가 업데이트돼도 다시 패치할 필요가 없습니다.
벤치마크 2배는 어떤 조건이었나
헤드라인 수치는 3090 Ti 순정 전력 450 W에서 개조 드라이버로 잰 값이고, 전력 한도를 350 W로 묶은 3090 보고에서 행렬곱은 1.57배였습니다. README 1.0의 대표 표는 RTX 3090 Ti를 450 W로 두고 8192×8192 크기의 GEMM(일반 행렬곱)을 다섯 번 재 중앙값을 낸 결과입니다. BF16은 87.50에서 157.41 TFLOPS로 80% 늘었고, TF32는 42.58에서 82.61이었습니다. 그런데 같은 표의 FP16은 87.46에서 118.39로 35% 증가에 그쳤습니다.
이 표의 원본인 이슈 #1에는 "a modified NVIDIA 610.43.02 driver and a custom pre-udev initramfs hook"으로 쟀다고 적혀 있습니다(GitHub #1). 같은 이슈에서 다른 사용자가 순정 드라이버 615.78.08로 다시 재 보니 BF16은 63.0에서 105.9 TFLOPS였습니다. 다만 이때 전력도 300 W에서 380 W로 달라졌습니다. 그래서 이 사용자는 MHz당 처리량으로 비교했고, 0.043에서 0.083 TFLOPS/MHz로 거의 두 배가 됐습니다. 3090 Ti의 MHz당 이론값은 약 0.086이라 해제 전은 이론의 50%, 해제 후는 97%입니다(필자 계산).
전력 한도를 낮게 고정하면 이야기가 달라집니다. EVGA 3090의 전력 한도를 350 W(기본 420 W)로 고정한 보고에서 FP16은 70.8에서 111.3 TFLOPS로 1.57배였습니다. MHz당으로는 1.94배인데 클럭이 1680 MHz에서 1380 MHz로 내려갔고, 대조군인 INT8은 1.02배로 그대로였습니다(GitHub #33). 3090 일곱 장을 한 번에 푼 보고도 BF16이 59~64% 늘었고, 나머지는 클럭이 약 14% 떨어지는 데 쓰였다고 분석했습니다(GitHub #52). 연산을 더 하면 전력을 더 쓰기 때문에 전력 한도 안에서는 클럭을 낮춰 맞추는 것입니다.
3090 일곱 장을 가진 해커 뉴스 사용자 jacquesm은 "모두 전력을 올려야 25%를 넘었다"고 했습니다(Hacker News 댓글). 예외도 있습니다. 170 W짜리 RTX 3060 12GB는 FP16이 26.84에서 51.40 TFLOPS로 거의 두 배였습니다(GitHub #60). 카드와 전력 조건에 따라 결과가 크게 갈린다는 뜻입니다.
"전문가용 수준"이라는 말도 A6000과 같은 TFLOPS가 된다는 뜻은 아닙니다. 같은 클럭, 같은 SM에서 발행 속도가 같아진다는 뜻입니다. 해제한 3090의 이론 상한은 FP16 누산과 같은 142 TFLOPS로, A6000(154.8)의 약 92%입니다(필자 계산: SM 82/84 × 클럭 1695/1800).
실제 작업에서는 얼마나 빨라지나
FP16·BF16 행렬곱이 시간의 큰 몫을 차지하는 프리필과 학습은 보고마다 5~50%대로 빨라지고, 토큰 생성과 양자화 GGUF는 거의 그대로입니다. 프리필은 LLM이 프롬프트 전체를 한꺼번에 읽어 들이는 단계이고, 디코드는 답을 한 토큰씩 만들어 내는 단계입니다. 아래 수치는 모두 사용자 보고이고, 보고마다 카드와 전력 한도, 측정 방법이 다릅니다. GGUF는 llama.cpp와 Ollama가 주로 양자화 모델을 담는 데 쓰는 파일 형식입니다.
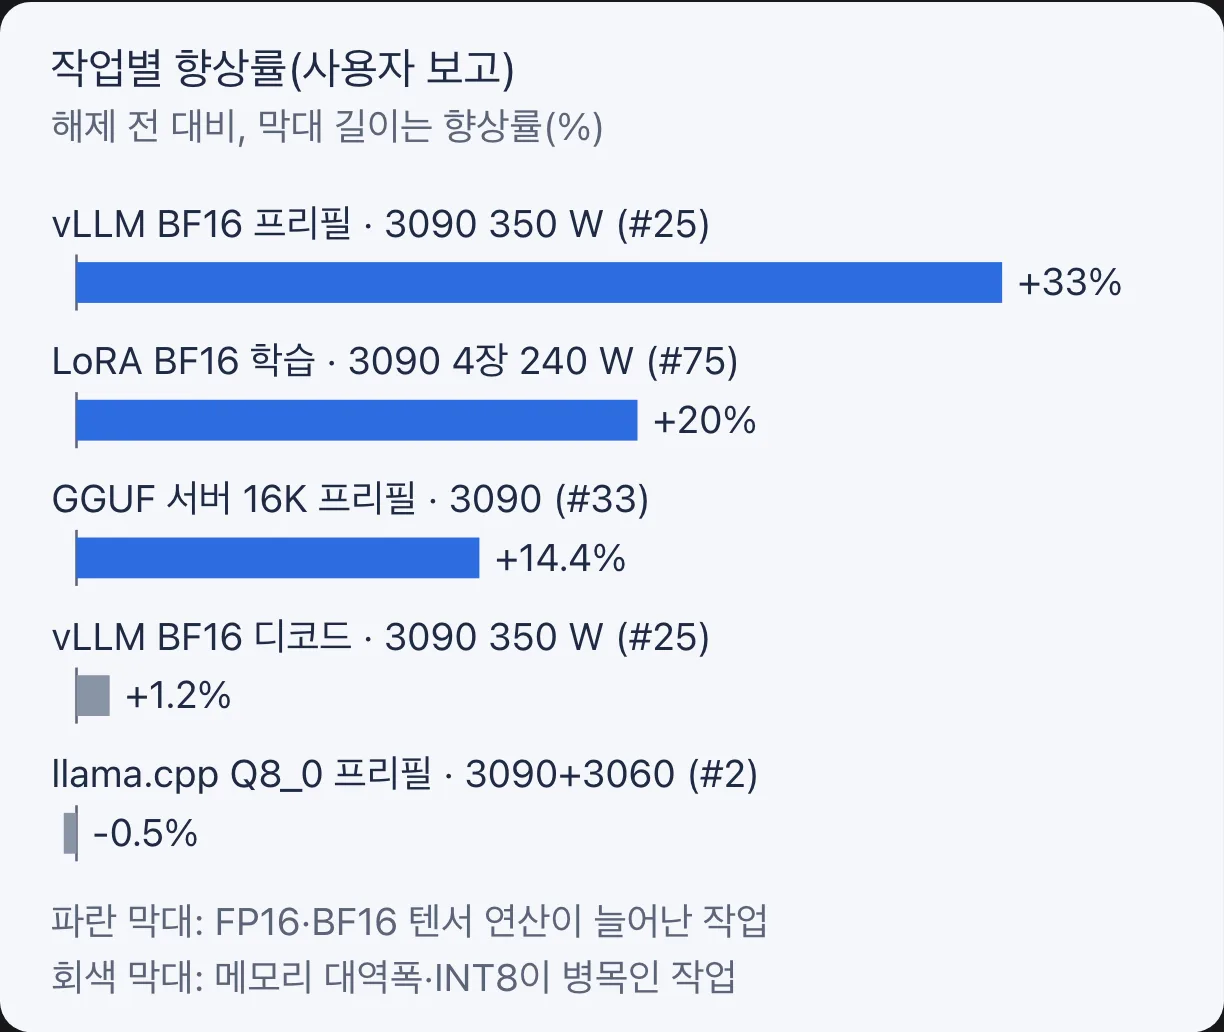
가장 조건이 잘 적힌 보고는 순정 3090을 350 W로 두고 vLLM으로 27B BF16 모델을 돌린 것입니다. 프리필 처리량은 두 번 잰 값을 합쳐 33% 늘었고, 첫 토큰까지 걸리는 시간(TTFT)은 24% 줄었지만 디코드는 1.2% 늘어난 데 그쳤습니다. 8시간 혼합 부하에서 오류(Xid)는 한 건도 없었습니다(GitHub #25). 27B급 모델을 GPU 한 장에서 돌릴 때의 조건과 점수 이야기는 Qwen 3.8 27B 성능 검증에도 정리했습니다.
메모리를 증설한 3080 20GB 두 장을 220 W로 고정한 보고도 vLLM 프리필 33~36%, 디코드는 오차 범위였고, 해제 전후 행렬곱 결과의 SHA-256 해시가 같았습니다. 같은 보고에서 GGUF 엔진(Strata)의 프리필은 8K 문맥에서 0.5~0.8%, 32K 이상에서 12~13%였습니다(GitHub #15).
전력을 올리면 폭이 커집니다. 가중치는 4비트, 계산은 16비트로 하는 vLLM W4A16 모델을 3090에서 돌린 보고는 250 W에서 프리필 25%, 375 W에서 50% 향상이었습니다(GitHub #107). 전력을 올리지 않고 큰 폭이 나온 카드도 있습니다. 기본 전력 170 W의 RTX 3060 12GB는 8,192토큰 프리필이 53% 늘었다고 보고됐습니다(GitHub #60).
학습도 같습니다. 3090 네 장으로 BF16 LoRA 학습을 한 보고는 240 W에서 스텝당 10.80초가 9.00초로 줄어 20% 빨라졌습니다. 함께 적힌 1.49배(7.24초)는 350 W로 올린 해제 상태를 240 W 순정과 비교한 값이라, 전력 상향 효과가 섞여 있습니다(GitHub #75).
이미지 생성 쪽은 ComfyUI Wiki가 r/StableDiffusion 보고를 정리하며 3090 Ti에서 31~60% 향상이라고 적었고, 같은 표의 INT8 모델은 대부분 0.3~4.6%였습니다. 레딧 원문은 확인하지 못한 2차 인용입니다(ComfyUI Wiki).
디코드는 그대로, 프리필도 2배가 아닌 이유
디코드는 연산이 아니라 메모리 대역폭이 병목이라 그대로입니다. 토큰 하나를 만들 때마다 모델 가중치 전체를 메모리에서 읽어야 하는데, 이 시간이 행렬곱 시간보다 깁니다. 텐서 코어가 두 배 빨라져도 기다리는 시간은 줄지 않습니다. README 1.0도 디코드를 "limited by memory bandwidth"라고 적고 변화 없음으로 분류했습니다.
프리필이 두 배가 되지 않는 이유도 같은 계산으로 설명됩니다. 이슈 #1의 순정 드라이버 재현자는 INT8 비중이 큰 vLLM W4A8 모델에서 FP32 누산 FP16·BF16 커널이 GPU 시간의 약 29%라고 쟀습니다. 그 부분만 두 배 빨라지면 전체 시간은 원래의 85.5%(1에서 0.29의 절반을 뺀 값)로 줄어 약 1.17배가 상한입니다(필자 계산). 실제로 잰 전체 향상은 약 5%로 측정 편차 범위였습니다(GitHub #1).
해커 뉴스에서도 3090 네 장을 쓰는 사용자는 200 W 제한에서 TFLOPS 시험은 25% 올랐지만 최대 전력으로 돌린 실사용 향상은 7~8%였다고 했고(Hacker News 댓글), 3060으로 nanochat을 학습한 사용자는 약 6%로 보고했습니다(Hacker News).
GGUF는 왜 거의 무관한가
llama.cpp와 Ollama가 쓰는 양자화 GGUF 모델은 행렬곱을 INT8 커널로 돌리기 때문에 해제와 거의 관계가 없습니다. 한 보고자는 llama.cpp가 양자화 가중치 행렬곱을 INT8 MMQ 커널(양자화 행렬곱 전용 커널)로 처리하고, 남은 이득은 주로 FlashAttention(주의 연산을 메모리 효율적으로 하는 커널)에서 나온다고 분석했습니다. 그래서 Q4 모델의 프리필은 컨텍스트 0에서 3%, 32k에서 10%, 100k에서 17%로 문맥이 길수록 커졌습니다(GitHub #158).
짧은 문맥이면 차이가 없습니다. 3090과 3060으로 Qwen 27B Q8_0을 돌린 보고는 프리필 -0.5%, 생성 0%로 "no measurable performance improvement"였고(GitHub #2), 3060에서 Ollama Q4_K_M 모델은 프리필 -1.6%, 디코드 -3.3%였습니다(GitHub #60).
GGUF 서버에서 16K 문맥 프리필이 14.4%(GitHub #33), 4K는 그대로이고 16K는 16%(GitHub #9)라는 보고도 긴 문맥에서만 이득이 났습니다. 다만 #33은 32K 문맥에서는 RAM에서 전문가 가중치를 읽어 오는 시간이 커서 변화가 없었다고 적었습니다.
README 1.0은 프리필 향상을 "+14~36%"로 적고 이슈 네 건(#9, #15, #25, #33)을 근거로 달았습니다. v2.0 README는 프리필 "+25~55%", 학습 "+25~50%"처럼 범위를 넓혀 적었지만 이슈 번호 없이 "compatibility reports"라고만 출처를 답니다. 필자가 열어 본 보고에는 25% 미만이 많아, 이 글은 1.0의 범위와 개별 보고를 기준으로 삼았습니다.
어떤 카드에서 되고, 어디서 안 되나
데스크톱 RTX 30(Ampere)은 안정적으로 되지만 예외가 있고, RTX 20·40은 실험 단계, RTX 50은 지원하지 않습니다. v2.0 README는 Ampere를 "Stable, 100+ user reports"로 분류했습니다. README 1.0의 카드별 표에서 BF16 행렬곱 향상은 3090이 25~67%, 3080 10GB가 70~73%, 3070이 73~81%, 3060 12GB가 약 80%였습니다. 가장 낮은 25%는 225 W로 제한한 카드에서 나왔습니다(README 1.0).
예외 사례도 구체적입니다.
- 3080 Ti 20GB OEM(GA102-250): 속도 선택 값이 바뀐 것까지 확인했는데 BF16은 절반 속도 그대로였습니다. 보고자는 이 제품은 반속도가 하드웨어에 고정됐을 수 있다고 추정했고, 보고서를 AI로 작성했다고 밝혔습니다(GitHub #28).
- 3070 노트북: 해제는 됐지만 FP16 향상이 0.99%였습니다(GitHub #124). README는 노트북이 쉴 때 dGPU(별도 그래픽 칩) 전원을 끄면 해제가 조용히 풀린다고 경고합니다.
- 기가바이트 3060 12GB(10de:2544): 해제가 -22 오류로 실패했고, 실패한 뒤 NVIDIA 드라이버가 카드를 잡지 못했습니다(GitHub #184).
- GA103 데스크톱 카드: README 1.0 시점에는 보고가 없었습니다.
RTX 40의 숫자는 RTX 30과 따로 봐야 합니다. v2.0 README는 4090을 165에서 329 TFLOPS, "+100%"로 적었지만 괄호 안에 "peak MMA rate"(텐서 명령의 최대 발행률)라고 달았습니다. Ada용 포크로 잰 실제 GEMM은 450 W에서 FP16 10%, BF16 17% 향상이었고(GitHub #157), 상류 저장소의 ada-beta 브랜치로 잰 영상 생성(모델 대부분 INT8)은 250 W에서 5%, 340 W에서 14%였습니다(GitHub #218). README 스스로 "The RTX 4090 runs out of power before it runs out of tensor cores"라고 적었습니다.
RTX 50에 대해 작성자는 Blackwell과 Hopper는 부팅 구조가 다르고 보안 계층이 더 많아 "50 시리즈는 기대하지 말라"고 했습니다(Hacker News 댓글).
써도 될까: 위험과 라이선스
펌웨어 취약점을 쓰는 비공식 도구라 실패 사례가 있고, 장기 신뢰성 데이터는 없으며, NVIDIA 라이선스와 충돌할 소지가 있습니다. 해커 뉴스 스레드의 첫 댓글도 "결과는 진짜지만 펌웨어 익스플로잇에 기대니 약간 위험하다"는 내용이었습니다(Hacker News 댓글).
보고된 문제는 이렇습니다. RTX 3070 LHR(채굴 성능을 제한한 판) 사용자는 해제한 채로 다섯 번 부팅해 첫 번째에 데스크톱이 뜬 지 약 40초 뒤 화면과 네트워크가 멈추는 하드락을 겪었고, 나머지 네 번은 정상이었습니다(GitHub #137). 한 버전에서는 냉부팅이 아닌 상태에서 해제가 실패하면 완전히 재부팅하기 전까지 NVIDIA 드라이버가 카드를 쓰지 못했고, 작성자가 해당 변경을 되돌렸습니다(GitHub #23). README는 카드 펌웨어가 멈추지 않으면 다음 전원 차단까지 DMA 버퍼(GPU가 시스템 메모리를 직접 읽고 쓰는 영역)를 유지한다고 적어 두었습니다.
전력과 발열도 따져야 합니다. 3090급 카드에서 2배에 가까운 수치를 보려면 전력 한도를 올려야 하고, 해커 뉴스의 jacquesm은 3090을 450 W로 올리는 것은 순정 쿨러 설계를 크게 넘는다고 지적했습니다(Hacker News 댓글).
월요신문은 Turing용 해제 도구 turing-unlock 개발자 nlzy의 "텐서 코어는 매우 높은 전력을 소비하며, 최대 속도로 제한을 해제하면 하드웨어가 손상될 수 있다"는 경고를 인용했습니다(월요신문).
README FAQ는 GPU가 손상될 가능성을 "very unlikely"라고 적었고(README), 작성자는 수냉 3090 두 장으로 한 달째 문제없이 쓰고 있다고 했습니다(Hacker News 댓글). 다만 이는 작성자 쪽 의견이고, 필자가 찾은 공개 보고 중 가장 긴 연속 부하 시험은 8시간 남짓입니다(GitHub #25).
라이선스와 NVIDIA 입장
NVIDIA 드라이버 라이선스에는 기술적 제한을 우회하지 말라는 조항이 있습니다. NVIDIA Driver License Agreement(2025년 2월 25일판) 2.6항은 "You may not bypass, disable, or circumvent any technical limitation, encryption, security"라고 적고, 2.2항은 역공학을 금지합니다(NVIDIA 드라이버 라이선스). 모듈은 드라이버를 수정하지 않고 펌웨어도 재배포하지 않는 구조이지만, 쓰는 펌웨어는 이 라이선스를 따릅니다. 이 글은 법률 판단을 하지 않고, 충돌 소지가 있다는 데까지만 적습니다.
모듈 자체는 README에 GPL-2.0-only라고 적혀 있지만 저장소 최상위에 LICENSE 파일은 없고, GPL 전문은 licenses/ 폴더에 있습니다.
10월 28일 기준 NVIDIA의 공식 입장은 없습니다. Tom's Hardware, Notebookcheck, Hardware Busters, 월요신문 기사 모두 NVIDIA 코멘트를 싣지 못했습니다(Tom's Hardware(야후 재게재), Notebookcheck). 보증에 미치는 영향에 대해 NVIDIA나 제조사가 언급한 자료도 찾지 못했습니다. NVIDIA가 막을 수 있느냐는 질문에 작성자는 현재 펌웨어 서명 키를 퓨즈로 폐기하는 것 말고는 방법이 없어 보인다는 의견을 냈습니다(GitHub #169).
설치 경로도 조심해야 합니다. 공식 지원은 리눅스뿐입니다. README FAQ는 떠도는 Windows 설치 프로그램을 매우 조심하라고 했고, 프로젝트와 무관한 코인과 웹사이트도 경고합니다. 원 저장소와 별개인 Windows UEFI 포트(impacifist/Windows-GPU-UNLOCK)는 한국어 부팅 안내까지 있어 국내에서도 공유되지만(디시인사이드), 성공 보고는 특정 메인보드와 카드 조합에 한정돼 있습니다.
국내 반응과 중고가 이야기
국내에서는 커뮤니티 사용기와 번역 기사가 먼저 돌았고, 중고 3090 값이 올랐다는 보도는 근거가 약합니다. 필자가 찾은 가장 이른 국내 글은 저장소가 생긴 10월 18일의 디시인사이드 글입니다(디시인사이드). 글쓴이는 "올린 사람 말에 따르면" 안정성이 보장되지 않았으니 함부로 따라 하지 말라고 전했습니다. 10월 22일 루리웹에는 3090 BF16이 76.7에서 127.6 TFLOPS로, 이미지 생성이 8분에서 6분으로 줄었다는 사용기가 올라왔는데, 전력 수치와 측정 조건이 없는 일화입니다(루리웹).
이후 10월 25일 퀘이사존 번역 기사(퀘이사존), 10월 26일 케이벤치(케이벤치)와 AI타임스(AI타임스), 10월 27일 월요신문 기사가 나왔습니다. 국내 기사의 수치는 대부분 외신과 GitHub 이슈를 옮긴 것입니다.
Wccftech 기사와 이를 옮긴 일부 번역 글은 드라이버 모듈을 패치해 PCIe 장치 ID를 바꾸는 방식이라고 소개했지만(Wccftech), 저장소 설명과 다릅니다.
해외에서는 중고 3090 값이 크게 올랐다는 보도가 있지만(Wccftech), 수집 방법이 적혀 있지 않고 근거로 보이는 것은 매물 하나입니다. 국내 원화 시세를 정리한 자료는 찾지 못했습니다. 해제 소식만 보고 중고 카드를 비싸게 사는 판단은 근거가 약합니다.
누가 써 볼 만한가
이미 리눅스에서 BF16 학습이나 긴 프롬프트 vLLM 추론을 돌리는 RTX 3090·3080 사용자라면 효과를 볼 가능성이 큽니다. 이미지 생성도 빨라졌다는 보고가 있습니다. 반대로 llama.cpp나 Ollama로 양자화 모델과 채팅만 한다면 거의 의미가 없습니다. 디코드 속도는 그대로이고, 게임 성능은 바뀌지 않습니다. 전력 한도를 그대로 둔 3090에서 기대할 수 있는 폭은 행렬곱 1.6배 안팎이고, 프리필과 학습은 보고마다 5~50%대, 대개 10~30%대였습니다(필자 정리).
써 보기로 했다면 다음을 확인하는 편이 안전합니다.
- 같은 조건에서 전후를 잽니다. 같은 커널, 같은 드라이버, 같은 전력 한도에서 순정 성능을 먼저 재야 합니다(dev.to). 효과 확인은 FP32 누산 GEMM이나 내 실제 작업으로 하고, 양자화 GGUF로 재면 효과가 거의 보이지 않습니다.
- 전력 한도를 따로 기록합니다. 전력을 올리고 잰 숫자에는 해제 효과와 전력 상향 효과가 섞입니다. 이슈 #75의 1.49배가 그런 예입니다.
- 출력을 비교합니다. 보고된 사례들은 해제 전후 출력이 비트 단위로 같았지만, 내 작업에서도 같은지 한 번은 확인해 둡니다.
- 되돌리는 법을 먼저 준비합니다. 커널 로그에서
gpu_unlock: unlocked가 찍혔는지 확인하고, 문제가 생기면 커널 파라미터를 지우고 부트로더 설정을 갱신한 뒤 재부팅합니다(GitHub #25). README는 펌웨어가 멈추지 않았을 때는 전원을 끈 뒤 다시 시도하라고 적었습니다.
카드가 없다면 해제를 위해 중고 카드를 찾기보다 빌려 쓰는 길도 있습니다. RTX 5090 빌려 Qwen3.8 돌리기에 시간당 비용과 손익분기를 정리했습니다.
출처
- Zagitta/gpu-unlock: github.com/Zagitta/gpu-unlock
- Hacker News: news.ycombinator.com/item?id=50219700
- GeekNews: news.hada.io/topic?id=35938
- NVIDIA GA102 화이트페이퍼 V2.0: nvidia.com/content/PDF/nvidia-ampere-ga-102-gpu-architecture-whitepaper…
- Hacker News 댓글: news.ycombinator.com/item?id=50221729
- Hardware Busters: hwbusters.com/news/rtx-4090-tensor-unlock-doubles-fp16-throughput-on-li…
- NVIDIA Ada 화이트페이퍼: images.nvidia.com/aem-dam/Solutions/geforce/ada/nvidia-ada-gpu-architec…
- NVIDIA RTX Blackwell 화이트페이퍼 V1.1: images.nvidia.com/aem-dam/Solutions/geforce/blackwell/nvidia-rtx-blackw…
- RTX 6000 Ada 데이터시트: nvidia.com/content/dam/en-zz/Solutions/design-visualization/rtx-6000/pr…
- RTX PRO 6000 제품 페이지: nvidia.com/en-us/products/workstations/professional-desktop-gpus/rtx-pr…
- How Ampere was unlocked: github.com/Zagitta/gpu-unlock/blob/main/docs/How Ampere was unlocked.md
- README 1.0: github.com/Zagitta/gpu-unlock/blob/e9f9408/README.md
- Hacker News 댓글: news.ycombinator.com/item?id=50222247
- firmware/NOTICE.md: github.com/Zagitta/gpu-unlock/blob/main/firmware/NOTICE.md
- GitHub #9: github.com/Zagitta/gpu-unlock/issues/9
- GitHub #25: github.com/Zagitta/gpu-unlock/issues/25
- nvidia-patch: github.com/keylase/nvidia-patch
- vgpu_unlock: github.com/DualCoder/vgpu_unlock
- tinygrad 드라이버 포크: github.com/tinygrad/open-gpu-kernel-modules
- cmpunlocker: github.com/amoghmunikote/cmpunlocker
- GitHub #1: github.com/Zagitta/gpu-unlock/issues/1
- GitHub #33: github.com/Zagitta/gpu-unlock/issues/33
- GitHub #52: github.com/Zagitta/gpu-unlock/issues/52
- Hacker News 댓글: news.ycombinator.com/item?id=50221917
- GitHub #60: github.com/Zagitta/gpu-unlock/issues/60
- GitHub #75: github.com/Zagitta/gpu-unlock/issues/75
- GitHub #2: github.com/Zagitta/gpu-unlock/issues/2
- GitHub #15: github.com/Zagitta/gpu-unlock/issues/15
- GitHub #107: github.com/Zagitta/gpu-unlock/issues/107
- ComfyUI Wiki: comfyui-wiki.com/en/news/2026-10-18-gpu-unlock-rtx30-bf16
- Hacker News 댓글: news.ycombinator.com/item?id=50224176
- GitHub #158: github.com/Zagitta/gpu-unlock/issues/158
- GitHub #28: github.com/Zagitta/gpu-unlock/issues/28
- GitHub #124: github.com/Zagitta/gpu-unlock/issues/124
- GitHub #184: github.com/Zagitta/gpu-unlock/issues/184
- GitHub #157: github.com/Zagitta/gpu-unlock/issues/157
- GitHub #218: github.com/Zagitta/gpu-unlock/issues/218
- Hacker News 댓글: news.ycombinator.com/item?id=50225140
- Hacker News 댓글: news.ycombinator.com/item?id=50219868
- GitHub #137: github.com/Zagitta/gpu-unlock/issues/137
- GitHub #23: github.com/Zagitta/gpu-unlock/issues/23
- Hacker News 댓글: news.ycombinator.com/item?id=50221626
- 월요신문: wolyo.co.kr/news/articleView.html?idxno=319597
- NVIDIA 드라이버 라이선스: nvidia.com/en-us/drivers/nvidia-license
- Tom's Hardware(야후 재게재): tech.yahoo.com/computing/articles/nvidia-rtx-20-30-40-110000982.html
- Notebookcheck: notebookcheck.net/Nvidia-RTX-3090-performance-nearly-doubles-with-free-…
- GitHub #169: github.com/Zagitta/gpu-unlock/issues/169
- impacifist/Windows-GPU-UNLOCK: github.com/impacifist/Windows-GPU-UNLOCK
- 디시인사이드: gall.dcinside.com/mgallery/board/view/?id=ai_utilize&no=143423
- 디시인사이드: gall.dcinside.com/mgallery/board/view/?id=sff&no=1763796
- 루리웹: bbs.ruliweb.com/etcs/board/300143/read/77107757
- 퀘이사존: quasarzone.com/bbs/qn_hardware/views/2082621
- 케이벤치: kbench.com/?q=node/282752
- AI타임스: aitimes.com/news/articleView.html?idxno=216672
- Wccftech: wccftech.com/nvidia-geforce-rtx-3090-ti-gets-nearly-80-fp16-bf16-comput…
- Wccftech: wccftech.com/nvidia-rtx-30-40-gpus-get-faster-in-ai-llms-with-new-unloc…
- dev.to: dev.to/dedupedai/rtx-4090-2x-fp16-unlock-real-gemm-gains-are-12-to-34-h…