Qwen3.8 27B 같은 오픈 모델을 써 보려고 지금 RTX 5090을 사면 카드값만 약 900만원이 들지만, Runpod에서 빌리면 시간당 약 937원입니다. 하루 8시간씩 쓴다면 카드값을 다 쓰는 데 3년 넘게 걸리므로, 매일 24시간 돌릴 계획이 아니라면 먼저 빌려 보는 편이 합리적입니다. 다만 "1년 전 프론티어 모델급"이라는 말은 최대 추론 설정의 종합 지수에서만 맞는 이야기이고, 32GB 카드에 올라가는 것은 원본이 아니라 4비트 버전입니다. API 키 하나로 서버가 지켜진다는 설명도 vLLM 공식 문서와 어긋납니다. 이 글은 그 계산과 설정 순서, 함정을 공식 문서와 가격 원자료로 정리합니다.
이 글은 2026년 10월 3일에 올라온 유튜브 영상 오픈 모델 돌리려면 1000만원... 그냥 Runpod에서 빌려 씁니다 | RTX 5090 + Qwen 3.8(개발동생)을 계기로 썼습니다. 영상 설명란에 적혀 있듯 Runpod의 유료 광고가 포함된 영상입니다. 필자는 Runpod와 금전 관계가 없고, 영상의 주장을 Qwen 모델 카드, Artificial Analysis, Runpod와 vLLM 공식 문서, 다나와 가격으로 다시 확인했습니다. 필자는 『클로드 코드 제대로 시작하기』를 썼고, 지금 최상위 모델을 쓰는 방법은 Claude Opus 5.5 잘 쓰는 법 10가지에 따로 정리했습니다.
핵심 요약
- 1000만원은 지금 시세로는 맞지만 급등한 값입니다. 다나와 기준 RTX 5090 최저가는 약 899만원(2026-10-09)으로, 2025년 1월 국내 권장가 369만9천원의 2.4배입니다. 미국에서도 최저가가 5,000달러로 출시가의 2.5배라는 보도가 있습니다.
- 빌리면 시간당 약 937원입니다. Runpod Community Cloud의 RTX 5090은 0.69달러, 60GB 컨테이너 디스크를 더해 약 0.70달러이고 초 단위로 과금됩니다. 카드값 899만원을 다 쓰려면 24시간 내내 13개월, 하루 8시간이면 3.3년이 걸립니다(필자 계산, 1달러 1,342원).
- "1년 전 프론티어급"은 지수상으로는 사실입니다. Artificial Analysis 지수(v4.3.2)에서 Qwen3.8 27B(xhigh)는 34점으로 Claude Opus 4.5(29)와 GPT-5(23)보다 높습니다. 하지만 지수를 재는 데 토큰 2억 개를 쓴 최대 추론 설정의 값이고, 현재 1위(58점)와는 24점 차이입니다.
- 5090 한 장에는 4비트 버전이 들어갑니다. 가중치만 원본 BF16이 51.7GiB, 공식 FP8이 28.8GiB라 vLLM 기준 가용 메모리 31.4GiB에는 사실상 못 들어가고, 영상도 실제로는 NVIDIA의 NVFP4(20.4GiB) 버전을 띄웠습니다.
- API 키만 믿으면 안 됩니다. vLLM의
--api-key는/v1등 일부 경로만 막고/invocations는 인증 없이 열어 두며, Runpod HTTP 프록시 주소는 공개 주소입니다. 다 쓰면 Stop이 아니라 Terminate까지 하세요.
목차
- 오픈 모델 돌리려면 정말 1000만원이 드나요?
- Qwen3.8 27B는 정말 1년 전 프론티어급인가요?
- 32GB 카드에 27B 모델이 어떻게 들어가나요?
- 사는 것과 빌리는 것, 손익분기는 언제인가요?
- Runpod에서 Qwen3.8 27B를 띄우고 Codex에 붙이는 순서
- 영상이 덜 말한 함정 다섯 가지
- 속도는 어느 정도 나오나요?
- 이 방법이 안 맞는 경우
- 이 글의 자료를 고른 방법
- 자주 묻는 질문
- 마치며
- 출처
오픈 모델 돌리려면 정말 1000만원이 드나요?
2026년 10월 시세로는 RTX 5090 PC 한 대에 1,000만원 가까이 드는 것이 맞습니다. 다만 이 값은 출시 권장가의 2.4배로 오른 급등 시세이고, 27B 모델을 돌리는 데 꼭 5090이 필요한 것도 아닙니다. 영상은 다나와에서 870만~960만원대 가격을 보여 줬는데, 필자가 10월 9일에 다나와를 다시 검색해 보니 상품별 최저가가 약 899만원(MANLI)부터 900만원대 초중반에 몰려 있었습니다(다나와 RTX5090 검색, 2026-10-09). 여기에 1000W급 파워와 본체를 더하면 영상의 "천만원"이 나옵니다.
이 가격이 정상가는 아닙니다. 엔비디아가 2025년 1월 RTX 5090을 공개하며 제시한 권장가는 1,999달러, 국내 369만9천원이었습니다. 지디넷코리아는 2026년 9월 14일 다나와 기준 최저가가 830만원 선이고 일부 제품은 1,000만원을 넘는다고 보도하며, 중국 업체들이 소비자용 5090을 AI 워크스테이션용으로 대량 사들이는 정황을 원인으로 들었습니다(지디넷코리아, 2026-09-14). 미국도 비슷해서, Tom's Hardware는 새 5090 최저가가 5,000달러로 출시가의 2.5배가 됐다고 썼습니다(Tom's Hardware, 2026-09-01). 아시아타임즈가 정리한 ASUS TUF 5090 한 제품의 가격만 봐도 2025년 8월 400만원에서 2026년 1월 480만원, 6월 700만원으로 올랐습니다(아시아타임즈, 2026-10-06).
영상이 대안으로 든 DGX Spark도 싸지 않습니다. 엔비디아는 2026년 2월 메모리 공급 문제로 Founders Edition 가격을 3,999달러에서 4,699달러로 올렸고(NVIDIA Developer Forums, 2026-02-25), 국내 다나와에서는 DGX Spark 본품과 ASUS GX10 같은 OEM 제품이 950만~1,030만원대에 팔립니다(다나와 DGX Spark 검색, 2026-10-09). 더 중요한 차이는 속도입니다. DGX Spark의 128GB 통합 메모리는 대역폭이 273GB/s로(NVIDIA DGX Spark) 5090의 약 15%입니다. 토큰을 하나 만들 때마다 가중치 전체를 메모리에서 읽어야 하므로, Spark는 더 큰 모델을 담을 수 있지만, 같은 27B 모델이라면 생성은 훨씬 느립니다.
반대로 "오픈 모델을 돌리려면 1000만원"이라는 말은 과장입니다. 27B 모델을 4비트로 줄인 GGUF 파일은 약 17GB이고, Simon Willison은 이 17GB짜리 Q4_K_M 빌드를 128GB 맥북 프로와 DGX Spark의 LM Studio에서 돌렸습니다(Simon Willison, 2026-08-16). 24GB 카드에도 들어가는 크기입니다. 32GB가 필요해지는 것은 컨텍스트를 길게 잡거나 vLLM 같은 서빙 엔진으로 여러 요청을 받을 때입니다.
Qwen3.8 27B는 정말 1년 전 프론티어급인가요?
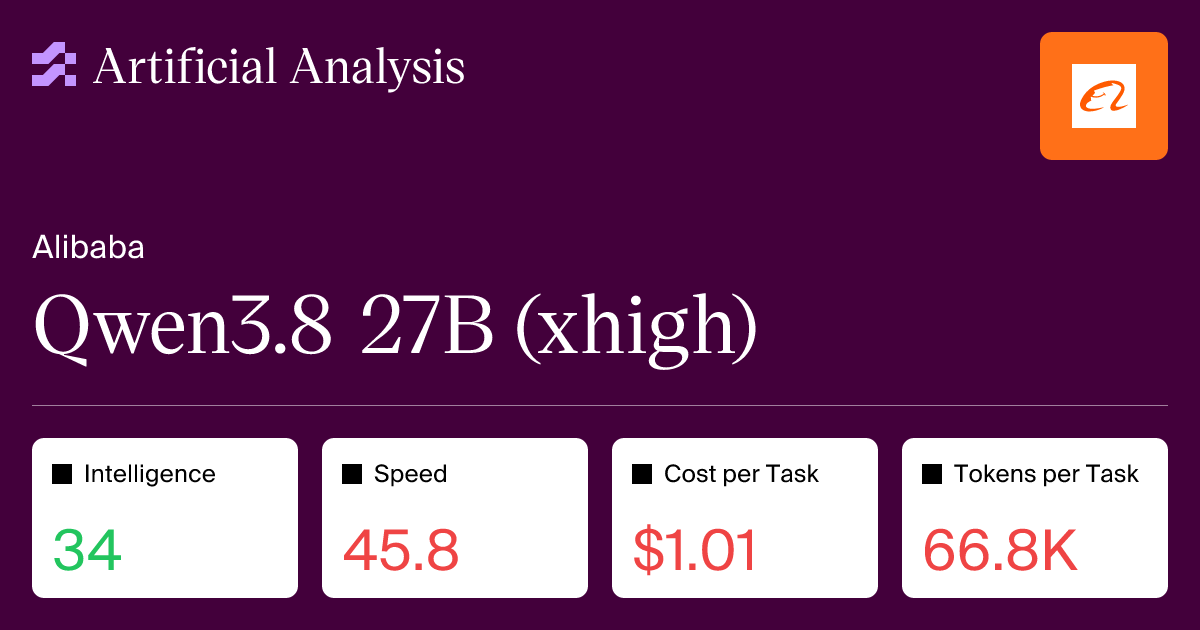
Artificial Analysis 종합 지수만 보면 그렇습니다. Qwen3.8 27B(xhigh)는 34점으로, 2025년 11월에 나온 Claude Opus 4.5(추론 모드, 29점)와 2025년 8월에 나온 GPT-5(high, 23점)보다 높습니다. 필자가 10월 9일 세 모델 페이지를 직접 열어 확인한 값이고, 영상의 숫자와 같습니다(Qwen3.8 27B, Claude Opus 4.5, GPT-5). Qwen3.8 27B는 2026년 8월 14일 Apache 2.0 라이선스로 공개된 dense 모델이고, 컨텍스트는 기본 262,144토큰입니다(Hugging Face, Qwen/Qwen3.8-27B).
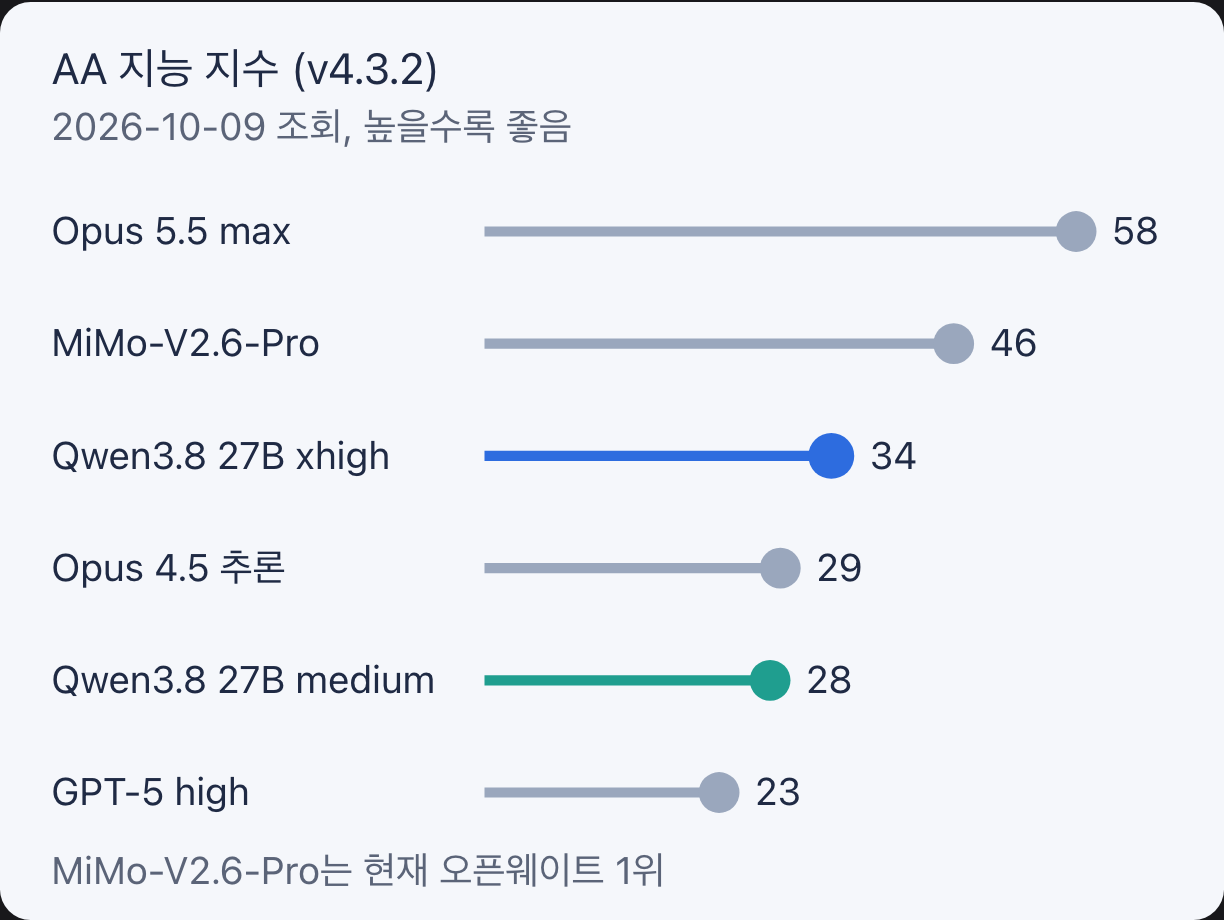
영상이 고른 두 모델만 넘은 것도 아닙니다. 같은 지수에서 2025년 11월에 나온 Gemini 3 Pro Preview(High)는 28점, GPT-5.1(High)은 25점이라(Gemini 3 Pro, GPT-5.1), 필자가 확인한 2025년 하반기 대표 모델 네 개를 모두 넘는 점수입니다. 다만 추론 강도를 medium으로 낮추면 28점으로 Gemini 3 Pro Preview와 같아집니다. 그런데 이 34점을 "1년 전 최고 모델과 같은 체감"으로 읽기에는 걸리는 점이 네 가지 있습니다.
- 최대 추론 설정의 값입니다. 34점은 추론 강도 xhigh 기준입니다. Artificial Analysis는 이 모델이 지수를 재는 동안 토큰 2억 개를 생성해 비교군 중앙값(8,200만 개)의 두 배가 넘었다며 "notably slow and very verbose"라고 평가했습니다. Simon Willison은 기본값 xhigh로 펠리컨 SVG 하나를 그리게 했더니 추론 토큰 22,276개, 21분이 걸렸고, 추론을 끄자 137초에 끝났다고 기록했습니다.
- 영상이 실제로 돌린 것은 4비트 버전입니다. 작성자는 설명란과 설정 gist에 "34점은 원래 정밀도 모델 기준"이라고 적었습니다. NVIDIA가 공개한 NVFP4 버전의 자체 측정에서도 GPQA가 88.92에서 88.01로, Terminal-Bench가 75.56에서 74.02로 조금씩 내려갑니다(Hugging Face, nvidia/Qwen3.8-27B-NVFP4).
- 지수 버전이 바뀌면 점수도 바뀝니다. 출시 직후 "52점"이라는 소개가 돌았는데(긱뉴스, 2026-08-18), 이는 평가 구성이 다른 이전 지수 버전의 값으로 보입니다. 지금 페이지는 10개 평가로 구성된 v4.3.2 기준 34점이므로, 버전이 다른 점수끼리 비교하면 안 됩니다(AA Methodology).
- 지수 자체에 대한 회의도 있습니다. Hacker News에서는 "AA 지수는 구성 벤치마크 상당수가 포화돼 더 이상 좋은 지표로 여겨지지 않는다"는 지적이 나왔습니다(HN 댓글, 2026-09-23). 지금 1위인 Claude Opus 5.5(max)는 58점으로, 27B 모델과는 아직 24점 차이입니다.
정리하면 "27B 오픈 모델이 1년 전 최상위 모델의 종합 지수를 넘었다"까지는 사실이고, "그러니 같은 품질로 코딩해 준다"는 확인되지 않았습니다. 국내 사용기도 이 간극을 보여 줍니다. 16GB 카드에서 이 모델로 한국어 PM 문서를 만들어 본 한 개발자는 문서 변환 품질은 좋지만 느려서 반복 업무에는 맞지 않는다고 평가했고(네이버 블로그 bangdo4, 2026-09-24), 128GB 맥북으로 반년을 써 온 다른 사용자는 계획은 프론티어 모델, 구현은 로컬 Qwen, 어려운 문제는 Codex로 역할을 나눠 쓴다고 했습니다(네이버 블로그 pediatrics_lsj, 2026-09-14).
32GB 카드에 27B 모델이 어떻게 들어가나요?
원본 그대로는 들어가지 않습니다. 27B 모델의 BF16 가중치는 51.7GiB(파일 55.6GB), Qwen이 공식으로 낸 FP8 버전도 가중치만 28.8GiB(파일 30.9GB)라서, vLLM 기준 5090 한 장의 가용 메모리 31.4GiB에 올리면 대화 기억(KV 캐시)을 둘 자리가 거의 남지 않습니다. 그래서 영상의 설정은 NVIDIA가 만든 NVFP4(4비트) 버전 nvidia/Qwen3.8-27B-NVFP4(20.4GiB, 파일 21.9GB)를 씁니다. vLLM 레시피도 5090 한 장에는 NVFP4만 들어가며 그마저 CUDA graph를 끄는 등 메모리를 아껴야 한다고 적고, FP8은 두 장으로 나눠 올리는 구성만 검증했습니다(vLLM Recipes, Qwen3.8-27B, 2026-10-08).
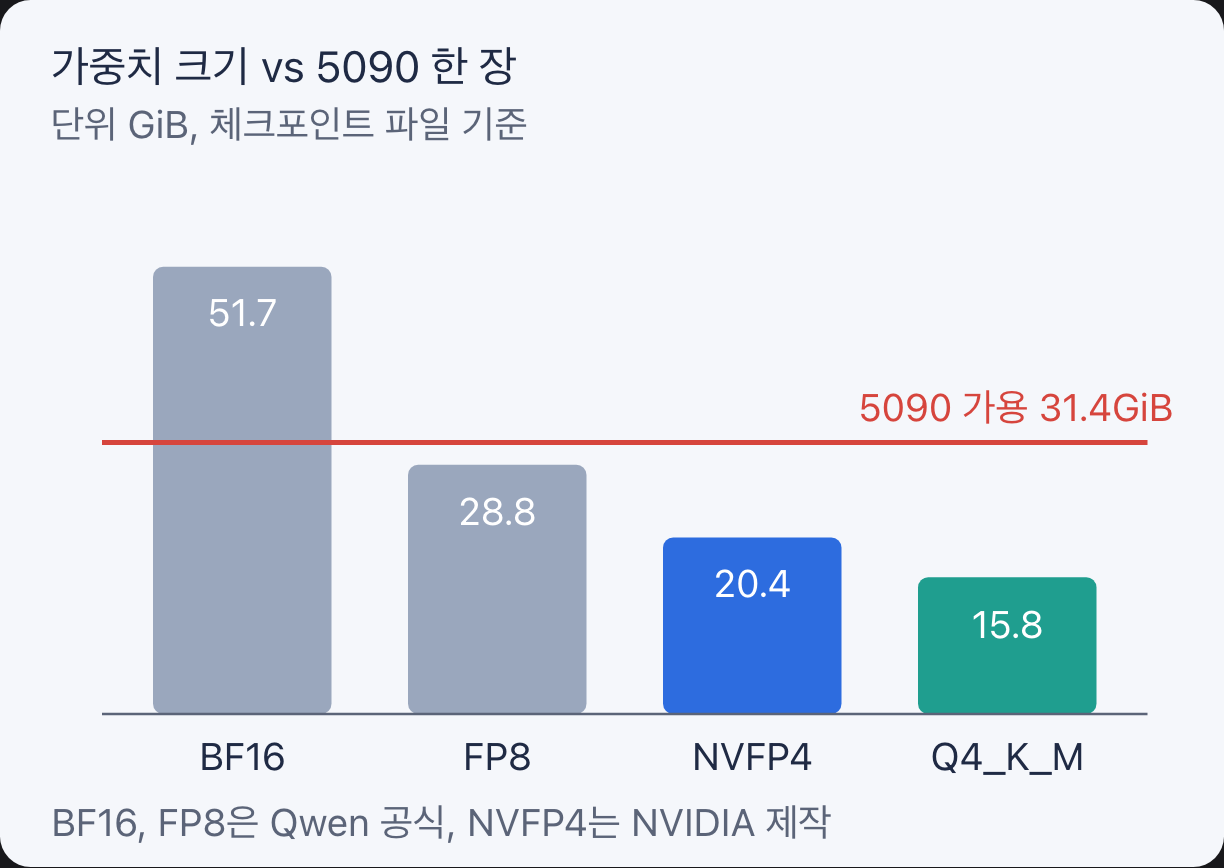
흔히 "27B면 FP8 27GB, 4비트 14GB"라고 어림하지만 실제 파일은 그보다 큽니다. Qwen3.8 27B는 이미지와 영상을 받는 비전 인코더를 품은 모델이고, 실제 파라미터 수도 27B가 아니라 약 277.8억 개입니다. FP8 버전도 비전 인코더 등 일부를 BF16으로 남겨 두어 30.9GB가 된 것으로 보입니다.
대신 이 모델은 KV 캐시가 작습니다. 공식 config.json을 보면 64개 층 가운데 일반 어텐션은 16개 층뿐이고 나머지 48개 층은 고정 크기 상태만 들고 가는 linear attention(Gated DeltaNet)입니다. 필자가 config 값(KV 헤드 4개, 헤드 크기 256)으로 계산해 보니 토큰 하나에 KV 캐시가 FP8 기준 32KiB, 13만1,072토큰 대화 하나를 꽉 채워도 4GiB입니다. 영상 설정이 --kv-cache-dtype fp8 --max-model-len 131072로 13만 토큰 컨텍스트를 잡을 수 있는 이유입니다.
반대로 linear attention 층의 상태는 요청마다 따로 잡힙니다. 필자 계산으로 48개 층의 상태는 요청 하나에 약 144MiB입니다. 작성자 gist는 --max-num-seqs 16을 빼면 메모리 부족으로 서버가 뜨지 않는다고 적었는데, 동시 요청 수를 16개로 묶으면 이 상태 메모리(16개면 약 2.25GiB)와 실행 버퍼가 함께 줄어든다는 것이 필자의 해석입니다. 같은 Pod를 여러 사람이 함께 쓰면 17번째 요청부터는 대기열에 쌓인다는 뜻이기도 합니다.
사는 것과 빌리는 것, 손익분기는 언제인가요?
하루 몇 시간 쓰느냐로 갈립니다. 카드값 899만원을 Runpod Community 요금(시간당 약 937원)으로 나누면 9,594시간이고, 24시간 내내 돌리면 약 13개월, 하루 8시간이면 3.3년, 하루 2시간이면 13.1년입니다. 아래 차트는 필자가 Runpod 가격표와 다나와 최저가, 2026년 10월 9일 환율(1달러 1,342원)로 계산한 값입니다. 60GB 컨테이너 디스크 요금(시간당 약 0.008달러)도 넣었습니다.
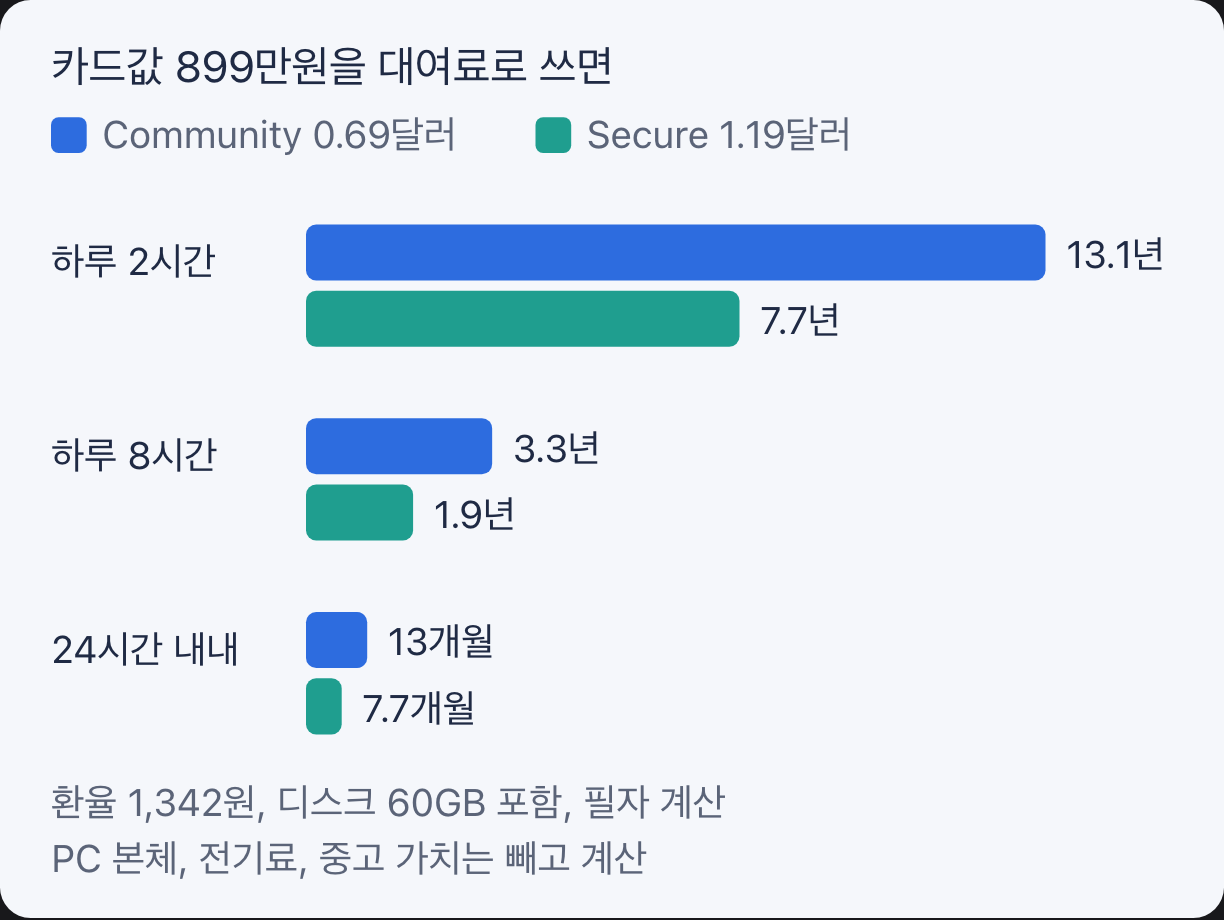
영상도 같은 방식으로 "24시간 돌리면 약 9개월, 하루 2시간이면 약 9년"이라고 계산했는데, 이는 실제로 쓴 Community 요금(0.69달러)이 아니라 녹화 당시 Secure 요금(0.99달러)으로 나눈 값입니다. 지금 Runpod 가격표 화면에는 Secure 요금이 1.19달러로 표시되고, 같은 페이지의 검색 엔진용 구조화 데이터에는 아직 0.99달러가 남아 있습니다(Runpod Pricing, "Updated September 27, 2026"). 어느 쪽이든 Community 요금으로 계산하면 손익분기는 영상보다 늦어집니다.
빠진 비용도 따져 봐야 합니다. 5090 PC를 부하 상태에서 0.75kW로 돌린다고 가정하면, 한전 주택용 누진 요금(한전 사이버지점)에 기후환경요금, 연료비조정단가, 부가세와 기금을 더해 시간당 약 113~272원이 더 듭니다(기타 계절 단가 기준, 7~8월은 누진 구간이 넓어집니다). 기존 사용량이 많아 누진 3단계에 걸리는 집일수록 위쪽 값에 가깝습니다. 이를 넣고 본체까지 1,000만원으로 잡으면 Community 기준 손익분기는 약 1만2천~1만5천 시간으로 늘어납니다(필자 계산). 반대로 구매 쪽에는 다 쓴 카드를 중고로 팔 수 있다는 장점이 남습니다. 다만 지금 같은 급등 시세에 사면 가격이 내려갈 때의 손실도 함께 떠안게 됩니다.
대여 쪽에도 숨은 시간이 있습니다. Pod를 새로 띄울 때마다 모델을 받는 10~15분도 과금되므로, 하루 2시간씩 쓰는 패턴이라면 실제 비용은 10% 안팎(약 8~13%) 늘어납니다.
영상이 소개한 "기존 클라우드 대비 최대 90% 저렴"이라는 말도 확인해 봤습니다. 이 문구는 Runpod 홈페이지에 실린 고객 후기 문장이고, Runpod가 직접 만든 AWS 비교 페이지의 표로 계산하면 H100은 2.79달러 대 12.29달러로 약 77%, A100은 1.19달러 대 7.35달러로 약 84% 저렴합니다(Runpod vs AWS, 2026-10-09 조회). 비싼 데이터센터 GPU에서는 차이가 크지만, 쓰려는 GPU와 시점으로 직접 비교해 보는 것이 맞습니다.
결론은 영상과 같습니다. 매일 장시간 돌릴 확신이 없다면 먼저 빌려 써 보고, 사용 패턴이 굳은 다음에 사는 편이 안전합니다. 일반 클라우드와 비교한 판단은 서버를 이제 AWS에 올리지 않는 이유에서 다른 각도로 다뤘습니다.
Runpod에서 Qwen3.8 27B를 띄우고 Codex에 붙이는 순서
구조는 단순합니다. 모델은 Runpod에서 빌린 5090 위의 vLLM 서버에서 돌고, 내 컴퓨터의 Codex는 그 서버의 OpenAI 호환 API를 두뇌로 씁니다. 아래 순서는 영상 작성자가 공개한 설정 gist(2026-10-02 수정)를 Runpod, vLLM, Codex 공식 문서와 대조해 정리한 것입니다.
- API 키를 만들어 Secret에 넣습니다. 긴 무작위 문자열을 하나 만들어 Runpod 콘솔의 Secrets에 저장합니다. 환경 변수에서는
{{ RUNPOD_SECRET_이름 }}형식으로 불러옵니다(Runpod Docs, Manage secrets). 기본값인 Pod ID 기반 키는 쓰지 않습니다. - Pod를 배포합니다. Pods에서 vLLM 템플릿을 고르고, 이미지 버전을
vllm/vllm-openai:v0.29.0으로 고정합니다. v0.29.0은 2026년 9월 9일에 나온 실제 버전이고 기본 이미지가 CUDA 13.0 기반이라(vLLM v0.29.0 릴리스), 필터에서 CUDA 13 이상 호스트만 고르라는 영상의 안내(영상에서는 13.1 이상을 선택)와 맞습니다. GPU는 RTX 5090 한 장, 컨테이너 디스크 60GB, HTTP 포트 8000, 환경 변수VLLM_API_KEY에 1번의 Secret을 넣습니다. - 시작 명령을 바꿉니다. 명령 전체는 목록 아래에 두었습니다. 준비까지 10~15분 걸리고, gist에 따르면 Logs 탭에
Application startup complete가 나오면 끝입니다. - 웹 터미널에서 확인합니다.
nvidia-smi로 GPU를,/v1/models호출로 모델 이름을 확인합니다. - Codex 전용 설정 폴더를 만들고 실행합니다. 평소 쓰는
~/.codex대신~/.codex-runpod를 따로 두면 기존 AGENTS.md와 MCP 설정이 섞이지 않습니다. Codex는CODEX_HOME환경 변수로 설정 폴더를 바꿀 수 있습니다(Codex Advanced Configuration).
3번의 Pod 시작 명령은 다음과 같습니다(gist 원문 그대로).
nvidia/Qwen3.8-27B-NVFP4 --served-model-name qwen3.8-27b --host 0.0.0.0 --port 8000 \
  --kv-cache-dtype fp8 --max-model-len 131072 --max-num-seqs 16 \
  --gpu-memory-utilization 0.95 --reasoning-parser qwen3 \
  --enable-auto-tool-choice --tool-call-parser qwen3_xml
4번 확인 명령과 5번 Codex 설정 파일(~/.codex-runpod/config.toml)은 다음과 같습니다. POD_ID는 Connect 탭의 HTTP 8000 주소 맨 앞부분입니다.
# Pod 웹 터미널에서
nvidia-smi
curl localhost:8000/v1/models -H "Authorization: Bearer $VLLM_API_KEY"
model_provider = "runpod"
# --served-model-name과 같게
model = "qwen3.8-27b"
# low, medium, xhigh만 가능 (high는 오류)
model_reasoning_effort = "low"
# --max-model-len과 같게
model_context_window = 131072
model_auto_compact_token_limit = 110000

[model_providers.runpod]
name = "Runpod vLLM"
base_url = "https://POD_ID-8000.proxy.runpod.net/v1"
# 키는 파일이 아니라 환경 변수로
env_key = "RUNPOD_VLLM_KEY"
wire_api = "responses"
stream_idle_timeout_ms = 600000
# 내 컴퓨터에서
export RUNPOD_VLLM_KEY="1번에서 만든 키"
cd 작업폴더 && CODEX_HOME=~/.codex-runpod codex
설정에서 두 줄은 이유를 알아 두면 덜 헤맵니다. wire_api = "responses"는 선택이 아닙니다. Codex 설정 문서는 커스텀 프로바이더의 wire_api가 받는 값이 responses 하나뿐이라고 적고 있고(Codex Config Reference), vLLM이 OpenAI Responses API(/v1/responses)를 구현해 두었기 때문에 이 연결이 됩니다. model_reasoning_effort는 Codex 목록에 high가 있어도 Qwen3.8은 xhigh, medium, low 세 단계만 받습니다(Hugging Face 모델 카드). 모델 기본값이 xhigh라서, 영상처럼 low로 시작해 필요할 때만 올리는 편이 빠릅니다. 실행 중에 /model로 모델을 바꾸면 OpenAI 모델이 설정에 저장돼 다음 실행이 꼬인다는 점도 gist에 적혀 있습니다. 국내에서도 Codex에 로컬 모델을 붙였다가 config.toml을 되돌리지 않아 "Reconnecting…"이 반복됐다는 경험담이 있습니다(네이버 블로그 euron, 2026-09-03).
영상이 덜 말한 함정 다섯 가지
영상 본편은 API 키가 새지 않게 관리하면 되고, Stop 해 두면 나중에 같은 설정으로 다시 켤 수 있다고 설명하지만, 공식 문서를 보면 둘 다 그대로 믿기 어렵습니다. 작성자도 gist에서 재시작 실패와 볼륨 요금 문제를 따로 적어 두었습니다.
1. API 키가 모든 경로를 막지는 않습니다. vLLM 보안 문서는 --api-key(또는 VLLM_API_KEY)가 /v1, /v2, /inference 경로만 인증하고, 같은 서버의 다른 경로는 인증 없이 열려 있다며 "가장 눈에 띄는 것이 /v1과 같은 추론 기능을 노출하는 /invocations"라고 경고합니다. 그러면서 "--api-key에만 의존하지 말라"고 적었습니다(vLLM Security, v0.29.0). 그리고 Runpod 문서는 HTTP 프록시로 연 포트가 공개 접근 가능하며 "Pod ID가 어느 정도 숨김 효과를 줄 뿐"이라고 씁니다(Runpod Docs, Expose ports). 두 문서를 합치면 프록시 주소를 아는 사람은 키 없이도 GPU를 쓸 수 있다고 봐야 합니다. 필자가 직접 시험해 보지는 않았지만, 주소를 공유하는 교육이나 팀 실습이라면 더 조심해야 합니다. 오래 띄워 둘 거라면 HTTP 포트를 열지 말고 SSH 접속으로 포트를 포워딩하거나, /v1만 통과시키는 리버스 프록시를 앞에 두세요.
2. Stop 한 Pod는 다시 안 켜질 수 있습니다. Runpod 문서에 따르면 Stop은 GPU를 반납하고 /workspace 볼륨은 남기지만 컨테이너 디스크는 지웁니다. 다시 켤 때 그 서버의 GPU를 다른 사람이 쓰고 있으면 GPU가 0개로 배정될 수 있습니다(Runpod Docs, Manage Pods, Zero GPUs). gist의 권장 설정처럼 볼륨 없이 컨테이너 디스크에 모델을 받으면 다시 켤 때 모델 22GB를 새로 받아야 합니다. 그래서 띄울 때마다 새로 만드는 방식이라면 영상의 권고대로 다 쓴 뒤 Terminate까지 하는 편이 깔끔합니다.
3. 정지 중에도 요금이 나가는 저장소가 있습니다. 컨테이너 디스크는 GB당 월 0.10달러이고 정지하면 과금이 멈춥니다. 볼륨 디스크는 실행 중 0.10달러, 정지 중에는 0.20달러로 두 배입니다. 여러 Pod에서 같이 쓰는 네트워크 볼륨은 1TB 미만이 GB당 월 0.07달러입니다(Runpod Docs, Storage types). 영상도 정지 중 디스크 비용을 언급했지만 두 배라는 점은 말하지 않았습니다. 과금은 gist의 "분 단위"가 아니라 초 단위이고, 배포하려면 최소 1시간 분량의 크레딧이 있어야 하며, 잔액이 0이 되면 네트워크 볼륨이 없는 Pod는 데이터와 함께 종료됩니다(Runpod Docs, Pricing).
4. 프록시는 100초가 지나면 끊깁니다. Runpod HTTP 프록시는 Cloudflare를 거치므로 100초 안에 응답이 시작되지 않으면 524 오류로 끊깁니다(Runpod Docs, Expose ports). Codex처럼 스트리밍으로 받는 클라이언트는 괜찮지만, xhigh 추론으로 긴 답을 한 번에 받는 스크립트라면 stream: true로 바꿔야 합니다.
5. Community와 Secure는 값만 다른 게 아닙니다. Runpod 문서는 Secure Cloud를 T3/T4 데이터센터, Community Cloud를 검증된 개인 공급자를 잇는 P2P 방식으로 설명합니다(Runpod Docs, Pods overview). 회사나 고객 데이터가 들어가는 작업이라면 Secure를 고르라는 것이 gist의 권고이기도 합니다. 국내 사용기에서는 Community와 Spot에서 세팅 도중 SSH가 끊겨 Secure로 옮겼다는 경험과 Japan 리전에는 쓸 수 있는 GPU가 거의 없었다는 경험이 나옵니다(네이버 블로그 mk_sml, 2026-04-21). 한국에서 SSH가 매우 느리고 보안 수준이 마음에 걸려 1주 만에 국내 GPU 클라우드로 옮겼다는 개발자도 있습니다(네이버 블로그 zeongzaehoon, 2026-07-20).
속도는 어느 정도 나오나요?
5090 한 장에서 4비트 27B 모델의 이론상 생성 속도 상한은 영상 설정(NVFP4 21.9GB)에서 초당 약 82토큰, 더 작은 Q4_K_M(17GB)에서 약 105토큰이고, 공개 측정값은 파일 형식과 컨텍스트 길이에 따라 초당 44~94토큰입니다. 토큰 하나를 만들 때마다 가중치 전체를 메모리에서 읽어야 하므로, 5090의 메모리 대역폭 1,792GB/s를 가중치 크기로 나눈 값이 MTP(여러 토큰 미리 예측) 같은 기법 없이 낼 수 있는 대략적인 상한입니다(파일에는 매 토큰 읽지 않는 비전 인코더도 들어 있어 실제 상한은 조금 더 높을 수 있습니다). NVFP4 21.9GB면 약 82토큰(필자 계산, HN 댓글도 같은 계산), 약 17GB인 Q4_K_M이면 약 105토큰입니다.
실측 사례는 이렇습니다. MacStories는 5090 PC의 LM Studio(Q4_K_M)에서 프롬프트가 8천 토큰일 때 초당 59토큰, 6만4천 토큰일 때 51토큰, 12만8천 토큰일 때 44토큰을 쟀습니다. 컨텍스트가 길어질수록 느려지고, 26만 토큰은 KV 캐시를 8비트로 줄여야 끝까지 돌았다고 썼습니다(MacStories, 2026-09-21). 5090과 같은 칩을 쓰는 RTX PRO 6000에서 vLLM으로 같은 NVFP4 모델을 돌린 한 사용자는 기본 생성 속도 초당 72토큰, 프롬프트 처리 초당 약 1만3천 토큰을 보고했습니다(HN 댓글, 2026-09-21). 양자화 업체 ByteShape는 llama.cpp로 5090에서 자사 IQ4_XS 파일이 초당 93.66토큰, Unsloth의 UD-Q4_K_M이 81.63토큰을 냈다고 공개했는데, 자사 제품을 알리는 글이라는 점은 감안해야 합니다(ByteShape, 2026-09-14).
체감 속도를 가장 크게 바꾸는 것은 하드웨어보다 추론 강도입니다. xhigh에서는 답을 내기 전에 생각하는 토큰이 수만 개까지 늘어납니다(앞의 Simon Willison 사례는 22,276개). 생각할 여유(출력 상한)를 늘리면 성공률과 시간이 함께 늘어난다는 실험도 있습니다. 3090 한 장과 OpenCode로 실험한 한 개발자는 출력 상한을 8천에서 3만2천 토큰으로 늘리자 24번 시도 중 성공이 5번에서 20번으로 늘었지만, 시도당 중앙값 시간도 약 245초에서 776초로 늘었다고 기록했습니다(저자 스스로 일반화할 수 없다고 밝혔습니다, dev.to, 2026-10-05). 영상이 "생각보다 빠르다"고 느낀 것도 low 설정으로 짧은 파이썬 파일을 만든 장면이었습니다.
이 방법이 안 맞는 경우
매일 장시간 돌리거나, 데이터가 밖으로 나가면 안 되거나, 최상위 모델 품질이 필요한 일이라면 이 방법이 답이 아닙니다.
- 매일 장시간 몇 년씩 쓸 계획이라면 구매가 유리해집니다. 하루 8시간 기준으로 Community 요금이면 3.3년(전기료와 본체를 넣으면 4~5년), Secure 요금이면 약 2년이 지나야 카드값을 넘습니다. 다만 구매 시점의 시세가 급등 구간이라는 점은 따로 따져야 합니다.
- 하루 한두 번 가볍게 써 볼 거라면 GPU를 빌리는 것보다 같은 모델을 토큰 단가로 파는 API가 쌀 수 있습니다. Artificial Analysis가 집계한 API 가격은 입력 100만 토큰당 0.50달러, 출력 3.00달러입니다(Artificial Analysis, 2026-10-09 조회). Pod를 띄우는 10~15분도 기다릴 필요가 없습니다. 다만 데이터가 제3자 API로 나가므로 직접 서버를 띄우는 장점은 사라집니다.
- 회사 코드나 고객 데이터를 다룬다면 Community는 피하고, Secure를 쓰더라도 사내 보안 규정이 해외 GPU 클라우드를 허용하는지 먼저 확인해야 합니다. 국내 데이터센터와 공공 인증이 필요한 조직이라면 국내 GPU 클라우드가 맞습니다.
- 요청이 가끔 몰리는 서비스라면 서버를 켜 두는 Pods보다 요청이 올 때만 켜지는 Serverless가 맞습니다. 영상도 이 점을 짚었습니다.
- 어려운 설계나 큰 리팩터링이라면 27B 모델로는 부족할 수 있습니다. 앞의 국내 사용자처럼 계획은 프론티어 모델에, 반복 구현은 오픈 모델에 맡기는 식으로 나누는 편이 현실적입니다. 코딩 에이전트를 다루는 일반 요령은 Claude Code 팁 11가지에 정리했습니다.
이 글의 자료를 고른 방법
영상 자막 전문을 읽고 주장을 가격, 모델 성능, 설정, 보안으로 나눈 뒤 각 주장을 원자료로 확인했습니다. 모델 사양은 Hugging Face 모델 카드와 config.json, 지능 지수는 Artificial Analysis 모델 페이지, 요금과 동작은 Runpod 가격표와 문서, 설정은 vLLM과 Codex 공식 문서, 국내 가격은 다나와 검색 결과와 지디넷코리아 기사로 확인했습니다. 영상 작성자가 공개한 gist는 GitHub API로 원문을 받아 실제로 띄운 모델과 명령을 확인했습니다. 국내 블로그는 경험담으로만 인용했고, 숫자는 공식 자료나 매체로 다시 확인한 것만 썼습니다. 최근 30일 커뮤니티 반응은 Hacker News, dev.to, YouTube에서 모았고, Reddit은 접속이 막혀 넣지 못했습니다.
필자의 한계. 필자는 이 글을 쓰면서 Runpod Pod를 직접 띄워 측정하지 않았습니다. 손익분기, KV 캐시, 생성 속도 상한은 공개된 가격과 설정값으로 계산한 값이고, 속도 사례는 다른 사람들의 측정입니다. Runpod Community 요금은 수요와 공급에 따라 바뀌고, 5090 시세도 몇 주 사이에 크게 움직였으므로 결정하기 전에 가격표를 다시 확인하길 권합니다. 본문의 이미지는 직접 만든 차트 3개와 섬네일을 빼면 NVIDIA, Artificial Analysis, vLLM, Runpod 공식 페이지의 대표 이미지이고, 해당 자료를 소개하려고 인용하면서 캡션에 출처를 달았습니다.
자주 묻는 질문
Runpod는 어떻게 결제하나요?
달러로 크레딧을 먼저 충전하는 방식입니다. Runpod 결제 문서에 따르면 Stripe가 지원하는 Visa, Mastercard, American Express 카드와 암호화폐를 받고, 선불카드는 한 번에 100달러 이상 충전해야 합니다. 처음 써 보는 사람은 10달러부터 시작할 수 있지만, 충전한 크레딧은 환불되거나 인출되지 않습니다(Runpod Docs, Billing). Pod를 배포하려면 고른 구성의 1시간 분량 크레딧이 있어야 하므로, 처음에는 작은 금액으로 시작하세요.
컨테이너 디스크는 얼마로 잡아야 하나요?
NVFP4 모델 파일이 약 22GB라서 영상처럼 60GB면 넉넉합니다. 국내 사용기에는 기본값 20GB로 두었다가 No space left on device 오류를 만났다는 사례가 있습니다(네이버 블로그 from0altitude, 2026-05-26). 자주 켰다 끈다면 네트워크 볼륨을 만들어 HF_HOME을 /workspace 아래로 지정하면 모델을 다시 받지 않아도 됩니다.
내 5090이나 4090에서 그대로 돌릴 수 있나요?
5090이라면 같은 NVFP4 모델과 vLLM 명령을 쓸 수 있습니다. 24GB인 4090이나 3090이라면 vLLM 대신 llama.cpp나 LM Studio로 17GB 안팎의 4비트 GGUF를 쓰는 편이 현실적이고, 컨텍스트는 줄여야 합니다. 5090에서도 개인용으로는 llama.cpp가 편했다는 국내 사용기가 있습니다(네이버 블로그 pochita_0, 2026-08-18).
한국어 품질은 어떤가요?
공식 벤치마크로 한국어 품질을 따로 확인하지는 못했습니다. 영상에서는 "안녕 너는 누구야"에 한국어로 제대로 답했고, 16GB 카드로 한국어 PM 문서를 변환해 본 국내 사용기는 문서 품질은 좋다고 평가했습니다(네이버 블로그 bangdo4). 한국어 품질이 중요한 업무라면 실제 문서 몇 건으로 직접 비교해 보고 정하세요.
Codex 대신 다른 코딩 에이전트에 붙일 수 있나요?
붙일 수 있습니다. vLLM은 OpenAI 호환 Chat Completions와 Responses API를 모두 제공하므로, OpenCode처럼 OpenAI 호환 엔드포인트를 받는 도구라면 base_url과 키만 바꾸면 됩니다. 국내에서도 5090에 띄운 Qwen3.8 27B를 OpenCode에 붙여 쓴 사용기가 있습니다(네이버 블로그 pochita_0).
마치며
오픈 모델에 1000만원이 드는지에 대한 답을 한 줄로 줄이면 지금 5090을 사면 그렇지만, 빌리면 시간당 약 937원이고 하루 8시간씩 써도 카드값을 넘기는 데 3년이 넘게 걸린다는 것입니다.
- 5090 최저가 약 899만원은 출시가의 2.4배인 급등 시세입니다. 사기 전에 빌려서 사용 패턴부터 확인하세요.
- Qwen3.8 27B의 34점은 xhigh 최대 추론 기준의 종합 지수입니다. 1년 전 최상위 모델을 지수로 넘었다는 뜻이지, 같은 체감을 보장한다는 뜻은 아닙니다.
- 5090 한 장에는 4비트 NVFP4 버전이 들어가고, 이 모델은 KV 캐시가 작아 13만 토큰 컨텍스트를 잡을 수 있습니다.
--api-key는/invocations를 막지 않습니다. 다 쓰면 Terminate까지 하세요.
지금 바로 할 일은 Runpod 가격표에서 RTX 5090의 Community와 Secure 요금을 확인하고, 하루 몇 시간 쓸지 정해 위 차트에 대 보는 것입니다. Runpod 요금이나 5090 시세, Artificial Analysis 지수가 크게 바뀌면 이 글을 갱신하겠습니다.
sources:auto출처
- 오픈 모델 돌리려면 1000만원... 그냥 Runpod에서 빌려 씁니다 | RTX 5090 + Qwen 3.8: youtube.com/watch?v=D_eJVFr3vLc
- 다나와 RTX5090 검색, 2026-10-09: search.danawa.com/dsearch.php?query=RTX5090
- NVIDIA GeForce RTX 5090: nvidia.com/en-us/geforce/graphics-cards/50-series/rtx-5090
- 지디넷코리아, 2026-09-14: zdnet.co.kr/view/?no=20260914161324
- Tom's Hardware, 2026-09-01: tomshardware.com/pc-components/gpus/nvidias-top-end-rtx-5090-gaming-gpu…
- 아시아타임즈, 2026-10-06: asiatime.co.kr/article/20261006500316
- NVIDIA Developer Forums, 2026-02-25: forums.developer.nvidia.com/t/2-23-2026-price-change-announcement/361713
- 다나와 DGX Spark 검색, 2026-10-09: search.danawa.com/dsearch.php?query=DGX Spark
- NVIDIA DGX Spark: nvidia.com/en-us/products/workstations/dgx-spark
- Simon Willison, 2026-08-16: simonwillison.net/2026/Aug/16/qwen-38-27b
- Artificial Analysis, 2026-10-09: artificialanalysis.ai/models/qwen3-8-27b
- Claude Opus 4.5: artificialanalysis.ai/models/claude-opus-4-5-thinking
- GPT-5: artificialanalysis.ai/models/gpt-5
- Hugging Face, Qwen/Qwen3.8-27B: huggingface.co/Qwen/Qwen3.8-27B
- Artificial Analysis Leaderboard: artificialanalysis.ai/leaderboards/models
- Gemini 3 Pro: artificialanalysis.ai/models/gemini-3-pro
- GPT-5.1: artificialanalysis.ai/models/gpt-5-1
- 설정 gist: gist.github.com/devbrother2024/018e89502e77259318f85c89eed38524
- Hugging Face, nvidia/Qwen3.8-27B-NVFP4: huggingface.co/nvidia/Qwen3.8-27B-NVFP4
- 긱뉴스, 2026-08-18: news.hada.io/topic?id=32599
- AA Methodology: artificialanalysis.ai/methodology/intelligence-benchmarking
- HN 댓글, 2026-09-23: news.ycombinator.com/item?id=49821855
- 네이버 블로그 bangdo4, 2026-09-24: blog.naver.com/bangdo4/224421940766
- 네이버 블로그 pediatrics_lsj, 2026-09-14: blog.naver.com/pediatrics_lsj/224411065319
- vLLM Recipes, Qwen3.8-27B, 2026-10-08: recipes.vllm.ai/Qwen/Qwen3.8-27B
- Hugging Face: huggingface.co/Qwen/Qwen3.8-27B-FP8
- config.json: huggingface.co/Qwen/Qwen3.8-27B/raw/main/config.json
- Runpod Pricing: runpod.io/pricing
- 한전 사이버지점: cyber.kepco.co.kr/ckepco/front/jsp/CY/E/E/CYEEHP00101.jsp
- Runpod 홈페이지: runpod.io
- Runpod vs AWS, 2026-10-09: runpod.io/compare/aws
- Runpod Docs, Manage secrets: docs.runpod.io/pods/templates/secrets
- vLLM v0.29.0 릴리스: github.com/vllm-project/vllm/releases/tag/v0.29.0
- Codex Advanced Configuration: developers.openai.com/codex/config-advanced
- Codex Config Reference: developers.openai.com/codex/config-reference
- 네이버 블로그 euron, 2026-09-03: blog.naver.com/euron/224399624676
- vLLM Security: github.com/vllm-project/vllm/blob/v0.29.0/docs/usage/security.md
- Runpod Docs, Expose ports: docs.runpod.io/pods/configuration/expose-ports
- SSH 접속: docs.runpod.io/pods/configuration/use-ssh
- Runpod Docs, Manage Pods: docs.runpod.io/pods/manage-pods
- Zero GPUs: docs.runpod.io/pods/troubleshooting/zero-gpus
- Runpod Docs, Storage types: docs.runpod.io/pods/storage/types
- Runpod Docs, Pricing: docs.runpod.io/pods/pricing
- Runpod Docs, Pods overview: docs.runpod.io/pods/overview
- 네이버 블로그 mk_sml, 2026-04-21: blog.naver.com/mk_sml/224259393424
- 네이버 블로그 zeongzaehoon, 2026-07-20: blog.naver.com/zeongzaehoon/224350419268
- HN 댓글: news.ycombinator.com/item?id=49789646
- MacStories, 2026-09-21: macstories.net/stories/m5-ultra-mac-studio-review-the-dream-mac-for-loc…
- HN 댓글, 2026-09-21: news.ycombinator.com/item?id=49793700
- ByteShape, 2026-09-14: byteshape.com/blogs/Qwen3.8-27B
- dev.to, 2026-10-05: dev.to/zjshen14/tuning-a-local-qwen-coding-agent-what-changed-what-stil…
- Runpod Docs, Billing: docs.runpod.io/accounts-billing/billing
- 네이버 블로그 from0altitude, 2026-05-26: blog.naver.com/from0altitude/224297322010
- 네이버 블로그 pochita_0, 2026-08-18: blog.naver.com/pochita_0/224382589426
글쓴이
주홍철은 네이버 출신 개발자이자 AI 핀테크 스타트업 어비스(AVISS)의 대표입니다. 경제·증시 분석 AI, AI 에이전트, 데이터 파이프라인을 직접 설계하고 개발하며, 『면접을 위한 CS 전공지식 노트』와 『클로드 코드 제대로 시작하기』(길벗)를 썼습니다. 회사 소개는 어비스 홈페이지에, 다른 글은 어비스 블로그에 있으며, 글에 대한 정정 요청이나 문의는 [email protected]으로 보내 주세요.