핵심 요약
- AI 네이티브 역량은 AI를 많이 쓰는 능력이 아니라, 일을 정의하고 맡길 일을 나누고 결과를 검증해 책임지는 능력입니다. Anthropic의 AI 유창성 프레임워크(4D), GitHub 전 CEO Thomas Dohmke가 정리한 "위임과 검증", 국내 기업의 채용 평가 축이 모두 같은 곳을 가리킵니다.
- 해외 기업은 2025년 봄부터 "AI 사용은 기본"이라고 선언했고, 2025년 말에는 Meta처럼 사용량보다 임팩트를 보겠다는 회사도 나왔습니다. Shopify, Duolingo, Microsoft 개발자 부문, Coinbase가 사용을 요구했고, Meta는 2026년부터 "AI-driven impact"를 핵심 기대치로 삼았습니다. 2026년 10월에는 Meta와 Microsoft가 비용 관리와 자체 도구 전환을 이유로 사내 Claude 사용을 줄였다는 보도까지 나왔습니다.
- 국내에서는 이데일리 조사 기준 대기업 25곳 중 8곳(32%)이 AI 역량을 채용 평가에 반영했습니다. CJ올리브영과 SK하이닉스는 결과물과 함께 문제 정의, AI 활용, 결과 검증의 과정을 보고, CJ올리브영은 반복 개선 과정까지 봅니다. 다만 기업 153곳 설문에서 인재상 1위는 여전히 직무 전문 역량(64.7%)이었습니다.
- 많이 쓴다고 역량이 저절로 생기지는 않습니다. Anthropic 실험에서 AI 도움을 받아 낯선 라이브러리를 익힌 그룹의 퀴즈 점수는 50%로, 직접 코딩한 그룹(67%)보다 17%p 낮았습니다. METR 실험에서는 숙련 개발자들이 19% 느려졌는데도 20% 빨라졌다고 믿었습니다. 2025년 초 도구 기준이고, METR은 2026년 후속 측정을 "unreliable signal"이라고 밝혔습니다.
- 필자가 권하는 기르는 법은 맡기기 전에 의도를 글로 쓰고, 일부 일은 일부러 AI 없이 하고, AI가 만든 결과물일수록 따져 묻는 것입니다. 증명은 이력서와 저장소에 문제 정의, AI 접근, 검증 과정을 남기고, AI 없이도 내 코드를 설명할 수 있게 만드는 데서 시작합니다.
목차
- AI 네이티브 역량이란 무엇인가요?
- 해외 기업은 어떻게 요구해 왔나요?
- 국내 기업은 무엇을 평가하나요?
- AI 네이티브 역량을 다섯 가지로 나누면
- 많이 쓰면 저절로 생기나요?
- 신입·주니어에게는 무엇이 달라졌나요?
- 어떻게 기르고 증명하나요?
- 출처
AI 네이티브 역량이란 무엇인가요?
AI 네이티브 역량은 일의 흐름을 처음부터 AI와 함께 짜고, 그 결과에 끝까지 책임지는 능력입니다. 어떤 도구를 몇 개 쓰는지와는 다른 이야기입니다. 국내 개발자 블로그 schw240은 기존 흐름에 AI를 덧붙여 막힐 때 묻는 방식을 AI-enabled, 문제 정의부터 검토와 경험 재사용까지 처음부터 AI와 함께 일하도록 흐름을 짜는 방식을 AI Native로 나눴습니다. 같은 글은 "AI Native는 '코드는 AI가 알아서 해주니까 나는 개발 공부를 안 해도 된다'는 의미가 아닙니다"라고 못 박았습니다(schw240 블로그).
영어권의 대표적인 글로는 Addy Osmani의 "The AI-Native Software Engineer"(2025년 7월)가 있습니다. 그는 AI 네이티브 엔지니어를 "deeply integrates AI into their daily workflow"(AI를 일상 업무 흐름에 깊이 녹인) 사람으로 정의하면서, 엔지니어는 도구의 사용자에 그치지 않고 "the ultimate guarantor"(최종 보증인)라고 덧붙였습니다(Addy Osmani).
Anthropic이 Rick Dakan, Joseph Feller와 함께 만든 AI 유창성 프레임워크(4D)는 이 능력을 네 갈래로 나눕니다(Anthropic 4D 원페이저).
- Delegation(위임): "Setting goals and deciding whether, when and how to engage with AI." 목표를 정하고, AI를 쓸지, 언제 어떻게 쓸지 정하는 일
- Description(기술): "Effectively describing goals to prompt useful AI behaviors and outputs." 원하는 결과가 나오도록 목표를 설명하는 일
- Discernment(분별): "Accurately assessing the usefulness of AI outputs and behaviors." AI의 결과와 행동이 쓸모 있는지 정확히 가리는 일
- Diligence(성실): "Taking responsibility for what we do with AI and how we do it." AI로 한 일과 그 방식에 책임지는 일
흔히 말하는 프롬프트 실력은 이 가운데 Description 하나에 해당합니다. 나머지 셋은 맡길지 정하고, 결과를 가려내고, 책임지는 일입니다. GitHub CEO였던 Thomas Dohmke가 AI를 깊이 쓰는 개발자 22명을 인터뷰한 글도 같은 결론입니다. 그는 가장 앞선 단계의 개발자들을 두고 "They now focus on the delegation and the verification of a task."(이제 작업의 위임과 검증에 집중한다)라고 정리했습니다(Thomas Dohmke).
Microsoft Work Trend Index 2026은 이런 사람을 숫자로 셌습니다. 10개국에서 AI를 쓰는 지식노동자 20,000명을 조사해, 에이전트에게 여러 단계의 일을 맡기고, 워크플로를 다시 설계하고, 팀 단위로 반복하는 AI 관행에 참여하는 세 가지를 모두 하는 사람을 "Frontier Professional"이라 불렀습니다. AI 사용자의 16%가 여기에 들었습니다(Microsoft WTI 2026).
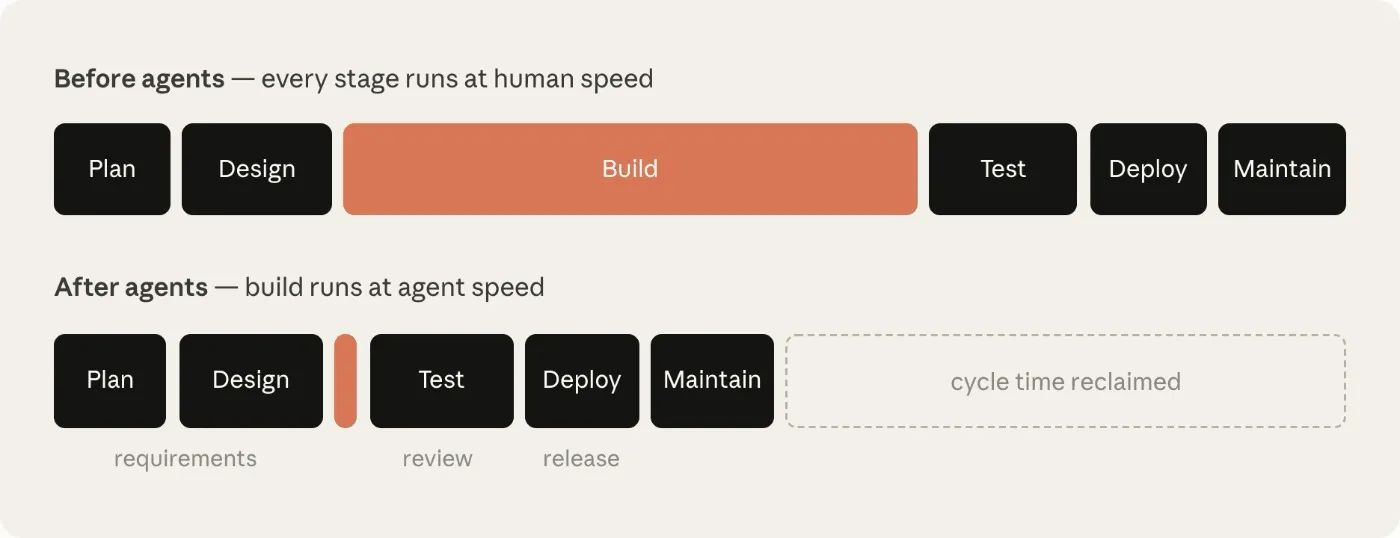
위 그림이 실린 Anthropic의 AI-native SDLC 플레이북(2026년 8월)은 그래서 "Nothing is implemented without an accepted plan."(승인된 계획 없이는 아무것도 구현하지 않는다)과 "Humans remain accountable for every decision that requires judgment."(판단이 필요한 모든 결정의 책임은 사람에게 남는다)를 원칙으로 둡니다(Anthropic).
해외 기업은 어떻게 요구해 왔나요?
2025년 봄부터 해외 기업들은 AI 사용을 "기본 기대치"로 선언했고, 2025년 말에는 얼마나 쓰는지보다 무엇을 바꿨는지를 보겠다는 회사도 나왔습니다. 주요 발표를 날짜순으로 놓으면 이렇습니다.
| 날짜 | 회사와 발신자 | 요구한 것 |
|---|---|---|
| 2025-04-07 | Shopify, CEO Tobi Lütke 메모 | "Reflexive AI usage is now a baseline expectation", 성과·동료 평가 설문에 AI 사용 문항 추가, 인력 요청 전에 AI로 안 되는 이유 증명(X) |
| 2025-04-08 | Fiverr, CEO Micha Kaufman 메일 공개 | 분야별 AI 도구 숙달 요구, "if you're working like it's 2024, you're doing it wrong!"(X) |
| 2025-04-28 | Duolingo, 전사 메일 | AI-first 선언, "headcount will only be given if a team cannot automate more of their work"(The Verge) |
| 2025-06-17 | Amazon, CEO Andy Jassy 메모 | "be curious about AI, educate yourself", 몇 년 안에 사무직 인력이 줄 것이라는 전망(Amazon) |
| 2025-06-27 (보도) | Microsoft 개발자 부문, 부문장 Julia Liuson 메일 | AI 사용을 성과 평가에 반영하라, "using AI is no longer optional"(Business Insider) |
| 2025-08-22 (보도) | Coinbase, CEO Brian Armstrong | 주말까지 AI 코딩 도구 온보딩 지시, 이유 없이 하지 않은 일부 엔지니어 해고(TechCrunch) |
| 2025-11-14 (보도) | Meta, 인사 책임자 메모 | 2026년부터 "AI-driven impact"를 핵심 기대치로, 2025년 평가에는 개인 AI 사용량 지표 미포함(Business Insider) |
2025년의 요구는 대부분 "써라"였습니다. 다만 Microsoft 메일은 회사 전체의 공식 발표가 아니라 GitHub Copilot 등을 맡은 개발자 부문장이 관리자들에게 보낸 것이어서, "Microsoft 전사가 AI 사용을 평가한다"로 넓혀 읽으면 과장입니다.
Zapier는 기준을 더 구체적으로 만들었습니다. 2025년 5월부터 모든 신규 입사자에게 AI 유창성을 요구했고, 전사 해커톤 한 주 만에 주간 AI 사용자가 10% 미만에서 50% 이상으로 늘었다고 밝혔습니다(Zapier). 따로 공개한 4단계 루브릭은 Unacceptable, Capable, Adoptive, Transformative입니다. Capable은 "you're using AI on purpose"(목적을 갖고 쓴다), Transformative는 "impact at scale"(규모 있는 임팩트)이고, 루브릭 자체는 "not a scorecard or a pass/fail test"(점수표나 합격·불합격 시험이 아니다)라고 적었습니다(Zapier 루브릭).
흐름이 바뀐 지점은 Meta입니다. 2025년 평가에 개인 사용량 지표를 넣지 않고 "AI-driven impact"를 보겠다고 한 것은, 사용량이 아니라 결과를 평가하겠다는 뜻으로 읽힙니다.
2026년 10월에는 반대 방향의 소식도 나왔습니다. The Information의 10월 5일 보도에 따르면 Meta와 Microsoft가 비용 관리와 자체 AI 도구 전환을 이유로 사내 Claude 사용을 줄였습니다. 원 보도는 유료 기사라 2차 요약으로만 확인되고, 두 회사는 이를 확인하지 않았습니다. 이 소식을 다룬 Hacker News 스레드(378점)의 상위 댓글 가운데 하나는 "The accountants are finally realising the cost of token maxing."(회계 담당자들이 마침내 토큰을 최대로 쓰는 비용을 깨닫고 있다)였습니다(HN). 같은 시기 업계 행사에서는 "Tokenmaxxing is dead"라는 말이 나왔고(EM360Tech), AI 토큰 순위표와 사용 의무가 있던 조직에서 Jira 내용을 프롬프트에 그대로 붙여 넣다 심각한 버그가 났다는 증언도 올라왔습니다(HN). 필자는 이 흐름을 많이 쓰는 것 자체는 역량이 아니라는 이야기가 업계에서도 나오기 시작한 신호로 봅니다.
국내 기업은 무엇을 평가하나요?
국내 기업은 AI를 쓰는지보다 AI와 함께 문제를 푸는 과정을 평가하기 시작했습니다. 평가표에 반복해 나오는 축은 "문제 정의, AI 활용, 결과 검증"이고, CJ올리브영은 반복 개선 과정까지 봅니다. 이데일리가 국내 대기업 25곳을 조사했더니 8곳(32%)이 AI 활용 경험과 역량을 이미 채용 평가에 반영하고 있었고, 도입을 검토하는 곳까지 합치면 44%였습니다(이데일리). 원티드가 2025년 1월부터 2026년 4월까지의 채용 공고 72,793건을 분석했더니 AI 도구·기법 키워드 가운데 가장 빠르게 늘어난 것은 "AI Native"(8배)였고, 2026년 7월 말 기준으로는 채용 공고 3건 중 2건에 AI 관련 키워드가 한 번 이상 나왔습니다(원티드).
| 회사 | 시점 | 바뀐 전형 | 무엇을 보나 |
|---|---|---|---|
| CJ올리브영 | 2026년 7월 | 개발자 경력 채용에서 라이브 코딩 대신 AI 과제, 크래프톤의 '코파 프로브' 활용 | "문제 정의 방식, AI 활용 및 프롬프트 작성 과정, 반복 개선 과정, 결과 검증 방식"(아시아경제) |
| SK하이닉스 | 2026년 7~9월 | 학력 제한과 자기소개서 폐지, AI 활용 역량을 직접 쓰는 서식, 반나절 심층면접(한국경제), 학력 정보를 받지 않는 AI 해커톤 | "문제 정의, AI 활용, 결과 검증 과정 등을 종합적으로"(SK하이닉스 뉴스룸) |
| LG CNS | 2026년 9월 | 신입 필기에 생성형 AI 활용 역량 검사 신설 | 직무에 따라 코딩형과 기획형으로 나눠 평가(바이라인네트워크) |
| 무신사 | 2026년 3월 공채 | 'AI 네이티브' 신입 개발자 공채, 약 2,000명 중 66명 선발 | AI 도구로 실무 문제를 해결하는 능력(뉴데일리) |
| 크래프톤 | 2026년 10월 | AI 네이티브 신입 100명 이상, 자체 AI 역량평가 '코파 프로브' 전형 | AI 활용 역량, 범용 사고력, 글로벌 역량(MTN) |
이런 시도는 2025년에 이미 나왔습니다. 컬리는 2025년 5월 시작한 개발자 공채의 코딩테스트에서 창사 이래 처음으로 AI 챗봇 사용을 허용하기로 했고, 회사 관계자는 "AI 활용 의지도 개발자가 갖춰야 할 역량"이라고 설명했습니다(중앙일보).
재직자에게도 같은 기대가 붙습니다. SK텔레콤은 2026년 3월 모든 임직원이 AI 에이전트를 하나 이상 쓰는 '1인 1AI' 제도를 도입하겠다고 밝혔습니다(파이낸셜뉴스). 카카오 정신아 대표는 2026년 신입 크루에게 "핵심은 도구 자체가 아니라 어떤 질문을 던질지, 주어진 정보와 맥락을 바탕으로 어떤 판단을 내리는 지에 달려 있다"고 말했습니다(카카오). 그보다 앞선 2025년 9월에는 카카오 정규돈 CTO가 "코딩 테스트 문제 풀이 능력 만으로 인재를 판단하는 관행에서 벗어나"야 한다고 썼습니다(아이뉴스24).
정부의 정의도 같은 구조입니다. 고용노동부는 2026년 4월 'AI 워커' 훈련 시범사업을 발표하며 AI 워커를 "자신의 전문 분야에서 AI 도구를 능숙하게 활용하여 업무 생산성을 높이는 노동자"로 정의했고, 길러야 할 능력을 '문제정의→데이터 활용→모델적용→검증'으로 이어지는 프로세스 수행능력이라고 적었습니다(고용노동부).
다만 AI 역량이 전부는 아닙니다. 원티드랩이 기업 153곳에 2026년 인재상을 물었더니(복수 응답) 1위는 직무 전문 역량(64.7%)이었고, AI·데이터 활용 역량은 24.2%로 4위였습니다(지디넷코리아). SK하이닉스도 새 서식에 AI 활용 역량과 함께 반도체 직무 전문성을 쓰게 했습니다. 이 회사 인사팀이 이데일리에 한 말이 요점을 짚습니다. "AI를 얼마나 잘 다루는지 보려는 게 아니다", "AI를 활용한 문제 해결 능력을 확인하는 게 핵심"이라는 것입니다(이데일리).
AI 네이티브 역량을 다섯 가지로 나누면
국내외 기업의 평가 축, Anthropic 4D, Dohmke의 "위임과 검증", Anthropic SDLC 플레이북을 겹쳐 놓으면 다섯 가지 역량이 나옵니다. 아래 분류는 필자가 이 자료들을 바탕으로 정리한 것이고, 공인된 표준은 아닙니다.
1. 문제 정의와 의도 기술
무엇을 왜 만드는지 AI가 오해하지 않게 글로 쓰는 능력입니다. CJ올리브영 평가 항목의 첫머리가 "문제 정의 방식"이었습니다. 예선 지원자 5천여 명 가운데 60여 명이 본선에 오른 채용 해커톤 'AX 인재전쟁'에서도 출제사 임원은 "AI 시대에는 솔루션을 구현하는 능력보다 문제를 정확히 정의하는 역량이 중요하다"고 말했습니다(벤처스퀘어).
현업 장면으로는 프론트엔드 개발자 teo가 150일에 걸쳐 AI로만 개발하는 방식으로 옮겨 간 경험을 정리한 글이 생생합니다. 그는 "내가 기대하는 게 없으면 AI가 엄청 잘하는 것처럼 보여. 근데 내가 원하는 게 명확해지는 순간부터 어려워지는 거지"라고 썼고, "AI가 답을 잘 찾아준다는 것과 내가 뭘 물어봐야 하는지 안다는 건 전혀 다른 문제야"라고 덧붙였습니다(velog teo). Anthropic AI Fluency Index에서도 사용자가 Claude에게 어떻게 함께 일할지 정해 준 대화는 30%뿐이었습니다(Anthropic).
2. 위임 판단과 작업 분해
무엇을 AI에 맡기고 무엇을 직접 할지 나누고, 맡길 일을 검증할 수 있는 크기로 쪼개는 능력입니다. Dohmke는 위임에 필요한 것으로 "problem framing, breaking down tasks optimally, parallelizing work, and articulating success criteria and constraints"(문제 설정, 작업의 적절한 분해, 병렬화, 성공 기준과 제약의 명시)를 꼽았습니다. Anthropic 사내 조사(2025년 8월 설문, 엔지니어·연구자 132명)에서 응답자들은 업무의 약 60%에 Claude를 쓴다고 답했지만, 절반 넘는 응답자는 "완전히 맡길 수 있는" 일이 0~20%뿐이라고 했습니다(Anthropic). 자주 쓰는 것과 통째로 맡기는 것은 다른 일입니다.
teo는 이를 "AI 저글링"이라 불렀습니다. 여러 작업을 워크트리로 나눠 동시에 돌리는 능력인데, 그는 "동시에 한다고 그냥 여러 개 켜놓으면 되는 건 아니야"라며 코드의 책임과 경계부터 나눌 수 있어야 한다고 했습니다. 2026년 10월 Hacker News에서 618점을 받은 질문 "How to deal with shipping AI-written code you don't understand?"의 최상위 답도 같습니다. "I don't let the LLM design the code at all, I let it implement a design I have created"(설계는 LLM에 맡기지 않고, 내가 만든 설계를 구현하게 한다)(HN). 경계를 사람이 먼저 긋는 방법은 AI 코딩에 DDD가 중요한 이유에서 다뤘습니다.
3. 검증과 디버깅
AI가 낸 결과가 맞는지, 쓸 만한지 가려내고, 틀렸을 때 원인을 찾는 능력입니다. Microsoft WTI 2026에서 AI 사용자들은 앞으로 중요해질 사람의 역량 1, 2위로 AI 출력의 품질 관리(50%)와 비판적 사고(46%)를 꼽았고, 86%는 AI 출력을 최종 답이 아니라 출발점으로 다룬다고 답했습니다(Microsoft WTI 2026). Stack Overflow 2026 설문에서도 AI 신뢰에 관한 응답 1위는 "결과를 쉽게 검증할 수 있을 때 신뢰한다"(48.0%)였고, 중요한 업무 결정까지 믿고 맡긴다는 응답은 6.6%였습니다(Stack Overflow).
검증에는 무엇을 의심할지 아는 눈이 필요합니다. Kent Beck은 AI가 엇나가는 신호로 같은 시도를 되풀이하는 루프, 요청하지 않은 기능, 테스트를 끄거나 지우는 행동을 들었습니다(Kent Beck). 뒤에서 볼 Anthropic 실험에서 AI로 배운 그룹과 직접 코딩한 그룹의 격차가 가장 컸던 문항도 디버깅이었습니다.
4. 맥락과 작업 환경 설계
AI가 매번 처음부터 묻지 않도록 맥락을 남기고, AI가 스스로 확인할 수 있는 환경을 만드는 능력입니다. Anthropic SDLC 플레이북의 원칙은 "Every stage commits an artifact the next stage can read."(모든 단계는 다음 단계가 읽을 수 있는 산출물을 커밋한다)입니다. 기획 단계의 intent.md, 설계 단계의 spec.md, 구현 전의 plan.md가 그 산출물입니다.
teo는 이 역량을 시행착오로 익혔습니다. CLAUDE.md 지침, 린트, 훅을 빡빡하게 쌓았다가 새 기능 개발이 막히자 하네스를 걷어냈고, 대신 마음에 들게 고친 방식을 스킬로 남겼습니다(그의 표현으로 "암묵지의 명세화"). 작업의 배경과 목적, 결과는 이슈와 PR에 남겨 대화를 모르는 다른 에이전트도 같은 뜻으로 읽게 했습니다. 필자가 이 블로그 글을 만드는 Claude Code 파이프라인도 리서치, 원고, 검토 단계가 각각 파일을 남기고 다음 단계가 그 파일을 읽는 구조입니다. CLAUDE.md, 스킬, 훅을 다루는 요령은 Claude Code 팁 11가지에 모아 두었습니다.
5. 책임과 기초
AI가 만든 결과를 내 이름으로 내보낼 수 있을 만큼 이해하고, 문제가 생기면 책임지는 능력입니다. 4D의 Diligence가 여기에 해당합니다. 개발 교육 유튜버 코딩알려주는누나는 요즘 채용 평가 기준을 설명하며 "AI는 책임을 져 주지가 않아요"라고 말했고, AI 결과물을 검증하고 통제하려면 기술 이해가 깊어야 한다고 했습니다(코딩알려주는누나). 국내 기업 인재상 1위가 직무 전문 역량이었던 것도 같은 맥락입니다. 기초가 없으면 검증도 책임도 할 수 없습니다.
다섯 역량을 한 표로 모으면 이렇습니다.
| 역량 | 4D 대응 | 기업이 보는 장면 | 연습법 |
|---|---|---|---|
| 문제 정의와 의도 기술 | Description | CJ올리브영 "문제 정의 방식", 문제를 스스로 정의하게 하는 해커톤 과제 | 맡기기 전에 intent를 글로 쓰기 |
| 위임 판단과 작업 분해 | Delegation | CJ올리브영(코파 프로브 활용)의 "AI 활용 및 프롬프트 작성 과정", Dohmke의 작업 분해 | 사람 몫과 AI 몫을 먼저 나누고 작게 맡기기 |
| 검증과 디버깅 | Discernment | CJ올리브영 "결과 검증 방식", SK하이닉스 해커톤 | 테스트로 완료 기준 정하기, 결과 설명해 보기 |
| 맥락과 작업 환경 설계 | Description과 Delegation에 걸침(필자 해석) | SDLC의 단계별 산출물 커밋 | 스킬, CLAUDE.md, 이슈·PR에 맥락 남기기 |
| 책임과 기초 | Diligence | Anthropic 라이브 면접은 AI 없이, 직무 전문 역량 1위 | 일부 일은 일부러 AI 없이 하기 |
많이 쓰면 저절로 생기나요?
아닙니다. 지금까지 나온 실험과 조사는 많이 쓰는 것과 잘 쓰는 것이 다르다는 쪽을 가리킵니다. 다만 숫자마다 조건이 붙어 있어 함께 읽어야 합니다.
빨라졌다는 느낌은 믿기 어렵다
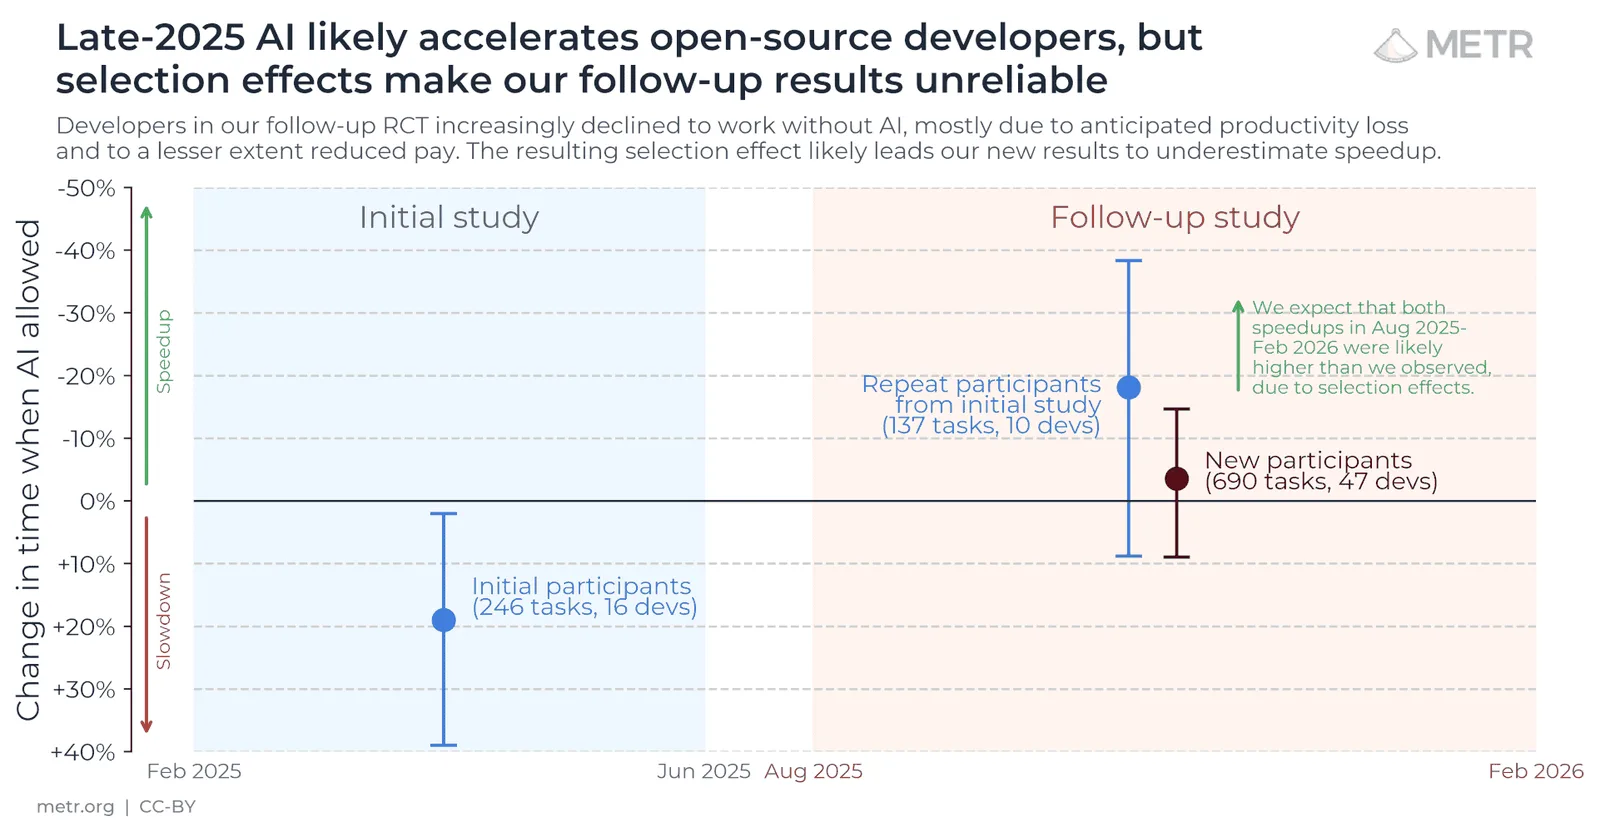
METR은 2025년 초 숙련 오픈소스 개발자 16명에게 실제 이슈 246개를 무작위로 나눠 맡겼습니다. AI를 허용하자 작업 시간이 19% 더 걸렸는데, 개발자들은 끝난 뒤에도 AI 덕분에 20% 빨라졌다고 믿었습니다(METR).
이 숫자를 "AI는 개발자를 느리게 한다"로 읽으면 안 됩니다. 2025년 초 도구 기준의 결과이고, METR은 2026년 2월 발표한 후속 실험에서 재참가자는 시간이 18% 줄고(신뢰구간 -38%에서 +9%) 신규 참가자는 4% 줄었다(-15%에서 +9%)고 추정했습니다. 그러면서도 참가자의 30~50%가 AI 없이 하기 싫어 일부 과제를 내지 않았다며 이 데이터를 "unreliable signal"(믿기 어려운 신호)이라고 스스로 밝혔습니다(METR). 두 연구에서 일관되게 남는 교훈은 체감과 실제가 어긋날 수 있다는 점입니다.
AI로 배우면 이해가 덜 남을 수 있다
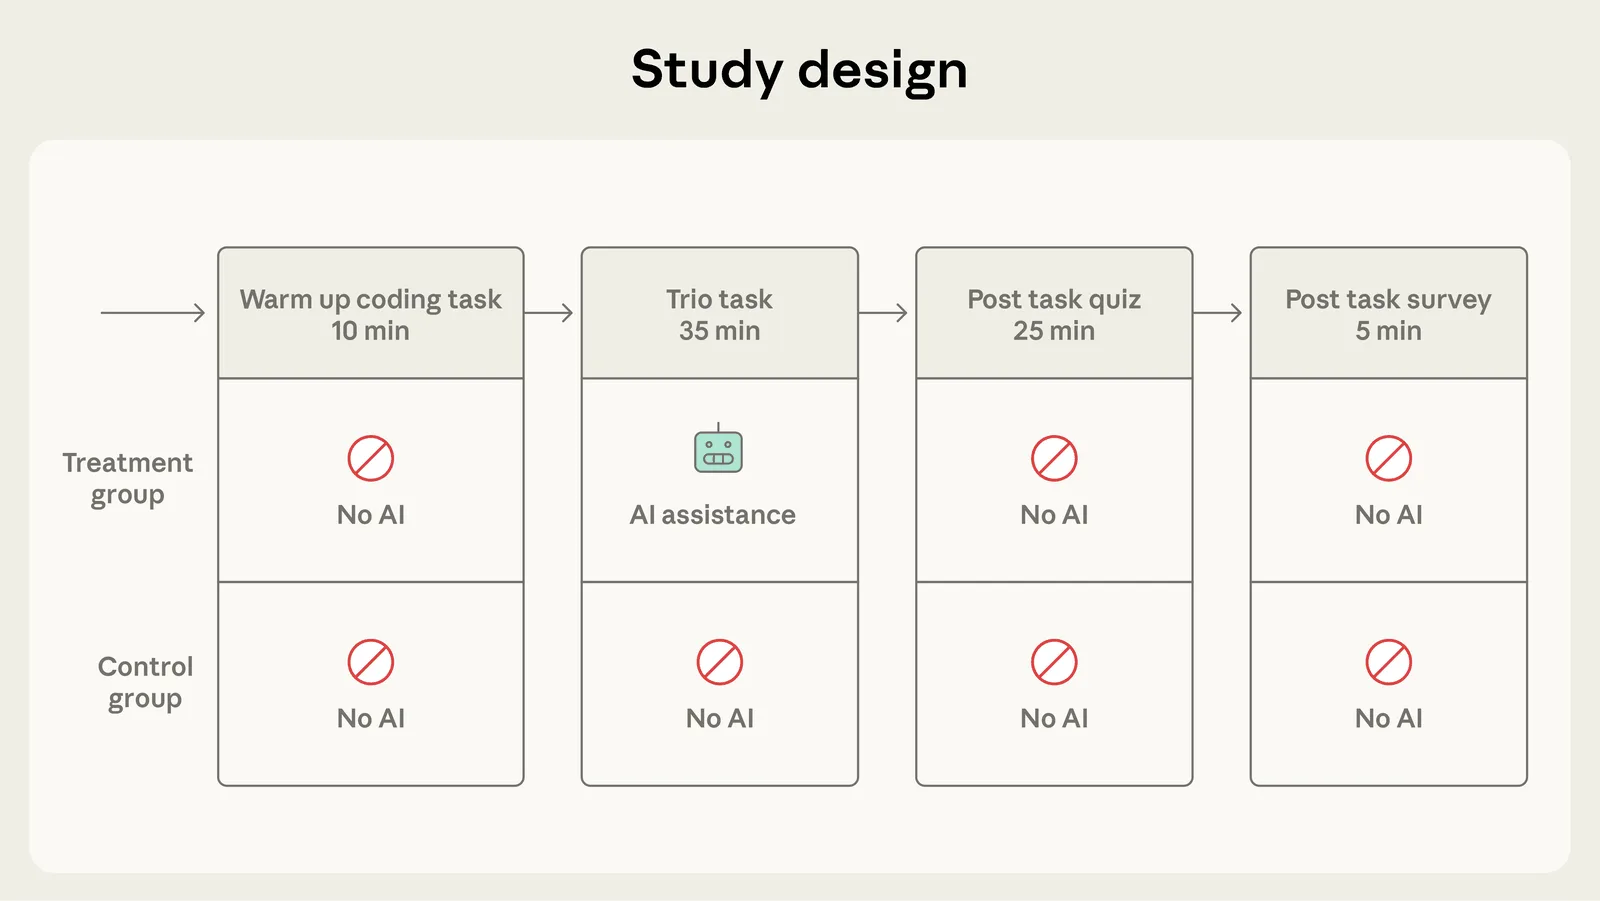
Anthropic은 2026년 1월, 주로 주니어인 개발자 52명을 무작위로 나눠 낯선 비동기 라이브러리 Trio로 기능을 구현하게 한 뒤 퀴즈를 봤습니다. 한 그룹만 과제 시간에 AI 도움을 받았습니다.
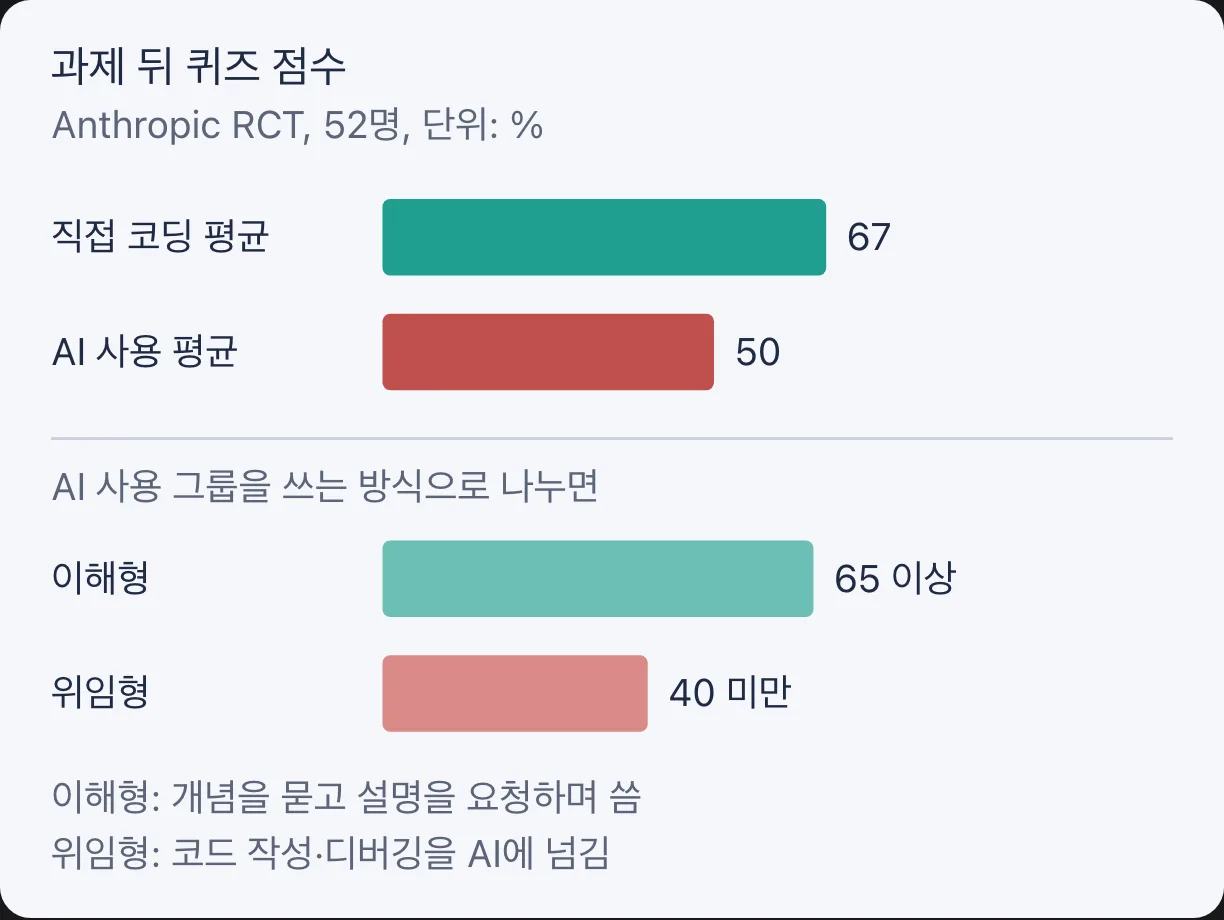
결과는 AI 그룹 평균 50%, 직접 코딩 그룹 67%로 17%p 차이였습니다. 속도는 AI 그룹이 약 2분 빨랐지만 통계적으로 유의하지 않았고, 격차가 가장 큰 문항은 디버깅이었습니다. 더 눈여겨볼 대목은 AI를 쓴 방식에 따른 차이입니다. 개념을 묻고 설명을 요청하며 이해하는 데 AI를 쓴 사람은 65% 이상, 코드 작성이나 디버깅을 AI에 통째로 기댄 사람은 평균 40% 미만이었습니다(Anthropic). 표본이 작고 처음 보는 라이브러리를 배우는 상황이며, Anthropic도 사용 방식과 학습 결과 사이의 인과관계를 주장하지는 않는다고 밝혔습니다. 그래도 AI를 쓰느냐만큼 어떻게 쓰느냐에 따라 남는 실력이 크게 달랐다는 점은 눈여겨볼 만합니다.
산출물을 만들 때 오히려 검증이 줄어드는 경향도 있습니다. Anthropic AI Fluency Index는 2026년 1월 한 주 동안의 Claude.ai 대화 9,830개를 분석했는데, 앱이나 코드, 문서 같은 산출물을 만든 대화에서는 맥락 누락을 지적하는 비율이 5.2%p, 사실을 확인하는 비율이 3.7%p, 추론을 따져 묻는 비율이 3.1%p 낮았습니다. 결과물이 그럴듯해 보여서일 수 있다는 것은 Anthropic이 든 여러 가능한 설명 가운데 하나입니다. 상관관계이고 초기 사용자 쪽으로 치우친 표본이라는 한계를 Anthropic도 밝혔습니다(Anthropic).
개발자 커뮤니티의 체감도 같습니다. 앞에서 본 Hacker News 질문이 바로 이해하지 못한 AI 코드를 내보내는 문제였고, dev.to에는 "I Made 866 Commits in 5 Weeks. My Understanding Didn't Keep Up."(5주에 커밋 866개를 했지만 이해는 따라가지 못했다)라는 글이 올라왔습니다(dev.to). teo의 결론도 비슷합니다. "AI로 만드는 속도는 빨라졌지만, 만들어진 것을 이해하고 이어서 개발하는 속도까지 같이 빨라지지는 않았습니다."
개인보다 조직이 더 크게 좌우한다
DORA 2025 보고서(약 5,000명)에서 응답자 90%가 업무에 AI를 쓰고 80% 이상이 생산성이 올랐다고 느꼈지만, 30%는 AI가 만든 코드를 거의 또는 전혀 믿지 않았습니다. AI 도입은 소프트웨어 배포 안정성과 여전히 부정적인 관계였습니다. DORA의 요약은 "AI doesn't fix a team; it amplifies what's already there."(AI는 팀을 고치지 않는다. 이미 있는 것을 증폭할 뿐이다)입니다(Google Cloud).
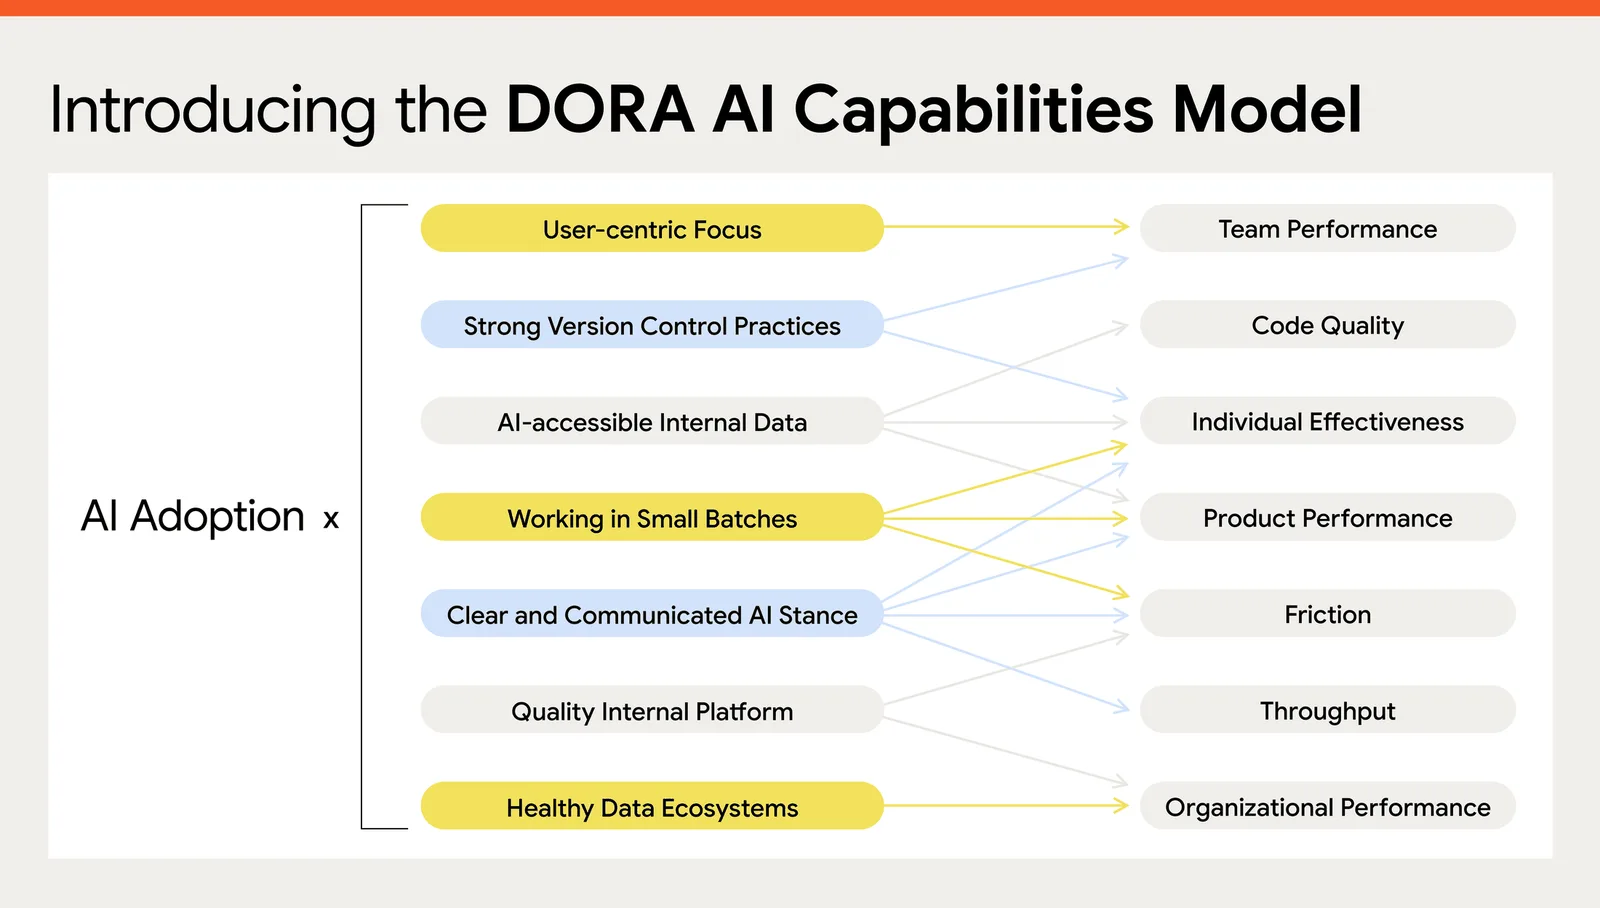
국내 현장의 증언도 있습니다. 우아한형제들 박경태 기술이사는 2025년 10월 우아콘에서 코파일럿 도입 초기에는 만족도가 높았지만 "테스트·리뷰·자동화 영역에서 근본적인 병목은 해소되지 않았다"고 말했습니다(바이라인네트워크). Microsoft WTI 2026은 문화, 관리자 지원, 인재 제도 같은 조직 요인이 개인의 태도와 행동보다 AI 효과에 2배 넘게 기여한다고 봤습니다(67% 대 32%). 그런데 결과가 안 나와도 AI로 일을 다시 설계한 시도를 보상받는다는 응답은 13%뿐이었습니다(Microsoft WTI 2026).
신입·주니어에게는 무엇이 달라졌나요?
신입이 첫 경험을 쌓던 일이 먼저 AI로 넘어가면서 입구는 좁아지고, 증명해야 할 것은 늘었습니다. Stanford Digital Economy Lab의 Canaries 연구(2026년 8월 12일 개정판)는 미국의 AI 노출 직무에서 22~25세 고용이 덜 노출된 또래의 추세보다 19% 낮다고 봤습니다. 경력자에게는 이런 격차가 없었고, 해고보다는 신규 채용 감소로 생긴 격차였습니다. 연구진은 인과 추정이 아니라 초기 서술 지표라고 선을 그었습니다(Stanford).
국내에서는 한국노동연구원 분석에서 2024년 경력 3년 미만 소프트웨어 개발자가 9천 명 줄고 3년 이상은 4만 2천 명 늘었습니다(뉴스1). 인프런 블로그가 정리한 실리콘밸리 개발자 인터뷰의 표현으로는 "잘 정의된 반복 태스크가 AI에 먼저 배정되면서 첫 경험을 얻는 입구가 좁아졌습니다"(인프런).
채용하는 쪽은 AI 협업 능력과 혼자 생각하는 힘을 따로 봅니다. Anthropic 지원자 가이드는 "we're looking for candidates who excel at collaborating with AI."라고 하면서도, 지원서는 본인이 초안을 쓴 뒤 Claude로 다듬고, 라이브 면접은 따로 안내하지 않는 한 "no AI assistance"로 치르라고 합니다(Anthropic). Anthropic 안에서 신입 채용 비중과 면접 평가표가 어떻게 바뀌었는지는 Anthropic 주니어 채용 보고서에 따로 정리했습니다.
어떻게 기르고 증명하나요?
기르는 핵심은 AI에 맡기기 전과 받은 뒤에 사람이 할 일을 습관으로 만드는 것이고, 증명의 핵심은 그 과정을 남들이 볼 수 있게 남기는 것입니다. 아래는 앞의 자료를 바탕으로 한 필자의 권고입니다.
기르는 법
맡기기 전에 의도를 글로 씁니다. Anthropic AI-native SDLC 플레이북은 코드를 짜기 전에 intent.md를 쓰라고 하고, 플레이북이 제시한 다섯 칸(Problem, Proposed outcome, Affected users and systems, Constraints, Open questions)을 국내 유튜브 채널 개발동생이 템플릿으로 정리했습니다(개발동생). 예를 들면 이렇습니다.
# intent.md: 주문 내역 CSV 내보내기

## Problem
고객센터가 주문 내역을 매번 개발팀에 요청해 응대가 늦어진다.

## Proposed outcome
관리자 화면에서 기간을 골라 주문 내역을 CSV로 내려받는다.

## Affected users and systems
고객센터 상담원, 관리자 화면, 주문 DB 읽기 전용 복제본

## Constraints
개인정보는 마스킹한다. 조회 기간에 상한을 둔다. 기존 주문 API는 바꾸지 않는다.

## Open questions
환불 건을 포함할지, 날짜를 어느 시간대 기준으로 자를지
다섯 칸을 채우다 막히는 곳이 곧 아직 정의하지 못한 부분입니다. 개발동생 영상의 지적처럼 intent.md는 Claude Code가 저절로 읽는 파일이 아니라서, CLAUDE.md에 읽으라고 적어 두어야 합니다. 오탈자나 작은 버그까지 이렇게 할 필요는 없고, 큰 기능을 시작할 때 쓰면 됩니다.
시작하기 전에 잠깐 멈춥니다. WTI 2026에서 Frontier Professional은 일을 시작하기 전에 무엇을 AI에 맡기고 무엇을 사람이 할지 정하려고 일부러 멈추는 비율이 53%로, 다른 AI 사용자(33%)보다 높았습니다(Microsoft WTI 2026). teo도 작업이 예상보다 오래 걸리면 멈추고 AI에게 현재 상황을 설명하게 했다고 썼습니다.
일부 일은 일부러 AI 없이 합니다. 같은 조사에서 실력을 유지하려고 일부러 AI 없이 일하는 비율은 Frontier Professional 43%, 다른 사용자 30%였습니다. 앞의 Anthropic 실험을 떠올리면, 새 라이브러리나 새 도메인을 배울 때는 코드를 받기보다 개념을 묻고 직접 짜 보는 편이 남습니다.
한 번에 끝내지 않고 주고받습니다. AI Fluency Index에서 대화의 85.7%에 반복과 수정이 있었고, 반복한 대화에서는 다른 유창성 행동이 평균 2.67개로 반복하지 않은 대화(1.33개)의 두 배였습니다. teo는 한 모델에서 잘 통하던 방식이 다음 모델에서는 방해가 되기도 했다고 썼으니, 모델이 바뀌면 일하는 법도 다시 다듬어야 합니다. 최신 모델에 맞춘 요령은 Opus 5.5 잘 쓰는 법에 정리했습니다.
산출물을 받았을 때일수록 의심하고, 네 가지 질문에 답해 봅니다. 산출물을 만든 대화일수록 검증 행동이 적었다는 Fluency Index 결과를 거꾸로 쓰는 습관입니다. 인프런 블로그가 정리한 질문은 이렇습니다(인프런). AI가 작성한 코드가 왜 작동하는가? 예상과 다른 결과가 나오면 어디부터 확인할 것인가? 이 변경이 다른 기능과 시스템에 어떤 영향을 줄 수 있는가? 문제가 생겼을 때 원래 상태로 어떻게 되돌릴 것인가?
반복하는 판단은 스킬로, 작업의 배경은 이슈와 PR로 남깁니다. 같은 지적을 두 번 하게 되면 스킬이나 CLAUDE.md로 옮길 때입니다.
증명하는 법
- 이력서에 과정을 씁니다. 코딩알려주는누나가 소개한 구성처럼 프로젝트마다 어떤 문제를 정의했는지, 내 역할이 무엇이었는지, AI로 어떻게 접근했는지, 결과가 무엇이었는지를 적고, 필자는 여기에 어떻게 검증했는지를 더하길 권합니다. 결과 수치는 실제로 잰 것만 씁니다.
- 3초 안에 이해되는 데모를 만듭니다. 같은 영상은 OpenAI의 Gabriel Petersson 인터뷰를 인용해, 데모는 단순해야 하고 무엇을 만들었는지 3초 만에 보여야 한다고 했습니다(코딩알려주는누나). 막연한 효율 개선 문구보다 화면 하나가 낫습니다.
- 저장소에 intent, spec, plan과 테스트를 함께 커밋합니다. 평가자는 결과물만이 아니라 과정을 보고 싶어 합니다. CJ올리브영과 SK하이닉스가 평가 항목으로 밝힌 "문제 정의, AI 활용, 결과 검증"이 저장소에 그대로 남는 셈입니다.
- 과제형 전형과 해커톤에 나갑니다. SK하이닉스 AI 해커톤은 학력 정보를 받지 않고 우수자에게 채용 패스트트랙 기회를 준다고 밝혔습니다(SK하이닉스 뉴스룸). 이력서 한 줄보다 과정을 직접 보여 줄 수 있는 자리입니다.
- AI 없이도 설명할 수 있게 준비합니다. Anthropic처럼 라이브 면접에서 AI를 쓰지 못하게 하는 곳이 있습니다. Dohmke가 AI 협업을 요구하는 학생 평가용 과제의 예로 든 "Here's what the AI wrote, what's wrong with it?"(AI가 쓴 코드다, 무엇이 문제인가?)에 답할 수 있는지 스스로 점검해 보면 좋습니다.
팀이 평가한다면
사용량 대신 산출물과 과정을 보는 편이 낫다고 필자는 봅니다. 토큰 사용량이나 커밋 수는 쉽게 부풀릴 수 있고, 2026년 10월의 tokenmaxxing 반성도 그 결과였습니다. Zapier처럼 루브릭을 쓰더라도 합격·불합격이 아니라 다음 단계를 정하는 자기 진단으로 쓰고, PR에 남은 intent와 테스트, 리뷰 기록처럼 과정을 볼 수 있는 산출물을 평가에 넣는 방법이 있습니다. 조직 요인이 개인 요인보다 효과가 크다는 WTI 결과와 DORA의 증폭기 비유를 함께 보면, 개인에게 AI 네이티브 역량을 요구하기 전에 작은 단위 작업, 버전 관리, 실패해도 보상받는 실험 공간 같은 기반부터 갖추는 것이 리더의 몫입니다.
출처
- schw240 블로그: m.blog.naver.com/schw240/224423192112
- Addy Osmani: addyo.substack.com/p/the-ai-native-software-engineer
- Anthropic 4D 원페이저: www-cdn.anthropic.com/b383cf6baddbfc72fdf8b0ed533a518e2872d531.pdf
- Thomas Dohmke: ashtom.github.io/developers-reinvented
- Microsoft WTI 2026: microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-th…
- Anthropic: claude.com/blog/the-ai-native-sdlc-playbook
- X: x.com/tobi/status/1909251946235437514
- X: x.com/michakaufman/status/1909610844008161380
- The Verge: theverge.com/news/657594/duolingo-ai-first-replace-contract-workers
- Amazon: aboutamazon.com/news/company-news/amazon-ceo-andy-jassy-on-generative-ai
- Business Insider: businessinsider.com/microsoft-internal-memo-using-ai-no-longer-optional…
- TechCrunch: techcrunch.com/2025/08/22/coinbase-ceo-explains-why-he-fired-engineers-…
- Business Insider: businessinsider.com/meta-ai-employee-performance-review-overhaul-2025-11
- Zapier: zapier.com/blog/transform-ai-company-culture
- Zapier 루브릭: zapier.com/blog/ai-fluency-rubric
- HN: news.ycombinator.com/item?id=49997161
- EM360Tech: em360tech.com/video-resources/tokenmaxxing-dead-jane-smith-thoughtspot-…
- HN: news.ycombinator.com/item?id=50137950
- 이데일리: v.daum.net/v/7EqzU9rNwv
- 원티드: wanted.co.kr/events/article_260810
- 아시아경제: view.asiae.co.kr/article/2026072108302549045
- 한국경제: hankyung.com/article/202607304570g
- SK하이닉스 뉴스룸: news.skhynix.co.kr/?p=66696
- 바이라인네트워크: byline.network/2026/09/10-707
- 뉴데일리: biz.newdaily.co.kr/site/data/html/2026/06/04/2026060400117.html
- MTN: news.mtn.co.kr/article/2026101312433186539
- 중앙일보: v.daum.net/v/20250610060102680
- 파이낸셜뉴스: fnnews.com/news/202603021801362180
- 카카오: kakaocorp.com/page/detail/11900
- 아이뉴스24: inews24.com/view/1884340
- 고용노동부: moel.go.kr/news/enews/report/enewsView.do?news_seq=19253
- 지디넷코리아: v.daum.net/v/20251208161412362
- 벤처스퀘어: venturesquare.net/1099438
- velog teo: velog.io/@teo/ai-native-fe
- Anthropic: anthropic.com/research/AI-fluency-index
- Anthropic: anthropic.com/research/how-ai-is-transforming-work-at-anthropic
- HN: news.ycombinator.com/item?id=50151036
- Stack Overflow: survey.stackoverflow.co/2026/ai/data/ai-trust
- Kent Beck: tidyfirst.substack.com/p/augmented-coding-beyond-the-vibes
- 코딩알려주는누나: youtube.com/watch?v=A7t9GQrNd5g
- METR: metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study
- METR: metr.org/blog/2026-02-24-uplift-update
- Anthropic: anthropic.com/research/AI-assistance-coding-skills
- dev.to: dev.to/mikachu/i-made-866-commits-in-5-weeks-my-understanding-didnt-kee…
- Google Cloud (DORA): cloud.google.com/blog/products/ai-machine-learning/announcing-the-2025-…
- 바이라인네트워크: byline.network/2025/10/1030
- Stanford: digitaleconomy.stanford.edu/publications/canaries-in-the-coal-mine
- 뉴스1: v.daum.net/v/20260127054103877
- 인프런: m.blog.naver.com/inflearn/224405725526
- Anthropic: anthropic.com/candidate-ai-guidance
- 개발동생: youtube.com/watch?v=4kXsF2S5MNY