핵심 요약
- Uber는 MCP 서버 800개 이상, 도구 5,000개 이상을 게이트웨이 하나로 운영합니다. 팀마다 따로 만들던 MCP 연동을 레지스트리(제어 평면)와 프록시(데이터 평면)로 모았고, HTTP, gRPC, TChannel로 된 기존 API를 백엔드 수정 없이 도구로 바꿉니다.
- 자동으로 만들되 기본은 꺼 둡니다. AutoCrawler가 서비스 정의에서 도구를 만들고 LLM이 설명을 쓰지만, 모든 도구는 비활성으로 등록되고 소유 팀이 검토하고 켜야 에이전트에게 보입니다. "발견이 곧 노출은 아니다"가 핵심 원칙입니다.
- 도구 정의만으로 컨텍스트가 찹니다. Uber는 도구 100개 이상을 설치한 세션에서 도구 설명만 5만~7만 토큰이 매 턴 다시 전송됐다고 밝혔습니다. 필자가 GitHub REST API 1,232개 작업을 도구로 바꿔 세어 보니 약 38만 토큰(OpenAI 토크나이저 추정)으로 20만 토큰짜리 컨텍스트 창에는 들어가지도 않았고, Omni MCP처럼 메타 도구 4개만 노출하면(필자가 쓴 최소 정의 기준) 202토큰이었습니다.
- 해법은 "적게 보여 주고, 적게 읽게 하기"입니다. 도구 4개짜리 Omni MCP로 필요할 때 찾게 하고, 응답은 필요한 필드만 잘라 주고(Response Projection), 코딩 에이전트는 CLI로 호출한 결과를 파일에 써서 필요한 부분만 읽습니다(Code Mode). Uber가 잰 SQL 쿼리에서 Code Mode는 결과가 한 줄인 쿼리도 토큰을 55% 이상, 넓은 표 조회는 거의 100% 줄였습니다.
- 권한과 감사는 게이트웨이가 한곳에서 맡습니다. 호출 주체(사람, 서비스, 에이전트)별 호출 주체(사람, 서비스, 에이전트)별 도구 단위 인가와 응답의 개인정보 자동 마스킹은 모든 도구에 기본으로 걸고, 서드파티 서버에는 토큰을 그대로 넘기지 않고 교환해 씁니다.
- 작은 팀도 가져갈 것이 있습니다. 게이트웨이보다 레지스트리(목록, 소유자, 켜짐 여부)를 먼저 만들고, 도구가 늘면 검색으로 바꾸고, 쓰기 도구는 조회 도구와 나누는 것부터 시작하면 됩니다.
목차
- Uber는 왜 MCP 게이트웨이를 만들었나
- 한눈에 보는 구조: 레지스트리와 프록시
- 문제 1. 도구는 누가 만들고 누가 책임지나
- 문제 2. 도구 설명만으로 컨텍스트가 찬다
- 문제 3. 비슷한 도구 사이에서 맞는 것을 고르기
- 문제 4. 모델이 결과를 다 읽을 필요는 없다
- 문제 5. 권한, 감사, 개인정보
- 다른 회사와 제품은 어떻게 하나
- 작은 팀이 가져다 쓸 설계 여섯 가지
- 반론과 이 글의 한계
- 자주 묻는 질문
- 마치며
- 출처
Uber는 왜 MCP 게이트웨이를 만들었나
팀마다 MCP 연동을 따로 만들다 보니 도구를 찾기 어렵고, 운영이 불안정하고, 특정 서비스와 에이전트에 묶였기 때문입니다. MCP(Model Context Protocol)는 AI 에이전트가 외부 도구와 데이터를 쓰는 표준 규약입니다. Uber 엔지니어링 블로그는 초기에 각 팀이 독자적으로 연동을 만들어 도구와 인프라가 중복됐고, 수백 개 팀이 에이전트 워크플로를 시도하기 시작하자 그 방식으로는 운영 복잡도, 보안 위험, 개발자의 수고만 늘어난다고 판단했다고 적습니다(Uber Engineering, Designing MCP Gateway, 2026-10-01).
규모를 보면 이유가 분명해집니다. 2026년 4월 MCP Dev Summit 북미 키노트를 5월에 정리한 Agentic AI Foundation(MCP를 관리하는 재단) 블로그에 따르면 Uber에는 내부 서비스가 1만 개 이상 있고, 엔지니어 5,000명 이상 중 90% 이상이 매달 AI 도구를 쓰며, 에이전트 작업이 주 6만 건 돌아갑니다. 이때 Uber가 꼽은 문제는 세 가지였습니다. MCP 서버를 만들고 배포하는 표준이 없었고, 어떤 에이전트가 어떤 데이터에 접근하는지 보이지 않았고, 검증된 도구를 찾을 방법이 없었습니다(AAIF Blog, 2026-05-14). 발표자인 Meghana Somasundara는 "에이전트는 더 빨리 움직이고 더 빨리 망가뜨린다(Agents move faster and break things faster)"고 말했습니다.
그래서 Uber는 모든 에이전트와 백엔드 사이에 MCP 게이트웨이라는 마이크로서비스 하나를 두었습니다. 10월 1일 글 기준으로 이 게이트웨이는 MCP 서버 800개 이상, 도구 5,000개 이상을 호스팅합니다. 8월 27일에 나온 다른 Uber 글은 사내 서버와 서드파티 SaaS 서버를 합쳐 "1,000개 이상의 MCP 서버"가 이 단일 진입점을 지난다고 썼으니(Uber Engineering, Running a Software Factory Efficiently at Uber Scale, 2026-08-27), 숫자는 무엇을 세느냐에 따라 다릅니다. 게다가 같은 8월 글은 다른 대목에서 "게이트웨이의 MCP 도구 1,000개 이상"이라고 써서, 1,000이 서버 수인지 도구 수인지도 분명하지 않습니다. 어느 쪽이든 사람이 손으로 관리할 수 있는 규모는 아닙니다.
한눈에 보는 구조: 레지스트리와 프록시
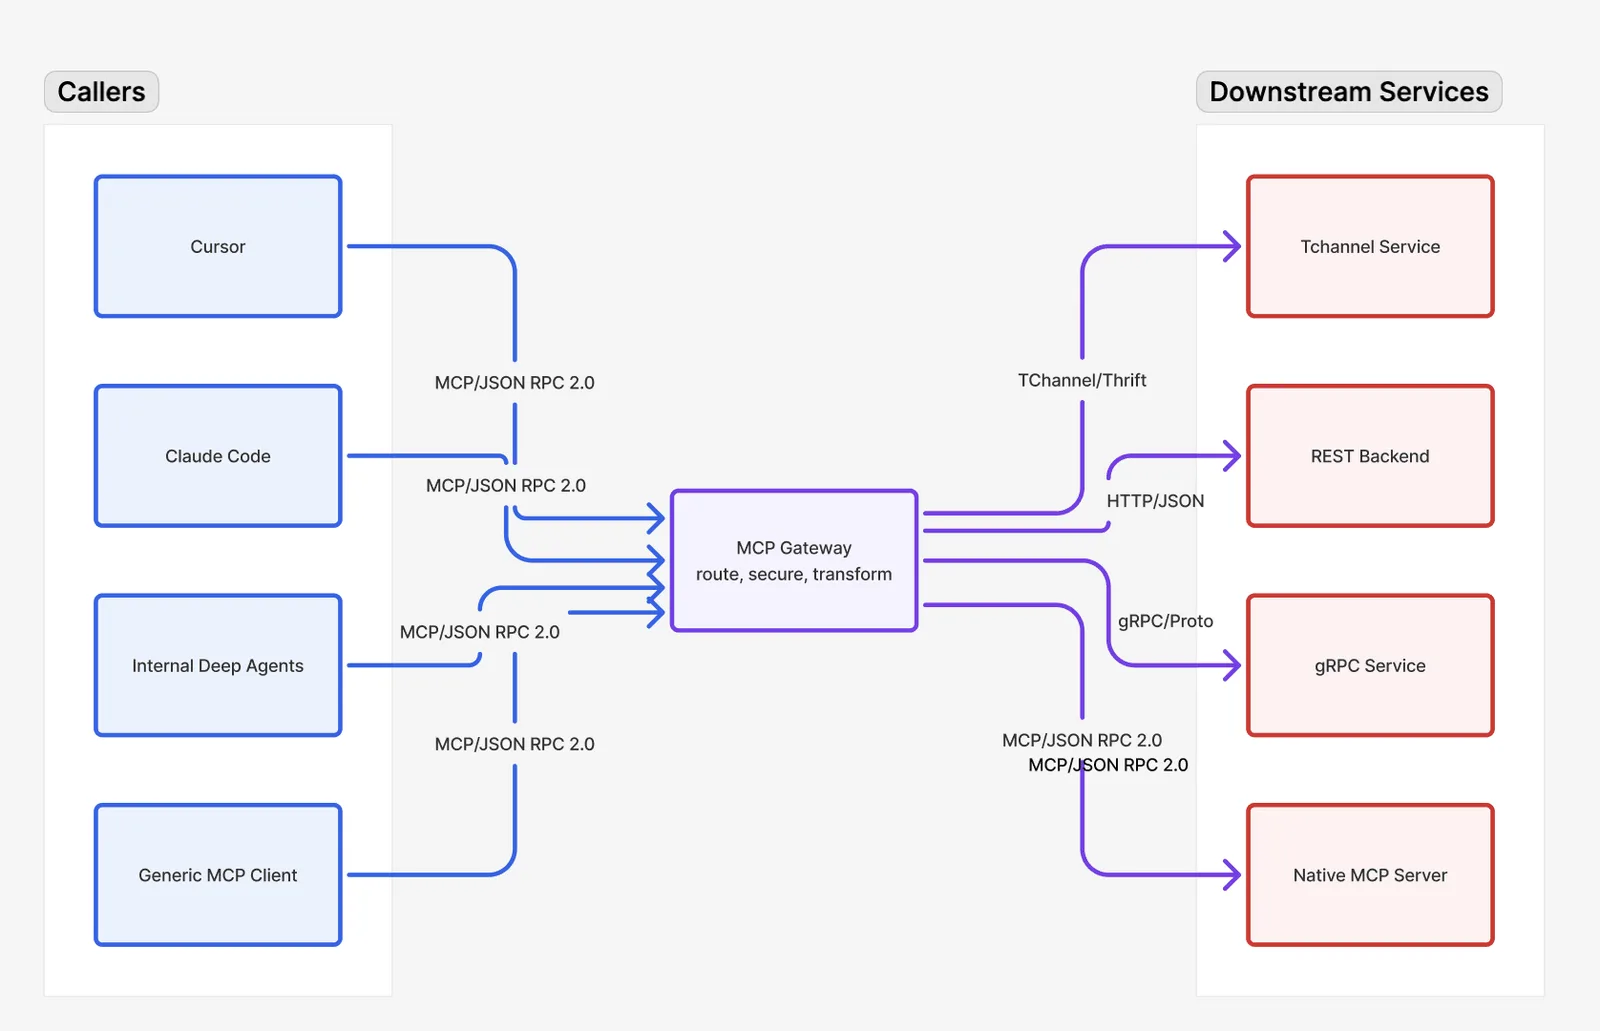
게이트웨이는 "무엇이 있고 누가 켰나"를 아는 레지스트리와, 실제 호출을 처리하는 프록시 두 부분으로 나뉩니다. 네트워크 장비에서 쓰는 말로 레지스트리가 제어 평면, 프록시가 데이터 평면입니다.
- MCP Registry(제어 평면): 서버와 도구의 카탈로그입니다. Uber는 이것을 "검색, 소유권, 활성화의 단일 진실 원천"이라고 부릅니다. 도구는 기존 API를 코드 없이 노출하는 정의부터 MCP 스펙에 맞춰 직접 구현한 네이티브 도구까지 섞여 있습니다.
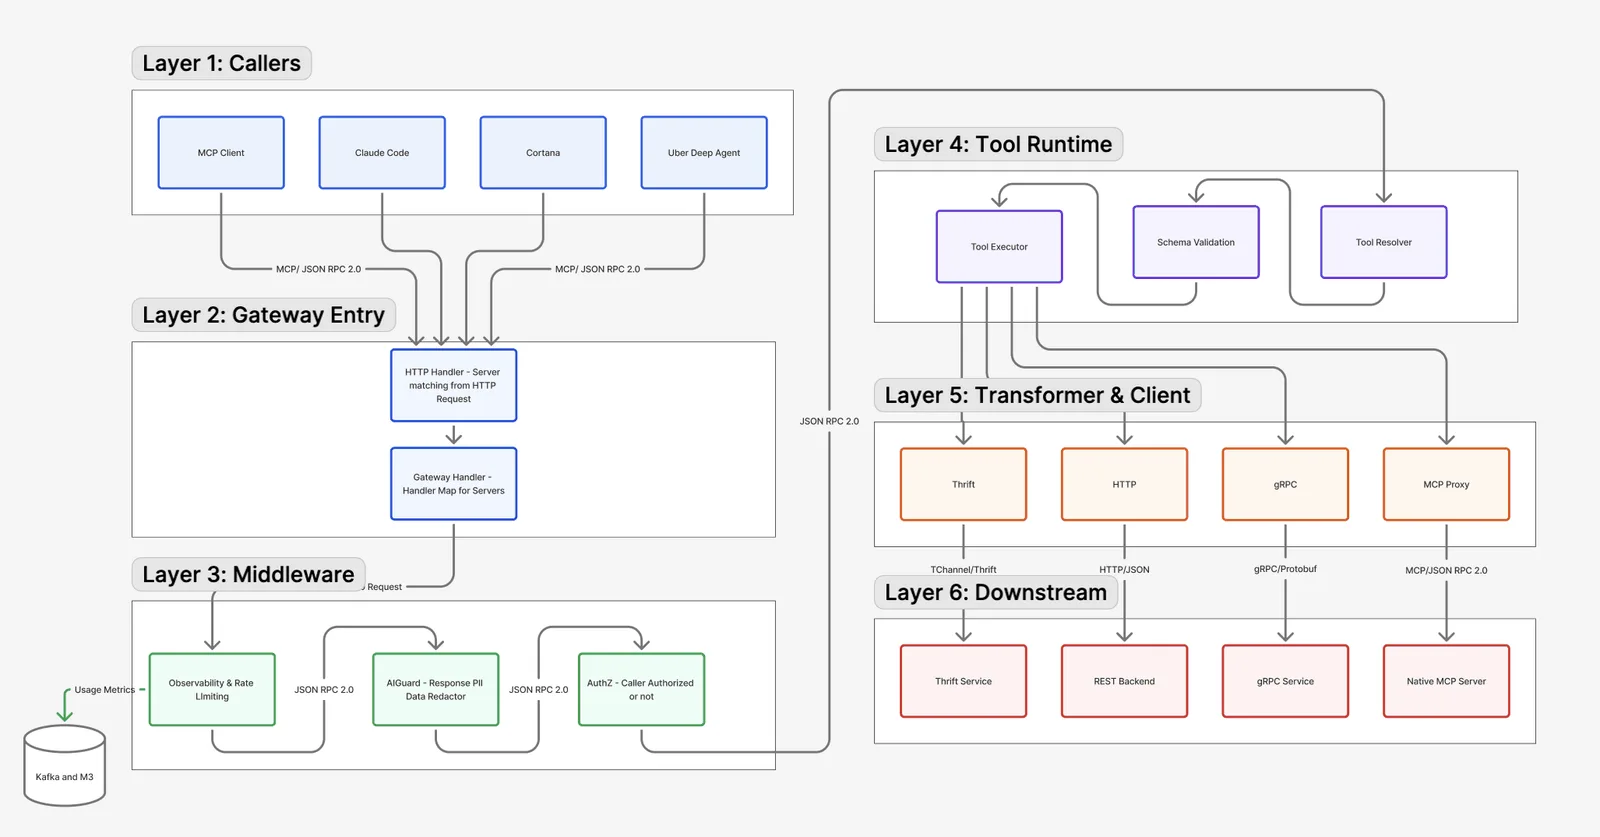
- Proxy Gateway(데이터 평면): 런타임에 MCP 요청을 HTTP, gRPC, TChannel 요청으로 바꿔 백엔드에 보내고, 응답을 다시 MCP 형식으로 돌려줍니다. 백엔드 서비스는 고칠 필요가 없습니다.
데이터 평면은 레지스트리의 설정을 일정 주기로 읽어 메모리에 올리기 때문에, 도구를 켜거나 설명을 고쳐도 재시작이나 재배포 없이 반영됩니다. 가상 서버마다 /<서비스 이름>/mcp 엔드포인트 하나가 생깁니다. 실제 백엔드 호출은 Uber의 서비스 메시 사이드카인 Muttley가 맡아서, 게이트웨이는 기존 서비스 간 라우팅을 그대로 물려받습니다.
이 구조 위에서 도구가 수천 개로 늘었을 때 생긴 문제와 Uber의 해법을 다섯 가지로 나눠 보겠습니다.
문제 1. 도구는 누가 만들고 누가 책임지나
Uber의 답은 "도구는 자동으로 만들고, 켜는 것은 서비스 소유 팀이 한다"입니다. 수천 개 서비스 팀에게 MCP 서버를 손으로 만들라고 하면 느리고 고통스럽다는 것이 Uber의 판단이었습니다. 그래서 AutoCrawler라는 수집기를 만들었습니다.
AutoCrawler는 Uber의 워크플로 엔진 Cadence 위에서 도는 분산 작업으로, 서비스 인터페이스 정의(IDL) 레지스트리를 정해진 주기로 훑어 새 서비스와 API, 스키마 변경을 찾습니다. Protobuf나 Thrift로 정의된 서비스라면 다섯 단계를 거칩니다.
- 서비스에 대응하는 가상 MCP 서버를 만들거나 갱신합니다.
- IDL 파일을 파싱해 메서드 이름, 요청과 응답 스키마, 주석을 뽑습니다.
- LLM으로 에이전트가 이해하기 쉬운 도구 설명을 새로 씁니다.
- 스키마를 MCP가 쓰는 JSON-RPC 2.0 스키마로 바꿉니다.
- 레지스트리에 비활성 상태로 등록합니다.
MCP를 직접 구현한 네이티브 서버는 Uber의 MCPFx 프레임워크로 만들고, 서버가 내보내는 하트비트 지표를 AutoCrawler가 보고 찾아냅니다. 찾으면 listTools를 호출해 도구 목록을 받아 역시 비활성 상태의 가상 프록시 서버로 등록합니다.
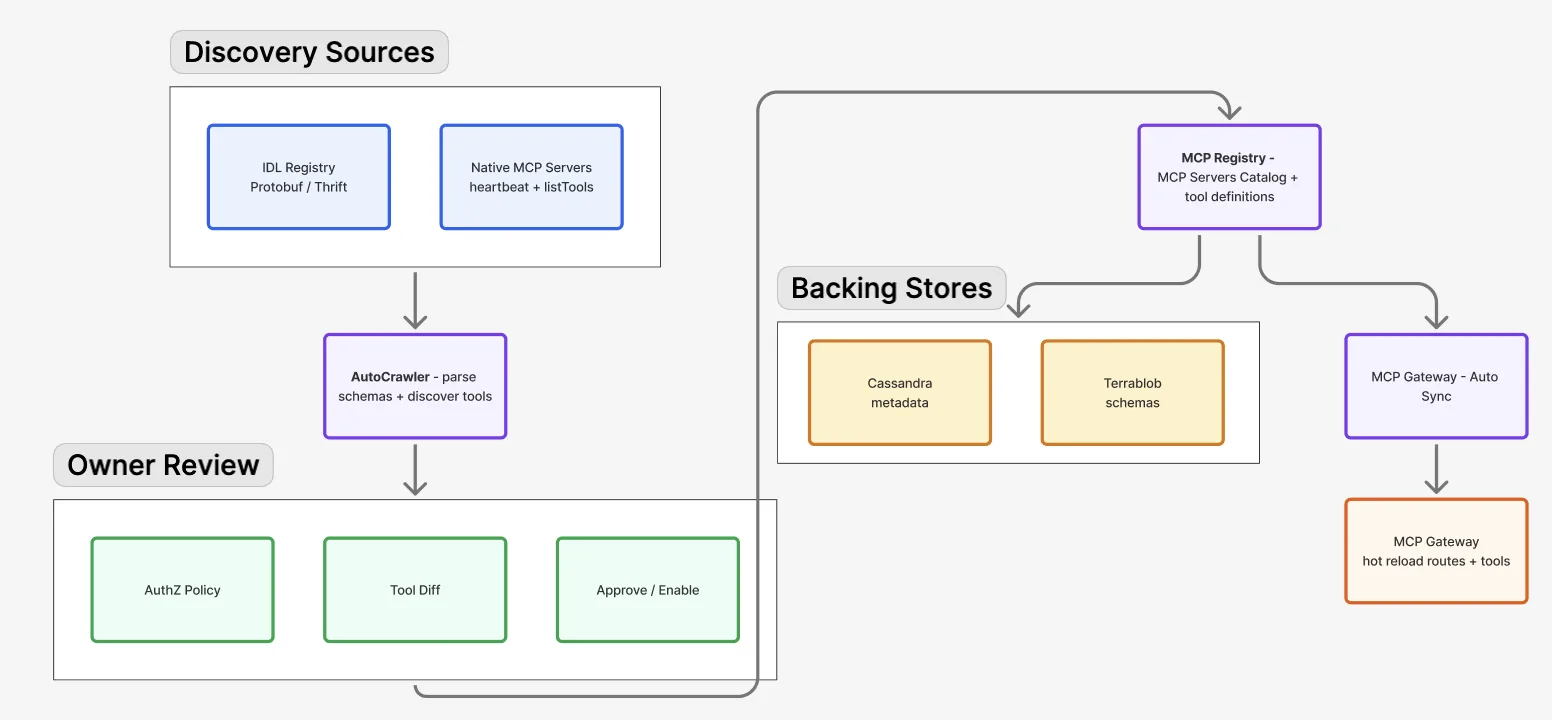
여기서 Uber가 강조하는 원칙이 "발견이 곧 노출은 아니다(discovery doesn't imply exposure)"입니다. 서비스 팀을 거치지 않고 MCP 서버를 만들 수는 있어도, 소유권과 통제권은 서비스 팀에 있어야 한다는 것입니다. 모든 서버와 도구는 꺼진 채로 시작하고, 소유 팀이 생성된 정의를 검토하고 다듬은 뒤 직접 켭니다. 도구 설명이 바뀌면 설정 변경 차이(diff)가 만들어지고 서버 소유자가 승인해야 배포되며, 문제가 생기면 이전 버전으로 되돌립니다. AAIF 정리에 따르면 이 변경은 코드와 풀 리퀘스트로 관리되고 보안 스캔을 거칩니다.
자동 변환만으로는 왜 안 될까요? 국내 사례가 답을 줍니다. 네이버클라우드의 김지혜 엔지니어는 2026년 8월 MCP 데브 서밋 서울에서, 대외와 내부 API를 합쳐 1만 개가 넘는 API를 MCP로 만들면서 세 번 시행착오를 겪었다고 발표했습니다. 손으로 만들면 품질은 좋지만 느렸고, OpenAPI 스펙을 자동 변환하면 빠르지만 도구 선택 정확도가 낮았고, 스펙과 가이드 문서로 생성하면 다시 만들 때마다 구현이 달라졌습니다. 결국 품질 평가와 AI 코드 생성을 묶은 자체 "MCP 제너레이터"를 만들어 기준에 못 미치면 다시 생성하게 했습니다(CIO 코리아, 2026-08-18). Uber가 IDL 주석을 그대로 쓰지 않고 LLM으로 설명을 다시 쓰고, 그 설명을 소유자가 승인하게 한 것과 비슷한 결론입니다.
참고로 Uber 글의 레지스트리 화면 캡처에는 "Showing 9110 of 9110"이라는 서버 수가 보입니다. 본문의 "800개 이상"과 차이가 크지만 글에는 설명이 없습니다. 비활성 서버까지 센 화면일 수 있으나 확인할 방법은 없습니다.
문제 2. 도구 설명만으로 컨텍스트가 찬다
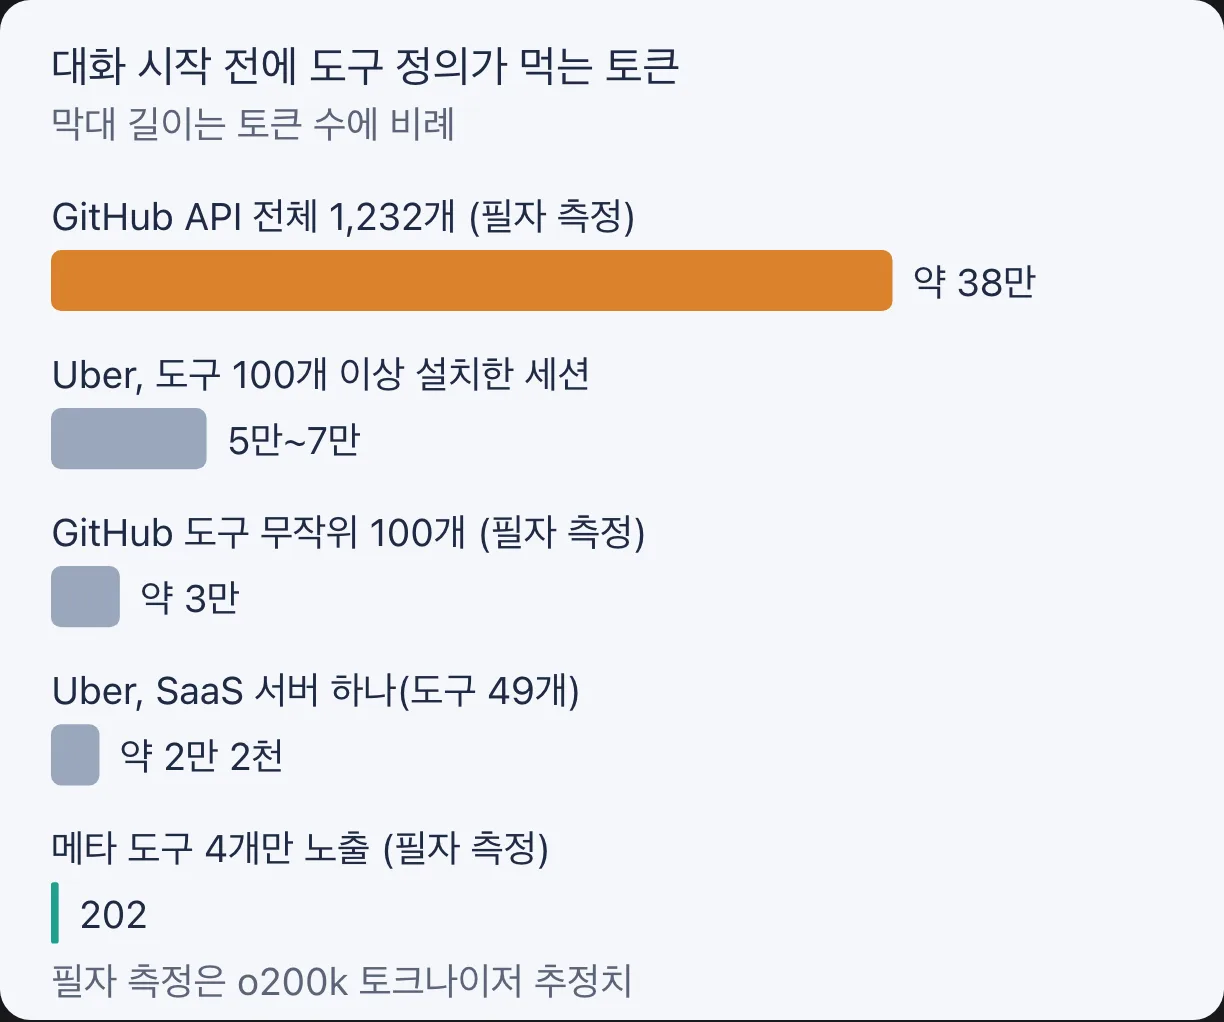
MCP 서버를 기본 방식대로 붙이면 도구 정의가 모두 컨텍스트에 실리기 때문에, 도구가 늘면 대화를 시작하기도 전에 수만 토큰을 씁니다. Uber는 이렇게 적었습니다. 도구 100개 이상을 설치한 세션에서는 엔지니어가 그 도구를 쓰든 안 쓰든 첫 프롬프트에 도구 스키마 약 5만~7만 토큰이 붙었고, 이것이 이후 모든 턴에 다시 전송됐습니다. 서드파티는 더 심했습니다. 한 업무용 SaaS는 서버 하나에 도구 49개를 넣어 스키마만 약 2만 2천 토큰이었고, 메신저와 프로젝트 관리 SaaS도 각각 34개, 46개였습니다. Uber는 "벤더 서버 두세 개만 붙여도 사용자가 프롬프트를 치기 전부터 편집 중인 파일보다 큰 스키마를 지고 다닌다"고 썼습니다(Uber Engineering).
이 숫자가 과장인지 직접 재 봤습니다. GitHub가 공개한 REST API 공식 OpenAPI 명세(2026년 10월 10일 커밋, 작업 1,232개)를 자동 변환기들이 흔히 하는 방식대로 MCP 도구 정의로 바꿨습니다. 작업 이름을 도구 이름으로, 요약과 설명을 도구 설명으로, 경로와 쿼리 파라미터와 요청 본문을 입력 스키마로 옮겼습니다. 토큰은 OpenAI의 o200k 토크나이저로 셌기 때문에 Claude로 세면 숫자가 달라지지만, 크기를 가늠하기에는 충분합니다.
| 측정 항목 (2026-10-13 필자 측정) | 토큰 |
|---|---|
| GitHub API 전체 1,232개 도구 | 379,564 |
| 도구 하나당 | 평균 308, 중앙값 226, 최대 4,902 |
| 무작위 100개(200번 뽑기) | 중앙값 30,494 (22,652~48,471) |
| 메타 도구 4개(서버 찾기, 도구 찾기, 스키마 조회, 호출) | 202 |
GitHub 하나만 통째로 붙여도 약 38만 토큰입니다. 20만 토큰짜리 컨텍스트 창에는 들어가지 않고, 100만 토큰 창이라도 3분의 1 넘게 차지합니다. 무작위 100개는 3만 토큰 안팎으로 Uber의 5만~7만보다 작지만, Uber는 "100개 이상"이라고 했고 사내 API의 스키마 깊이도 다르므로 같은 자릿수라고 보는 편이 맞습니다.
국내에서도 같은 벽에 부딪힌 기록이 있습니다. 토스는 사내 Swagger 문서를 MCP 서버로 제공하면서 "대량의 API를 제공하는 서버의 모든 API 스펙을 LLM에 제공하니 토큰 초과 에러가 발생"했고, 쓰지 않는 API를 빼고 Swagger JSON을 줄이고, API를 사용자용, 어드민용, 디버깅용으로 묶어 그 묶음 키로 페이지를 나누는 방식으로 풀었다고 썼습니다(토스 기술 블로그, 2025-10-27). 도구 설명이 시스템 프롬프트, 규칙 파일, 대화 이력과 함께 컨텍스트 창의 어느 층을 차지하는지는 AI가 코드를 쓸수록 DDD가 중요한 이유에서 그림으로 정리했습니다.
Uber의 첫 번째 해법은 Omni MCP입니다. MCP에는 여러 서버를 가로지르는 검색 개념이 없어서, 에이전트는 어느 서버에 물어볼지 미리 알아야 합니다. 서버 수백 개를 다 연결하면 위처럼 컨텍스트가 바닥납니다. Omni MCP는 게이트웨이의 모든 서버에 접근하는 단일 프록시 서버로, 도구를 딱 네 개만 노출합니다.
discover_server: 질문 의도에 맞는 MCP 서버를 찾습니다.discover_tools: 그 서버의 도구 목록을 봅니다.get_tool_schema: 쓸 도구의 JSON 스키마를 받습니다.invoke_tool: 도구를 호출합니다.
에이전트는 처음에 이 네 도구만 알고, 필요할 때 단계적으로 좁혀 들어갑니다. 필자가 이 이름과 역할대로 정의를 써서 세어 보니 202토큰이었습니다. 인가를 비롯한 게이트웨이 기능은 그대로 적용됩니다.
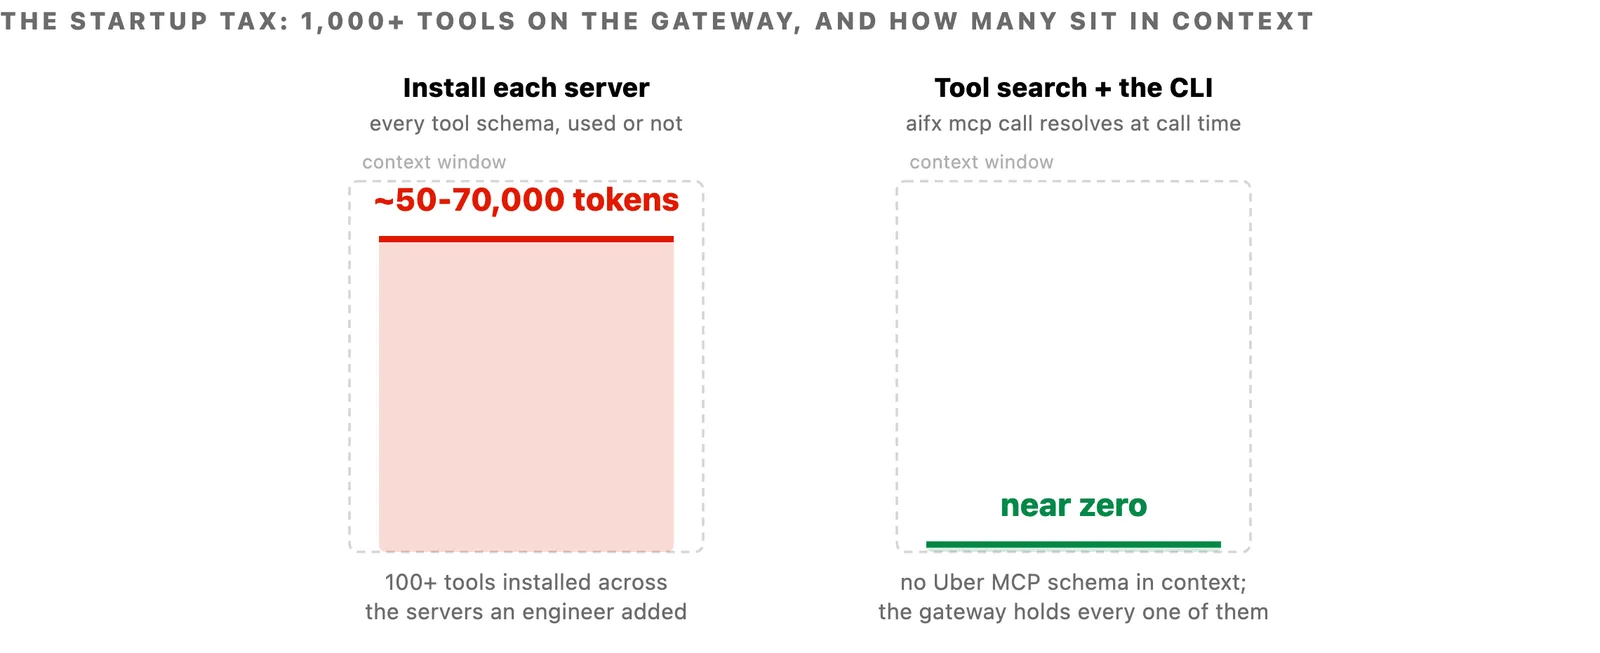
같은 방향의 수치는 다른 곳에서도 나옵니다. Anthropic은 GitHub, Slack, Sentry, Grafana, Splunk를 붙인 흔한 구성에서 도구 정의가 약 5만 5천 토큰을 차지하고, 도구 검색(Tool Search)을 쓰면 필요한 3~5개만 불러와 보통 85% 넘게 줄어든다고 공식 문서에 적었습니다(Claude Docs, Tool search tool). Cloudflare는 사내 MCP 포털에서 도구 52개, 약 9,400토큰을 포털 도구 2개, 약 600토큰으로 줄였다고 밝혔습니다(Cloudflare Blog, 2026-04-14).
문제 3. 비슷한 도구 사이에서 맞는 것을 고르기
도구가 많아지면 토큰만 드는 게 아니라 모델이 엉뚱한 도구를 고릅니다. Claude 공식 문서는 "사용 가능한 도구가 30~50개를 넘으면 Claude가 맞는 도구를 고르는 능력이 떨어진다"고 적고, 도구 검색은 요청마다 필요한 3~5개만 불러오기 때문에 수천 개 도구에서도 정확도가 유지된다고 설명합니다(Claude Docs). OpenAI도 한 턴에 처음부터 보이는 함수를 20개 미만으로 두라고 권합니다(강제는 아닌 권장, OpenAI Function calling). Anthropic이 2025년 11월에 공개한 내부 평가에서는 도구 검색을 켜자 Opus 4의 정확도가 49%에서 74%로, Opus 4.5는 79.5%에서 88.1%로 올랐습니다(Anthropic Engineering, Advanced tool use, 2025-11-24). 지금보다 한두 세대 전 모델로 잰 측정이지만 방향은 분명합니다.
그런데 검색도 공짜는 아닙니다. 검색이 엉뚱한 도구를 위로 올리면 모델은 그것을 고릅니다. 앞의 GitHub 도구 1,232개에 Claude 도구 검색의 한 방식이기도 한 키워드 검색(BM25)을 걸고, 정답을 아는 자연어 요청 16개를 넣어 정답이 몇 위에 오는지 봤습니다.
| 요청 (필자 실험, BM25) | 정답 도구 | 정답 순위 | 1위로 나온 도구 |
|---|---|---|---|
| add a label to an issue | issues/add-labels | 2위 | issues/remove-label |
| request reviewers on a pull request | pulls/request-reviewers | 2위 | pulls/remove-requested-reviewers |
| create a release | repos/create-release | 2위 | reactions/create-for-release |
| close an issue | issues/update | 36위 | issues/list-issue-field-values-for-issue |
| delete a branch | git/delete-ref | 40위 | repos/delete-deployment-branch-policy |
| 16개 전체 | 1위 7개, 5위 안 13개 |
눈에 띄는 것은 두 종류의 실패입니다. 첫째, "라벨 붙이기"를 물었는데 "라벨 떼기"가 1위로 나왔습니다. 이름과 설명의 단어가 거의 같아서 키워드로는 반대 동작을 가르지 못합니다. 조회 도구라면 다시 고르면 되지만 쓰기 도구라면 사고입니다. 둘째, 사람의 말과 API 구조가 다를 때입니다. GitHub에서 이슈 닫기는 별도 API가 아니라 이슈 수정(issues/update)에 상태를 넘기는 것이고, 브랜치 삭제는 Git 참조 삭제(git/delete-ref)입니다. 사람은 "닫기", "브랜치"라고 말하지만 API 설명에는 그 말이 앞에 나오지 않아 36위, 40위로 밀렸습니다. 16개 요청은 작은 표본이고 실제 모델은 순위 5위 안의 후보를 다시 읽고 고르므로, 이 표는 정확도 벤치마크가 아니라 실패의 모양을 보여 주는 예시로 봐 주세요.
Uber가 IDL 주석을 그대로 쓰지 않고 LLM으로 "에이전트 친화적" 설명을 다시 쓰는 단계를 넣은 이유가 여기 있습니다. 사람이 쓰는 말이 설명에 들어가야 검색에 걸립니다. 네이버클라우드는 외부에 도구 2개만 노출하고 시맨틱 검색으로 도구를 추리는데, 키워드, 임베딩, 하이브리드를 비교해 임베딩 방식이 가장 정확했다고 밝혔습니다(CIO 코리아). Uber도 8월 글에서 도구 검색이 "도구 라이브러리가 커져도 높은 선택 정확도를 유지한다"고 쓰고 있습니다.
문제 4. 모델이 결과를 다 읽을 필요는 없다
도구 호출의 결과도 컨텍스트에 쌓이고, 쌓인 것은 매 턴 다시 과금됩니다. Uber는 세션 분석 대시보드가 잡아내는 낭비 16가지 중 하나로 "40KB짜리 MCP 응답이 컨텍스트에 남아 이후 턴마다 다시 청구되는 것"을 꼽았습니다. Uber의 해법은 두 가지입니다.
첫째는 Response Projection입니다. GraphQL처럼 필요한 필드만 달라고 하는 호출 방식입니다. 게이트웨이가 도구의 요청 스키마에 필드 하나를 끼워 넣고, 모델이 필요한 필드의 중첩 경로를 배열로 채워 보내면, 게이트웨이가 응답을 그 필드만 남기고 잘라 돌려줍니다. Uber는 절감 수치를 밝히지 않았기에 직접 해 봤습니다. GitHub 저장소 조회 API(GET /repos/modelcontextprotocol/modelcontextprotocol)의 실제 응답은 1,681토큰이었고, 이름, 별 수, 열린 이슈 수, 마지막 푸시 시각, 라이선스 다섯 필드만 남기니 54토큰이 됐습니다. 게이트웨이 쪽 구현은 길지 않습니다. 아래는 그 측정에 쓴 함수입니다.
def project(obj: dict, paths: list[str]) -> dict:
    """응답에서 'license.spdx_id' 같은 점 경로의 필드만 남긴다."""
    out = {}
    for p in paths:
        cur, dst, keys = obj, out, p.split(".")
        for k in keys[:-1]:
            cur = (cur or {}).get(k)
            dst = dst.setdefault(k, {})
        dst[keys[-1]] = (cur or {}).get(keys[-1])
    return out

project(repo, ["full_name", "stargazers_count", "open_issues_count",
               "pushed_at", "license.spdx_id"])
# 1,681토큰 응답이 54토큰으로 (2026-10-13 필자 측정)
둘째는 Code Mode입니다. 코딩 에이전트는 셸에서 일하므로 결과를 컨텍스트에 바로 싣는 대신 파일에 쓰는 편이 낫다는 발상입니다. Uber는 에이전트 작업용 사내 CLI인 aifx에 세 명령을 두었습니다.
aifx mcp list: 쓸 수 있는 MCP 서버를 봅니다.aifx mcp search: 모든 서버에서 도구를 검색합니다.aifx mcp call: 게이트웨이를 거쳐 도구를 호출합니다.
에이전트는 이 명령들을 한 줄로 이어 결과를 파일에 쓰고, 필요한 부분만 grep으로 골라 읽습니다. MCP 서버를 설치할 필요가 없고 MCP 정의가 컨텍스트에 없어도 맞는 도구를 찾습니다. Uber는 Code Mode가 이제 코딩 에이전트에서 MCP 도구를 쓰는 회사 기본값이라고 밝혔습니다(Uber Engineering, Designing MCP Gateway).
효과는 SQL 쿼리에서 잘 보입니다. 기존 방식에서 쿼리 한 번은 요청 제출, 상태 확인 2~5번, 결과 조회로 이뤄지고, 단계마다 모델이 한 턴씩 끼어들어 응답이 모두 컨텍스트에 남습니다. Code Mode에서는 이 반복을 파이썬 루프가 하위 프로세스에서 돌리고 요약만 모델에게 돌려줍니다. Uber가 같은 Claude Code 세션에서 같은 쿼리 5개를 두 방식으로 돌린 결과는 다음과 같습니다.
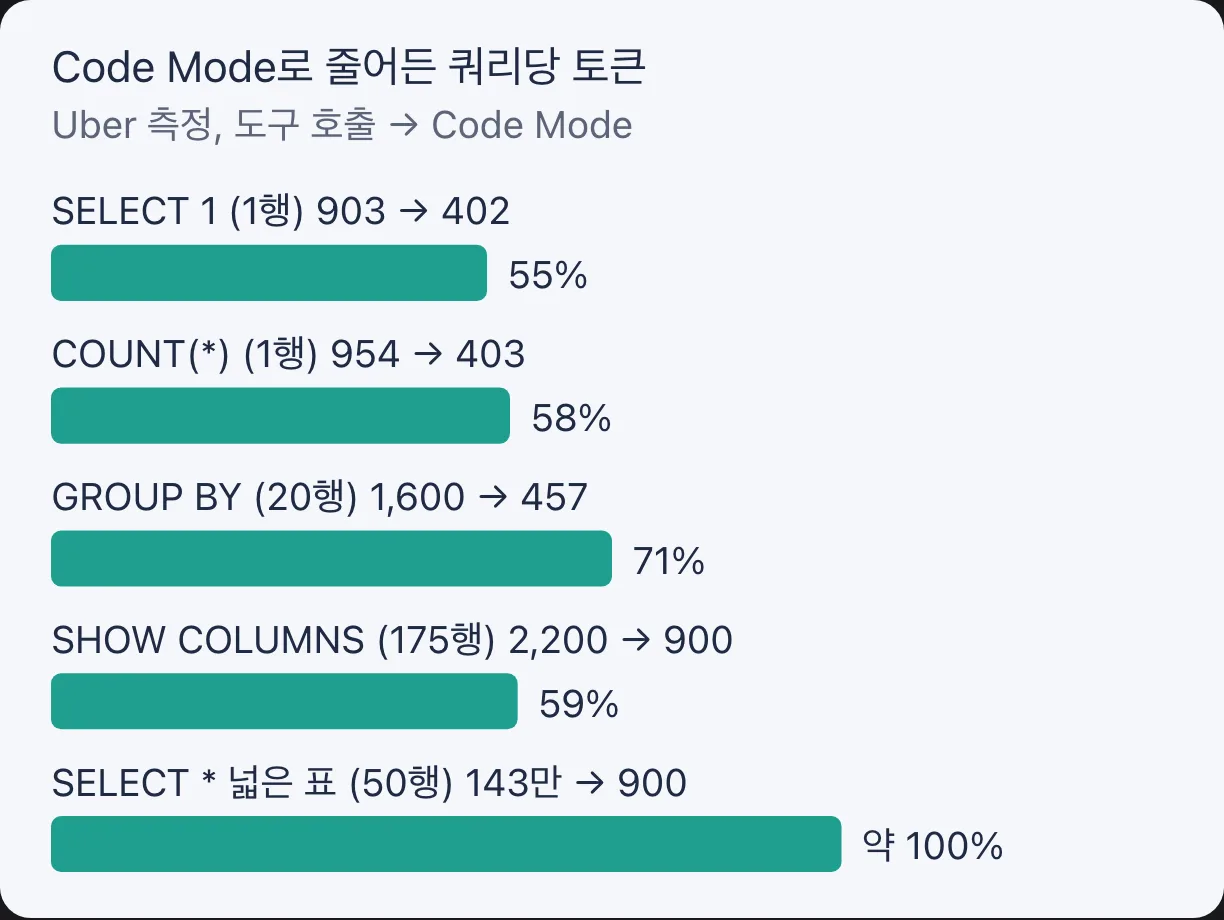
결과가 한 줄인 SELECT 1에서도 55%가 줄었다는 점이 중요합니다. 큰 응답을 피해서가 아니라 모델의 왕복 자체를 없앴기 때문입니다. 마지막 줄처럼 넓은 표를 통째로 읽으면 도구 호출 방식은 143만 토큰을 썼습니다. 같은 작업을 N번 반복하는 대량 작업에서는 N번의 모델 턴이 스크립트 하나가 되어 절감이 90%를 넘는다고 Uber는 밝혔고, 가장 많이 쓰는 MCP 서버용으로 미리 만든 Code Mode 스킬 25개 이상을 기본 경로로 깔아 두었습니다.
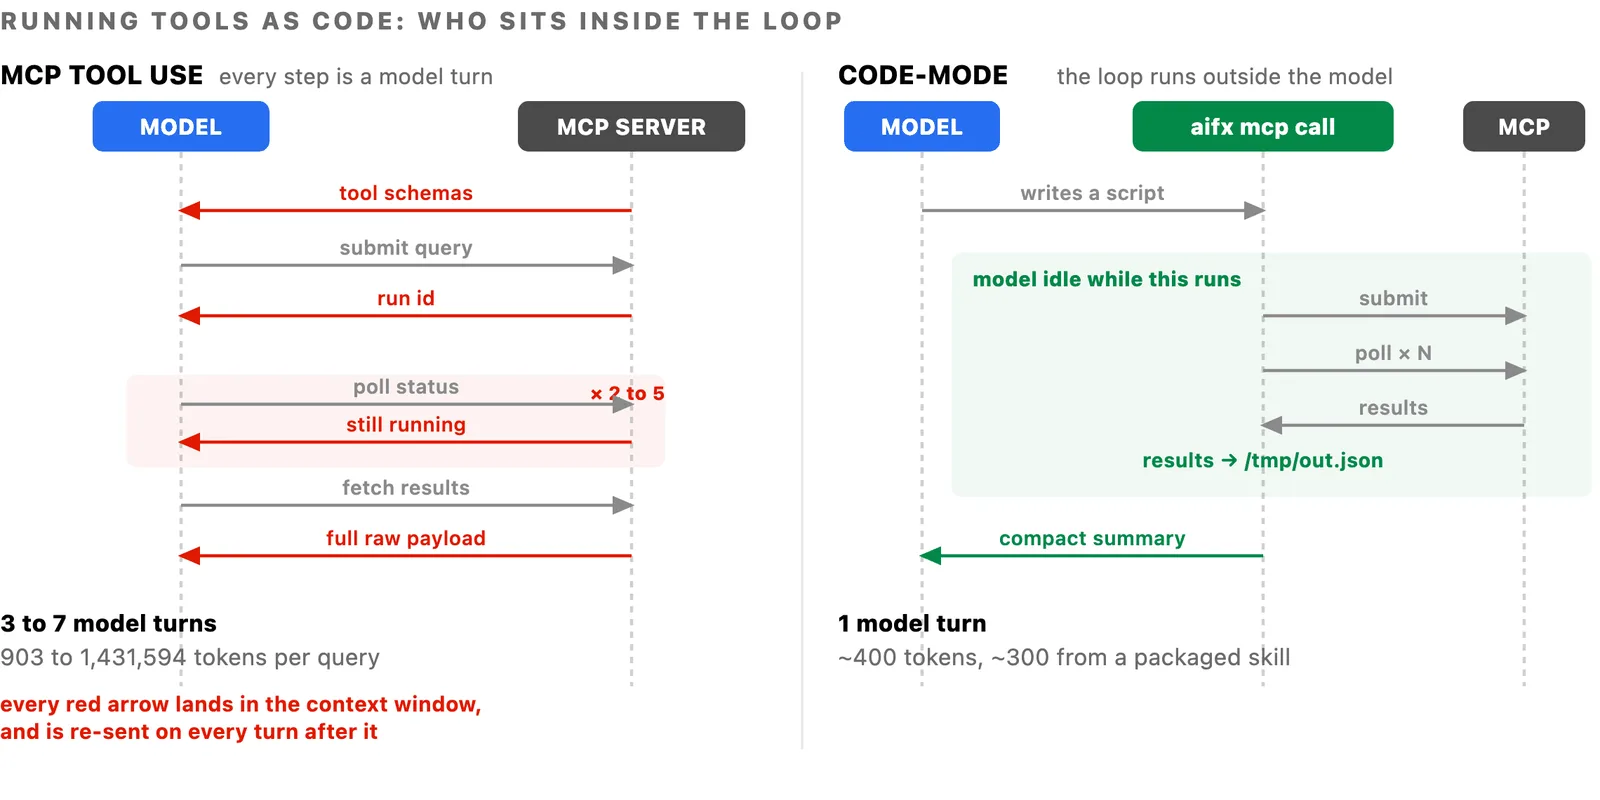
이 방향은 Uber만의 것이 아닙니다. Cloudflare는 2025년 9월 "LLM은 MCP를 직접 호출하는 것보다 MCP를 호출하는 코드를 쓰는 데 더 능숙하다"며 Code Mode를 내놓았고(Cloudflare Blog, 2025-09-26), 2026년 2월에는 엔드포인트 2,500개가 넘는 자사 API를 MCP 도구로 다 노출하면 117만 토큰이지만 Code Mode로는 약 1,000토큰이라고 밝혔습니다(Cloudflare Blog, 2026-02-20). Anthropic도 2025년 11월 도구를 코드로 실행하게 해 한 작업의 토큰을 15만에서 2,000으로(98.7%) 줄인 예를 공개했습니다(Anthropic Engineering, 2025-11-04).
문제 5. 권한, 감사, 개인정보
도구 하나하나가 공격면이 됩니다. Uber는 보안을 도구마다가 아니라 게이트웨이 한곳에서 기본으로 겁니다.
- 도구 단위 인가: Uber의 사내 접근 제어 시스템(Access Control System)으로 호출 주체를 사람, 서비스, 에이전트로 구분하고, 서버 단위 정책을 두되 필요하면 도구 단위로 덮어씁니다.
- 개인정보 마스킹: 모든 도구 응답에서 개인정보와 민감 정보를 기본으로 가립니다. 데이터 평면 그림의 AIGuard 계층입니다.
- 서드파티 토큰: Jira나 Google 같은 외부 MCP 서버를 쓸 때 게이트웨이는 호출자의 사내 토큰을 사내 서드파티 연동 서비스로 넘기고, 그 서비스가 이를 외부 서비스용 토큰으로 교환해 요청을 보냅니다. 게이트웨이는 그 사이에서 인가, 속도 제한, 민감 정보 마스킹을 합니다.
- 쓰기 차단과 기록: AAIF 정리에 따르면 중요 서비스에 대한 쓰기 작업은 막거나 기록하고, 서드파티 MCP는 내부 MCP보다 엄격한 문을 통과해야 합니다.
이것이 왜 게이트웨이의 일인지는 MCP 스펙이 말해 줍니다. 2026년 7월 28일 버전 스펙의 보안 모범 사례는 받은 토큰을 그대로 다른 서버로 넘기는 "토큰 패스스루"를 안티패턴으로 규정하고, MCP 서버는 자신에게 발급되지 않은 토큰을 받아서는 안 된다고 못 박습니다(MCP Security Best Practices). 도구 스펙은 도구 목록이 요청에 담긴 권한에 따라 달라질 수 있다고 허용하고, 감사를 위해 도구 사용을 기록하라고 권합니다(MCP Spec, Tools). 도구 설명 자체도 위험합니다. 사용자에게는 안 보이고 모델에게만 보이는 지시를 설명에 숨기는 "도구 오염(tool poisoning)" 공격이 2025년에 알려졌고, 승인한 뒤에 설명을 바꾸는 수법도 있습니다(Invariant Labs, 2025-04-01). Invariant Labs는 승인한 설명을 해시로 고정해 두는 방법을 권합니다. Uber가 밝힌 차이 승인은 자동 생성한 사내 도구 설명에 대한 것이지만, 설명이 바뀔 때마다 차이를 만들고 소유자가 승인하게 하는 같은 절차를 서드파티 도구에도 걸면 이런 수법을 한곳에서 줄일 수 있다고 필자는 봅니다.
다른 회사와 제품은 어떻게 하나
"기존 API를 도구로 바꾸고, 많은 도구를 검색으로 다루고, 권한과 기록을 한곳에서"라는 뼈대는 대부분의 게이트웨이 제품이 같습니다. 차이는 무엇을 직접 해 주느냐입니다. 2026년 10월 13일에 각 공식 문서를 기준으로 정리했습니다.
| 이름 | 기존 API를 도구로 | 많은 도구 다루기 | 권한과 기록 |
|---|---|---|---|
| Uber MCP Gateway (사내) | IDL(Protobuf, Thrift) 자동 변환, LLM 설명, 기본 비활성 | Omni MCP 4개 도구, CLI 검색, Code Mode | 도구 단위 인가, 개인정보 마스킹 |
| 네이버클라우드 (MCP 데브 서밋 서울 발표) | 평가 기반 MCP 제너레이터 | 도구 2개 노출, 임베딩 검색 | 임시 키, 기존 클라우드 권한 체계 |
| AWS Bedrock AgentCore Gateway | OpenAPI, Smithy, Lambda | 내장 의미 검색 도구 | 인바운드와 아웃바운드 OAuth, 관측과 감사 |
| Azure API Management | 관리 중인 REST 작업을 골라 노출 | 문서에 언급 없음 | APIM 정책, 추적 |
| Kong AI MCP Proxy | OpenAPI 작업을 도구로 | 문서에 언급 없음 | 도구별 ACL, 허용과 거부 모두 감사 로그 |
| IBM ContextForge | REST, gRPC를 가상 서버로 | 가상 서버로 묶기 | JWT, RBAC, OpenTelemetry |
| Docker MCP Gateway | 해당 없음(서버를 컨테이너로 격리) | 대화 중 서버 검색과 추가 | 자격증명 주입, 호출 추적 |
| Cloudflare MCP Server Portals | 해당 없음(여러 서버를 한 주소로) | 승인한 서버만, 이후 Code Mode | Access 정책, 로그 한곳에 |
국내에서는 카카오가 2025년 11월 PlayMCP에 MCP 게이트웨이를 붙여 OAuth 인증과 서킷 브레이커, 캐싱을 플랫폼이 대신 맡게 하겠다고 발표했습니다(11월 말 정식 출시 예정이라는 보도, 전자신문, 2025-11-02). 다만 외부 개발자의 MCP 서버를 모아 주는 공개 플랫폼이라 Uber의 사내 게이트웨이와는 성격이 다릅니다.
표에서 Uber만 가진 것은 "자동 생성은 하되 소유 팀이 켠다"는 운영 절차입니다. 제품은 변환과 프록시를 주지만, 수천 개 도구의 설명을 누가 책임지고 언제 켜는지는 조직이 정해야 합니다. Uber 글의 결론도 같습니다. "가장 어려운 부분은 AI가 아니라 연결 조직(connective tissue), 즉 탐색, 보안, 신뢰성"이라고 썼습니다.
작은 팀이 가져다 쓸 설계 여섯 가지
도구가 수십 개인 팀이 Uber의 게이트웨이를 그대로 만들 필요는 없습니다. 그러나 문제는 규모만 작을 뿐 같은 순서로 옵니다. 지금 적용할 수 있는 순서로 정리했습니다.
- 게이트웨이보다 레지스트리를 먼저 만듭니다. 도구 이름, 소유자, 켜짐 여부, 읽기인지 쓰기인지를 적은 표 하나로 시작해도 됩니다. Uber가 레지스트리에 맡긴 일도 검색, 소유권, 활성화 세 가지입니다.
- 자동 생성한 도구는 꺼 둔 채로 시작합니다. OpenAPI에서 도구를 뽑았다면 설명을 사람의 말로 고친 것만 켭니다. 실험에서 봤듯 "닫기", "브랜치" 같은 사용자의 말이 설명에 없으면 검색에서 밀립니다.
- 조회와 쓰기를 나누고, 쓰기는 이름부터 다르게 짓습니다. "add"와 "remove"가 한 글자 차이로 붙어 있으면 검색도 모델도 헷갈립니다. 되돌리기 어려운 작업은 승인 단계를 둡니다.
- 도구가 10개를 넘고 계속 늘어난다면 검색으로 바꿉니다. Claude 문서는 도구가 10개 이상이거나 도구 정의가 1만 토큰을 넘으면 도구 검색을 쓰라고 권하고, 30~50개부터는 정확도가 떨어진다고 적습니다. Claude는
defer_loading과 도구 검색 도구를, OpenAI는tool_search를 제공합니다. Claude 문서는 자주 쓰는 3~5개는 항상 불러오고 나머지를 미뤄 두라고 권합니다. MCP 서버를 직접 운영한다면 Omni MCP처럼 찾기, 스키마, 호출 몇 개만 노출하는 방법도 있습니다. Claude Code에서 MCP 서버를 연결하고 공유 범위를 정하는 기본은 Claude Code 팁 11가지의 10번 팁에 있습니다. - 큰 응답은 필드를 고르게 하거나 파일로 돌립니다. 응답 프로젝션은 위의 함수 정도면 시작할 수 있고, 반복 조회나 폴링은 모델이 아니라 스크립트가 돌게 합니다(Code Mode, 스킬).
- 토큰을 넘기지 말고 교환하고, 호출은 한곳에서 기록합니다. 사용자 토큰을 외부 MCP 서버에 그대로 전달하지 않고, 누가 어떤 도구를 어떤 입력으로 불렀는지 남기되 로그의 개인정보는 가립니다.
마지막으로 숫자를 잽니다. Uber가 해법을 찾은 것도 세션마다 도구 정의와 응답이 몇 토큰을 차지하는지 재고 나서였습니다. 지금 쓰는 에이전트의 첫 요청에 도구 정의가 몇 토큰 붙는지부터 확인해 보세요.
반론과 이 글의 한계
Uber의 숫자는 Uber가 잰 것입니다. 이 글의 Uber 수치는 모두 Uber 엔지니어링 블로그와 키노트 정리에서 왔고, 독립 검증은 없습니다. 이를 보도한 The Stack 기사도 Uber 블로그를 요약했을 뿐 반론이나 별도 검증은 싣지 않았습니다(The Stack, 2026-09-16). Uber 스스로도 "측정한 비용 절감은 우리 환경에 고유하며 코드베이스, 팀 규모, 워크플로에 따라 다를 수 있다"고 적었습니다. Omni MCP와 Response Projection은 효과 수치가 아예 공개되지 않았습니다. 국내 한 블로그도 이 사례를 소개하며 "MCP만 쓰면 AI 비용이 90% 절약된다는 뜻이 절대 아니다"라고 짚고, 도구가 늘어날수록 얼마나 영리하게 관리하느냐가 비용을 좌우한다는 이야기로 읽었습니다(네이버 블로그 디코드 더 월드).
MCP보다 CLI가 낫다는 반론도 있습니다. 2026년 상반기에는 "MCP는 죽었다, CLI 만세" 같은 글이 해커뉴스에서 크게 논쟁이 됐고(Eric Holmes, 2026-02-28), 실제로 Uber도 코딩 에이전트에서는 MCP 스키마를 싣지 않고 CLI로 호출합니다. 그러나 그 CLI 뒤에는 여전히 게이트웨이가 있습니다. 9월 말 해커뉴스에서 686점을 받은 글은 MCP를 반대하던 팀이 2026년 7월의 무상태(stateless) 스펙 이후 MCP를 코어에 넣은 이야기였고, 댓글에서는 단일 프로토콜이라 모든 서버 앞에 인증 프록시 하나를 둘 수 있다는 점이 MCP의 가치로 꼽혔습니다(Earendil, 2026-09-29; HN 토론). GitHub 블로그도 "스킬이 MCP를 죽였나"라는 질문에 "아니다, 서로 다른 문제를 푼다. MCP는 접근을 주고 스킬은 그 접근을 잘 쓰는 법을 알려 준다"고 답했습니다(GitHub Blog, 2026-09-18). 정리하면 논쟁의 핵심은 MCP냐 CLI냐가 아니라 도구를 어디서 고르고 결과를 어디서 읽느냐이고, Uber는 고르기는 검색으로, 읽기는 파일로 옮겼습니다.
게이트웨이는 비용을 더합니다. 모든 호출이 한곳을 지나므로 그곳이 멈추면 모든 에이전트가 멈추고, 프록시와 변환, 마스킹만큼 지연이 붙습니다. Omni MCP 방식은 도구 하나를 쓰기까지 찾기, 스키마 조회, 호출로 왕복이 늘어납니다. 도구가 열 개 안팎인 팀이라면 게이트웨이보다 도구를 줄이는 편이 빠릅니다.
필자 실험의 한계. 토큰 수는 OpenAI의 o200k 토크나이저로 센 추정치이고, GitHub API를 단순 규칙으로 변환했기 때문에 LLM이 다시 쓴 Uber의 설명과는 길이가 다릅니다. 도구 검색 실험은 요청 16개의 작은 표본이고, 검색 대상 설명을 300자로 잘랐으며, 실제 모델이 검색 결과를 읽고 고르는 단계는 넣지 않았습니다.
자주 묻는 질문
MCP 게이트웨이와 일반 API 게이트웨이는 무엇이 다른가요?
API 게이트웨이는 사람이 짠 코드가 정해진 API를 부르는 길을 관리하고, MCP 게이트웨이는 모델이 스스로 도구를 고르는 길을 관리합니다. 그래서 인증, 속도 제한, 로깅 같은 공통 기능 외에 도구 설명의 품질, 도구 검색, 응답 크기 줄이기, 도구 단위 권한처럼 모델의 판단을 돕고 제한하는 기능이 더 붙습니다. Kong이나 Azure API Management처럼 기존 API 게이트웨이가 MCP 기능을 덧붙이는 경우도 많습니다.
도구가 몇 개부터 문제가 되나요?
Claude 문서는 30~50개를 넘으면 도구 선택 정확도가 떨어진다고 하고, 도구가 10개 이상이거나 도구 정의가 1만 토큰을 넘으면 도구 검색을 쓰라고 권합니다. OpenAI는 처음부터 보이는 함수를 20개 미만으로 두라고 권합니다. Uber가 든 업무용 SaaS 서버 하나가 도구 49개, 약 2만 2천 토큰이었으니 서버 하나만 붙여도 두 기준을 모두 넘을 수 있습니다.
직접 만들어야 하나요, 제품을 쓰면 되나요?
변환과 프록시, 검색은 AWS AgentCore Gateway, Kong, IBM ContextForge 같은 제품과 오픈소스가 이미 제공합니다. 직접 만들어야 하는 것은 Uber가 운영 절차로 푼 부분, 즉 누가 도구 설명을 책임지고 언제 켜며 바뀔 때 누가 승인하는지입니다. 작은 팀은 제품이나 클라이언트의 도구 검색 기능을 쓰고 레지스트리 표와 승인 규칙만 직접 두는 편이 현실적입니다.
2026년 7월의 MCP 스펙 변경은 게이트웨이에 어떤 영향을 주나요?
2026-07-28 스펙은 세션과 초기 핸드셰이크를 없애 모든 요청이 스스로 완결되게 했고, Mcp-Method, Mcp-Name 헤더를 필수로 넣었습니다. MCP 공식 블로그는 이제 요청이 평범한 라운드 로빈 로드밸런서 뒤의 어느 서버로 가도 되고, 게이트웨이가 본문을 열지 않고 헤더만 보고 라우팅과 인가를 할 수 있다고 설명합니다(MCP Blog, 2026-07-28). Uber처럼 수백 개 서버를 한 프록시로 다루는 구조에 유리한 변화입니다.
Omni MCP처럼 도구를 4개만 노출하면 단점은 없나요?
있습니다. 도구 하나를 쓰기까지 서버 찾기, 도구 찾기, 스키마 조회, 호출로 왕복이 여러 번 생기고, 검색이 엉뚱한 서버를 고르면 그만큼 돌아갑니다. 그래서 Claude 문서는 자주 쓰는 3~5개 도구는 항상 불러 두라고 권하고, Uber도 자주 쓰는 서버에는 미리 만든 Code Mode 스킬을 둡니다.
마치며
Uber MCP 게이트웨이를 한 줄로 줄이면 "도구는 자동으로 많이 만들되, 모델에게는 적게 보여 주고 적게 읽게 하며, 켜는 결정은 사람이 한다"입니다.
- 레지스트리(제어 평면)와 프록시(데이터 평면)로 나눠, 기존 API를 백엔드 수정 없이 도구로 바꿉니다.
- 자동 생성한 도구는 기본 비활성이고, 설명이 바뀔 때마다 소유자가 차이를 보고 승인합니다.
- 도구 정의는 Omni MCP와 검색, CLI로 컨텍스트 밖에 두고, 응답은 프로젝션과 Code Mode로 필요한 만큼만 읽습니다.
- 도구 단위 인가와 개인정보 마스킹은 게이트웨이 한곳에서 모든 도구에 기본으로 걸고, 서드파티 서버에는 토큰을 교환해 씁니다.
도구가 열 개든 오천 개든 순서는 같습니다. 목록과 소유자를 정하고, 보여 주는 도구를 줄이고, 읽는 결과를 줄이세요. Uber가 Omni MCP나 응답 프로젝션의 효과 수치를 공개하면 이 글에 더하겠습니다.
출처
- Uber Engineering, Designing MCP Gateway, 2026-10-01: uber.com/in/en/blog/designing-mcp-gateway
- AAIF Blog, 2026-05-14: aaif.io/blog/how-uber-runs-60000-ai-agent-tasks-per-week-with-mcp
- Uber Engineering, Running a Software Factory Efficiently at Uber Scale, 2026-08-27: uber.com/us/en/blog/efficient-software-factory
- CIO 코리아, 2026-08-18: cio.com/article/4210824
- github/rest-api-description: github.com/github/rest-api-description
- 토스 기술 블로그, 2025-10-27: toss.tech/article/internal-mcp-server
- Claude Docs, Tool search tool: platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- Cloudflare Blog, 2026-04-14: blog.cloudflare.com/enterprise-mcp
- OpenAI Function calling: developers.openai.com/api/docs/guides/function-calling
- Anthropic Engineering, Advanced tool use, 2025-11-24: anthropic.com/engineering/advanced-tool-use
- Cloudflare Blog, 2025-09-26: blog.cloudflare.com/code-mode
- Cloudflare Blog, 2026-02-20: blog.cloudflare.com/code-mode-mcp
- Anthropic Engineering, 2025-11-04: anthropic.com/engineering/code-execution-with-mcp
- MCP Security Best Practices: modelcontextprotocol.io/docs/2026-07-28/tutorials/security/security_bes…
- MCP Spec, Tools: modelcontextprotocol.io/specification/2026-07-28/server/tools
- Invariant Labs, 2025-04-01: invariantlabs.ai/blog/mcp-security-notification-tool-poisoning-attacks
- AWS Bedrock AgentCore Gateway: docs.aws.amazon.com/bedrock-agentcore/latest/devguide/gateway-using-mcp…
- Azure API Management: learn.microsoft.com/en-us/azure/api-management/export-rest-mcp-server
- Kong AI MCP Proxy: developer.konghq.com/plugins/ai-mcp-proxy
- IBM ContextForge: github.com/IBM/mcp-context-forge
- Docker MCP Gateway: docs.docker.com/ai/mcp-catalog-and-toolkit/dynamic-mcp
- Cloudflare MCP Server Portals: blog.cloudflare.com/zero-trust-mcp-server-portals
- 전자신문, 2025-11-02: v.daum.net/v/tFPBqo71E1
- The Stack, 2026-09-16: thestack.technology/1-000-mcp-servers-zero-schema-bloat-ubers-assault-o…
- 네이버 블로그 디코드 더 월드: blog.naver.com/suhoz/224415626544
- Eric Holmes, 2026-02-28: ejholmes.github.io/2026/02/28/mcp-is-dead-long-live-the-cli.html
- Earendil, 2026-09-29: earendil.com/posts/you-said-no-mcp
- HN 토론: news.ycombinator.com/item?id=49906637
- GitHub Blog, 2026-09-18: github.blog/ai-and-ml/should-you-read-the-code-is-rag-dead-and-did-skil…
- MCP Blog, 2026-07-28: blog.modelcontextprotocol.io/posts/2026-07-28