핵심 요약
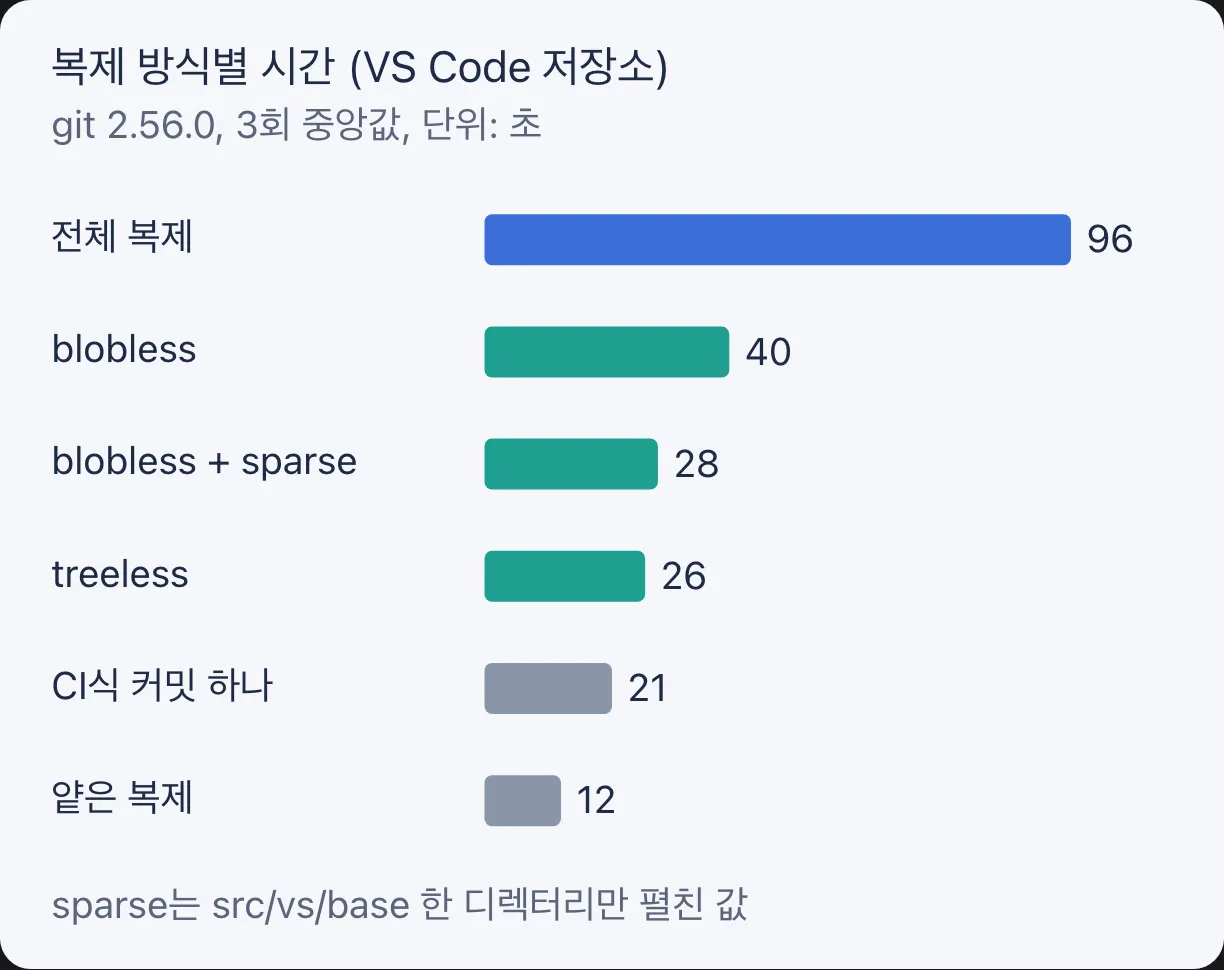
- 복제 시간은 방식에 따라 8배 가까이 차이 납니다. git 2.56으로 VS Code 저장소(커밋 약 16만 9천 개)를 세 번씩 받아 중앙값을 보면 전체 복제 96초, 부분 복제(blobless) 40초, 트리까지 뺀 부분 복제(treeless) 26초, 얕은 복제(
--depth=1) 12초였습니다..git용량은 1.6GB에서 84MB까지 줄었습니다.- 빨리 받은 만큼 나중에 치릅니다. 같은 파일의
git blame이 전체 복제에서는 2.1초, blobless에서는 첫 실행에 120초 걸렸습니다. treeless에서는git log -- 파일과blame이 15분 안에 끝나지 않았고, 얕은 복제에서는 이력 자체가 없어 blame이 제 역할을 못 합니다.- blobless 복제의 blame 문제는
git backfill이 풉니다. git 2.49에 들어온 이 명령으로 sparse 범위의 파일 내용을 20초에 묶어 받자, 120초 안팎 걸리던 첫 blame이 1.4초가 됐습니다.- 에이전트를 여러 개 돌린다면 sparse-checkout과 worktree 조합이 가장 큰 차이를 냅니다. 필요한 디렉터리만 펼친 blobless 저장소에서 worktree 하나는 0.2초, 17MB였고, 전체 복제에서는 3.2초, 351MB였습니다. 다섯 개면 86MB와 1.7GB입니다.
- CI는 이미 얕은 복제를 쓰고 있을 가능성이 큽니다. GitHub Actions의
actions/checkout은 기본으로 커밋 하나만 받고, GitLab은 새 프로젝트의 기본 깊이가 20입니다. 이력이 필요한 작업만 골라 blobless나fetch-depth: 0으로 바꾸는 것이 출발점입니다.
목차
- 왜 지금 복제 방식을 다시 봐야 하나
- 네 가지 복제는 무엇을 빼고 받나
- 복제 시간과 용량: 96초에서 12초까지
- 빨리 받은 값은 나중에 치른다: blame, log, 옛 커밋
- git backfill로 blobless의 약점 메우기
- 에이전트 여러 개를 돌릴 때: sparse-checkout과 worktree
- CI 설정: GitHub Actions와 GitLab의 기본값
- 상황별로 무엇을 쓸까
- 출처
왜 지금 복제 방식을 다시 봐야 하나
에이전트가 코드를 쓰면 저장소를 받는 횟수가 사람 기준보다 훨씬 많아지기 때문입니다. Anthropic은 2026년 10월 13일 엔지니어링 블로그에서 사내 모노레포를 git에서 자체 버전 관리 시스템 Scion으로 옮긴 과정을 공개했습니다(Anthropic). 이 회사는 CI에서만 하루 약 2,500만 번 코드를 체크아웃한다고 밝혔고, 저장소 작업 사본은 압축해도 25GB가 넘습니다. 저자는 해커 뉴스 답글에서 체크아웃이 머지보다 훨씬 많은 이유를 "Each test shard we run in parallel needs to check out the code"(병렬로 도는 테스트 조각마다 코드를 체크아웃해야 한다)라고 설명했습니다(HN 답글).
눈여겨볼 대목은 Anthropic이 git을 떠나기 전에 무엇을 써 봤는가입니다. 원문은 얕은 복제(shallow clone), sparse checkout, promisor remote(부분 복제), 사내 git 미러, 블롭 저장소에 둔 저장소 스냅숏(seed)을 모두 썼고, 가장 많을 때는 사내 git 미러를 수백 대 돌렸다고 밝혔습니다. 그래도 머지 속도가 빨라지자 스냅숏이 main에서 점점 멀어졌고, 부분 복제에서 diff나 blame 같은 이력 작업을 살려 두는 데 갈수록 손이 많이 갔다고 했습니다.
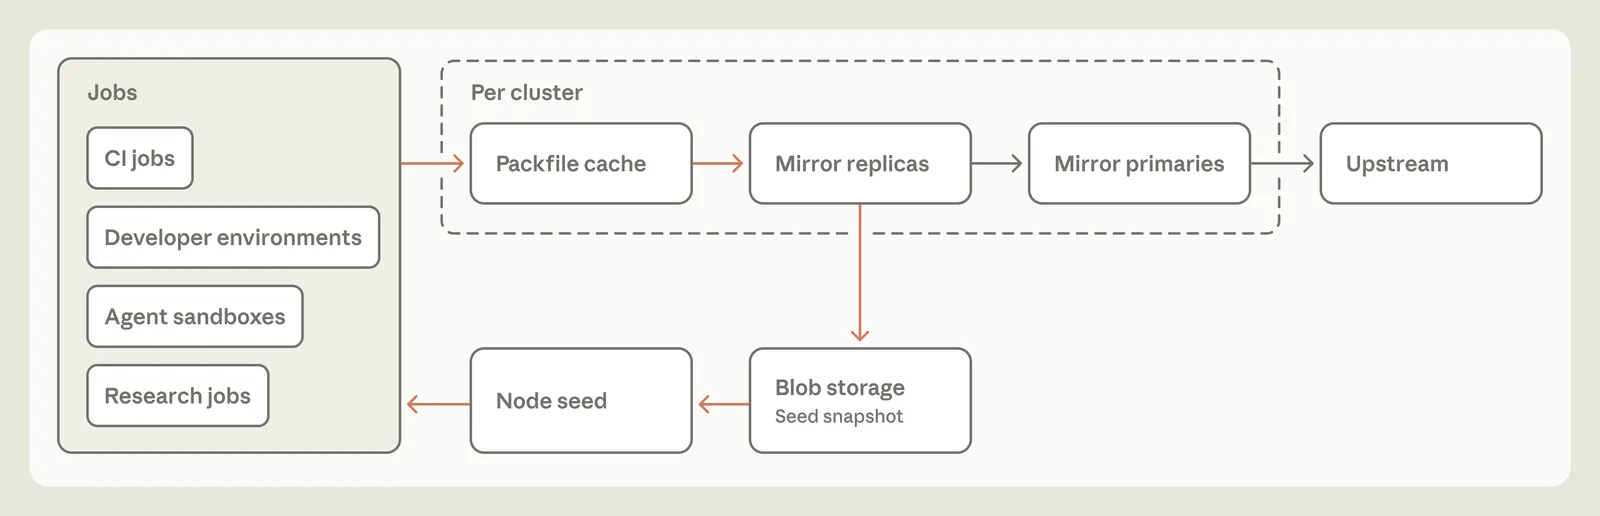
대부분의 팀은 Anthropic 규모가 아닙니다. Scion이 왜 나왔고 무엇이 과장됐는지는 Anthropic이 git을 버리고 Scion을 만든 이유에서 따로 정리했습니다. 이 글은 그 반대편에서 출발합니다. Anthropic이 한계를 본 git의 기능들이 보통 크기의 큰 저장소에서는 얼마의 시간과 용량을 아껴 주고, 대신 무엇을 잃게 하는지 직접 재 봤습니다.
대상은 GitHub의 microsoft/vscode 저장소입니다. GitHub API가 밝힌 저장소 크기는 약 1.5GB이고(GitHub API, 2026-10-22 조회), 필자가 받은 복제본에서 세어 보니 main 브랜치 커밋은 168,669개, 작업 사본의 파일은 21,079개였습니다. 모노레포라 부를 만큼 크지는 않지만, 필자가 보기에는 오래 운영한 제품 저장소가 흔히 닿는 크기입니다. 측정은 2026년 10월 22일 오전 서울에서 M1 Max 맥북(macOS 14.6)과 git 2.56.0(9월 28일 출시)으로 했고, 복제는 방식마다 세 번 받아 중앙값을 썼습니다. 집과 사무실 인터넷 속도에 따라 절대값은 달라지니, 방식 사이의 비율을 보는 편이 맞습니다.
네 가지 복제는 무엇을 빼고 받나
git 저장소는 커밋, 트리(디렉터리 목록), 블롭(파일 내용) 세 종류의 객체로 이뤄지고, 복제 방식은 이 중 무엇을 미리 받지 않을지를 고르는 일입니다. GitHub의 Derrick Stolee가 2020년에 쓴 글의 그림이 차이를 가장 잘 보여 줍니다.
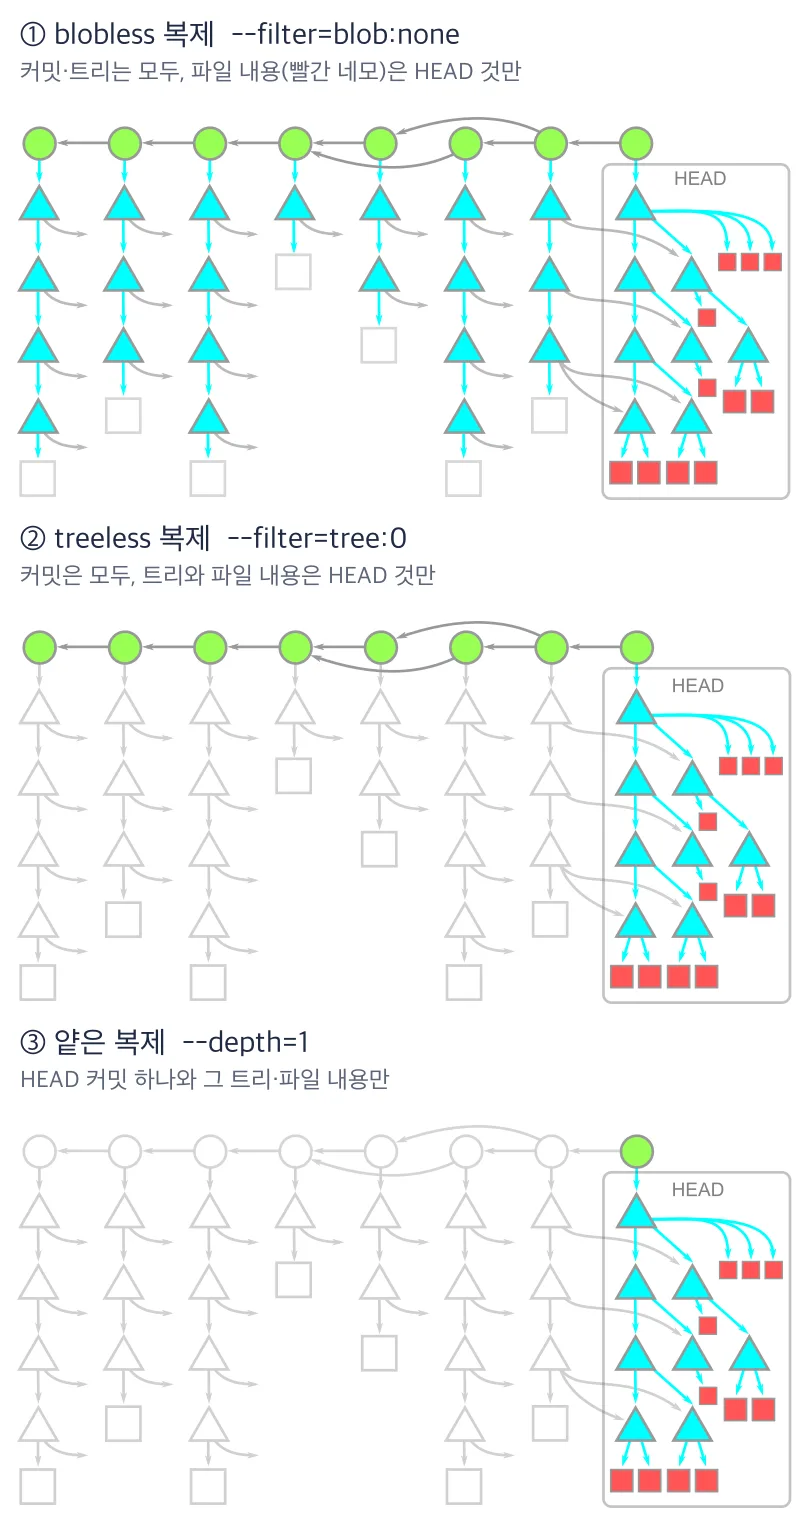
- 전체 복제(
git clone)는 모든 커밋, 트리, 블롭을 받습니다. 오프라인에서도 어떤 이력이든 볼 수 있지만 가장 무겁습니다. - blobless 복제(
--filter=blob:none)는 커밋과 트리를 모두 받고, 파일 내용은 지금 체크아웃할 것만 받습니다. 예전 파일 내용이 필요해지면 그때 서버에서 받아 옵니다. - treeless 복제(
--filter=tree:0)는 커밋만 모두 받고, 트리와 파일 내용은 지금 것만 받습니다. - 얕은 복제(
--depth=1)는 최신 커밋 하나와 그 내용만 받습니다. 이전 이력은 아예 없습니다.
2번과 3번을 부분 복제(partial clone)라고 부르고, 빠진 객체를 나중에 채워 주는 원격 저장소를 promisor remote라고 합니다. 부분 복제에는 전제가 하나 있습니다. git 공식 문서는 "Use of partial clone requires that the user be online"(부분 복제를 쓰려면 사용자가 온라인이어야 한다)이라고 쓰고, 한계로 "Dynamic object fetching tends to be slow as objects are fetched one at a time"(빠진 객체를 그때그때 받는 일은 객체를 하나씩 받기 때문에 느린 편이다)을 꼽습니다(git 문서: partial clone). 뒤에서 잴 blame의 비용이 바로 이 문장에서 나옵니다.
얕은 복제와 부분 복제는 서로 다른 축입니다. 얕은 복제는 커밋의 범위를 줄이고, 부분 복제는 그 범위 안에서 트리와 블롭을 줄입니다. 여기에 sparse-checkout을 더하면 작업 사본에 펼칠 디렉터리까지 고를 수 있습니다. sparse-checkout은 받는 객체가 아니라 디스크에 꺼내 놓는 파일을 줄이는 기능이라, blobless 복제와 함께 쓸 때 효과가 큽니다.
복제 시간과 용량: 96초에서 12초까지
같은 저장소라도 받는 방식에 따라 복제 시간은 약 8배, .git 용량은 약 19배 차이 났습니다. 아래 표와 그래프는 git 2.56.0으로 각 방식을 세 번씩 받아 중앙값을 낸 결과입니다. "CI식 커밋 하나 받기"는 빈 저장소를 만들고 git fetch --depth=1 origin <커밋> 뒤 체크아웃하는 방식으로, GitHub Actions의 actions/checkout이 기본으로 하는 일과 같은 흐름입니다.
| 방식 | 복제 시간 | .git |
디스크 전체 | 펼친 파일 |
|---|---|---|---|---|
| 전체 복제 | 96초 | 1.6GB | 1.9GB | 21,079개 |
| blobless | 40초 | 459MB | 809MB | 21,079개 |
| blobless + sparse | 28초 | 368MB | 385MB | 611개 |
| treeless | 26초 | 217MB | 568MB | 21,079개 |
| 얕은 복제 | 12초 | 84MB | 435MB | 21,079개 |
| CI식 커밋 하나 | 21초 (16~32초) | 85MB | 435MB | 21,079개 |
clone 방식 가운데서는 전체 복제만 --no-tags로 받았고 나머지는 기본값(태그 포함)이라, 비교 조건은 전체 복제에 조금 유리합니다. 그래도 표에서 두 가지가 눈에 띕니다. 첫째, 복제 시간의 대부분은 이력의 파일 내용을 받는 데 씁니다. 파일 내용만 빼도(blobless) 96초가 40초로, .git은 1.6GB가 459MB로 줄었습니다. 둘째, 작업 사본 자체(약 351MB)는 어느 방식이든 거의 같습니다. sparse-checkout으로 한 디렉터리만 펼친 경우에만 파일이 611개로 줄어 디스크 전체가 385MB가 됐습니다.
같은 측정을 맥에 기본으로 깔린 git 2.39.5(Apple Git-154)로도 한 번 해 봤습니다. 전체 복제 90.5초, blobless 51.1초, treeless 22.7초, 얕은 복제 10.8초로 순서는 같았고 비율도 비슷했습니다. blobless만 51초로 차이가 컸는데, 버전보다 그 시점의 네트워크 차이로 보입니다.
빨리 받은 값은 나중에 치른다: blame, log, 옛 커밋
복제가 빨랐던 방식일수록 이력을 묻는 명령이 느려지거나 아예 답을 못 합니다. 복제를 마친 뒤 같은 파일(src/vs/base/common/strings.ts, main에서 이 파일을 바꾼 커밋 208개)로 자주 쓰는 명령을 돌렸습니다. 각 명령은 한 번씩 돌렸고, 15분(900초)이 지나면 멈췄습니다.
| 명령 | 전체 복제 | blobless | treeless | 얕은 복제 |
|---|---|---|---|---|
| status 첫 실행 | 0.75초 | 2.1초 | 2.2초 | 0.99초 |
| log -- 파일 | 3.8초 | 2.3초 | 15분 넘음 | 0.03초 (커밋 1개) |
| blame 첫 실행 | 2.1초 | 120초 | 15분 넘음 | 0.02초 (이력 없음) |
| blame 두 번째 | 2.1초 | 1.7초 | 15분 넘음 | 0.02초 |
| HEAD~3000 체크아웃 | 1.9초 | 5.2초 | 15초 | 불가 |
표에 없는 blobless + sparse 구성은 blame에서 blobless와 같은 경향(첫 실행 122초, 두 번째 1.4초)을 보였고, log는 2.4초였습니다. 펼친 파일이 611개뿐이라 status 첫 실행(0.24초)과 옛 커밋 체크아웃(1.1초)은 오히려 가장 빨랐습니다.
blobless에서 blame 첫 실행이 120초 걸린 이유는 앞의 문서 문장 그대로입니다. blame은 파일의 예전 내용을 커밋마다 비교해야 하는데, blobless 복제에는 예전 파일 내용이 없습니다. git은 빠진 내용을 만날 때마다 서버에 하나씩 요청하고, 이 파일을 바꾼 커밋이 208개이니 요청도 그만큼 쌓입니다(필자 추정). git backfill 문서도 같은 상황을 "commands that compute blob diffs, such as git blame, become very slow as they download the missing blobs in single-blob requests"(git blame처럼 블롭 차이를 계산하는 명령은 빠진 블롭을 하나씩 요청해 받느라 매우 느려진다)라고 적었습니다(git 문서: git-backfill). 한 번 받은 내용은 남기 때문에 두 번째 blame은 1.7초로 전체 복제(2.1초)와 비슷해졌습니다. git 2.39.5로 잰 첫 blame은 77.9초였으니, 이 값은 그날의 네트워크에 따라 크게 흔들립니다.
treeless는 이력 작업에서 사실상 쓸 수 없었습니다. git log -- 파일처럼 경로를 따라가는 명령은 커밋마다 그 시점의 트리를 봐야 하는데, treeless 복제에는 예전 트리가 없어 커밋마다 트리를 받아 옵니다. 15분을 기다려도 log와 blame 모두 끝나지 않았고, git 2.39.5로 돌린 blame도 7분 넘게 걸려 중단했습니다. GitHub도 이 방식을 두고 "We strongly recommend that developers do not use treeless clones for their daily work"(개발자가 일상 작업에 treeless 복제를 쓰지 않기를 강하게 권한다)라고 했습니다(GitHub 블로그). treeless는 빌드 한 번 하고 버리는 CI용입니다.
얕은 복제는 빠르지만 답이 틀립니다. log가 0.03초 만에 끝난 것은 보여 줄 커밋이 하나뿐이기 때문입니다. 얕은 복제에서 같은 파일을 blame하자 1,424줄 전부가 받아 온 커밋 하나(^070abe7c, 앞의 ^는 이력의 경계라는 표시)로 나왔습니다. 옛 커밋으로 체크아웃하는 것은 아예 불가능합니다. 같은 GitHub 글은 "we do not recommend shallow clones except for builds that delete the repository immediately afterwards"(빌드 뒤 저장소를 바로 지우는 경우가 아니면 얕은 복제를 권하지 않는다)라고 썼고, 얕은 복제에서 다시 fetch하면 서버 부담이 커진다고 경고했습니다.
정리하면 복제 단계에서 아낀 시간은 사라지지 않고, 이력을 묻는 순간으로 미뤄질 뿐입니다. Anthropic이 원문에서 부분 복제로 diff와 blame을 살려 두는 데 손이 많이 갔다고 한 것도 이 문제입니다. 국내에서도 다른 저장소(Astro)로 같은 경향, 곧 부분 복제의 첫 blame이 오래 걸리고 얕은 복제의 blame이 커밋 하나로 뭉치는 현상을 직접 확인한 글이 있습니다(네이버 블로그 ksj0073). 다만 blobless의 경우에는 이 비용을 미리, 묶어서 치르는 방법이 있습니다.
git backfill로 blobless의 약점 메우기
git backfill은 blobless 복제에서 빠진 파일 내용을 묶어서 한꺼번에 받아 두는 명령입니다. git 2.49(2025년 3월)에 들어왔고 아직 실험 기능으로 표시돼 있습니다. GitHub는 git 2.49 소개 글에서 이 명령이 같은 경로에 있는 객체를 묶어 요청해 서버가 델타 압축을 훨씬 잘할 수 있다고 설명했습니다(GitHub 블로그: Highlights from Git 2.49). sparse-checkout이 켜져 있으면 지금 펼친 디렉터리에 해당하는 파일만 받습니다.
새로 받은 blobless 저장소에 src/vs/base만 펼친 뒤 git backfill을 돌렸습니다. 20초가 걸렸고 .git이 365MB에서 528MB로 162MB 늘었습니다. 그다음 같은 파일의 blame은 첫 실행부터 1.4초였습니다. 복제와 sparse 설정, backfill까지 합쳐 51초에 .git 528MB로, 전체 복제(96초, 1.6GB)보다 빠르고 가벼우면서 내가 일하는 디렉터리의 blame은 바로 쓸 수 있는 상태가 됩니다.
| 순서 | 시간 | .git 용량 |
이후 blame |
|---|---|---|---|
blobless + sparse 복제 (src/vs/base) |
31초 | 365MB | 120초 안팎 |
git backfill (sparse 범위만) |
20초 | 528MB | 1.4초 |
참고: blobless 전체에 git backfill |
46초 + 140초 | 1.6GB | 1.6초 |
| 참고: 전체 복제 | 96초 | 1.6GB | 2.1초 |
backfill 실험은 앞의 세 번과 따로 한 번 새로 받아 잰 값이라, 복제 시간과 용량이 앞 표의 중앙값(blobless + sparse 28초·368MB, blobless 40초)과 조금 다릅니다. "120초 안팎"은 앞 측정에서 같은 구성의 첫 blame이 122초였던 값입니다.
sparse 없이 저장소 전체에 backfill을 돌리면 이야기가 달라집니다. blobless 복제 46초에 backfill 140초가 더 걸렸고, .git은 1.6GB로 전체 복제와 같아졌습니다. GitHub도 "running git backfill immediately after cloning a repository with --filter=blob:none doesn't bring much benefit, since it would have been more convenient to simply clone the repository without an object filter enabled in the first place"(blobless로 복제하자마자 backfill을 돌리는 것은 큰 이득이 없다. 처음부터 필터 없이 복제하는 편이 더 편했을 것이다)라고 썼습니다. backfill은 sparse 범위와 함께, 또는 복제 뒤 시간이 날 때 나눠 받는 용도로 쓰는 것이 맞습니다.
명령으로는 다음과 같습니다.
# 1. 커밋과 트리만 받고, 최상위 파일만 펼친다
git clone --filter=blob:none --sparse https://github.com/microsoft/vscode.git
cd vscode

# 2. 내가 일할 디렉터리만 펼친다 (cone 모드)
git sparse-checkout set --cone src/vs/base

# 3. 펼친 범위의 옛 파일 내용을 묶어서 미리 받는다 (git 2.49 이상)
git backfill
에이전트 여러 개를 돌릴 때: sparse-checkout과 worktree
코딩 에이전트를 여러 개 동시에 돌린다면 복제 방식보다 작업 사본을 몇 벌 만드느냐가 더 큰 비용입니다. 에이전트마다 서로 다른 브랜치에서 일하게 하려면 git worktree add로 작업 폴더를 따로 만드는 것이 보통입니다. worktree는 .git 객체를 공유하고 작업 사본만 새로 펼치므로, 펼칠 파일 수가 곧 비용입니다. Claude Code로 여러 작업을 동시에 돌리는 방법은 Claude Code 팁 11가지에서 worktree를 중심으로 정리했습니다.
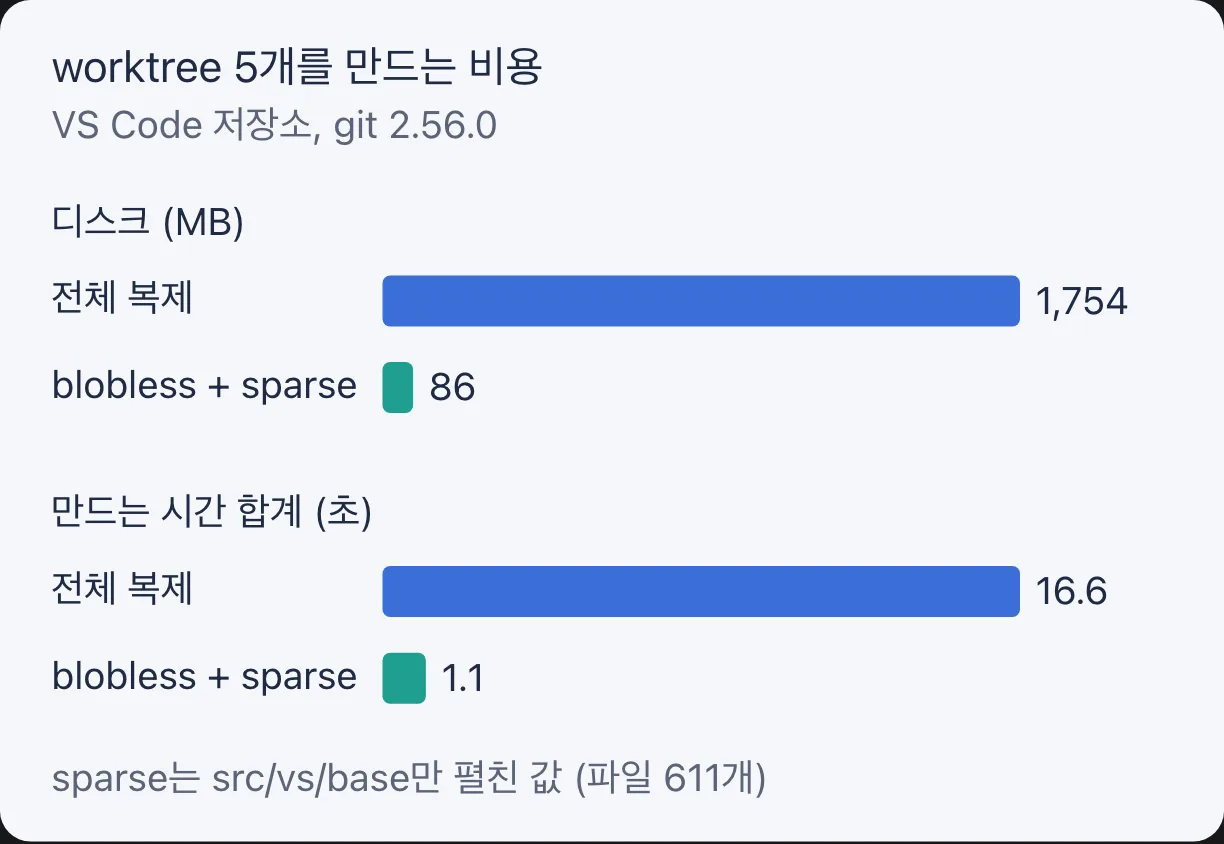
git worktree add로 작업 폴더를 다섯 개 만들 때 든 디스크와 시간입니다. 전체 복제의 worktree는 하나에 351MB, 3.2초 안팎이었고, sparse-checkout을 켠 blobless 저장소의 worktree는 하나에 17MB, 0.2초 안팎이었습니다. 출처: 필자 측정전체 복제에서 worktree 하나는 3.2초, 351MB(파일 21,079개)가 들었습니다. sparse-checkout을 켠 blobless 저장소에서 만든 worktree는 펼칠 범위 설정을 그대로 물려받아 0.2초, 17MB(파일 611개)였습니다. 에이전트 다섯 개를 띄운다면 1.7GB와 86MB의 차이이고, 스무 개라면 6.9GB와 346MB로 벌어집니다. 다만 sparse 범위 밖의 파일은 작업 폴더에 없으므로, 빌드나 테스트에 필요한 디렉터리를 cone에 함께 넣어야 합니다.
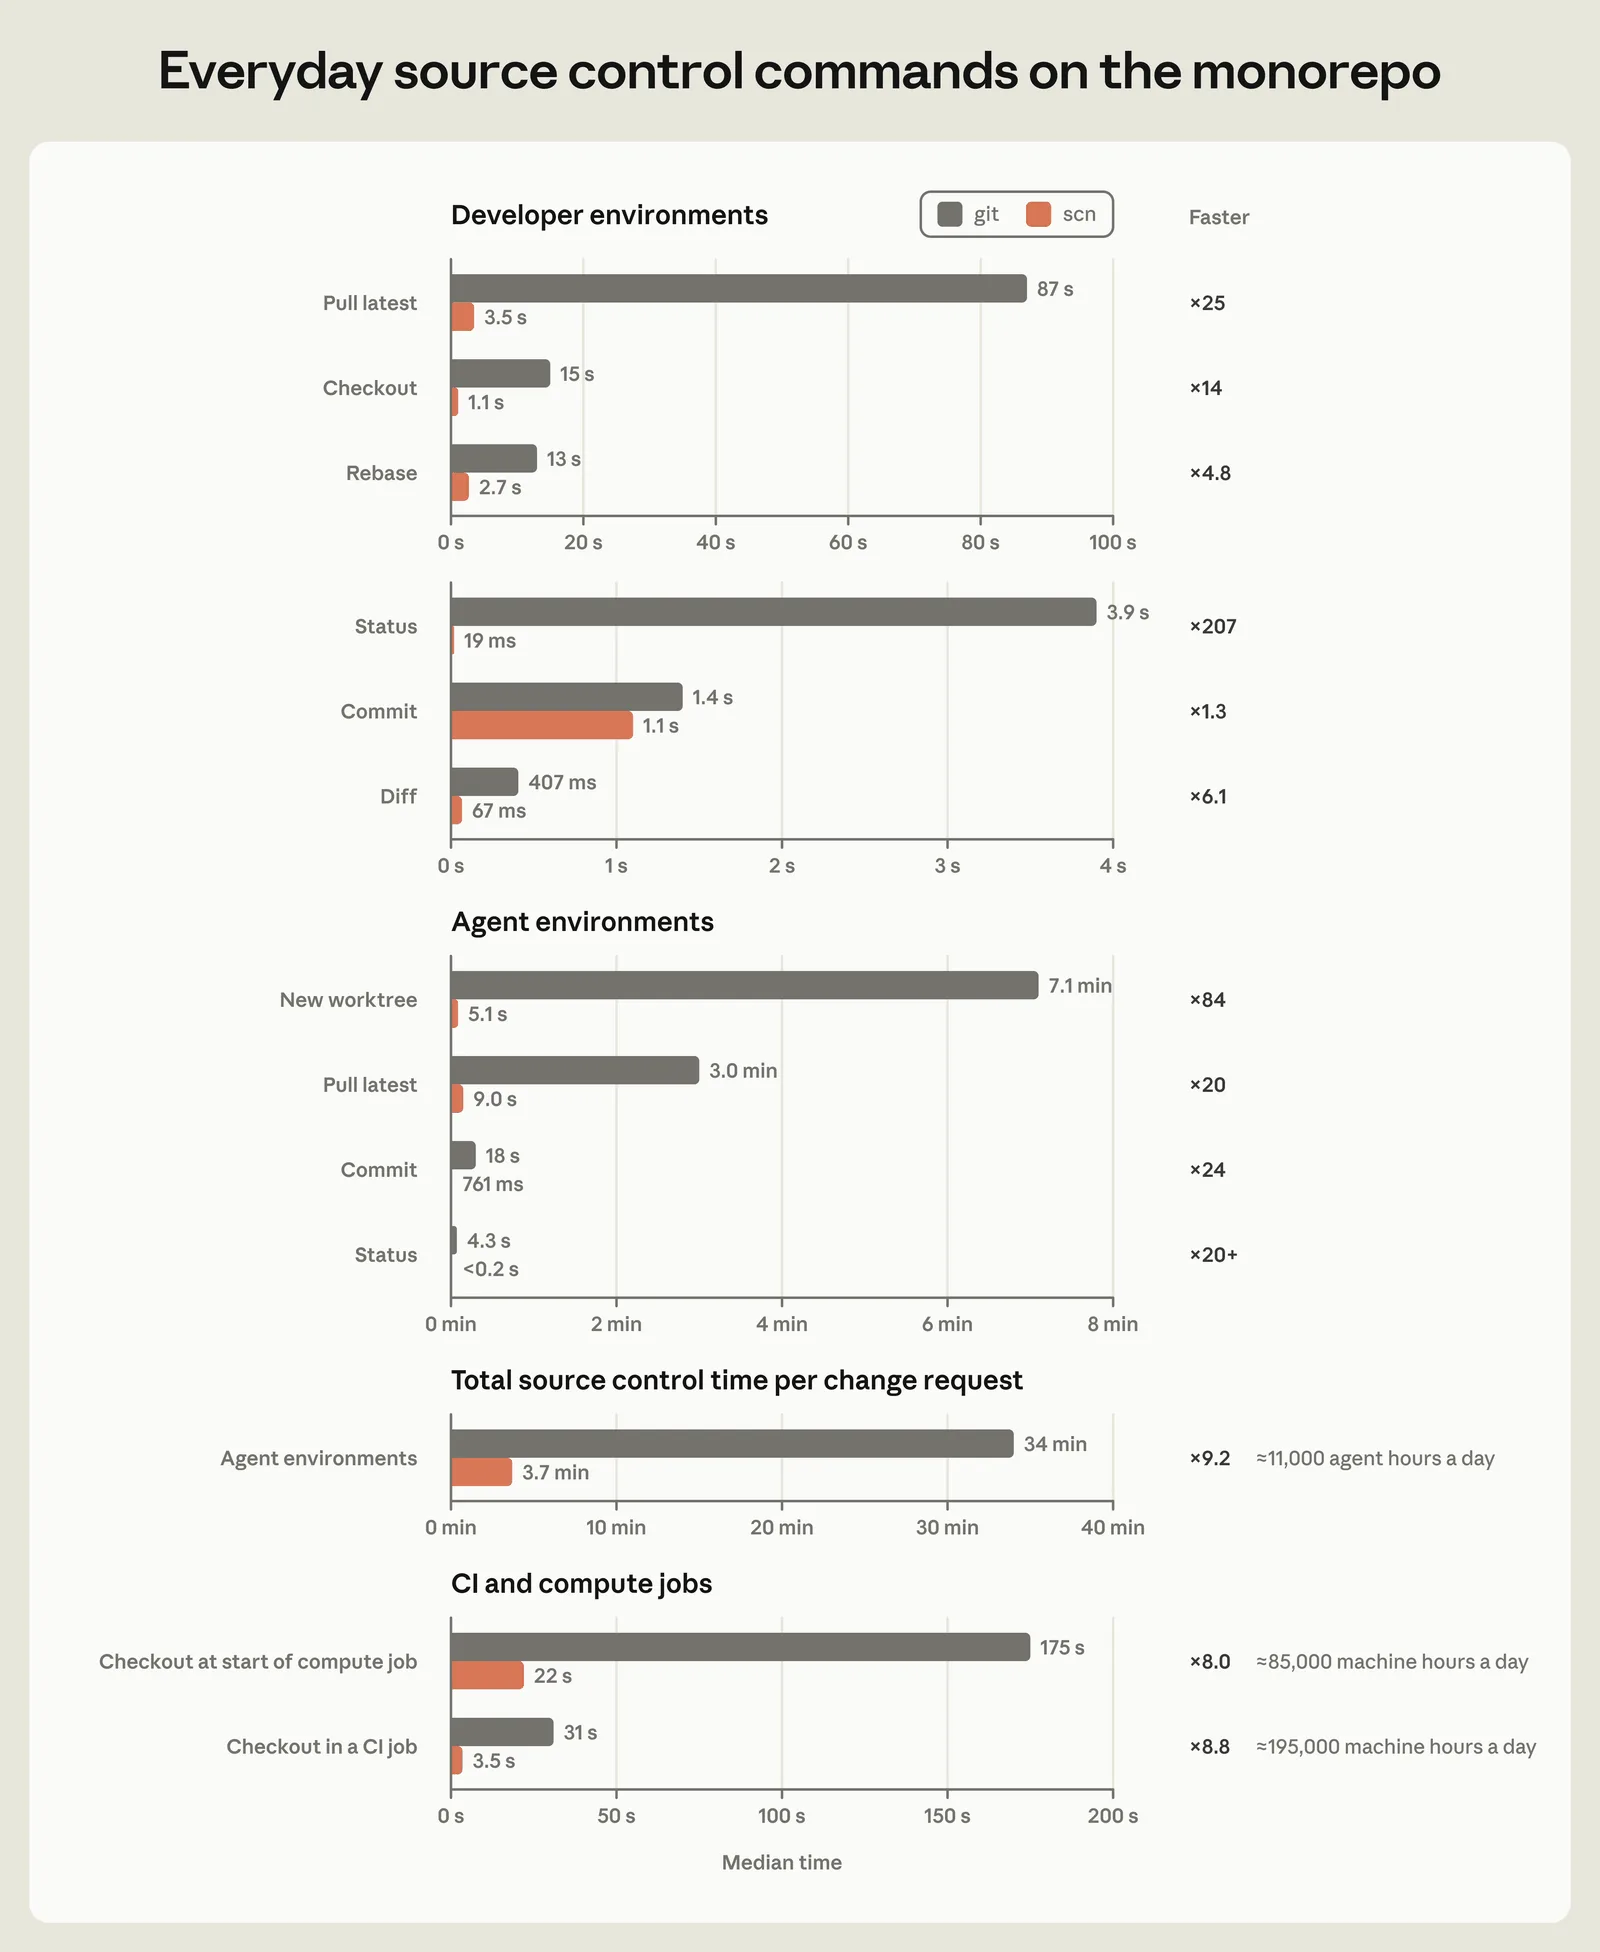
Anthropic의 측정도 같은 방향을 가리킵니다. 원문 마지막 그림을 보면 에이전트 환경에서 새 worktree를 만드는 데 git으로는 중앙값 7.1분이 걸렸고 Scion으로는 5.1초가 걸렸습니다. 변경 요청 하나에 소스 관리로 쓰는 시간도 34분에서 3.7분으로 줄었습니다. Anthropic 규모에서는 이것이 git을 떠날 이유가 됐습니다. VS Code 크기에서는 sparse-checkout만으로 worktree 하나가 3.2초에서 0.2초로 줄었습니다(필자 측정). 줄어든 배수는 Anthropic의 84배보다 작지만, git을 그대로 쓰면서 얻는 차이입니다.
git status가 느리다면 fsmonitor를 켭니다. git 2.37부터 맥과 윈도우에 파일 변경을 지켜보는 데몬이 내장됐고, git 2.55부터는 리눅스도 지원합니다(GitHub 블로그: Highlights from Git 2.55). 전체 복제에서 git config core.fsmonitor true와 core.untrackedCache true를 켜자 첫 status는 데몬을 띄우느라 1.8초 걸렸지만, 그다음부터는 0.16초가 0.03~0.04초가 됐습니다. VS Code 크기에서는 체감이 작지만, 파일이 수십만 개인 저장소에서는 차이가 커집니다. GitHub는 fsmonitor를 켜자 큰 작업 사본 세 곳에서 status가 1초 아래로 떨어졌다고 소개했습니다("status times dropping to under a second on three different large worktrees when FSMonitor is enabled", GitHub 블로그).
CI 설정: GitHub Actions와 GitLab의 기본값
CI는 이미 얕은 복제를 쓰고 있을 가능성이 큽니다. GitHub Actions의 actions/checkout(현재 v7) README는 "Only a single commit is fetched by default, for the ref/SHA that triggered the workflow"(기본으로 워크플로를 실행한 ref나 SHA의 커밋 하나만 받는다)라고 적고, fetch-depth의 기본값은 1, filter와 sparse-checkout의 기본값은 비어 있습니다(actions/checkout). GitLab은 새 프로젝트의 기본 복제 깊이가 20이고, 2022년 1월 14.7에서 50에서 20으로 내려갔습니다(GitLab 문서, GitLab MR 77576).
그래서 CI에서 따져 볼 것은 "얕은 복제를 쓸까"가 아니라 "이력이 필요한 작업이 얕은 복제 때문에 조용히 틀리고 있지 않은가"입니다. 변경된 파일만 테스트하려고 main과 비교하는 작업, 커밋 메시지로 변경 기록을 만드는 작업, git describe로 버전을 붙이는 작업이 여기에 해당합니다. GitLab 문서도 GIT_DEPTH를 쓰면 git describe에 기대는 작업이 제대로 동작하지 않을 수 있다고 경고합니다(GitLab 문서).
이런 작업에만 이력을 주는 방법은 두 가지입니다. 이력이 꼭 필요하면 fetch-depth: 0으로 전체를 받고, 커밋과 경로 이력만 필요하면 blobless로 받습니다. 앞의 측정에서 blobless 복제는 전체 복제의 절반이 안 되는 시간에 git log -- 파일을 전체 복제보다 빨리 답했습니다. 설정 예시는 다음과 같습니다.
# GitHub Actions: 이력이 필요한 작업만 blobless로 전체 이력 받기
- uses: actions/checkout@v7
  with:
    fetch-depth: 0
    filter: blob:none

# GitHub Actions: 모노레포에서 필요한 디렉터리만 받기
- uses: actions/checkout@v7
  with:
    sparse-checkout: |
      services/api
      libs/common
# GitLab CI: 태그를 빼고 fetch 전략으로 이전 작업 폴더 재사용
variables:
  GIT_STRATEGY: fetch
  GIT_DEPTH: "20"
  GIT_FETCH_EXTRA_FLAGS: --no-tags
GitLab의 모노레포 문서는 대형 저장소에 fetch 전략을 권하고, --no-tags로 fetch를 더 작게 만들 수 있다고 안내합니다(GitLab 문서: Managing monorepos). 같은 문서는 개발 환경에서는 얕은 복제를 피하고 blobless나 treeless 같은 부분 복제를 쓰라고 권합니다. 앞의 측정 결과를 보면 treeless보다는 blobless 쪽이 안전합니다.
국내 사례로는 토스가 있습니다. 토스 프론트엔드 모노레포는 2024년 기준 40GB를 넘었고, 매일 오전 저장소를 git clone --depth 50 등으로 미리 받아 둔 도커 이미지를 만들어 CI에서 처음부터 복제하지 않게 했습니다(토스 기술 블로그). Anthropic이 쓰다 한계를 본 스냅숏(seed) 방식과 같은 계열이고, 하루 머지가 수십 건인 규모에서는 잘 통한 방법입니다. 이 방식에서는 스냅숏을 만드는 주기가 머지 속도를 따라가는지가 관건입니다. Anthropic은 스냅숏을 새로 만드는 사이에 main이 너무 많이 앞서 나가 한계를 봤습니다.
상황별로 무엇을 쓸까
개발자는 blobless, 일회성 CI는 얕은 복제, 에이전트 여러 개는 blobless와 sparse-checkout, worktree 조합이 기본값으로 무난합니다. 측정과 공식 문서를 합쳐 정리하면 다음과 같습니다.
| 상황 | 권하는 방식 | 이유 |
|---|---|---|
| 개발자 노트북 | blobless (--filter=blob:none) |
복제가 절반 이하로 줄고 log는 그대로. 옛 커밋 checkout은 1.9초에서 5.2초로 느려진다. blame이 잦으면 git backfill을 한 번 돌린다 |
| 에이전트 여러 개 | blobless + sparse-checkout + git worktree |
worktree 하나가 351MB에서 17MB로. 빌드에 필요한 디렉터리를 cone에 넣는다 |
| 빌드 뒤 버리는 CI | 얕은 복제 (actions/checkout 기본값) |
가장 빠름. 단, 이력을 쓰는 작업이 섞여 있는지 확인한다 |
| 이력이 필요한 CI | fetch-depth: 0 + filter: blob:none |
커밋과 경로 이력은 다 있고 파일 내용만 필요할 때 받는다 |
| 파일이 수십만 개인 모노레포 | scalar clone |
blobless, sparse-checkout, 백그라운드 유지보수, fsmonitor를 한 번에 켠다 |
마지막 줄의 Scalar는 git 2.38부터 git에 함께 들어 있는 대형 저장소 관리 도구입니다. scalar clone은 blobless 복제와 cone 모드 sparse-checkout을 켜고, git maintenance start로 한 시간마다 도는 백그라운드 유지보수를 등록하며, 지원하는 플랫폼에서는 fsmonitor도 켭니다(git 문서: scalar, git 소스 scalar.c). 편하지만 사용자 계정에 예약 작업이 생기므로, 공용 CI 러너보다는 개발자 노트북에 맞습니다. 이번 측정에서 Scalar를 빼고 같은 설정을 하나씩 잰 것도 이 때문입니다.
어떤 방식을 고르든 순서는 같습니다. 먼저 우리 저장소에서 재 보고, 병목이 정말 복제인지 확인합니다. 예를 들어 LY Corporation의 한국어 기술 블로그는 AI 도입을 마친 팀의 목표로 팀 전체 하루 머지 20~40개를 제시했습니다(LY Corporation 기술 블로그). Anthropic의 하루 수만 건과는 자릿수가 다릅니다. 필자가 보기에는 이 규모에서 git보다 리뷰가 먼저 막힙니다. AI가 만든 PR이 몰리자 리뷰가 병목이 된 오픈소스 쪽 사례는 AI 기여 폭증, 오픈소스가 문을 닫는다에서 정리했습니다. 내 저장소의 숫자는 아래 명령 몇 줄로 확인할 수 있고, VS Code 크기 저장소라면 10분 안팎이면 끝납니다.
REPO=https://github.com/your-org/your-repo.git   # 내 저장소 주소로 바꾼다
FILE=src/your/file.ts                            # 자주 보는 파일로 바꾼다

time git clone --no-tags "$REPO" full             # 1. 전체 복제 시간
time git clone --filter=blob:none "$REPO" blobless # 2. blobless 복제 시간
du -sh full/.git blobless/.git                    #    두 방식의 .git 용량

time git -C blobless blame "$FILE" > /dev/null    # 3. blobless의 첫 blame 비용
time git -C full worktree add ../agent-1 -b agent-1 # 4. 전체 복제에서 작업 폴더 하나의 비용
전체 복제가 1분 안쪽이고 worktree 하나가 몇 초라면 지금 설정을 바꿀 이유가 크지 않습니다. 복제가 몇 분씩 걸리고 CI 로그에서 체크아웃이 눈에 띄는 비중을 차지한다면, 위 표의 순서대로 하나씩 바꿔 보면 됩니다.
출처
- Anthropic 엔지니어링 블로그: anthropic.com/engineering/redesigning-source-control
- HN 답글: news.ycombinator.com/item?id=50078883
- GitHub API, 2026-10-22: api.github.com/repos/microsoft/vscode
- GitHub 블로그, Derrick Stolee: github.blog/open-source/git/get-up-to-speed-with-partial-clone-and-shal…
- git 문서: partial clone: git-scm.com/docs/partial-clone
- git 문서: git-backfill: git-scm.com/docs/git-backfill
- 네이버 블로그 ksj0073: m.blog.naver.com/ksj0073/224441041431
- GitHub 블로그: Highlights from Git 2.49: github.blog/open-source/git/highlights-from-git-2-49
- GitHub 블로그: Highlights from Git 2.55: github.blog/open-source/git/highlights-from-git-2-55
- GitHub 블로그: github.blog/engineering/infrastructure/improve-git-monorepo-performance…
- actions/checkout: github.com/actions/checkout
- GitLab 문서: docs.gitlab.com/ci/pipelines/settings
- GitLab MR 77576: gitlab.com/gitlab-org/gitlab/-/merge_requests/77576
- GitLab 문서: docs.gitlab.com/ci/runners/configure_runners
- GitLab 문서: Managing monorepos: docs.gitlab.com/user/project/repository/monorepos
- 토스 기술 블로그: toss.tech/article/monorepo-pipeline
- git 문서: scalar: git-scm.com/docs/scalar
- git 소스 scalar.c: github.com/git/git/blob/v2.56.0/scalar.c
- LY Corporation 기술 블로그: techblog.lycorp.co.jp/ko/legacy-to-ai-driven-project-ax-roadmap