핵심 요약
- Anthropic이 사내 모노레포를 git에서 직접 만든 버전 관리 시스템 Scion으로 옮겼습니다. 2026년 10월 13일 엔지니어링 블로그에서 공개했고, 7명이 Scion과 코드 리뷰 도구 Antique를 만들어 5개월 만에 이전을 끝냈습니다.
- 이유는 Claude가 쏟아 내는 코드의 양입니다. 하루 머지는 2026년 5월 평균 약 2,500건에서 9월 3만 건 이상으로 늘었습니다. 3만 건은 9월 9일 하루의 최고치(30,401건)에 가깝고, 그래프의 7일 평균은 2만 건에 못 미칩니다.
- 핵심 설계는 "클라이언트는 늘 온라인"이라는 전제입니다. 커밋, 리베이스, 머지, blame을 모두 서버가 하고, 클라이언트는 필요한 파일만 받습니다. 이전 git 미러 인프라보다 CPU와 메모리 기준으로 200배 작아졌습니다.
- 새로운 발명이라기보다 구글 Piper, 메타 Mononoke가 걸어간 길입니다. Scion의 데이터 모델은 Mononoke의 Bonsai에서 많은 것을 가져왔고, 이를 지적받은 뒤 Anthropic이 원문에 각주를 달았습니다.
- 대부분의 팀은 git을 버릴 이유가 없습니다. Anthropic도 Scion은 일반적인 git 대체재가 아니고 다른 회사가 쓸 수 있는 형태로 공개하기 어렵다고 했습니다. 대신 부분 클론, sparse-checkout, CI 체크아웃 캐시처럼 git 안에서 같은 생각을 적용하는 길이 열려 있습니다.
목차
- 무엇이 발표됐나요?
- git은 어디서 막혔나요?
- Scion은 git과 무엇이 다른가요?
- 체크아웃은 어떻게 빨라졌나요?
- Claude와 엔지니어는 각각 무엇을 했나요?
- 처음 나온 생각인가요? Piper, Mononoke와 비교
- 개발자 반응: "SVN을 다시 만들었다"
- 우리 팀도 git을 버려야 하나요?
- 출처
무엇이 발표됐나요?
Anthropic은 2026년 10월 13일 엔지니어링 블로그에 "Redesigning source control at Anthropic"을 올려, 사내 모노레포를 git에서 자체 버전 관리 시스템 Scion으로 완전히 옮겼다고 밝혔습니다(Anthropic 엔지니어링 블로그). 글은 "Nick G.와 소스 관리 팀"이 썼고, 첫 문단에서 문제를 이렇게 정리합니다. 이제 Anthropic에서 병목은 코드를 쓰는 일이 아니라 사람 규모에 맞춰 만든 개발 인프라, 곧 소스 관리, 빌드, CI라는 것입니다.
숫자로 보면 이렇습니다. 원문은 "In May 2026, Anthropic averaged around 2,500 code changes merged per day; as of September, we merged over 30,000 per day."(2026년 5월에는 하루 평균 약 2,500건을 머지했고, 9월 기준 하루 3만 건 넘게 머지했다)라고 썼습니다. 그리고 머지를 원하는 수요는 사실상 끝이 없어서, 병목을 하나 없앨 때마다 만들어지는 코드가 곧바로 더 늘어난다고 덧붙였습니다.
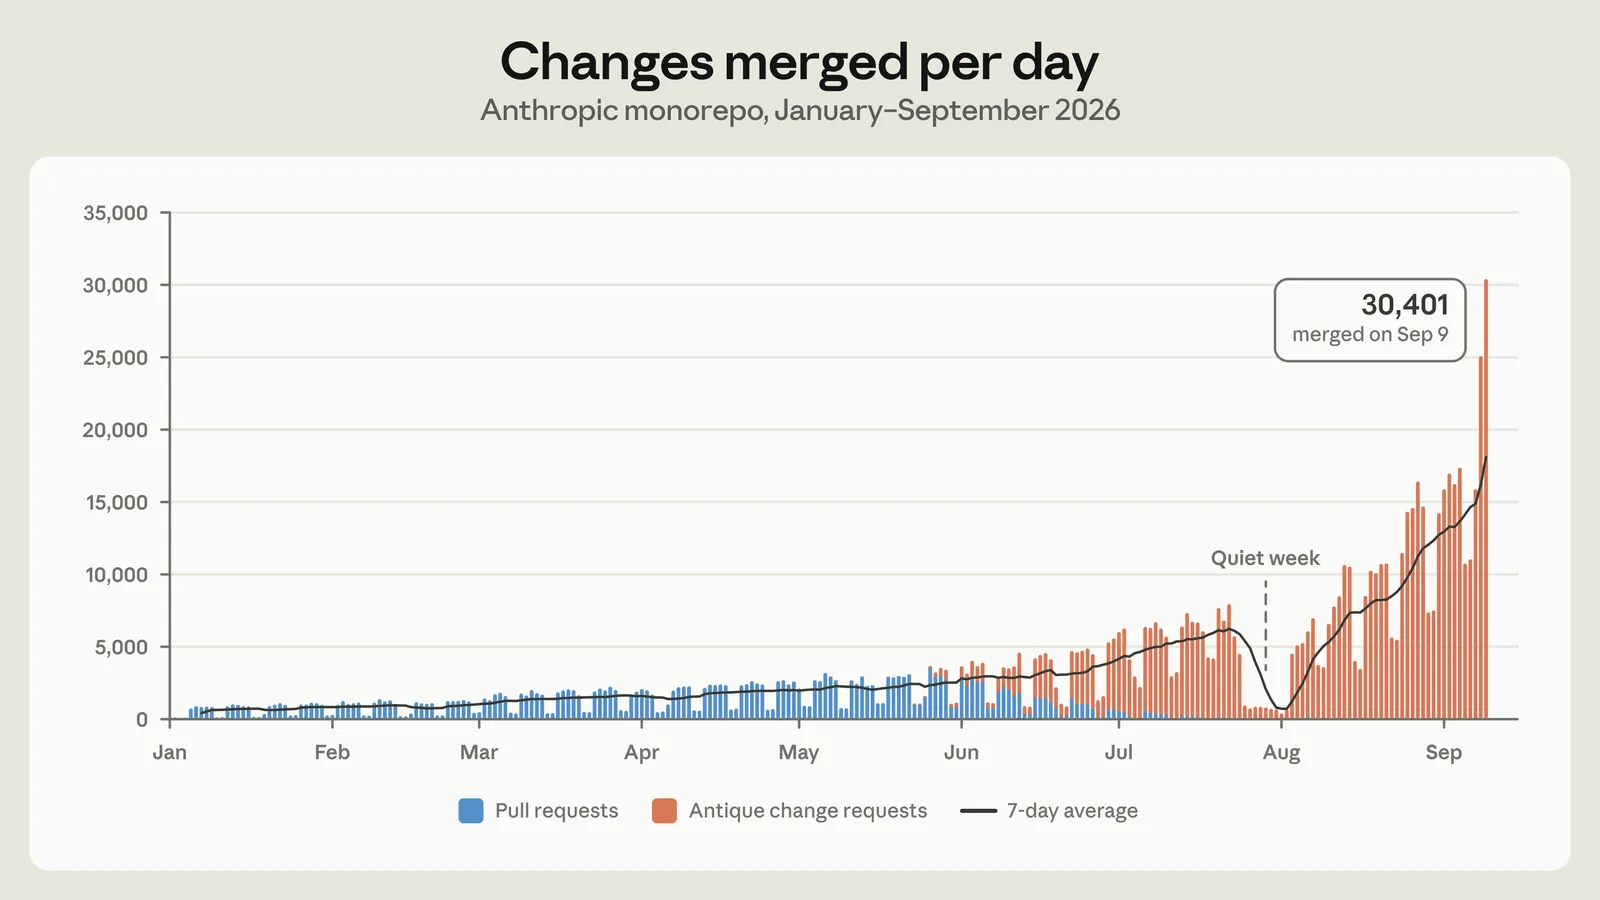
그래프를 읽을 때 두 가지를 같이 봐야 합니다. 첫째, 3만 건은 매일의 평균이 아닙니다. 말풍선에 적힌 30,401건은 9월 9일 하루 값이고, 같은 그래프의 7일 평균선은 2만 건에 못 미칩니다.
둘째, 세는 단위가 중간에 바뀝니다. 5월 중순까지는 풀 리퀘스트(파랑)만 있었고, 5월 말부터 Anthropic이 새로 만든 코드 리뷰 도구 Antique의 변경 요청(주황)이 섞이기 시작해 6월에는 둘이 섞여 있고, 7월부터는 주황이 거의 전부입니다. 그러니 "넉 달 만에 정확히 12배"라고 말하기보다는, 5월 평균 약 2,500건이던 하루 머지가 9월에는 3만 건을 넘긴 날이 나올 만큼 늘었다고 보는 편이 정확합니다. 그래도 증가 폭이 크다는 사실은 달라지지 않습니다.
이 일을 한 팀은 작았습니다. 원문은 "A team of seven people built both Scion and Antique"라고 썼고, 관련 시스템 여섯 개 안팎을 더 만들면서 5개월 만에 이전을 끝냈다고 했습니다. 같은 기간에 코드 검색, 소스 관리용 권한(IAM) 시스템, 리뷰된 코드를 대량으로 반영하는 방법도 함께 만들었습니다. 그사이 하루 머지 양은 10배로 늘었습니다.
git은 어디서 막혔나요?
git 자체가 잘못됐다기보다, git의 분산 설계가 Anthropic의 사용 방식과 맞지 않게 된 것이 원인이라고 원문은 설명합니다. git은 클론 하나하나가 완전한 저장소라서 인터넷이 끊겨도 diff, 이력, blame, 아무 리비전 체크아웃을 다 할 수 있습니다. 원문도 대부분의 저장소에는 이 설계가 옳고, git이 표준이 된 큰 이유라고 인정합니다.
문제는 크기와 횟수였습니다. 원문에 나온 규모는 다음과 같습니다.
- 메인 브랜치 이력만 "almost 100 GB"
- 압축한 작업 사본이 "over 25 GB"
- CI용 체크아웃이 하루 "on the order of 25 million"번(개발 환경, 에이전트 샌드박스, 리서치 작업은 뺀 숫자)
- 이 체크아웃을 아무 최적화 없이 받으면 하루 "over 600 PB"의 git 트래픽(원문이 "Fetched naively"라고 단서를 단 가정 계산)
Anthropic도 처음부터 git을 버리려 한 것은 아닙니다. git에는 저장소 일부만 다루는 기능이 있습니다. 이력을 잘라 받는 얕은 클론(shallow clone), 필요한 디렉터리만 펼치는 sparse checkout, 빠진 객체를 나중에 받아 오는 promisor remote가 그것입니다. 큰 모노레포를 운영하는 회사들이 흔히 쓰는 우회책도 있습니다. 사내 git 미러를 여러 대 두고, 저장소 스냅샷(seed)을 blob 저장소에 미리 만들어 두는 방식입니다. Anthropic은 이걸 다 썼고, 가장 많을 때는 사내 git 미러를 "several hundred"개 돌렸습니다.
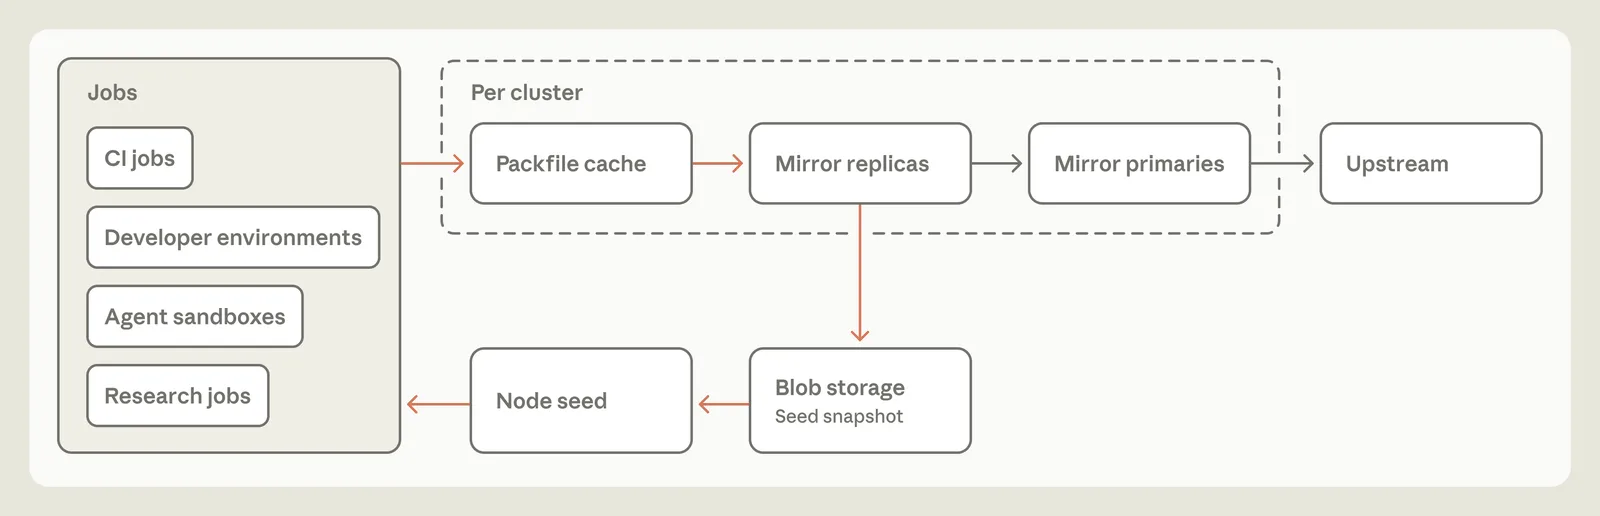
이 방법으로 시간은 벌었지만 머지가 늘수록 운영이 어려워졌습니다. 스냅샷을 새로 만드는 사이에 main 끝이 너무 멀리 달아났고, 부분 클론에서 diff나 blame처럼 이력이 필요한 작업을 계속 돌아가게 하려면 점점 더 손이 많이 갔습니다. 저장소가 미러의 디스크나 메모리 한도를 넘어서자 미러를 늘리는 방법도 더는 통하지 않았습니다.
여기서 Anthropic은 한 발 물러나 사실 하나를 짚습니다. 대부분의 회사처럼 Anthropic도 git을 "권위 있는 사본 하나를 둔 중앙집중 시스템"으로 쓰고 있었고, 클라이언트는 거의 다 에이전트와 작업이라 애초에 늘 온라인이었다는 것입니다. 오프라인에서도 모든 일을 할 수 있게 해 주는 git의 장점이, 저장소가 커지자 오히려 확장을 막고 있었습니다. 그래서 질문을 바꿨습니다. "에이전트가 늘 온라인이라는 사실을 처음부터 전제로 소스 관리를 설계하면 어떤 모습일까?"
Scion은 git과 무엇이 다른가요?
Scion은 무거운 일을 전부 서버로 옮기고, 클라이언트는 필요한 것만 받아 쓰는 구조입니다. 원문은 설계 원칙 여섯 가지를 내세웁니다. git과 나란히 놓으면 차이가 잘 보입니다.
| 원칙 | git | Scion |
|---|---|---|
| 클라이언트는 늘 온라인 | 오프라인 작업을 전제로, 클라이언트가 저장소 전체를 가진다 | 서버에 늘 닿는다고 보고, 필요할 때 데이터를 받는다 |
| 클라이언트와 서버의 비대칭 | 클론 하나하나가 완전한 서버가 될 수 있다 | 이력, blame, 커밋, 머지, 리베이스를 서버가 한다. 클라이언트는 크기가 제한된 로컬 객체 캐시와 작업 사본을 관리하고 파일 변경을 감시한다 |
| 소스 관리를 서비스로 | CI나 도구가 질문하려면 로컬 사본을 두거나 업체 API에 기대야 한다 | 클라이언트가 쓰는 모든 질의를 API로 열어, 많은 작업이 로컬 저장소 없이 돈다 |
| 모든 것을 수평 확장 | 미러가 디스크와 메모리 한도에 걸린다 | 데이터를 나눠 저장하고, 서버에도 저장소 전체를 펼친 사본이 없다. packfile이 없어 저장소 정리 작업도 없다 |
| 커밋은 싸고 잠금 없이 | 로컬에서 커밋하고 push한다 | 커밋, 리베이스, 머지가 모두 서버에서 일어나 push가 없다. 비용이 저장소 전체가 아니라 변경 크기에 비례해야 한다 |
| 작업 사본은 선택, 기본은 일부만 | 체크아웃이 기본이다 | 요청한 디렉터리만 담는 sparse 체크아웃과, 파일을 읽을 때 채우는 가상화 체크아웃이 기본이다 |
원칙만 보면 추상적이니 데이터 구조를 보겠습니다. Scion의 작업 단위는 "changeset"이고, 쓰기 앞 로그(write-ahead log)의 항목 하나입니다. git 커밋은 트리 전체를 가리키는 포인터를 담지만, changeset은 첫 번째 부모와 비교해 바뀐 파일 목록과, blob 저장소에 압축해 둔 파일 내용의 주소만 담습니다. 주소는 내용으로 만든 해시라서(content-addressed) 한 번 저장된 데이터는 바뀌지 않습니다. changeset은 서버에서 만들어지고 만들어지는 즉시 모든 곳에서 보입니다.
이 구조 덕분에 커밋을 받는 일이 가벼워집니다. 받아야 할 packfile도, 서버끼리 맞출 잠금도, 옮길 ref도 없기 때문입니다. 브랜치나 태그 같은 ref는 지원하지만 main과 릴리스 브랜치 말고는 쓰지 않도록 유도합니다. 모든 서버가 합의해야 하는 전역 상태는 언젠가 확장을 막는 문제가 되기 때문입니다. ref를 옮기는 일은 Spanner의 행 하나에 대한 compare-and-swap으로 changeset 생성과 따로 처리됩니다.
바뀐 파일만 적어 두면 "이 줄을 마지막에 누가 고쳤나" 같은 질문에 바로 답하기 어렵습니다. 그래서 Scion은 changeset에서 blame용 구조, 경로별 이력, 커밋 그래프용 skip list 같은 데이터를 따로 만들고, 이를 "derived data"(파생 데이터)라고 부릅니다. 파생 데이터는 모두 재귀적으로 정의돼서, 어떤 changeset의 값은 부모 changeset의 값으로 계산합니다. 덕분에 새 종류의 파생 데이터를 쉽게 추가할 수 있고, 종류마다 미리 계산할지 필요할 때 계산할지 고를 수 있으며, 클라이언트가 내부 구조를 보지 않으므로 클라이언트를 바꾸지 않고 최적화할 수 있습니다. 메타데이터는 구글 Spanner에, 파일 내용은 클라우드 저장소에 둡니다.
체크아웃은 어떻게 빨라졌나요?
Scion 클라이언트는 "내가 가진 것"을 말하지 않고 "내가 원하는 것"만 묻습니다. 이 차이가 캐시를 여러 겹으로 쌓을 수 있게 만들었습니다. git의 fetch는 클라이언트와 서버가 서로 가진 커밋을 주고받으며 협상하고, 서버가 클라이언트에게 빠진 객체를 계산해 packfile로 묶어 보냅니다(git pack-protocol 문서). 원문은 이와 대비해 Scion의 요청은 바뀌지 않는 객체 하나를 가리키므로 어느 캐시든 답할 수 있다고 설명합니다. 클라이언트마다 응답이 달라지는 git fetch는 그만큼 앞단에서 캐시하기 어렵다는 뜻으로 읽힙니다(필자 해석).
Scion의 scn 클라이언트는 루트 트리에서 시작해 로컬에 없는 트리를 하나씩 요청하고, 같은 방식으로 파일 내용(blob)을 요청합니다. 요청마다 절대 바뀌지 않는 특정 객체를 가리키므로 어느 캐시든 대신 답할 수 있습니다. 수 GB짜리 packfile 응답 하나가 없으니 중간에 끊겨도 이어 받을 수 있고, 필요 없는 트리는 아예 요청하지 않으면 되니 sparse 체크아웃과 가상화 체크아웃에 특별한 지원도 필요 없습니다.
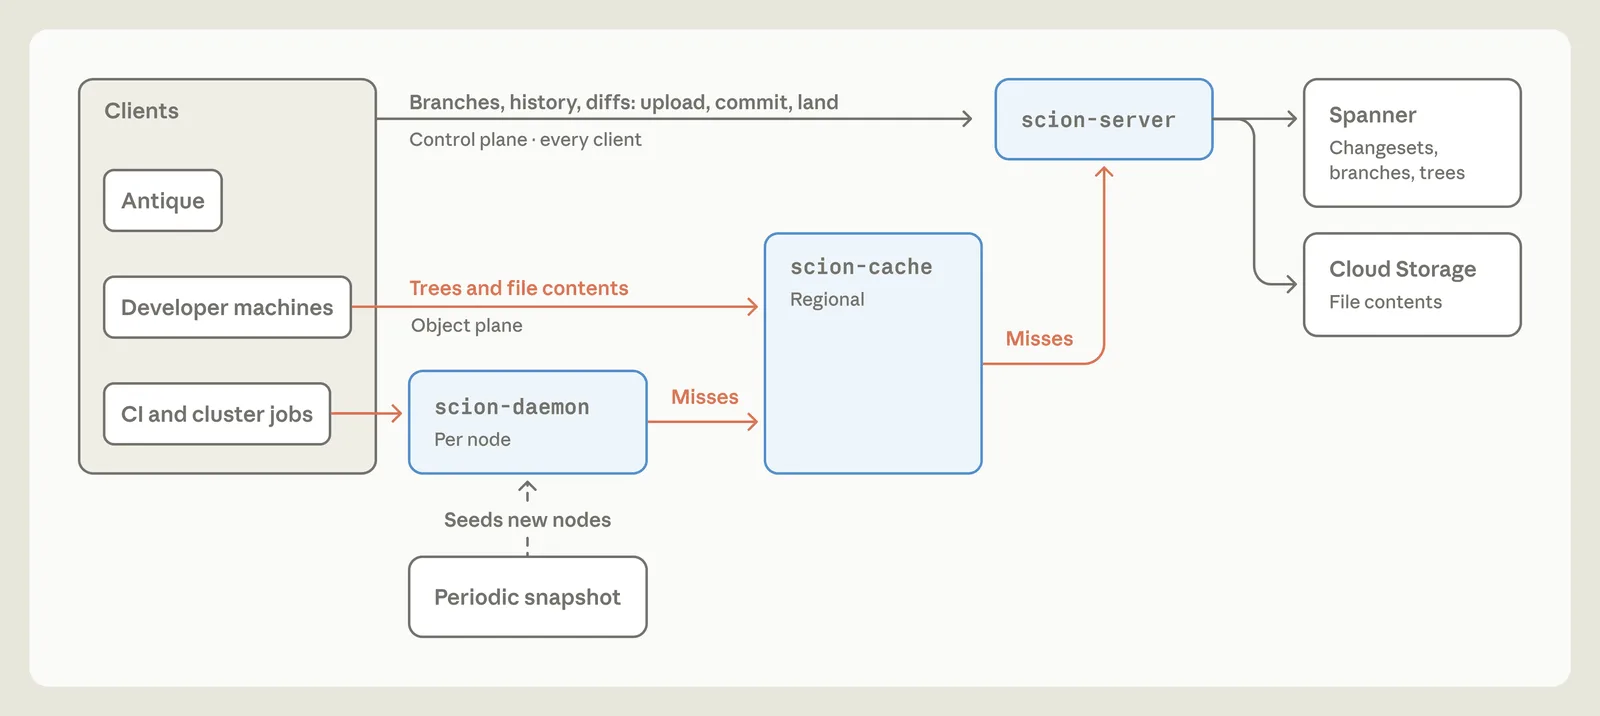
계층은 셋입니다. 노드마다 scion-daemon이 그 노드의 객체를 모아 두고, 같은 노드의 작업들이 이를 함께 씁니다. daemon은 주기적으로 새로 만드는 스냅샷에서 출발해 같은 리전의 scion-cache에만 묻습니다. scion-cache는 daemon이 바로 쓸 디스크 형식 그대로 메모리에서 객체를 흘려보내므로, 빠진 객체를 계산하거나 델타 압축을 할 필요가 없습니다. 캐시에 없는 객체만 권위 있는 scion-server에 묻습니다. 세 계층이 같은 RPC에 답하지만, 한 리전 캐시의 장애가 전체를 쓰러뜨리지 않도록 계층 순서를 엄격하게 지킵니다.
원문이 밝힌 결과는 다음과 같습니다.
- 계층마다 캐시 적중률 99% 이상
- Scion 인프라 규모가 이전 git 미러 인프라보다 CPU와 메모리 기준 "200x smaller"
- CI와 리서치 작업의 체크아웃이 "two orders of magnitude faster (in seconds rather than minutes)"
- CI에서만 CPU 용량 25% 절약
원문 마지막 그림은 명령별 중앙값을 git과 Scion(scn)으로 비교합니다. 본문은 CI·리서치 작업 체크아웃이 약 100배(two orders of magnitude, 몇 분에서 몇 초로) 빨라졌다고 썼지만, 그림의 CI 작업 체크아웃 중앙값은 8.8배입니다. 원문은 이 차이를 설명하지 않으니 측정 기준이 다른 것으로 보고 따로 읽는 편이 안전합니다(필자 해석).
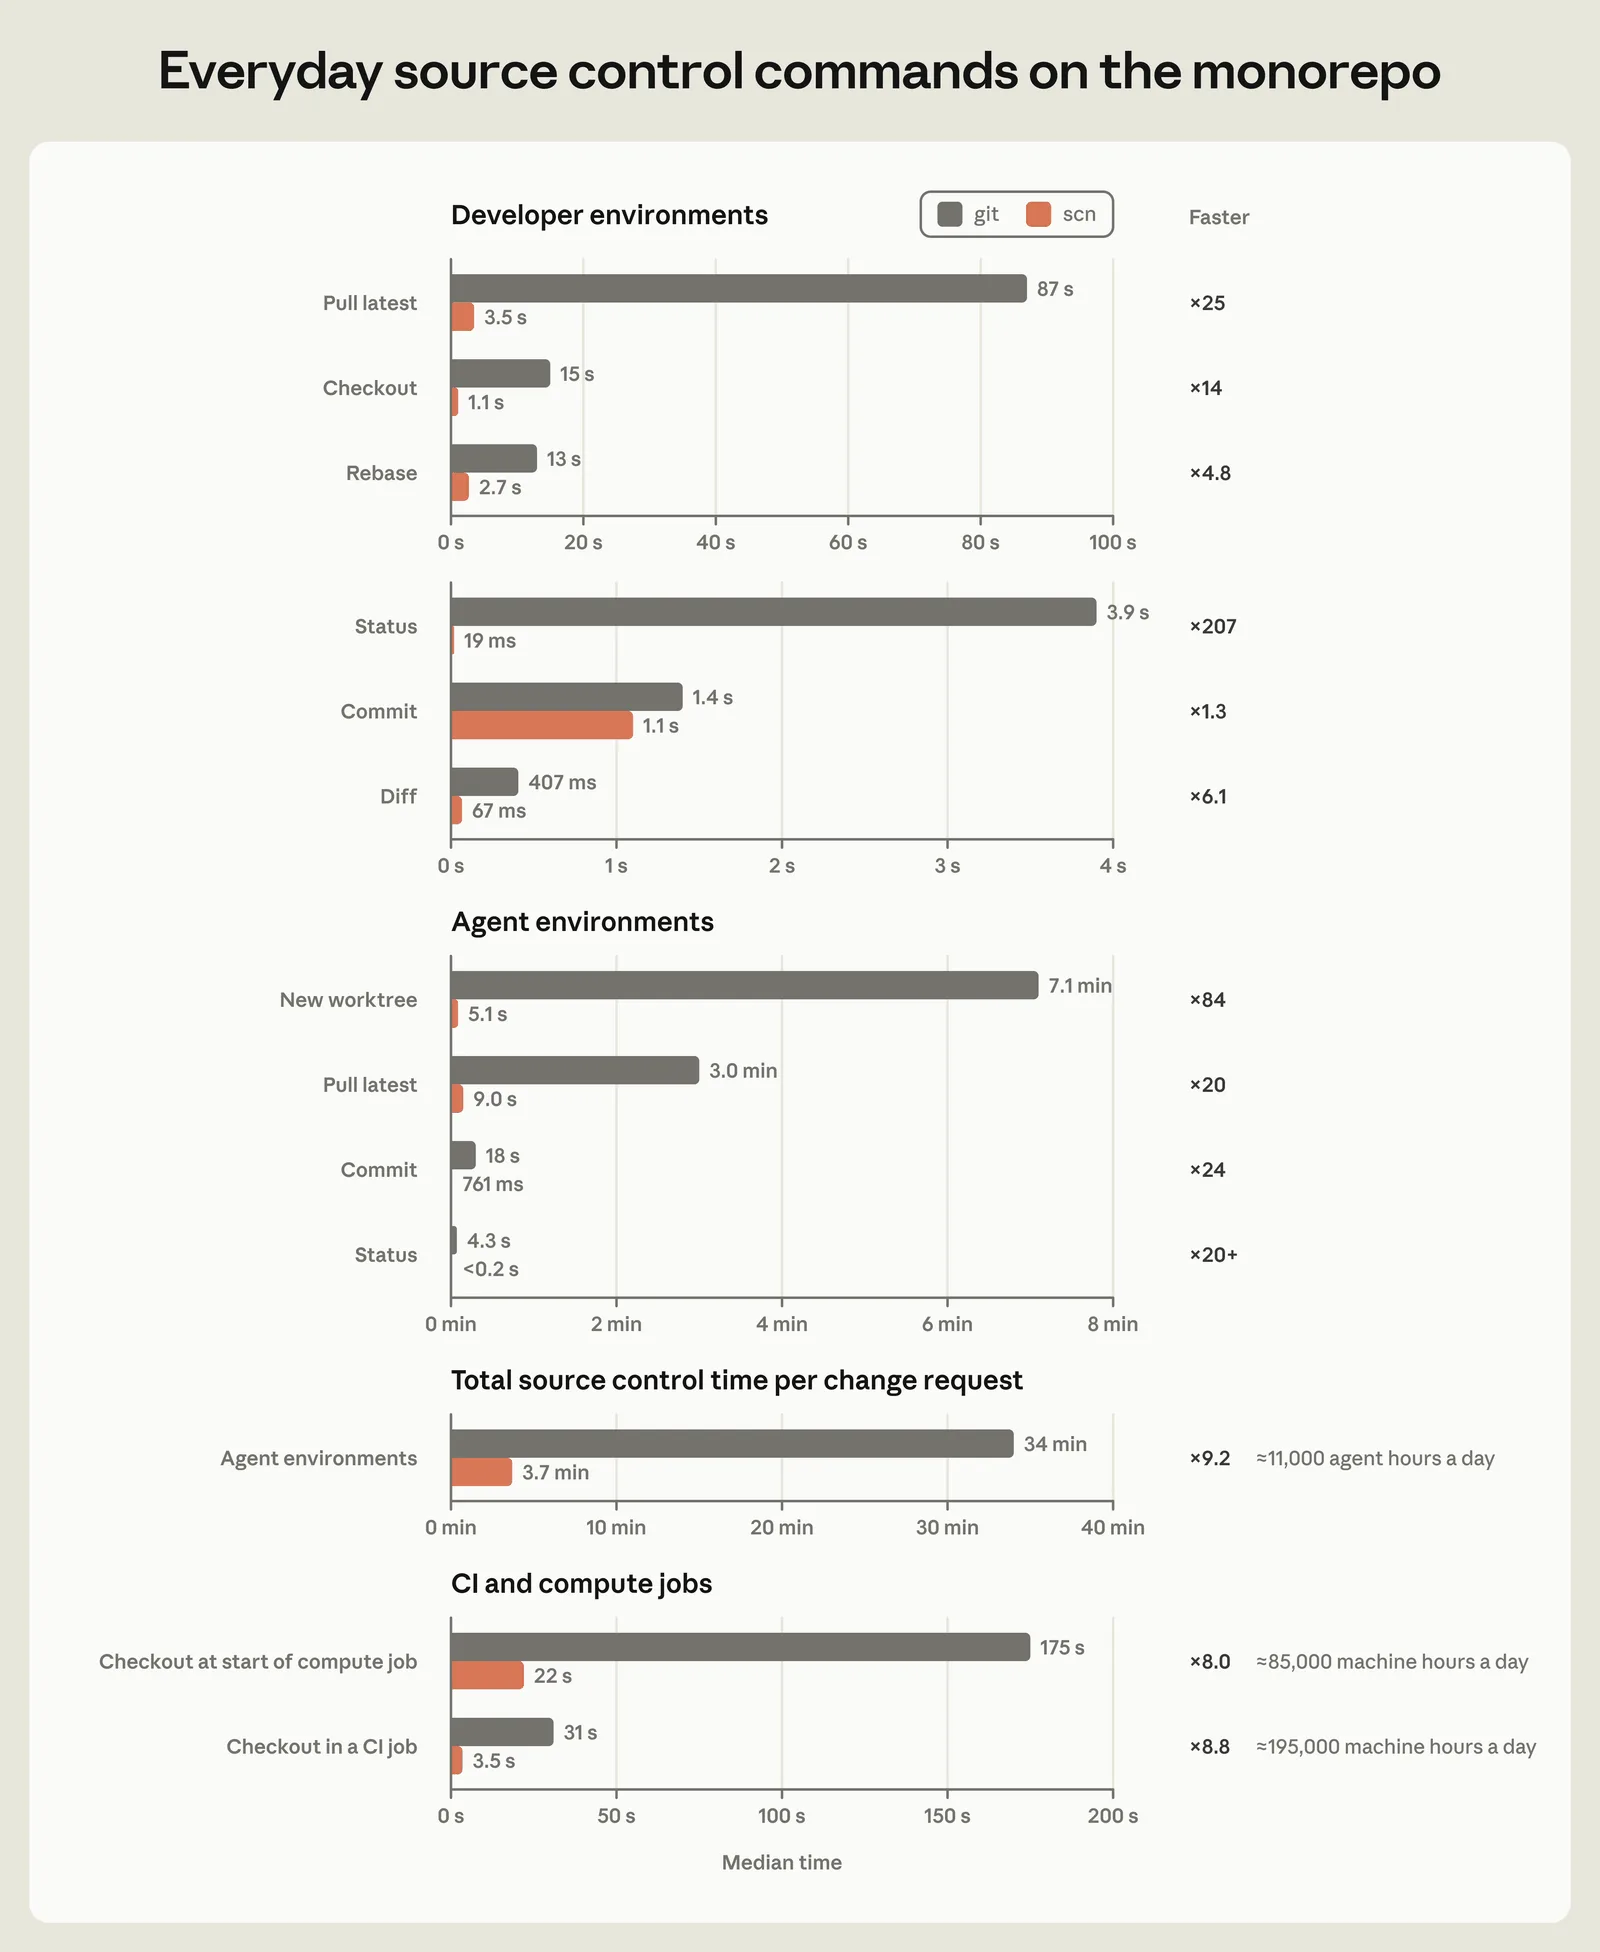
| 환경 | 명령 | git 중앙값 | Scion 중앙값 | 빨라진 배수 |
|---|---|---|---|---|
| 개발자 | pull | 87초 | 3.5초 | 25배 |
| 개발자 | status | 3.9초 | 19밀리초 | 207배 |
| 에이전트 | 새 worktree | 7.1분 | 5.1초 | 84배 |
| 에이전트 | pull | 3.0분 | 9.0초 | 20배 |
| 에이전트 | 변경 요청당 소스 관리 시간 합계 | 34분 | 3.7분 | 9.2배 |
| CI | CI 작업 체크아웃 | 31초 | 3.5초 | 8.8배 |
에이전트 쪽 숫자가 특히 큽니다. 변경 요청 하나에 소스 관리로 쓰던 34분이 3.7분이 됐고, 그림은 이를 하루 약 1만 1천 에이전트 시간으로 환산했습니다. CI 체크아웃은 8.8배, 컴퓨트 작업 시작 체크아웃은 8.0배로, 그림이 각각 하루 약 19만 5천, 8만 5천 머신 시간에 해당한다고 적었습니다. 개발 환경의 커밋은 1.4초가 1.1초로 거의 그대로지만, 에이전트 환경의 커밋은 18초가 761밀리초로 24배 빨라졌습니다. 빨라진 폭은 명령과 환경마다 크게 다릅니다.
Claude와 엔지니어는 각각 무엇을 했나요?
원문은 Claude가 문제를 만든 원인이자 문제를 푼 도구였다고 말합니다. 동시에 엔지니어가 하는 일의 상당 부분이 "Claude에게 아니라고 말하는 것"이었다고 적었습니다. Scion을 만들기 시작한 시기에 Claude Mythos Preview 같은 새 모델과 도구가 사내에 풀렸고, 이것이 Scion의 필요를 키우는 동시에 만드는 속도를 끌어올렸다고 합니다.
원문이 "특히 놀라운 예"로 든 일화는 수집(ingestion) 파이프라인입니다. git 저장소를 Scion으로 옮겨 담는 파이프라인의 첫 프로토타입은 사람이 거의 손으로 썼습니다. 그런데 Claude Mythos Preview의 초기 사내 버전에 전부 다시 쓰라고 시켰더니, 추가 지시 없이 메모리를 20분의 1만 쓰고 4배 빠른 버전이 나왔다고 합니다. 수집 순서와 데이터 구조에 걸린 암묵적인 불변 조건도 모두 지켰다고 했습니다. 이 숫자는 Scion 전체가 아니라 이 파이프라인 하나에 대한 것입니다.
엔지니어의 역할에 대한 대목이 더 흥미롭습니다. 원문은 이 시스템을 만든 엔지니어 모두가 이제 코드 작성은 Claude가 자기보다 낫다고 평가한다고 적었습니다. 그래도 시스템 사이의 큰 구조와 설계 트레이드오프는 사람이 판단했고, 그 일의 상당 부분이 Claude를 말리는 것이었습니다. 에이전트가 코드를 많이 쓸수록 설계의 경계를 사람이 분명히 그어야 한다는 이야기는 AI가 코드를 쓸수록 DDD가 중요한 이유에서도 다뤘습니다.
- 제약을 어기는 패턴을 막았습니다. 이전 과정에서 여러 시스템이 코드 리뷰 도구에 물어보면 될 "이 변경이 언제 main에 들어갔나"를 커밋 로그를 처음부터 읽어 가며 찾으려 했다고 합니다.
- 적대적 리뷰의 과잉 방어를 걸러 냈습니다. Anthropic은 적대적 리뷰(adversarial review)를 많이 쓰는데, 다른 사내 서비스를 믿지 못하겠다는 리뷰 하나 때문에 Claude가 불필요한 검증과 복잡도를 잔뜩 붙인 일이 있었습니다.
- 줄 단위가 아니라 의도를 리뷰합니다. 원문은 "Our team members still review every change request for the system, but they now examine the intent of the change as opposed to reading every line of code."(팀원은 여전히 모든 변경 요청을 리뷰하지만, 이제 코드를 한 줄씩 읽는 대신 변경의 의도를 본다)라고 썼습니다. 이를 돕도록 Antique는 승인 규칙에 의미 조건을 걸 수 있어, 주석만 바꾼 변경과 민감한 로직 변경을 구분해 사람이 중요한 변경에 집중하게 합니다.
운영 방식도 바뀌었습니다. 팀은 Slack 채널을 만들어 Claude 하나에 컴포넌트 하나의 건강 상태만 집요하게 지켜보게 하고, 이런 Claude를 "superfan"이라고 부릅니다. scion-daemon superfan, scion-cache superfan, Antique 머지 큐 superfan이 텔레메트리와 로그를 보며 이상한 점을 찾습니다. 기존 알림도 그대로 두지만, superfan이 알림보다 미묘한 문제를 잡는다고 했습니다.
머지 큐의 저장소 전역 잠금은 포기했습니다. 원문은 테스트가 도는 동안 수백, 수천 개 변경이 머지될 수 있다면 CI가 무엇을 뜻하느냐고 묻습니다. 업계 표준인 머지 큐의 저장소 전역 잠금을 이 규모에서 재현하지 못해서, 대신 머지 뒤, 배포 전 자동 테스트에 투자했습니다. 동시에 들어온 변경끼리 충돌할 수 있지만, 사람이 충돌을 알아채기도 전에 Claude가 대개 고친다고 합니다. 비슷한 흐름은 오픈소스 쪽에서도 보입니다. AI가 만든 PR이 쏟아지자 리뷰가 병목이 된 메인테이너들의 대응은 AI 기여 폭증, 오픈소스가 문을 닫는다에서 정리했습니다.
처음 나온 생각인가요? Piper, Mononoke와 비교
아닙니다. 거대한 모노레포를 위해 git 밖에서 소스 관리를 새로 만든 회사는 이미 있었고, Anthropic도 원문에서 구글 Piper와 메타 Sapling을 선행 사례로 들었습니다. 원문에는 10월 15일 각주가 새로 붙었습니다. "Specifically, the server component of Sapling, Mononoke. It pioneered many of the techniques we use in Scion, in particular the Bonsai data model."(구체적으로는 Sapling의 서버 구성 요소인 Mononoke다. Scion에서 쓰는 많은 기법, 특히 Bonsai 데이터 모델을 처음 개척했다.)
| 구글 Piper (2015년 1월 통계) | Microsoft Windows 저장소 (2017) | Anthropic Scion (2026년 9월) | |
|---|---|---|---|
| 규모 | 86TB, 파일 약 10억 개 | 약 300GB, 파일 약 350만 개 | 메인 이력 약 100GB, 작업 사본 25GB 이상 |
| 하루 변경 | 사람 1만 6천 + 자동화 2만 4천 건 | push 평균 8,421건 | 머지 3만 건 이상(최고치 기준) |
| 방식 | Spanner 위의 Piper, FUSE 파일시스템 CitC | git + 가상 파일시스템 GVFS | 자체 VCS, Spanner + 클라우드 저장소, 가상화 체크아웃 |
| 출처 | CACM 2016 | Microsoft 블로그 | Anthropic |
세 회사가 세는 단위(changes, push, merge)가 달라 숫자를 그대로 비교할 수는 없습니다. 그래도 방향은 보입니다. 구글은 2015년에 이미 하루 변경의 60%를 자동화 시스템이 만들었고, Piper를 Spanner 위에 올리고 개발자는 클라우드에 있는 작업 공간을 FUSE 파일시스템으로 열게 했습니다. Scion이 Spanner를 쓰고 가상화 체크아웃을 둔 것과 닮았습니다. 메타는 2022년에 Sapling 클라이언트를 공개하면서 사내 저장소가 수천만 개 파일, 수천만 개 커밋, 수천만 개 브랜치 규모라고 했습니다(Meta 엔지니어링 블로그). Microsoft는 git을 버리지 않고 가상 파일시스템(GVFS)을 얹는 쪽을 택했고, 그 경험은 지금 git에 들어간 Scalar로 이어졌습니다.
선행 사례와 얼마나 닮았는지는 논란이 됐습니다. 2017~2018년 메타에서 Mononoke를 함께 만든 Rain은 10월 14일 블로그에서 Scion이 blame 같은 작업을 빠르게 하려고 "파생 데이터"를 쓰는 설명을 자신이 쓴 Mononoke 설명과 나란히 놓고, 비슷한 통찰을 넘어선 모방이라고 썼습니다(sunshowers.io). 다음 날 두 번째 글에서는 changeset이 Mononoke의 Bonsai changeset과 "exactly the same"이라며, Sapling만 언급하고 Mononoke를 빼먹은 것은 정직하지 않다고 비판했습니다(sunshowers.io).
원문 저자 Nick G.는 HN 답글에서 메타가 바깥에 이 시스템 전체를 Sapling이라고 불러 왔기 때문에 그렇게 썼고, Mononoke의 Bonsai 데이터 모델에서 영감을 받았으며 각주를 추가하겠다고 답했습니다(HN 답글). Rain은 새 각주로 출처 표기가 충분해졌다고 받아들이면서도, 글을 쓴 시점의 판단은 그대로라고 덧붙였습니다. HN에는 Sapling이 오픈소스(GPL)이니 설계를 참고한 것 자체는 문제가 아니라는 반론도 여럿 달렸고(HN), Rain은 베낀 것이 아니라 출처 표기가 문제라고 답했습니다(HN).
개발자 반응: "SVN을 다시 만들었다"
"AI 때문에 git이 무너졌다"는 해석에 맞서 "큰 모노레포에서 늘 있던 문제가 AI 덕에 빨리 왔을 뿐"이라는 반응이 HN, Reddit(r/ClaudeAI), YouTube에서 여럿 나왔습니다. 원문을 올린 Hacker News 글은 10월 19일 기준 892점, 댓글 1,009개를 받았습니다(HN).
- 중앙집중으로 돌아갔다는 냉소. HN에는 "So... Anthropic reinvents SVN?"이라는 댓글이 달렸고(HN), Simon Willison도 Subversion 같은 중앙집중 소스 관리를 다시 만든 것처럼 보인다고 평했습니다(Simon Willison). Theo의 영상 "Anthropic Rebuilt Git (yes really)"에도 "They reinvented SVN"이 가장 많은 공감을 받은 댓글로 올라 있습니다(YouTube).
- 사람이 안 보는 코드에 대한 걱정. 가장 많은 답글(198개)이 달린 댓글은 "Claude 코드를 리뷰하지 않으면 나중에 엉성한 코드가 나오는데, 그걸 어떻게 피하나, 아니면 그냥 받아들이나"라는 질문이었습니다(HN).
- 따라 하기 열풍에 대한 경고. "모두가 FOMO에 빠져 같은 걸 해야 한다고 생각했다가, 자기가 Anthropic이나 구글이 아니라는 걸 깨닫는 못난 시기가 올 것"이라는 댓글도 있었습니다(HN).
- 공개하지 않을 거면 왜 알리나. "오픈소스로 내지 않을 거면 왜 이걸 말해 주나"라는 반응도 나왔습니다(HN). The New Stack은 아예 제목을 "But you can't have it"으로 달았습니다(The New Stack).
저자 Nick G.는 HN 답글로 원문에 없던 내용도 덧붙였습니다. 오프라인을 지원하지 않은 이유는 Claude가 Scion의 압도적인 최대 사용자이고 Claude는 어차피 온라인이기 때문이라고 했습니다(HN 답글). 구글 저장소가 80TB대인데 100GB가 그렇게 크냐는 질문에는, 문제는 크기가 아니라 증가 속도이고 Scion이 빨라지자 코드를 더 쓰게 돼 Scion에 압력이 더 가는 자기 강화 고리가 있다고 답했습니다(HN 답글).
Theo는 영상에서 git이 지금 흐름에 맞는 기본 단위가 아니고, 직접 만들어 옮기는 전환 비용이 무엇보다 크게 떨어졌다며 대체로 반겼습니다. 머지 큐의 전역 잠금 대신 머지 뒤 테스트로 간 결정도 반겼습니다. 다만 앞에서 본 Antique의 의미 기반 승인 규칙처럼 변경 종류를 코드로 짠 규칙으로 구분하는 부분에는 가장 회의적이라고 했습니다. 코드를 만드는 값이 떨어지면 기존 소프트웨어를 다시 만드는 일이 쉬워진다는 논쟁은 깃허브 별 26만 개 리버스 엔지니어링 도구 REA 글에서도 짚었습니다.
국내 커뮤니티 토론은 조용한 편입니다. 긱뉴스의 원문 요약 글은 10월 14일 게시돼 14점, 댓글 3개를 받았고, 국내 사용자 댓글은 구글에도 같은 이름의 저장소(GoogleCloudPlatform/scion)가 있어 헷갈린다는 내용 하나였습니다(긱뉴스). 국내 기사와 블로그는 대부분 원문 숫자를 옮겼고, 솔루션뉴스처럼 "넉 달 새 12배"로 요약한 기사도 있었습니다. 앞에서 본 것처럼 이 숫자는 하루 최고치와 바뀐 집계 단위를 함께 봐야 합니다.
우리 팀도 git을 버려야 하나요?
아니요. Anthropic 스스로 Scion을 일반적인 git 대체재로 권하지 않습니다. 원문은 "Scion is by no means a suitable replacement for git for general use."(Scion은 결코 일반적인 용도의 git 대체재가 아니다)라고 쓰고, 이 개념은 엔지니어 수만 명이나 코드를 쏟아 내는 에이전트 무리가 있는 정말 거대한 모노레포에서만 말이 된다고 했습니다. 사내에서 쓸 수 있는 토큰이 다른 회사가 현실적으로 쓰려 할 양을 훨씬 넘는다는 점도 스스로 밝혔습니다. Scion은 git과 크게 달라 개발 과정 전체를 옮겨야 하고 자체 코드 리뷰, 코드 검색, CI가 필요해서, 다른 회사가 쓸 수 있는 형태로 공개하기 어렵다고 했습니다.
저자도 HN에서 "직접 VCS를 바이브 코딩하라"는 글이 아니고 git에 바로 적용할 수 있는 아이디어가 많다고 강조했습니다(HN 답글).
그렇다고 남의 일만은 아닙니다. 원문은 이런 문제가 앞으로 6~12개월 사이 더 흔해질 것으로 봤습니다. 실제로 GitHub는 Scion 글 일주일 전 "Building Git infrastructure for agent-scale development"에서 2026년 9월 한 달 동안 개발자와 에이전트가 GitHub에 커밋 73억 8천만 건을 만들어 1년 전의 5배를 넘었고, push는 4.9배, PR 머지는 4배 가까이 늘었다고 밝혔습니다(GitHub 블로그). GitHub의 해법은 git을 버리는 것이 아니라 git 서버 안에서 저장과 계산을 나누는 것이었고, 사내 벤치마크에서 쓰기 처리량이 최대 35배 높아졌다고 했습니다. Anthropic이 원문 끝에서 제안한 방향, 곧 "git 서버가 git 클라이언트와 같은 방식으로 일할 필요는 없다"와 같은 쪽입니다.
국내 사례도 있습니다. 토스 프론트엔드 챕터는 2024년 글에서 모노레포 하나로 서비스 200여 개를 관리하고 일평균 60개 이상의 PR을 머지한다고 했습니다. 저장소가 40GB를 넘어 --filter=blob:none 없이는 클론이 안 됐고, 매일 아침 저장소를 미리 받아 둔 도커 베이스 이미지를 만들어 CI 체크아웃을 36분에서 22초로 줄였습니다(토스 기술 블로그). Anthropic이 쓰다가 한계를 만난 seed 스냅샷과 같은 계열의 방법이고, 2024년 기준 하루 수십 건 규모에서는 잘 통했다는 사례입니다.
지금 git으로 해 볼 수 있는 것은 이렇습니다.
- 부분 클론으로 파일 내용을 필요할 때 받습니다. blobless 클론은 커밋과 트리는 모두 받고 파일 내용(blob)은 필요할 때 받습니다. 얕은 클론은 빌드 뒤 바로 지우는 CI가 아니면 권하지 않는다는 것이 GitHub의 안내입니다(GitHub 블로그).
- sparse-checkout으로 필요한 디렉터리만 펼칩니다. Git 2.25에 들어간
git sparse-checkout명령을 부분 클론과 함께 쓰면 효과가 커집니다(GitHub 블로그). - 큰 저장소라면 Scalar를 씁니다. Git 2.38에 들어간 Scalar는 부분 클론, sparse-checkout, 백그라운드 유지보수, 고급 설정을 한꺼번에 켜 주는 대형 저장소 관리 도구입니다(GitHub 블로그).
- CI 체크아웃을 캐시합니다. 토스처럼 미리 받아 둔 이미지나 러너 캐시에서 시작해 최근 변경만 받으면 됩니다. 스냅샷을 새로 만드는 주기는 머지 속도에 맞춰 줄여야 합니다.
- 저장소 질문은 클론 대신 API로 합니다. "이 줄을 누가 고쳤나", "이 PR이 언제 main에 들어갔나"처럼 CI가 저장소에 묻는 질문은 GitHub이나 GitLab API로 대신할 수 있는지 먼저 봅니다. Anthropic의 엔지니어가 Claude를 말린 사례도 이 종류였습니다.
명령으로 쓰면 다음과 같습니다(저장소 주소와 디렉터리는 예시입니다).
# 커밋과 트리만 받고 파일 내용은 필요할 때 받는 blobless 클론
git clone --filter=blob:none https://github.com/your-org/monorepo.git
cd monorepo

# 필요한 디렉터리만 작업 사본에 펼치기 (cone 모드)
git sparse-checkout set --cone services/api libs/common
Scalar를 쓰면 위 설정을 한 번에 켤 수 있습니다. 위 명령과 따로, 새 폴더에서 실행합니다.
# 부분 클론, sparse-checkout, 백그라운드 유지보수를 한 번에 켜는 Scalar
# (작업 사본은 monorepo/src에 생기고, 처음에는 최상위 파일만 펼쳐진다)
scalar clone https://github.com/your-org/monorepo.git
머지 큐의 전역 잠금을 풀고 머지 뒤 테스트로 가는 Anthropic의 방식은 더 조심해야 합니다. 필자가 보기에 이 방식은 충돌을 사람보다 빨리 고치는 에이전트, 문제가 생긴 변경을 자동으로 찾아 되돌리는 bisect·revert 파이프라인(원문이 소스 관리 API 덕에 가능해졌다고 든 사내 도구), 배포 전 자동 테스트가 갖춰져 있어야 성립합니다. 이런 장치 없이 머지 전 검사만 없애면 main이 깨진 채로 오래 남을 수 있습니다. 하루 머지가 수십 건인 팀이라면 머지 큐를 두고, 에이전트가 늘어 큐 대기 시간이 실제 병목으로 측정될 때 다시 보는 순서가 맞습니다. Claude Code로 여러 작업을 동시에 돌리고 있다면, 먼저 Claude Code 팁 11가지에 정리한 worktree 활용부터 점검해 보는 것도 좋습니다.
출처
- Anthropic 엔지니어링 블로그: anthropic.com/engineering/redesigning-source-control
- git pack-protocol 문서: git-scm.com/docs/pack-protocol
- CACM 2016: web.archive.org/web/20241231230143/https://cacm.acm.org/research/why-go…
- Microsoft 블로그: devblogs.microsoft.com/bharry/the-largest-git-repo-on-the-planet
- Meta 엔지니어링 블로그: engineering.fb.com/2022/11/15/open-source/sapling-source-control-scalab…
- sunshowers.io: sunshowers.io/posts/anthropic-mononoke
- sunshowers.io: sunshowers.io/posts/anthropic-mononoke-2
- HN 답글: news.ycombinator.com/item?id=50107559
- HN: news.ycombinator.com/item?id=50108205
- HN: news.ycombinator.com/item?id=50095847
- r/ClaudeAI: reddit.com/r/ClaudeAI/comments/1x5b5ek/redesigning_source_control_at_an…
- HN: news.ycombinator.com/item?id=50073633
- HN: news.ycombinator.com/item?id=50075274
- Simon Willison: simonwillison.net/2026/Oct/13/redesigning-source-control-at-anthropic
- YouTube: youtube.com/watch?v=hiI0Vk4NgeY
- HN: news.ycombinator.com/item?id=50082912
- HN: news.ycombinator.com/item?id=50075661
- HN: news.ycombinator.com/item?id=50080814
- The New Stack: thenewstack.io/anthropic-scion-git-replacement
- HN 답글: news.ycombinator.com/item?id=50079495
- HN 답글: news.ycombinator.com/item?id=50078904
- 긱뉴스: news.hada.io/topic?id=35309
- 솔루션뉴스: solnews.co.kr/news/articleView.html?idxno=84999
- HN 답글: news.ycombinator.com/item?id=50089160
- GitHub 블로그: github.blog/engineering/building-git-infrastructure-for-agent-scale-dev…
- 토스 기술 블로그: toss.tech/article/monorepo-pipeline
- GitHub 블로그: github.blog/open-source/git/get-up-to-speed-with-partial-clone-and-shal…
- GitHub 블로그: github.blog/open-source/git/bring-your-monorepo-down-to-size-with-spars…
- GitHub 블로그: github.blog/open-source/git/the-story-of-scalar