핵심 요약
- 토큰값은 Fable 5.2가 정확히 2배입니다. 100만 토큰당 입력 8달러·출력 40달러로 Opus 5.5(4달러·20달러)의 두 배이고, 캐시 읽기만 0.20달러로 같습니다.
- 성능은 Fable 5.2가 시스템 카드 비교표 16개 결과 가운데 14개에서 앞서지만, Anthropic 권장 출발점은 Opus 5.5입니다. Opus를 high 이상으로 올려도 모자란 일, 몇 시간짜리 무인 에이전트 작업에서 Fable 5.2로 올라가라고 안내합니다.
- "반값"은 Opus를 max까지 올려야 하는 코딩에서 나온 숫자입니다. Anthropic 초기 테스트에서 Fable 5.2 high는 Opus 5.5 max와 비슷한 코딩 점수를 과제당 비용 약 절반에 냈고, 3자 종합 측정에서는 같은 짝이 약 10% 쌌습니다.
- API에서 모델 이름만 바꾸면 비용이 3배를 넘을 수 있습니다. effort 기본값이 Fable 5.2는 high, Opus 5.5는 medium이라, Artificial Analysis 측정으로 과제당 2.45달러가 9.08달러가 됩니다.
- 구독에서 Fable이 정식으로 플랜 한도에 들어가는 곳은 Max·Ultra 플랜과 Team 프리미엄 좌석입니다. 주간 한도의 절반까지 추가 비용 없이 쓰고, Pro는 출시 혜택이 끝나면 사용량 크레딧으로 냅니다. Free는 쓸 수 없습니다.
최종 수정 2026-11-15
- 기준: Anthropic 발표문(11월 9일)과 시스템 카드, 개발자 문서의 모델·가격·effort 페이지, Claude 요금 페이지, Claude Code 문서, 고객 지원 문서, Artificial Analysis 모델 페이지를 2026년 11월 15일에 열어 본 내용입니다.
- 곧 바뀌는 것: Pro와 Team 표준 좌석의 Fable 출시 혜택(주간 한도 절반까지 포함, 리셋 1회)은 한국 시간 11월 17일 오후 4시 59분에 끝납니다. 그 뒤 Pro에서 Fable은 사용량 크레딧으로만 씁니다.
- Artificial Analysis 점수, 과제당 비용과 시간은 측정이 쌓이면 바뀝니다.
- 수정 기록: 2026-11-15 처음 씀.
목차
- Fable 5.2와 Opus 5.5는 어떻게 다른가
- 요금 비교: 토큰값은 정확히 2배
- 구독 플랜과 Claude Code에서 쓰는 법
- 같은 작업 비용 계산 예시
- 성능 비교: 공식 벤치마크
- effort를 맞춰 보면 달라지는 비용
- 써 본 사람들의 평가
- 바꾸기 전에 알아둘 차이
- 작업별로 고르는 법
- Fable 5.2로 바꾸기 전에 할 일
- 출처
Fable 5.2와 Opus 5.5는 어떻게 다른가
Fable 5.2(클로드 페이블 5.2)는 Anthropic의 최상위 공개 모델이고, Opus 5.5는 Anthropic이 "가장 강한 일상용 모델(strongest daily driver)"이라 부르는 기본 모델입니다. Fable 5.2는 2026년 11월 9일, Opus 5.5는 9월 22일에 나왔습니다. 같은 날 나온 Mythos 5.2는 Fable 5.2와 같은 모델인데, Fable에 걸린 사이버·바이오 안전장치 없이 승인받은 기관에만 열립니다(Introducing Claude Fable 5.2 and Claude Mythos 5.2, Anthropic, Choosing the right model, Claude 문서).
겉 사양은 거의 같습니다. Anthropic 모델 문서 기준으로 두 모델 모두 컨텍스트 100만 토큰, 최대 출력 12만 8천 토큰, 지식 기준 시점 2026년 6월이고, 답하기 전에 생각하는 adaptive thinking이 늘 켜져 있습니다. 생각하는 양을 정하는 effort도 low, medium, high, xhigh, max 다섯 단계로 같습니다(Models overview, Claude 문서, Effort, Claude 문서).
| 항목 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| 모델 ID | claude-fable-5-2 |
claude-opus-5-5 |
| 출시일 | 2026-11-09 | 2026-09-22 |
| 컨텍스트 / 최대 출력 | 100만 / 12만 8천 토큰 | 100만 / 12만 8천 토큰 |
| API effort 기본값 | high | medium |
| Claude Code effort 기본값 | medium | medium |
| Claude Code 기본 모델 | 아님(골라야 함) | 기본 모델 |
가장 큰 차이는 값과 effort 기본값입니다. 이 둘이 실제 비용을 어떻게 바꾸는지는 아래 계산 예시에서 봅니다. Opus 5.5 자체를 잘 쓰는 법은 Opus 5.5 잘 쓰는 법 10가지 글에 따로 정리했습니다.
요금 비교: 토큰값은 정확히 2배
API 정가로 Fable 5.2는 모든 항목에서 Opus 5.5의 2배이고, 캐시 읽기만 같습니다. 아래 표는 Anthropic 가격 문서의 100만 토큰(MTok)당 값입니다(Pricing, Claude 문서).
| 100만 토큰당 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| 입력 | $8 | $4 |
| 출력 | $40 | $20 |
| 캐시 쓰기(5분) | $10 | $5 |
| 캐시 쓰기(1시간) | $16 | $8 |
| 캐시 읽기 | $0.20 | $0.20 |
| Batch(입력/출력) | $4 / $20 | $2 / $10 |
| Fast mode(입력/출력) | $16 / $80 | $8 / $40 |
Fable 5.2 값은 이전 Fable 5.1(10달러/50달러)보다 20% 내렸습니다. 두 모델 모두 100만 토큰 컨텍스트 전체를 할증 없이 정가로 받습니다. 미국 안에서만 처리하도록 inference_geo를 "us"로 지정하면 모든 토큰 값에 1.1배가 붙습니다.
캐시 읽기 값이 같다는 점이 중요합니다. Anthropic 개발자 블로그는 캐시를 많이 쓰는 긴 작업에서는 두 모델의 차이가 캐시되지 않은 입력과 출력에서만 난다고 설명합니다(Which Claude model should you build with?, claude.dev). 반대로 5분 캐시 쓰기는 읽기보다 Fable 5.2에서 50배, Opus 5.5에서 25배 비쌉니다(Optimizing for cost and intelligence, Claude 문서). 모델을 중간에 바꾸면 캐시를 새로 써야 하니 한 작업 안에서는 모델을 자주 바꾸지 않는 편이 낫습니다.
구독 플랜과 Claude Code에서 쓰는 법
Free 플랜은 Fable을 못 쓰고, Pro는 출시 혜택이 끝나면 사용량 크레딧을 따로 내야 합니다. Anthropic 고객 지원 문서 기준 플랜별 조건은 아래와 같습니다(Claude Fable models on your plan, Claude Fable 5.2 launch offers).
| 플랜 | Fable 5.2 사용 | 출시 혜택 |
|---|---|---|
| Free | 못 씀 | 없음 |
| Pro, Team 표준 좌석 | 플랜 한도에 포함되지 않음, 사용량 크레딧으로 결제 | 11월 16일(태평양 시간)까지 주간 한도의 최대 50%를 Fable에, Fable 리셋 1회 |
| Max, Ultra, Team 프리미엄 좌석 | 주간 한도의 최대 50%까지 추가 비용 없이 | 구독 기간에 따라 Fable 리셋 1~3회(2027-03-08 만료) |
| 사용량 기반 Enterprise, API | API 단가 | 해당 없음 |
출시 혜택의 리셋은 11월 9일 오전 10시(태평양 시간) 전에 유료 결제가 있던 계정만 받습니다. 여기서 "주간 한도의 50%"는 한도가 늘어난다는 뜻이 아니라, 원래 주간 한도 가운데 절반까지를 Fable에 쓸 수 있다는 뜻입니다. 지원 문서는 Fable 모델이 다른 Claude 모델보다 사용 한도를 빨리 쓴다고 따로 적었습니다.
구독료는 Claude 요금 페이지 기준 Pro가 월 20달러(연간 결제 시 월 17달러), Max가 월 100달러, Ultra가 월 200달러이고, Team 표준 좌석은 월 25달러(연간 결제 시 20달러)입니다(Claude 요금). 요금 페이지는 달러로만 값을 적었고, 국내 매체가 적은 원화 금액(API 단가 등)은 환율로 환산한 값입니다.
웹, 데스크톱, 모바일 앱에서는 모델 선택 메뉴에서 "Fable 5.2"를 고르면 됩니다. Claude Code에서는 기본 모델이 그대로 Opus 5.5라 Fable 5.2는 직접 골라야 합니다. 2.1.321 이상에서 /model fable을 치거나 claude --model fable로 시작합니다. Pro처럼 Fable이 사용량 크레딧으로 넘어가는 플랜에서는 /model 목록의 Fable 줄에 "Requires usage credits"가 붙습니다. /model로 Fable로 바꾸면 메인 모델을 물려받는 하위 에이전트도 Fable로 돌기 때문에, 하위 에이전트를 다른 모델에 두려면 그 에이전트 정의에 model을 따로 적습니다(Model configuration, Claude Code 문서). Opus 5.5와 Claude Code 기본 사용법은 Claude Code 팁 11가지에 정리했습니다.
같은 작업 비용 계산 예시
입력 20만 토큰, 출력 3만 토큰짜리 작업 하나는 Fable 5.2가 2.80달러, Opus 5.5가 1.40달러입니다. 아래 계산은 모두 위 가격표로 필자가 했습니다.
| 경우 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| A. 캐시 없음: 입력 20만 + 출력 3만 | $1.60 + $1.20 = $2.80 | $0.80 + $0.60 = $1.40 |
| B. 입력 중 18만이 캐시 읽기, 새 입력 2만 + 출력 3만 | $0.16 + $0.036 + $1.20 = 약 $1.40 | $0.08 + $0.036 + $0.60 = 약 $0.72 |
B처럼 입력 대부분이 이미 캐시에 올라가 있으면 입력 쪽 차이가 크게 줄어듭니다. 다만 처음 캐시에 올리는 18만 토큰에는 5분 캐시 쓰기 값(Fable 1.80달러, Opus 0.90달러)이 한 번 붙고, 비용 대부분이 출력이라 전체로는 여전히 2배 가까이 납니다.
진짜 함정은 effort입니다. 같은 일을 시켜도 effort가 높을수록 생각에 쓰는 출력 토큰이 늘어납니다. 3자 평가 기관 Artificial Analysis가 같은 지수 시험을 돌린 결과로 두 모델의 배수를 맞대 보면 이렇습니다(Artificial Analysis, Claude Fable 5.2, Artificial Analysis, Claude Opus 5.5). 토큰과 비용은 Artificial Analysis 값이고 배수는 필자 계산입니다.
| Fable 설정 / 비교할 Opus 설정 | 출력 토큰 비율 × 단가 2배 | 과제당 비용 비율 |
|---|---|---|
| medium / medium | 4,100만 ÷ 4,250만 × 2 = 약 1.9배 | $3.80 ÷ $2.45 = 약 1.6배 |
| high / medium (API에서 이름만 바꾼 경우) | 8,530만 ÷ 4,250만 × 2 = 약 4.0배 | $9.08 ÷ $2.45 = 약 3.7배 |
| high / max | 8,530만 ÷ 2억 1,800만 × 2 = 약 0.8배 | $9.08 ÷ $10.04 = 약 0.9배 |
| max / max | 2억 7,500만 ÷ 2억 1,800만 × 2 = 약 2.5배 | $26.54 ÷ $10.04 = 약 2.6배 |
API에서 effort를 적지 않고 모델 이름만 claude-opus-5-5에서 claude-fable-5-2로 바꾸면 Opus medium이 Fable high로 바뀌어 과제당 비용이 3배 넘게 뜁니다. 단가가 2배이므로 Fable이 더 싸지려면 같은 일을 Opus의 절반보다 적은 토큰으로 끝내야 하고, 반값이 되려면 대략 4분의 1이어야 합니다. 이 표에서 Fable이 더 싼 짝은 Opus를 max까지 올린 경우(약 0.9배)뿐이었고, 반값까지 간 짝은 없었습니다. 반값은 아래 Anthropic의 FrontierCode 2.0 초기 테스트 결과입니다.
성능 비교: 공식 벤치마크
Fable 5.2는 시스템 카드 비교표에서 지식 업무 Elo 평가 두 개를 빼고 Opus 5.5보다 높았습니다. Anthropic 시스템 카드가 Fable 5.2 결과로 든 16개 가운데 14개에서 Fable 5.2가 가장 높았습니다. 아래 숫자는 발표문 표에서 고른 것으로, 각 모델의 가장 높은 effort, 안전장치를 켠 상태의 결과입니다. 예외는 두 가지입니다. FrontierCode 2.0의 Fable 5.2 점수는 xhigh, Remote Labor Index는 평가 기관 Scale AI의 기본 설정대로 두 모델 모두 high 결과입니다(Anthropic 발표문, System Card: Claude Fable 5.2 & Claude Mythos 5.2).
| 시험(영역) | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0(에이전트 코딩) | 49.1% | 45.5% |
| FrontierSWE v2(에이전트 코딩) | 69.9% | 62.3% |
| AutomationBench(업무 자동화) | 51.4% | 42.5% |
| Remote Labor Index(실제 원격 업무 완수) | 41.3% | 21.3% |
| WANDR(에이전트 검색) | 82.1% | 72.3% |
| OSWorld 2.1(컴퓨터 사용) | 89.3% | 87.2% |
| HLE, 도구 사용(다분야 추론) | 74.2% | 67.7% |
| AA-Briefcase v1.1 Elo(지식 업무) | 1785 | 1800 |
차이가 큰 곳은 실제 원격 업무를 끝까지 해내는 비율(Remote Labor Index, 약 2배)과 긴 에이전트 작업입니다. 컴퓨터 사용(OSWorld)처럼 이미 둘 다 높은 시험은 2점 남짓 차이입니다. 문서·보고서 같은 지식 업무 평가(AA-Briefcase Elo)는 Opus 5.5가 조금 앞섰고, 시스템 카드의 GDPval-AA Elo도 Opus 5.5가 1866으로 Fable 5.2(1831)보다 높았습니다. 다만 같은 AA-Briefcase의 채점표 점수는 Fable 5.2가 66.1%로 Opus 5.5(61.2%)보다 높았습니다.
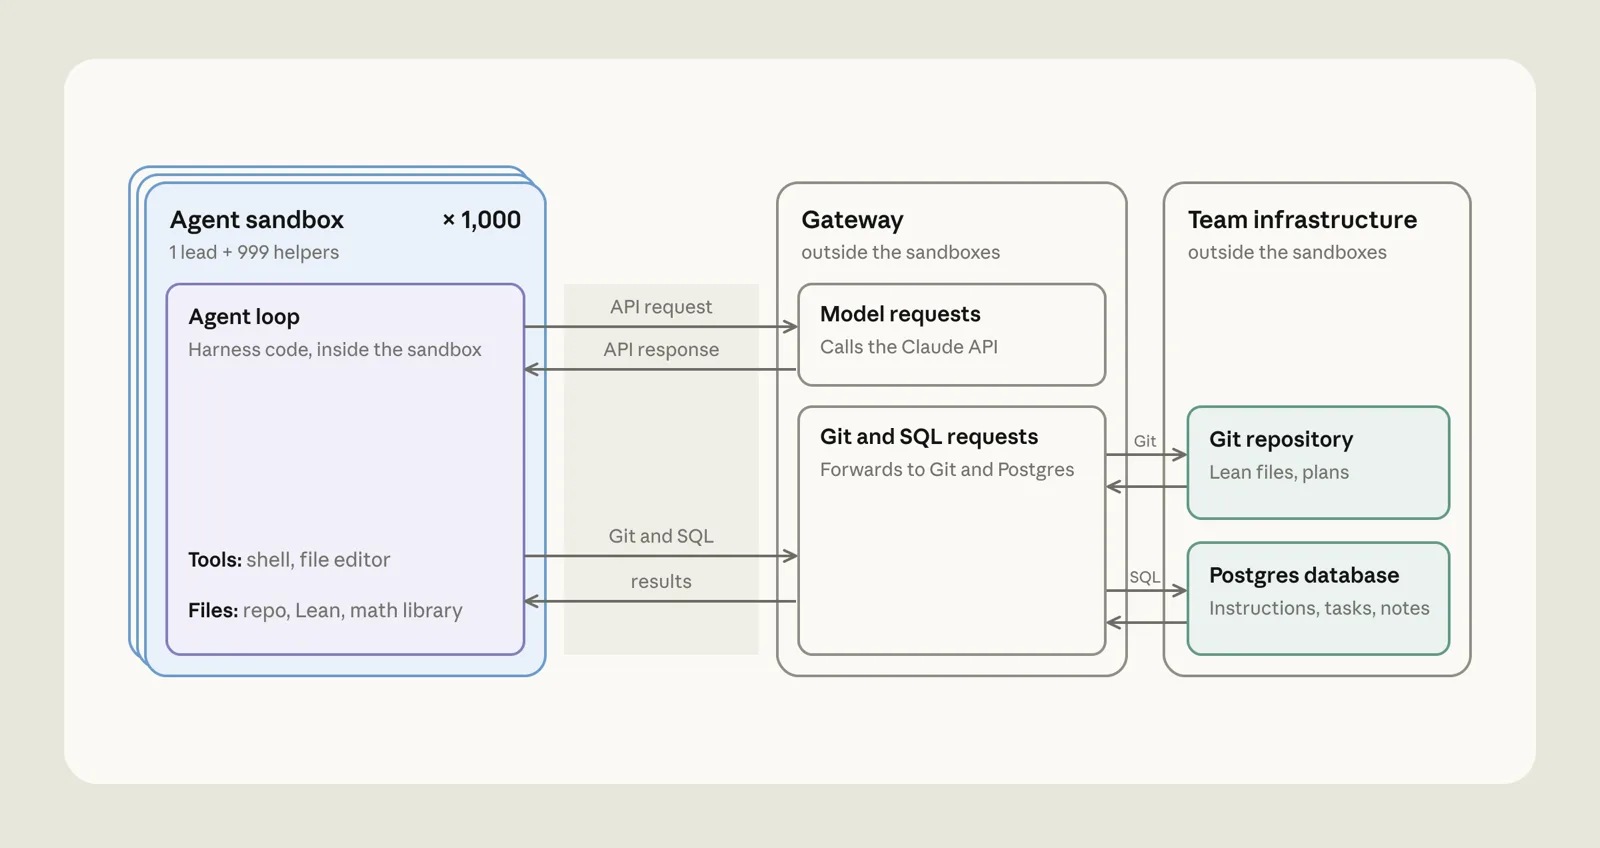
긴 무인 작업의 차이는 Anthropic의 수학 증명 실험에서 잘 보입니다. Fable 5.2 초기 버전 에이전트 1,000개(리드 1개, 도우미 999개)가 페르마의 마지막 정리를 증명 검증 언어 Lean으로 옮기는 일을 28.7시간 만에 끝냈습니다. 같은 구성의 Opus 5.5 팀은 18시간 동안 26%를 했고, 30시간이 지나도 27%에 머물렀습니다(Anthropic 발표문). 이 실행은 18시간 무렵 멈췄다가 마지막 저장 지점에서 12시간을 더 준 것이고, 달러 비용은 공개되지 않았습니다(Safely scaling multi-agent teams with Claude Fable 5.2, claude.dev).
effort를 맞춰 보면 달라지는 비용
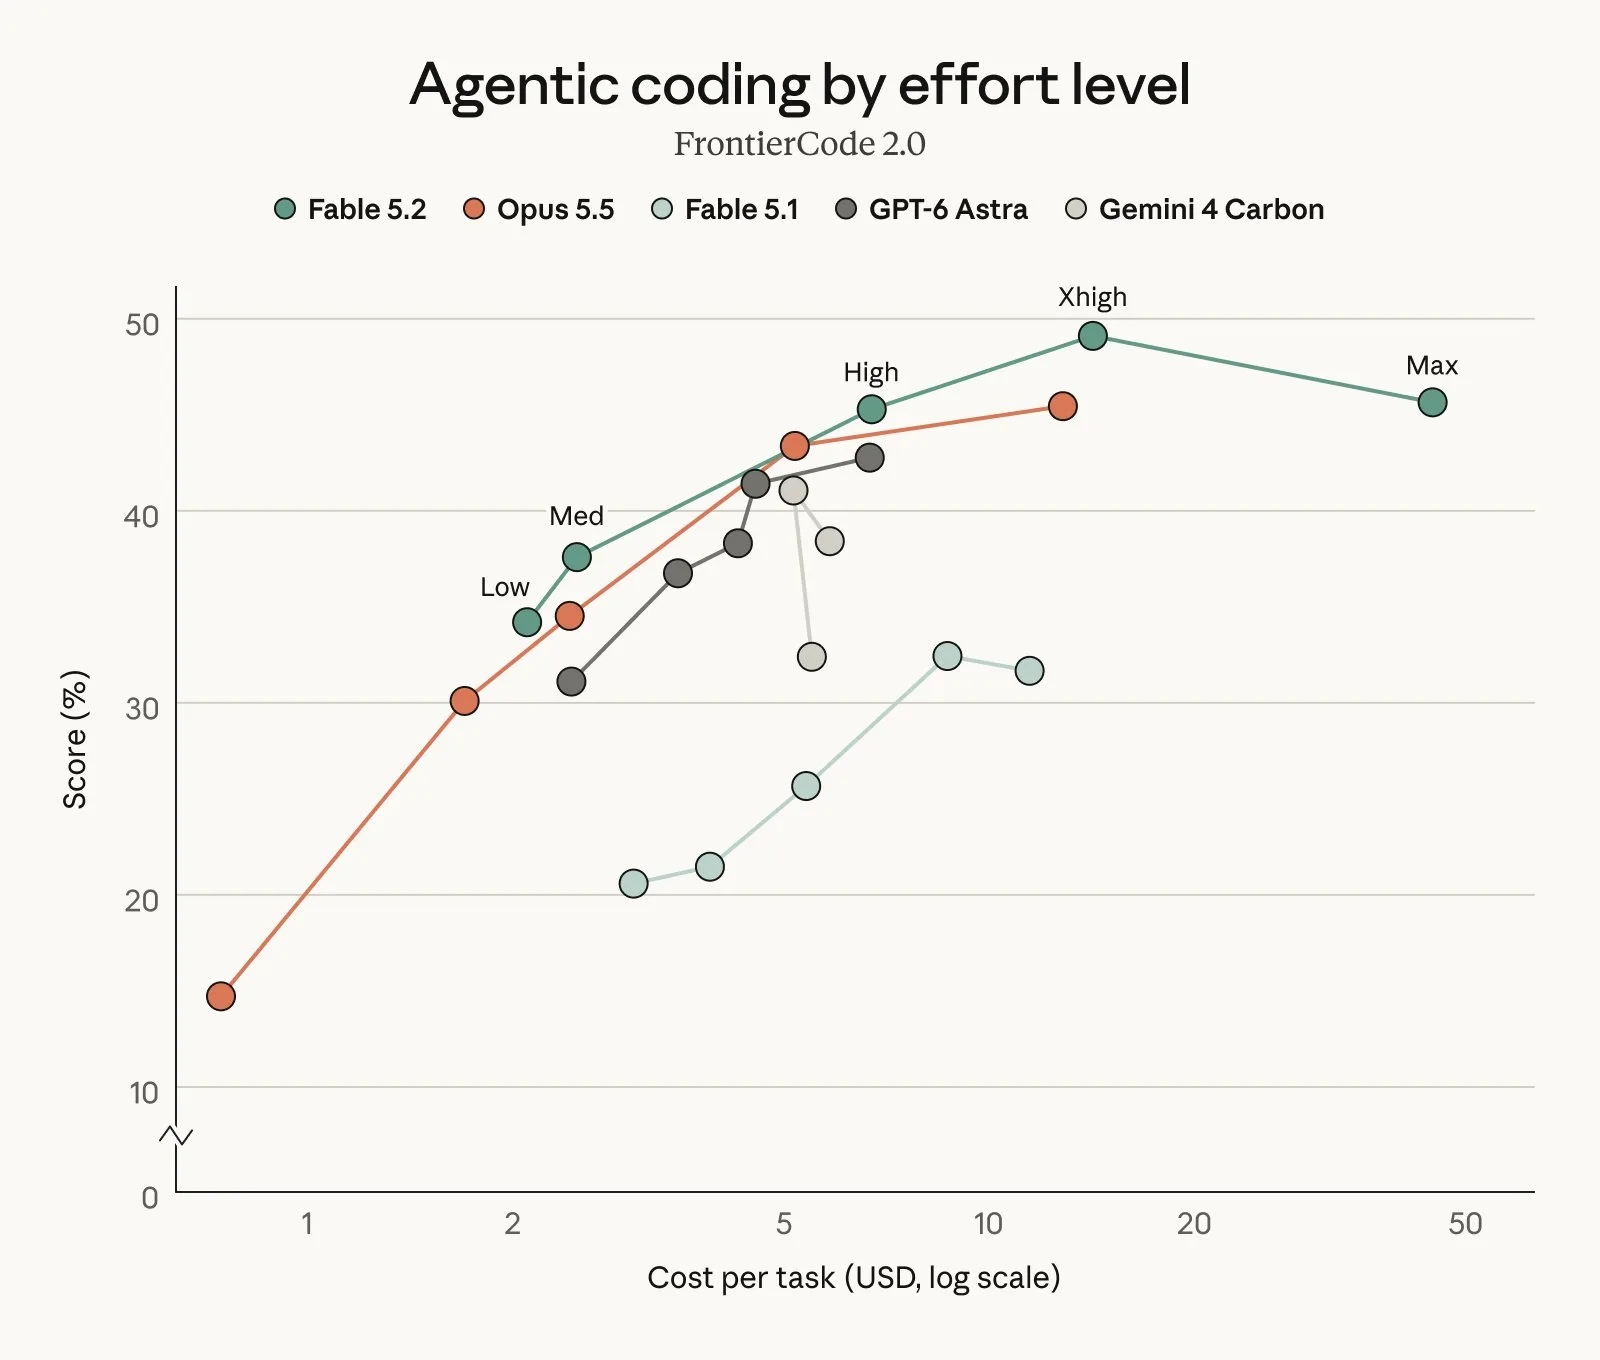
같은 점수를 내는 데 드는 돈으로 비교하면 Fable 5.2가 더 쌀 때가 있습니다. 제목의 "반값"이 여기서 나옵니다. Anthropic은 초기 테스트에서 에이전트 코딩 시험 FrontierCode 2.0의 Fable 5.2 high가 45.3%로 Opus 5.5 max의 최고점(45.5%)과 비슷한 점수를 과제당 비용 약 절반에 냈다고 밝혔습니다(Anthropic 발표문). 3자 측정인 Artificial Analysis 지능 지수(여러 시험 묶음)에서는 같은 짝이 약 10%만 쌌습니다(위 계산 예시 배수표 3행).
Artificial Analysis의 지능 지수(여러 시험을 묶은 점수)로 봐도 방향이 같습니다. 2026년 11월 15일 기준 값이고, high와 점수가 같고 더 비싼 Fable 5.2 xhigh(62점, 14.83달러)와 Opus 5.5 low(35점, 0.98달러)는 표에서 뺐습니다.
| 설정 | 지수 | 과제당 비용 |
|---|---|---|
| Opus 5.5 medium | 48 | $2.45 |
| Opus 5.5 high | 52 | $3.46 |
| Fable 5.2 low | 54 | $3.10 |
| Fable 5.2 medium | 56 | $3.80 |
| Opus 5.5 xhigh | 57 | $6.05 |
| Opus 5.5 max | 59 | $10.04 |
| Fable 5.2 high | 62 | $9.08 |
| Fable 5.2 max | 65 | $26.54 |
Fable 5.2 low는 Opus 5.5 high보다 점수가 높고 조금 쌉니다. Fable 5.2 high는 과제당 약 16분으로 Opus 5.5 max(약 25분)보다 빨리 끝냈습니다. Artificial Analysis도 공식 게시물에서 낮은 effort의 Fable 5.2가 Opus 5.5를 더 적은 과제당 비용으로 이길 수 있다고 썼습니다(Artificial Analysis 공식 X).
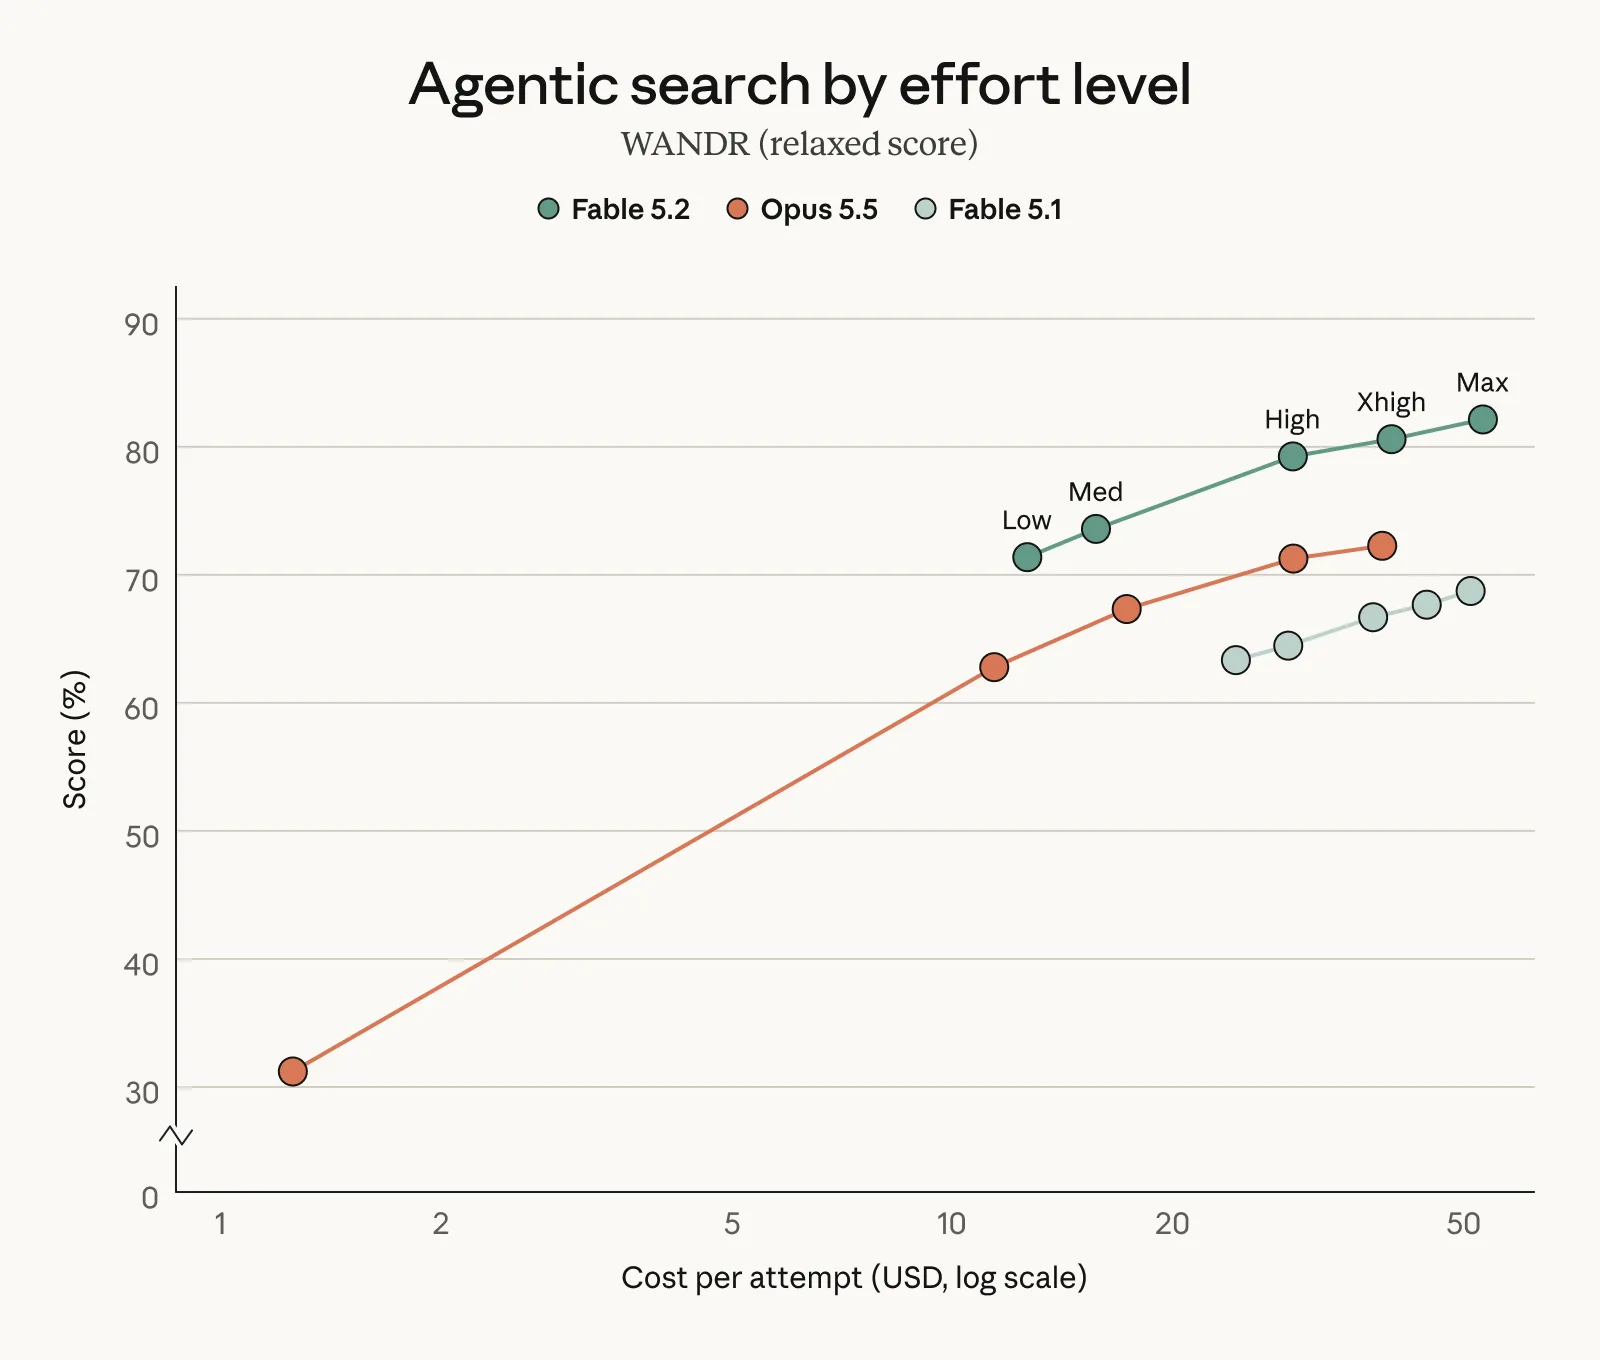
에이전트 검색 시험 WANDR에서는 차이가 더 큽니다. Anthropic은 Fable 5.2 medium이 Opus 5.5의 최고점과 같은 점수를 과제당 비용 약 40%에 냈다고 밝혔습니다(Anthropic 발표문).
반대 결과도 있습니다. Anthropic의 비용 최적화 문서에서 SWE-bench Pro 문제 463개로 잰 결과에서는 Opus 5.5 xhigh(96.5%)가 Fable 5.2 high(96.3%)와 같은 수준을, 푼 과제 하나당 비용 절반 남짓에 냈습니다. 딥 리서치 시험 DeepResearch Bench II에서는 기본 effort의 Fable 5.2가 Opus 5.5보다 2.9배 비싸면서 점수는 1.9점 낮았습니다(Optimizing for cost and intelligence, Claude 문서). 정리하면 이렇습니다.
- 같은 effort끼리 비교하면 Fable 5.2가 대개 더 비쌉니다. 배수는 위 계산 예시의 두 번째 표에 있습니다.
- 같은 점수를 노리면, 그 점수가 Opus에게 max 수준을 요구하는 어려운 일일 때 Fable 5.2가 같거나 더 쌀 수 있습니다.
- 어느 쪽이 맞는지는 작업마다 다르니 내 작업으로 재 봐야 합니다.
써 본 사람들의 평가
출시 첫 주에 나온 후기는 어려운 일에서는 확실히 낫고 한도는 빨리 줄어든다는 쪽으로 모입니다. 아래는 필자가 직접 잰 결과가 아니라 국내외 사용자들이 올린 체험담이고, 대부분 몇 번 돌려 본 결과입니다.
어려운 일에서 차이가 납니다. Hacker News의 한 사용자는 Opus 5.5가 11일 동안 만든 프로젝트를 Fable 5.2에 검토시키자 30분 만에 5시간 한도를 다 쓰고 심각한 버그 7개를 보고했다고 썼습니다. 버그가 진짜인지는 아직 확인하지 않았다고 덧붙였습니다(Hacker News). 클리앙에서는 3D 프린팅용 컵 케이스 설계를 맡겼더니 Opus 5.5 medium이 잘 못하기도 하던 출력용 형상 최적화까지 해냈다는 글이 올라왔습니다(클리앙). 유튜브 스마트대디는 같은 프롬프트로 게임, 3D 장면, 영상 예고편 등 5개 과제를 Fable 5.2, Opus 5.5, GPT-6 Astra에 맡겨 Fable 5.2가 4번 이기고 1번 비겼다고 했습니다(스마트대디 유튜브). GPT-6 Astra와 Opus 5.5를 같은 과제로 맞붙인 필자의 실험은 Opus 5.5 vs GPT-6 Astra 글에 있습니다.
평범한 일에서는 차이가 잘 안 보입니다. 같은 Hacker News 스레드에서는 "평범한 코딩에서는 Fable 5.2와 Opus 5.5를 구분하기 어렵다"는 댓글의 답글 타래가 가장 길었고, 비슷한 경험을 적은 답글도 이어졌습니다. 한 네이버 블로거는 납품 일정을 바꾸는 업무 메일을 네 모델에 한 번씩 맡겼는데 넷 다 잘 썼고, Fable 5.2는 메모의 날짜가 틀린 경우까지 짚은 정도의 차이였다고 적었습니다(kaltoe_ai 블로그).
비용과 한도는 자주 나온 불만입니다. 유튜버 단테는 API 단가로 비용을 환산해 비교했습니다. 같은 3D 장면 과제를 medium으로 세 번씩 돌리니 평균 Fable 5.2가 3.75달러, Opus 5.5가 1.49달러였습니다. 코딩 미궁 과제에서는 Fable 5.2 high가 Opus 5.5 max 비용의 56%로 같은 결과를 냈지만, 같은 결과를 가장 싸게 낸 것은 1.71달러가 든 Opus 5.5 medium이었습니다. 그래서 "Opus medium으로 시작하고, 모자라면 Opus max 대신 Fable high로 바로 간다"는 순서를 권했습니다(단테 유튜브). 클리앙의 3D 프린팅 작성자는 첫 제작 20분에 사용량 17%를 썼고(클리앙, 컵 설계 글), 다음 날 작업을 마무리하려고 리셋권을 바로 썼다고 했습니다(클리앙, 자작품 개선 글).
나눠 쓰는 방식이 자리 잡고 있습니다. 같은 클리앙 글 댓글의 "페이블로 계획만 잡고 노가다는 오퍼스", 스마트대디의 "설계, 기획, 검수는 페이블, 실행은 오퍼스 5.5"처럼 설계·검토는 Fable, 구현은 Opus에 맡기겠다는 사용자가 여럿 보입니다. MINDUNG 유튜브는 공개 성능표를 비슷한 비용끼리 짝지어, 평소 Opus high를 쓰면 Fable medium과, Opus xhigh를 쓰면 Fable high와 비교해 볼 만하다고 정리했습니다(MINDUNG 유튜브). 다만 xhigh와 high 짝은 Artificial Analysis 기준 Fable 쪽이 1.5배쯤 비쌉니다. 한국어 답변 품질을 따로 잰 공식 자료나 국내 비교는 아직 찾지 못했습니다.
바꾸기 전에 알아둘 차이
Fable 5.2는 더 비쌀 뿐 아니라 몇 가지 동작이 Opus 5.5와 다릅니다. 개발자 문서와 발표문에서 옮기기 전에 알아둘 것만 추렸습니다(What's new in Claude Fable 5.2, Claude Fable 5.2 모델 문서).
- 데이터 보관: Fable 5.2는 30일 데이터 보관이 필요하고, 따로 승인받지 않으면 데이터를 남기지 않는 무보관(ZDR) 조건으로 쓸 수 없습니다.
- 모델 전환: Fable 5.2의 생각(thinking) 블록은 Fable 5.2와 Mythos 5.2만 읽습니다. 대화 중간에 다른 모델로 내려가면 그때까지의 추론은 버려지고 캐시도 새로 씁니다.
- 낮은 effort의 조기 종료: 긴 작업 도중 턴을 일찍 끝내는 일이 있고, low와 medium에서 더 잦다고 문서가 적었습니다.
- 하위 에이전트 비용: Fable 5.2가 하위 에이전트에 일을 나누면 그 비용이 전체 비용의 큰 몫이 될 수 있습니다.
- 안전장치와 대체 모델: Opus 5.5에도 안전 분류기가 있어, Claude Code에서는 두 모델 모두 사이버 쪽 요청은 Opus 4.8, 바이오 쪽 요청은 Opus 5로 다시 보냅니다(Model configuration, Claude Code 문서). Fable 5.2는 침투 테스트, 익스플로잇 작성 같은 고위험 사이버 작업과 연구용 생물학 작업 대부분을 막고, Anthropic은 초기 테스트에서 차단이 Fable 5.1보다 약 55% 줄었다고 밝혔습니다(Anthropic 발표문). 두 모델의 차단 빈도를 직접 비교한 공식 자료는 없습니다. API에서는 거절로 돌아오므로 서버 쪽 대체(fallback, 베타)를 켜거나 직접 다른 모델로 다시 보내야 합니다.
작업별로 고르는 법
모르겠으면 Opus 5.5 medium에서 시작하고, effort를 high 이상으로 올려도 모자랄 때 Fable 5.2를 시험해 봅니다. 공식 자료마다 경계가 조금 다릅니다. Anthropic 모델 선택 문서는 "모델을 바꾸는 것보다 effort를 조절하는 편이 더 나은 수단일 때가 많다"고 하면서, xhigh나 max에서도 평가가 모자라면 Fable 5.2로 옮기라고 안내합니다(Choosing the right model, Claude 문서). 개발자 블로그는 한 걸음 더 나가 "high를 넘긴다면 차라리 다음 모델을 더 낮은 effort로 시험하라"고 적었습니다(claude.dev).
| 작업 | 추천 | 이유 |
|---|---|---|
| 일상 코딩, 버그 수정, 문서·메일 작성 | Opus 5.5 medium | 차이가 작고, 같은 medium끼리도 Opus 과제당 비용이 Fable의 약 3분의 2 |
| 복잡한 에이전트 코딩, 리팩터링, 컴퓨터 사용 | Opus 5.5 high, 모자라면 Fable 5.2 medium | Anthropic 모델 선택 문서가 Opus 5.5 영역으로 분류(개발자 블로그는 대형 리팩터링을 Fable 쪽에 둠) |
| Opus를 max로 돌리던 어려운 문제 | Fable 5.2 high | 같은 점수를 비슷하거나 더 적은 비용에 낼 수 있음 |
| 몇 시간짜리 무인 에이전트, 대형 마이그레이션, 많은 하위 에이전트 지휘 | Fable 5.2 medium부터, 무인 실행은 high도 비교 | 긴 작업에서 차이가 가장 큼. medium은 일을 남기고 턴을 끝내는 일이 더 잦음 |
| 딥 리서치, 과학·정량 분석 | 두 모델을 같이 재 보고 결정 | 개발자 블로그는 Fable 쪽에 두지만, 딥 리서치 시험에서는 Fable이 더 비싸고 점수가 낮았음 |
| 보고서·문서 같은 지식 업무 | 일상 문서는 Opus 5.5, 여러 단계 분석을 완성 문서·스프레드시트·발표 자료까지 이어 가는 일은 Fable 5.2 | Elo 평가는 Opus 5.5가 조금 앞서지만, 공식 선택표는 완성 문서까지 가는 분석을 Fable 5.2 예로 듦 |
구독자라면 Fable은 한 작업을 끝까지 맡길 때보다 설계, 검토, 막힌 문제에 짧게 쓰는 편이 한도를 아낍니다. 클리앙에서도 "100달러 요금제 오퍼스 5.5 중간으로만 써도 늘상 간당간당해서, 어려운거만 페이블 시킵니다"라는 댓글이 나왔습니다(클리앙).
Fable 5.2로 바꾸기 전에 할 일
- 지금 쓰는 effort부터 확인합니다. Opus 5.5를 medium이나 high로 쓰고 있고 결과가 충분하면 바꿀 이유가 적습니다. max를 자주 쓴다면 Fable 5.2 high와 비교해 볼 차례입니다. xhigh라면 Fable 5.2 high가 더 비쌀 수 있으니 결과 차이까지 봅니다.
- API라면 effort를 직접 적습니다. 모델 이름만 바꾸면 Fable 5.2는 high로 돌아 과제당 비용이 3배 넘게 뛸 수 있습니다. API 문서는 Fable 5.2를 high에서 시작하라고 권하지만, 비용이 먼저라면 medium으로 재 보고 모자랄 때 올리는 편이 안전합니다.
- 같은 작업 서너 개로 비용과 결과를 같이 잽니다. 점수만 보지 말고 과제당 비용, 걸린 시간, 다시 시킨 횟수를 함께 적습니다. 출력 상한(
max_tokens)은 Anthropic 권장대로 에이전트 작업에서 6만 4천 정도로 넉넉히 둡니다. - 구독자는 Fable 쓸 일을 정해 둡니다. 설계와 검토, Opus가 두세 번 실패한 문제처럼 Fable에 맡길 일을 미리 정합니다. Claude Code에서 Fable을 메인으로 쓸 때는 하위 에이전트 정의에 Opus 5.5를 적어 두면 한도를 덜 씁니다.
출처
- Introducing Claude Fable 5.2 and Claude Mythos 5.2, Anthropic: anthropic.com/claude-fable-and-mythos-5-2
- Choosing the right model, Claude 문서: platform.claude.com/docs/en/about-claude/models/choosing-a-model
- Models overview, Claude 문서: platform.claude.com/docs/en/models/overview
- Effort, Claude 문서: platform.claude.com/docs/en/build-with-claude/effort
- Pricing, Claude 문서: platform.claude.com/docs/en/about-claude/pricing
- Which Claude model should you build with?, claude.dev: claude.dev/blog/which-claude-model-should-you-build-with
- Optimizing for cost and intelligence, Claude 문서: platform.claude.com/docs/en/about-claude/models/optimizing-for-cost-and…
- Claude Fable models on your plan: support.claude.com/en/articles/15424964-claude-fable-models-on-your-plan
- Claude Fable 5.2 launch offers: support.claude.com/en/articles/17506494-claude-fable-5-2-launch-offers
- Claude 요금: claude.com/pricing
- Model configuration, Claude Code 문서: code.claude.com/docs/en/model-config
- Artificial Analysis, Claude Fable 5.2: artificialanalysis.ai/models/claude-fable-5-2
- Artificial Analysis, Claude Opus 5.5: artificialanalysis.ai/models/claude-opus-5-5
- System Card: Claude Fable 5.2 & Claude Mythos 5.2: anthropic.com/document/claude-fable-5-2-mythos-5-2-system-card
- Safely scaling multi-agent teams with Claude Fable 5.2, claude.dev: claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2
- Anthropic 공식 X: x.com/claudeai/status/2119867122683953298
- Artificial Analysis 공식 X: x.com/ArtificialAnlys/status/2119878995386982508
- Hacker News: news.ycombinator.com/item?id=50429068
- 클리앙, 컵 설계 글: clien.net/service/board/park/19290340
- 스마트대디 유튜브: youtube.com/watch?v=s4-n3qQ1BPQ
- kaltoe_ai 블로그: blog.naver.com/kaltoe_ai/224476912654
- 단테 유튜브: youtube.com/watch?v=NPyi7jGHwHc
- 클리앙, 자작품 개선 글: clien.net/service/board/park/19290588
- MINDUNG 유튜브: youtube.com/watch?v=0y3O5gt2yPA
- What's new in Claude Fable 5.2: platform.claude.com/docs/en/models/fable-5-2/whats-new-fable-5-2
- Claude Fable 5.2 모델 문서: platform.claude.com/docs/en/models/fable-5-2/overview