핵심 요약
- 클로드 메모리란 Claude가 경험에서 얻은 지식을 세션이 끝난 뒤에도 남겨 두었다가 다음 세션에서 다시 읽는 노트입니다. 모델 가중치를 바꾸는 학습이 아닙니다. Anthropic은 지난 대화 기록과 노트를 대조해 틀린 메모를 고치고 위키 같은 구조를 만드는 작업을 dreaming이라고 부릅니다.
- 포켓몬 레드에서 Sonnet 3.7은 메모 파일 413개를 쓰고 배지 1개를, Fable 5는 파일 10개(폴더 2개 안의 9개와 global.md)를 쓰고 배지 4개를 얻었습니다. 화면에서 읽을 수 있는 정보는 적지 않고 직접 알아낸 전략만 남긴 쪽이 앞섰습니다. 다만 모델마다 한 번씩 돌린 결과이고 모델 세대도 달라서, 배지 차이를 메모리 전략만의 효과로 볼 수는 없습니다.
- CL-Bench 데이터베이스 과제에서는 메모리 폴더가 있다고 알려 주기만 해도 Opus 5의 평균 보상이 0.564에서 0.828로 올랐습니다. 반대로 "실패만 기록하라"는 규칙을 주자 메모리로 얻는 이득이 Opus 5는 0.234, Opus 4.7은 0.150 줄었습니다. 무엇에 쓰는지만 알려 주고 쓰는 법은 모델에 맡기라는 것이 원문의 결론입니다.
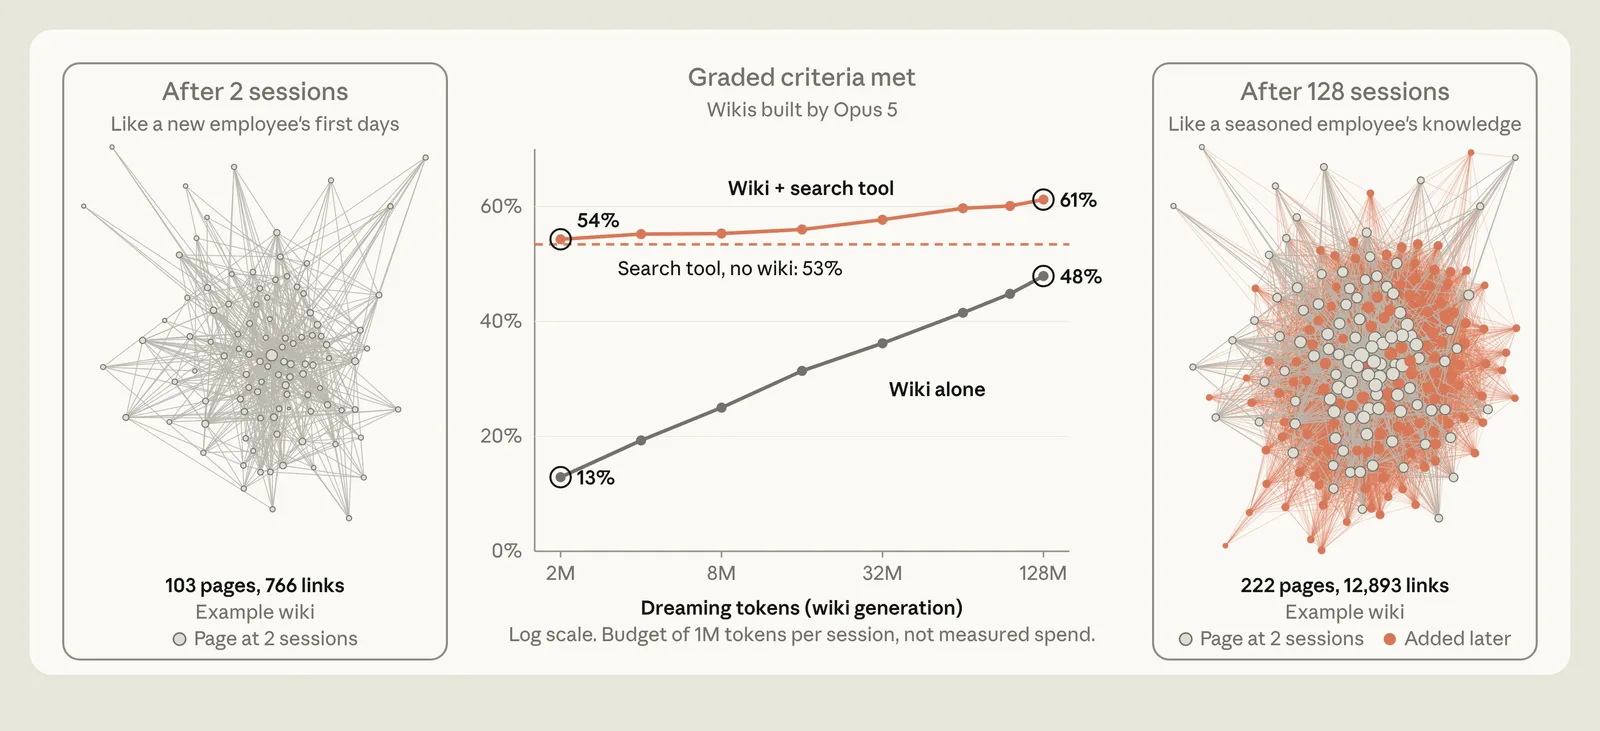
- dreaming으로 만든 위키는 위키만 쓸 때 채점 기준 충족 비율을 13%에서 48%로, 검색과 함께 쓸 때 54%에서 61%로 올렸습니다. 검색만 쓰면 53%였습니다. 한 문서만 찾으면 되는 과제에서는 뚜렷한 이득이 없었고, 바탕 문서보다 1.77배 커져 요약 노릇을 못 한 위키도 나왔습니다.
- 필자가 Claude Code 2.1.319로 재 보니 MEMORY.md는 200줄 또는 25,000자에서 잘렸습니다. 25KB는 바이트가 아니라 글자 수라서, 한글이 3바이트라 빨리 잘린다는 걱정은 맞지 않습니다. 필자 맥의 한 프로젝트는 색인이 264줄이라, 이 규칙대로 계산하면 아래 64줄이 세션 시작 때 실리지 않습니다.
목차
- 클로드 메모리란: 세션을 넘어 남기는 노트
- 포켓몬 실험: 413개와 10개
- 메모리를 쓰라고만 해도 점수가 오른다
- dreaming: 틀린 메모를 기록과 대조해 고친다
- 위키는 언제 도움이 되고 언제 부풀까
- 직접 재 보니: MEMORY.md는 200줄, 25,000자에서 잘린다
- 내 클로드 코드 메모리 정리하는 법
- 출처
클로드 메모리란: 세션을 넘어 남기는 노트
클로드 메모리란 Claude가 사용자와의 대화나 맡은 작업에서 얻은 지식을 세션이 끝난 뒤에도 남겨 두고, 나중에 다시 읽는 컨텍스트입니다. Anthropic이 2026년 11월 6일 엔지니어링 글 "The components of agent memory"(글쓴이 Lance Martin)에서 이렇게 정의했습니다(Anthropic). 같은 글은 메모리에서 빼는 것도 분명히 적었습니다. 학습으로 정해지는 모델 가중치의 변화, 한 대화 안에서만 쓰이는 문맥 내 학습(in-context learning), 오래된 대화를 요약으로 바꿔 끼우는 compaction은 메모리가 아닙니다.
그러니 클로드 메모리는 모델이 다시 학습해 똑똑해지는 기능이 아닙니다. 이 글이 다루는 메모리는 Claude Code나 Managed Agents 같은 에이전트가 파일로 남기는 메모리이고, Claude 앱 채팅의 메모리 설정과는 다른 이야기입니다. 디스크에 남은 글을 다음 세션이 읽는 구조이고, 그 글을 무엇으로 채우느냐가 성능을 가릅니다. 해커 뉴스에서도 가중치를 바꾸지 않으면 진짜 기억이 아니라는 비판과, 파일이라서 잘못된 기억을 찾아 지울 수 있다는 반론이 맞섰습니다(해커 뉴스).
Anthropic은 메모리를 네 층으로 나눕니다. 아래층일수록 원재료에 가깝고, 맨 위층은 매 세션 실리기 때문에 작게 유지해야 합니다.
- 대화 기록(transcripts): 세션에서 일어난 일을 검색할 수 있게 남긴 이벤트 기록입니다.
- 메모리 노트: Claude가 세션 중에 중요하다고 판단해 직접 쓴 노트입니다.
- 메모리 표현: 노트와 기록을 엮어 만든 위키 같은 구조입니다.
- 주입 컨텍스트: 매 세션 시작 때 미리 싣는 맨 위층입니다.
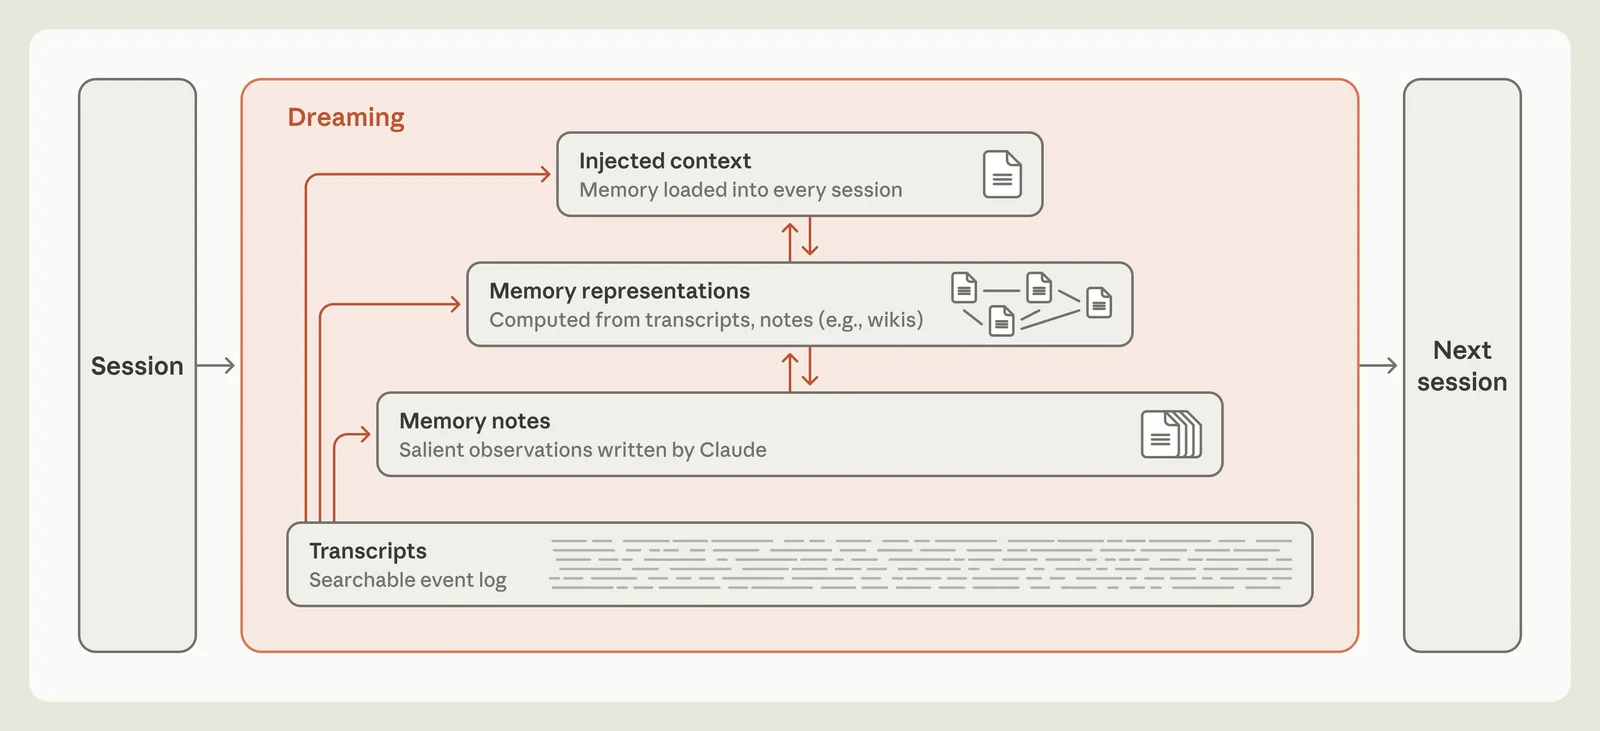
dreaming은 아래층 기록을 다시 읽어 위층을 고치거나 새로 만드는 작업입니다. Anthropic은 사람이 잠자는 동안 해마가 낮의 경험을 재생해 장기 기억으로 옮긴다는 설명에 빗대 이 이름을 썼습니다. 원문에 따르면 dreaming은 틀린 메모를 고치고, 새 노트를 만들고, 위키를 짓고, 다음 세션에 미리 실릴 내용을 고를 수 있습니다.
필자가 Claude Code의 자동 메모리에 이 층을 대응시켜 보면 이렇습니다. 공식 문서에 따르면 프로젝트마다 ~/.claude/projects/<project>/memory/ 폴더가 생기고, 같은 git 저장소의 워크트리와 하위 폴더는 이 폴더 하나를 함께 씁니다(Claude Code 메모리 문서). 그 안의 MEMORY.md 앞부분이 매 대화 시작 때 실리는 주입 컨텍스트이고, 색인이 가리키는 주제 파일들이 메모리 노트에 해당합니다. 자동 메모리는 로컬 세션에서 기본으로 켜져 있습니다.
원문은 메모리가 때로는 "예측"이라고 봅니다. 규칙을 적는다는 것은 그 패턴이 다시 쓰일 것이라고 예측하는 일이고, 확인한 사실을 적는다는 것은 다음 세션이 그 사실을 다시 확인하지 않고 믿어도 된다고 예측하는 일이라는 설명입니다. 예측이 빗나가면 쓸모없는 메모가 쌓이거나, 더 나쁘게는 틀린 메모를 믿게 됩니다. 아래 실험들은 결국 이 예측을 얼마나 잘하는지, 빗나간 예측을 어떻게 고치는지를 잰 것입니다.
포켓몬 실험: 413개와 10개
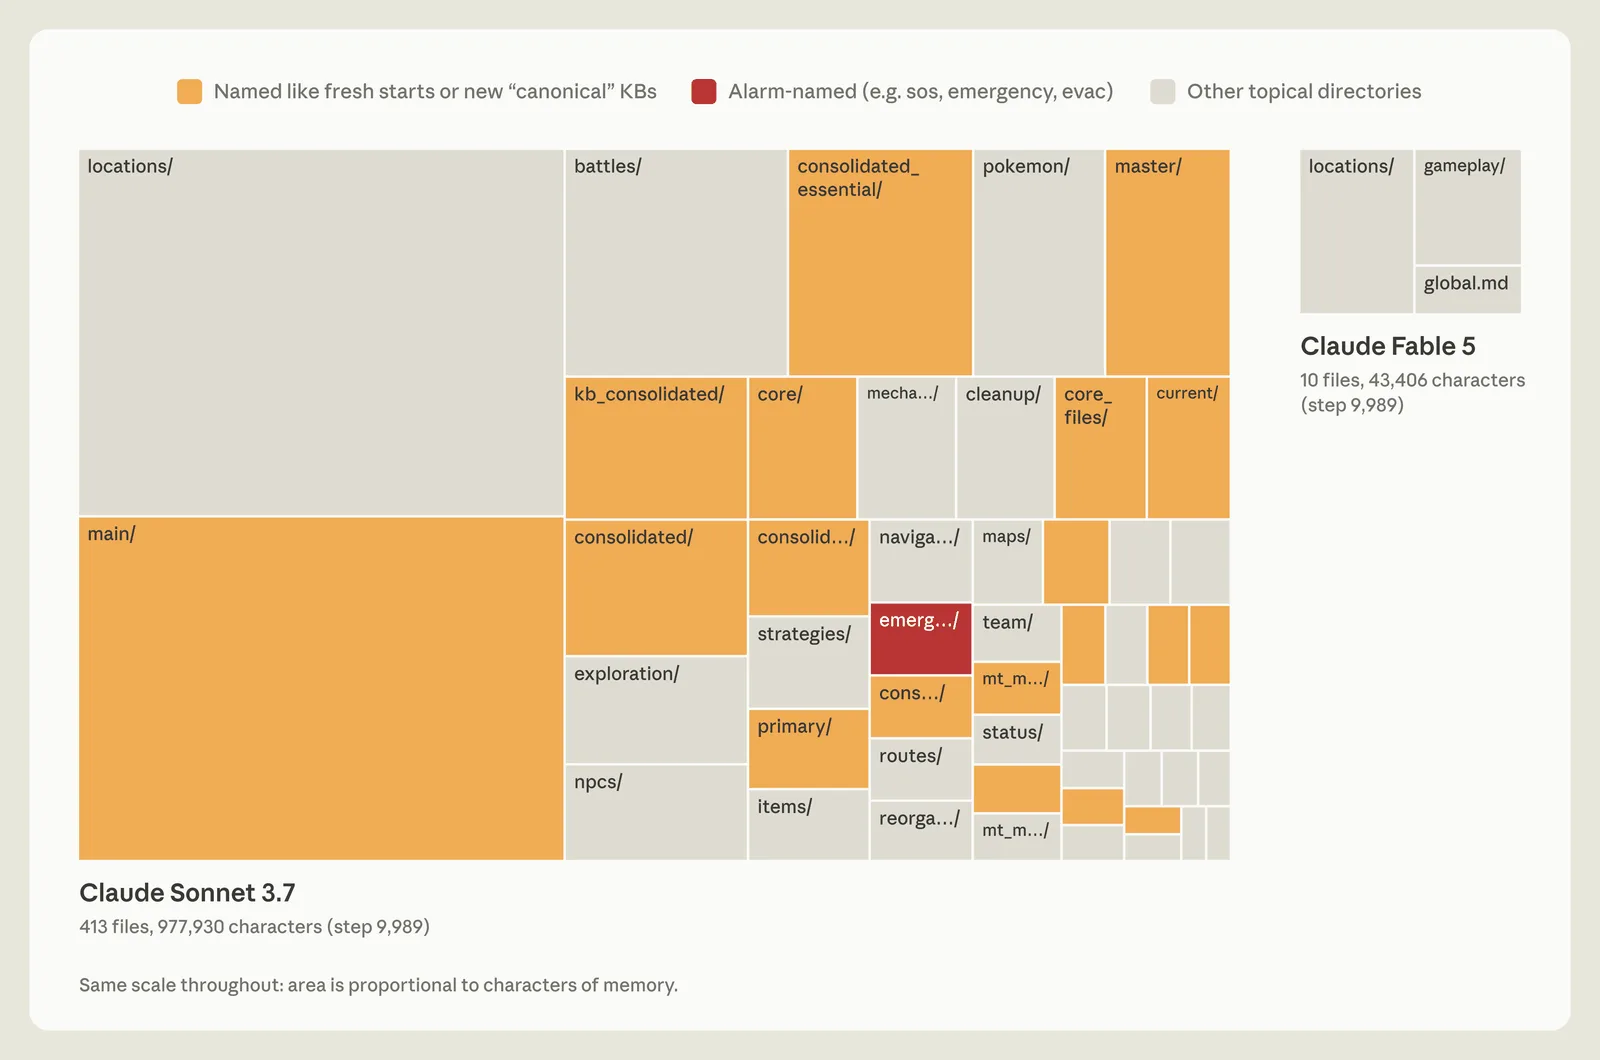
Anthropic은 Claude에게 포켓몬 레드를 시키면서 읽고 쓸 수 있는 메모 폴더를 주고, 무엇을 기억할지 고르는 판단력을 비교했습니다. 비교 대상은 Sonnet 3.7과 Fable 5를 한 번씩 돌린 기록이고, 둘 다 게임을 약 10,000스텝 진행한 시점(그림 표기 step 9,989)의 메모 폴더를 봤습니다(Anthropic).
| 모델 | 메모 폴더 | 배지 |
|---|---|---|
| Sonnet 3.7 | 파일 413개, 폴더 225개, 977,930자 | 1개 |
| Fable 5 | 폴더 2개 안의 파일 9개와 global.md 하나(그림 표기 10 files), 43,406자 | 4개 |
제목의 "10개"는 이 9개와 global.md를 합친 숫자입니다. 원문 본문은 "폴더 2개에 파일 9개, 그리고 최상위 파일 global.md 하나"라고 적었고, 그림은 이를 10개 파일로 셉니다.
Sonnet 3.7은 모든 것이 중요할 수 있다고 보고 닥치는 대로 적었습니다. 전투 한 번, 주운 아이템 하나, 만난 NPC 한 명마다 파일을 따로 만드는 일이 잦았습니다. 문제는 포켓몬의 게임 상태가 계속 바뀐다는 점입니다. 자세히 적은 기록은 계속 낡았고, 게임이 진행될수록 Claude는 게임보다 메모를 뒤지는 데 시간을 더 썼습니다.
원문이 든 장면이 이 상황을 잘 보여 줍니다. 약 10,000스텝 무렵 Sonnet 3.7은 네 번째 "master" 메모 폴더를 만들기 시작했고, 이어진 17스텝 동안 파일 6개를 만들고 9개를 지우면서 게임 안에서는 아무 행동도 하지 않았습니다. 메모 정리가 본업을 밀어낸 것입니다.
Fable 5는 게임이 알려 주지 않는 것만 적었습니다. 원문의 설명은 이렇습니다. 가진 돈이나 지도 위 현재 위치처럼 매 턴 화면에서 읽을 수 있는 정보는 저장해 봐야 중복이고, 전략과 계획과 검증한 규칙은 Claude가 직접 알아내야만 생기며 적어 두지 않으면 사라집니다.
그래서 Fable 5의 global.md는 대시보드 노릇을 했습니다. 현재 목표, 체육관 공략 계획, 메모리를 쓰는 자기 규칙이 들어 있었습니다. locations 폴더에는 특정 길을 지나는 계획을, gameplay 폴더에는 게임이 어떻게 돌아가는지 배운 전략을 넣었습니다.
gameplay 폴더에 남은 규칙 하나가 이 방식을 잘 보여 줍니다. 가장 잡기 쉬운 포켓몬 중 하나인 잉어킹(Magikarp)을 몬스터볼 7개를 연달아 던지고도 못 잡은 뒤, Claude는 이렇게 적었습니다. "공이 3번 이상 연달아 실패하면 타이밍을 바꿀 것(메뉴 단계 사이에 '대기' 입력을 더 넣기). 이렇게 한 직후 잡혔다." 다음에도 쓸 수 있고, 화면에는 나오지 않으며, 직접 해 보고 확인한 규칙입니다.
원문에 따르면 Opus 5.5도 비슷하게 현재 목표와 다음 단계를 담은 작은 메모 폴더를 계속 고쳐 쓰며 게임을 끝까지 깼습니다.
이 비교를 읽을 때는 단서가 꼭 필요합니다. 원문 스스로 모델마다 실행 한 번("one run each")을 비교했다고 밝혔고, Sonnet 3.7과 Fable 5는 세대가 다른 모델입니다. 길 찾기, 전투 판단, 메뉴 조작 실력까지 함께 달라졌을 테니 배지 1개와 4개의 차이를 메모리 전략만의 효과로 볼 수는 없습니다. 원문도 이 비교를 무엇을 남길지 고르는 판단력의 예로 들었을 뿐, 메모리 방식만 바꾼 통제 실험으로 내놓지는 않았습니다.
커뮤니티 반응도 이 지점을 짚었습니다. 해커 뉴스에서는 "쓸모없는 실험"이라는 혹평이 나왔고, 실험 결과를 정리하면서 스스로 "(포켓몬에서는)"이라는 단서를 단 댓글도 있었습니다(해커 뉴스). 그래도 "화면에서 다시 읽을 수 있는 것은 적지 않는다"는 원칙 자체는 실행 횟수와 관계없이 바로 써먹을 수 있는 교훈입니다.
메모리를 쓰라고만 해도 점수가 오른다
메모리를 어떻게 쓰라는 지시 없이 메모리 폴더가 있다는 사실만 알려 줘도, 최근 Claude 모델의 점수는 크게 올랐습니다. 실험에 쓴 CL-Bench(Continual Learning Bench) 1.0은 에이전트가 메모리를 써서 긴 과제를 얼마나 잘 풀어 가는지 재는 벤치마크로, UC 버클리 Sky Lab 쪽에서 나왔습니다(UC 버클리 Sky Lab). 원문이 건 벤치마크 사이트는 11월 9일 현재 열리지 않아 버클리 페이지로 대신 겁니다.
Anthropic이 고른 과제는 데이터베이스에서 정보를 찾아 질문에 차례로 답하는 것입니다. Claude가 답하면 정답을 알려 주고, 다음 질문을 위해 메모를 쓸 기회를 줍니다. Anthropic은 이 과제를 Claude Managed Agents에서 돌렸고, 질문마다 새 세션에서 시작하게 했습니다. 세션을 넘어 남는 것은 메모리 디렉터리 하나뿐이었습니다.
| 모델 | 메모리 없음(무상태) | 메모리 사용 |
|---|---|---|
| Opus 5.5 | 0.655 | 0.838 |
| Sonnet 5.5 | 0.644 | 0.833 |
| Opus 5 | 0.564 | 0.828 |
| Opus 4.7 | 0.383 | 0.700 |
| Sonnet 5 | 0.306 | 0.610 |
| Sonnet 4.6 | 0.330 | 0.364 |
숫자는 원문 그림 3의 평균 보상입니다(Anthropic). 같은 메모리 폴더를 줘도 모델마다 쓰는 방식이 달랐습니다.
Sonnet 4.6은 왜 틀렸는지 추측을 세우는 데서 멈췄고, 메모리 폴더에는 검증하지 않은 추측을 몇 개씩 적은 파일이 흩어져 있었습니다. Opus 4.7은 확인한 사실과 아직 확인하지 않은 사실을 나눠 표시하기 시작했고, Sonnet 5는 채점으로 확인된 답에 "확인됨"을 달고 틀린 답은 정정했습니다.
원문은 Opus 5를 이 모델들 가운데 "루프를 닫은 첫 모델"이라고 불렀습니다. 틀린 답을 기록하고, 원인을 추측하고, 그 추측을 시험하고, 결과를 다음에 쓸 규칙으로 바꾸는 순환을 끝까지 돌렸다는 뜻입니다. Opus 5의 메모 항목 대부분에는 규칙과 그 규칙이 참인 이유, 앞선 질문의 답, 도중에 발견한 함정에 대한 경고가 들어 있었습니다. Opus 5.5와 Sonnet 5.5도 루프를 닫았고, 메모리를 쓸 때 점수는 Opus 5와 비슷했지만 메모리 없는 기준선이 조금 더 높았습니다.
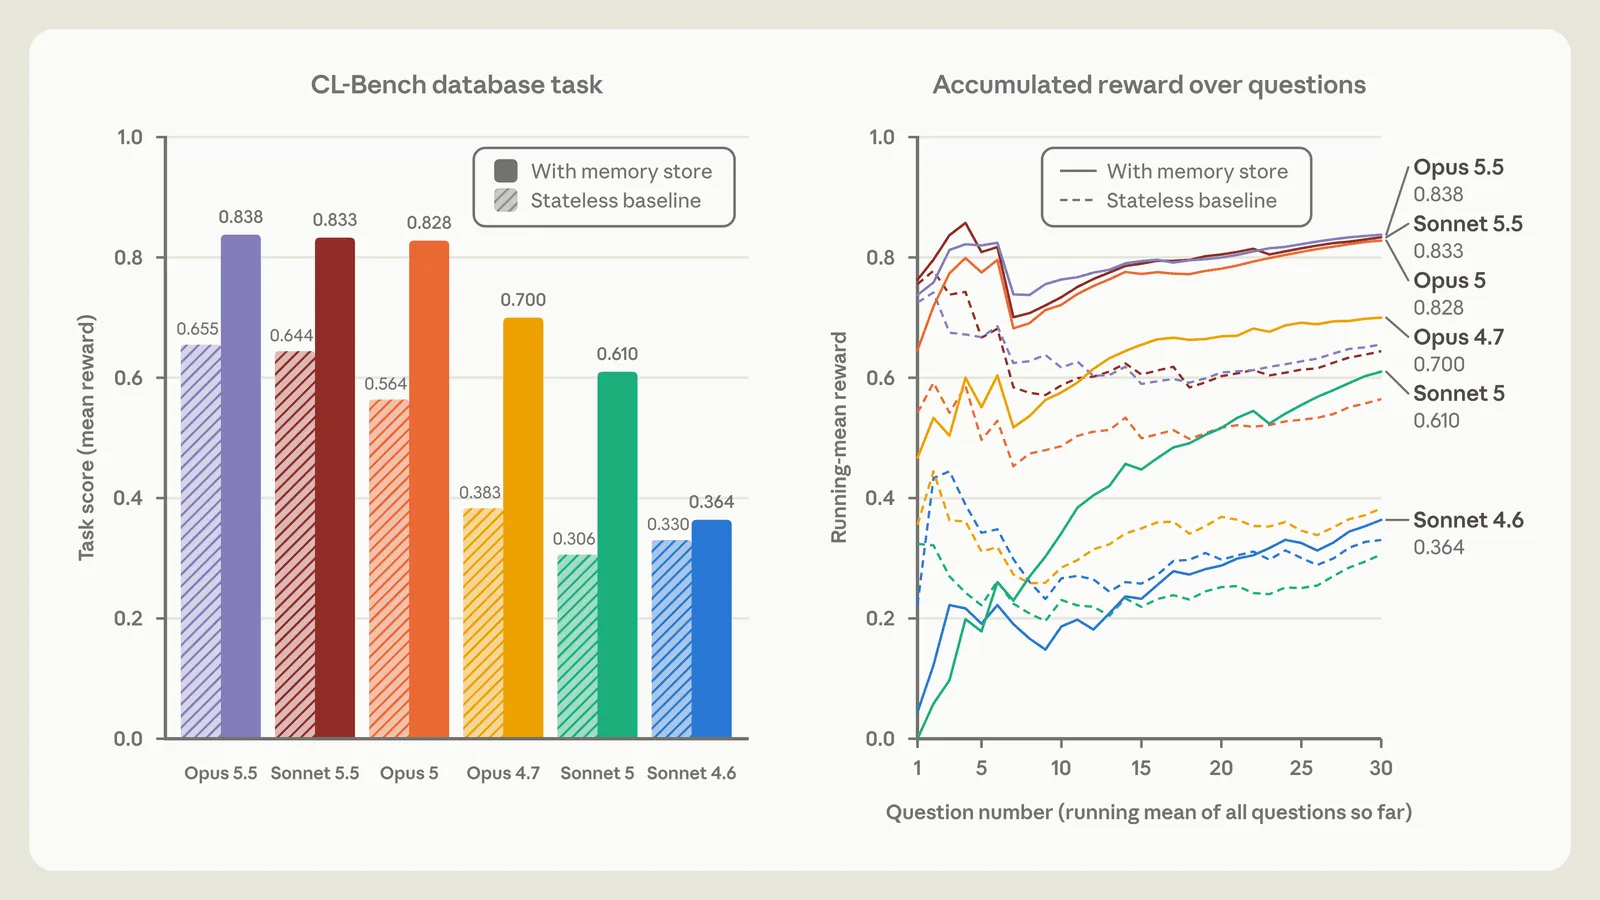
더 흥미로운 결과는 지시문 실험입니다. 원문은 "Claude에게 메모리가 무엇을 위한 것인지는 알려 주되, 어떻게 쓸지는 정하지 않는 편이 낫다"고 정리했습니다. CL-Bench에서 Anthropic이 한 일은 메모리 폴더가 있다고 알린 것뿐이었고, Opus 4.7과 Opus 5는 그것만으로 메모리를 잘 썼습니다.
무엇을 적을지 규칙을 정해 주자 오히려 손해가 났습니다. "실패만 기록하라"는 규칙을 주자 메모리로 얻는 이득이 Opus 5는 0.234, Opus 4.7은 0.150 줄었고, Sonnet 4.6은 0.020 줄었습니다. 원문은 강한 모델일수록 무엇이 중요한지 스스로 판단하게 두는 편이 고정 규칙보다 낫고, 미리 정한 규칙은 성능을 깎을 수 있다고 썼습니다.
반대로 이전 세대 모델은 지시가 도움이 됐습니다. Sonnet 4.6은 메모리 폴더를 잘 읽지 않았고 자기 추측도 시험하지 않았습니다. 답하기 전에 메모리를 읽고 추측을 명시적으로 시험하라고 지시하자 점수가 메모리만 줬을 때의 0.364에서 0.641로 올랐습니다. 원문은 이를 "거의 두 배"라고 표현했고, 메모리 없는 기준선 0.330과 비교하면 약 1.94배입니다.
Sonnet 5는 같은 일을 시키지 않아도 했습니다. 지시 없이도 10번 중 9번은 답하기 전에 메모리를 먼저 읽었고, Sonnet 4.6은 절반이 안 됐습니다. 그래서 Anthropic은 최신 모델에는 사람이 요청하거나 분명히 기억할 가치가 있을 때 메모를 만들라는 정도의 간단한 안내만 주고 판단은 Claude에 맡긴다고 밝혔습니다. 필자가 보기에 실무에서 얻을 결론은 하나입니다. 같은 지시문이라도 쓰는 모델에 따라 득이 되기도 하고 실이 되기도 하니, 모델을 바꿨다면 메모리 지시도 다시 봐야 합니다.
dreaming: 틀린 메모를 기록과 대조해 고친다
dreaming은 Claude가 지난 대화 기록을 다시 읽으며 메모를 사실과 대조해 고치고, 흩어진 노트를 새 구조로 엮는 오프라인 작업입니다. 아이디어는 Letta와 UC 버클리 연구진의 sleep-time compute에서 왔습니다. 질문이 들어오기 전 쉬는 시간에 모델이 주어진 문맥을 미리 생각해 두게 하는 방법으로, 논문은 같은 정확도에서 질문 시점의 계산을 약 5배 줄였다고 보고했습니다(sleep-time compute 논문). Anthropic은 같은 생각을 메모리 정리에 옮겼습니다.
dreaming이 필요한 이유는 메모가 세션 안의 판단으로 쓰이기 때문입니다. 처음부터 틀렸거나 환경이 바뀌어 낡은 메모도 다음 세션의 Claude가 그대로 읽고 믿을 수 있습니다. 원문은 포켓몬 달맞이산(Mt. Moon)에서 이 일이 실제로 벌어진 장면을 소개했습니다.
달맞이산 입구 근처에는 한 방향으로만 내려갈 수 있는 낭떠러지가 있어, 잘못 내려가면 왔던 길로 떨어집니다. Claude는 산 입구의 포켓몬센터를 이정표로 삼았기 때문에, 센터가 산의 어느 쪽에 있다고 믿느냐에 따라 낭떠러지로 걸어갈지가 갈렸습니다.
Claude는 포켓몬센터가 동쪽에 있다고 잘못 적었습니다. 센터를 나서며 "달맞이산은 지나왔다"고 말하고 메모에 "Mt Moon DONE"이라고 썼습니다. 몇 행동 뒤 낭떠러지를 넘어 왔던 길로 떨어졌는데, 내비게이션 도구가 낙하를 보여 주지 않아 Claude는 "서쪽으로 너무 많이 왔다(I overshot far west)"고 결론 내리고 자기가 줄곧 맞는 쪽에 있었다고 믿었습니다.
메모를 고치지 않은 실행은 같은 길로 세 번 떨어진 뒤 "I'm going to stop rather than keep looping."(계속 맴도느니 멈추겠다)이라고 적었고, 실험 환경의 자동 응답에 따라 계속하다가 산 앞 마을인 회색시티(Pewter City)까지 되돌아갔습니다. 이 실행은 끝까지 블루시티(Cerulean City)에 닿지 못했습니다.
Anthropic은 틀린 위치가 적힌 메모 폴더에 dreaming을 돌렸습니다. Claude는 메모를 세션 대화 기록과 대조해 오류를 찾아냈고 메모를 다시 썼습니다. 원문은 대화 기록이 메모를 검증할 기준 사실(ground truth)이 됐다고 설명합니다. 고친 메모를 받은 Claude는 곧장 동굴로 돌아갔고, 누적 행동 1,935회째에 블루시티에 도착했습니다.
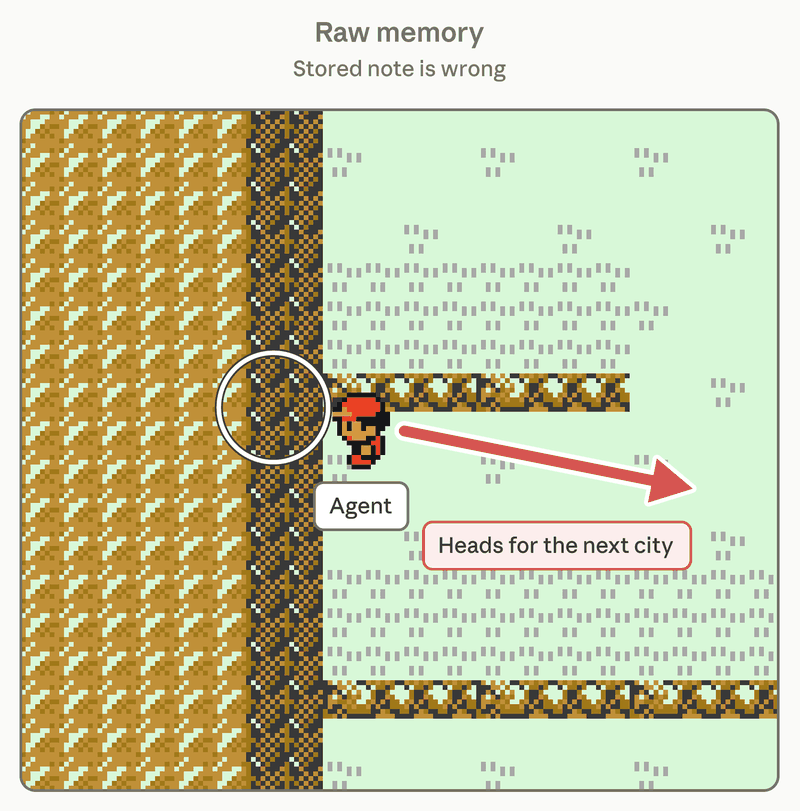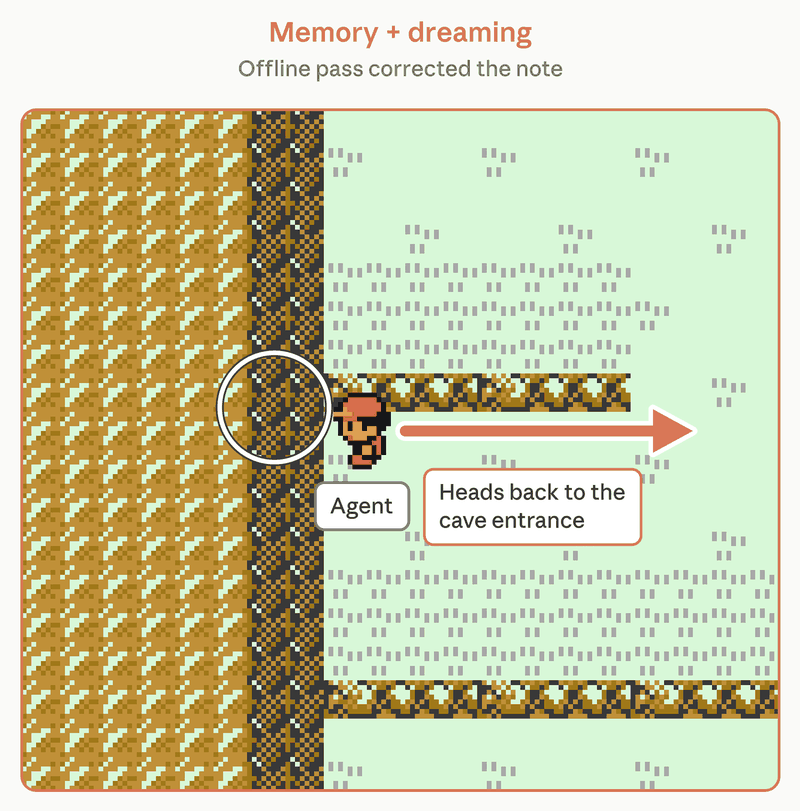
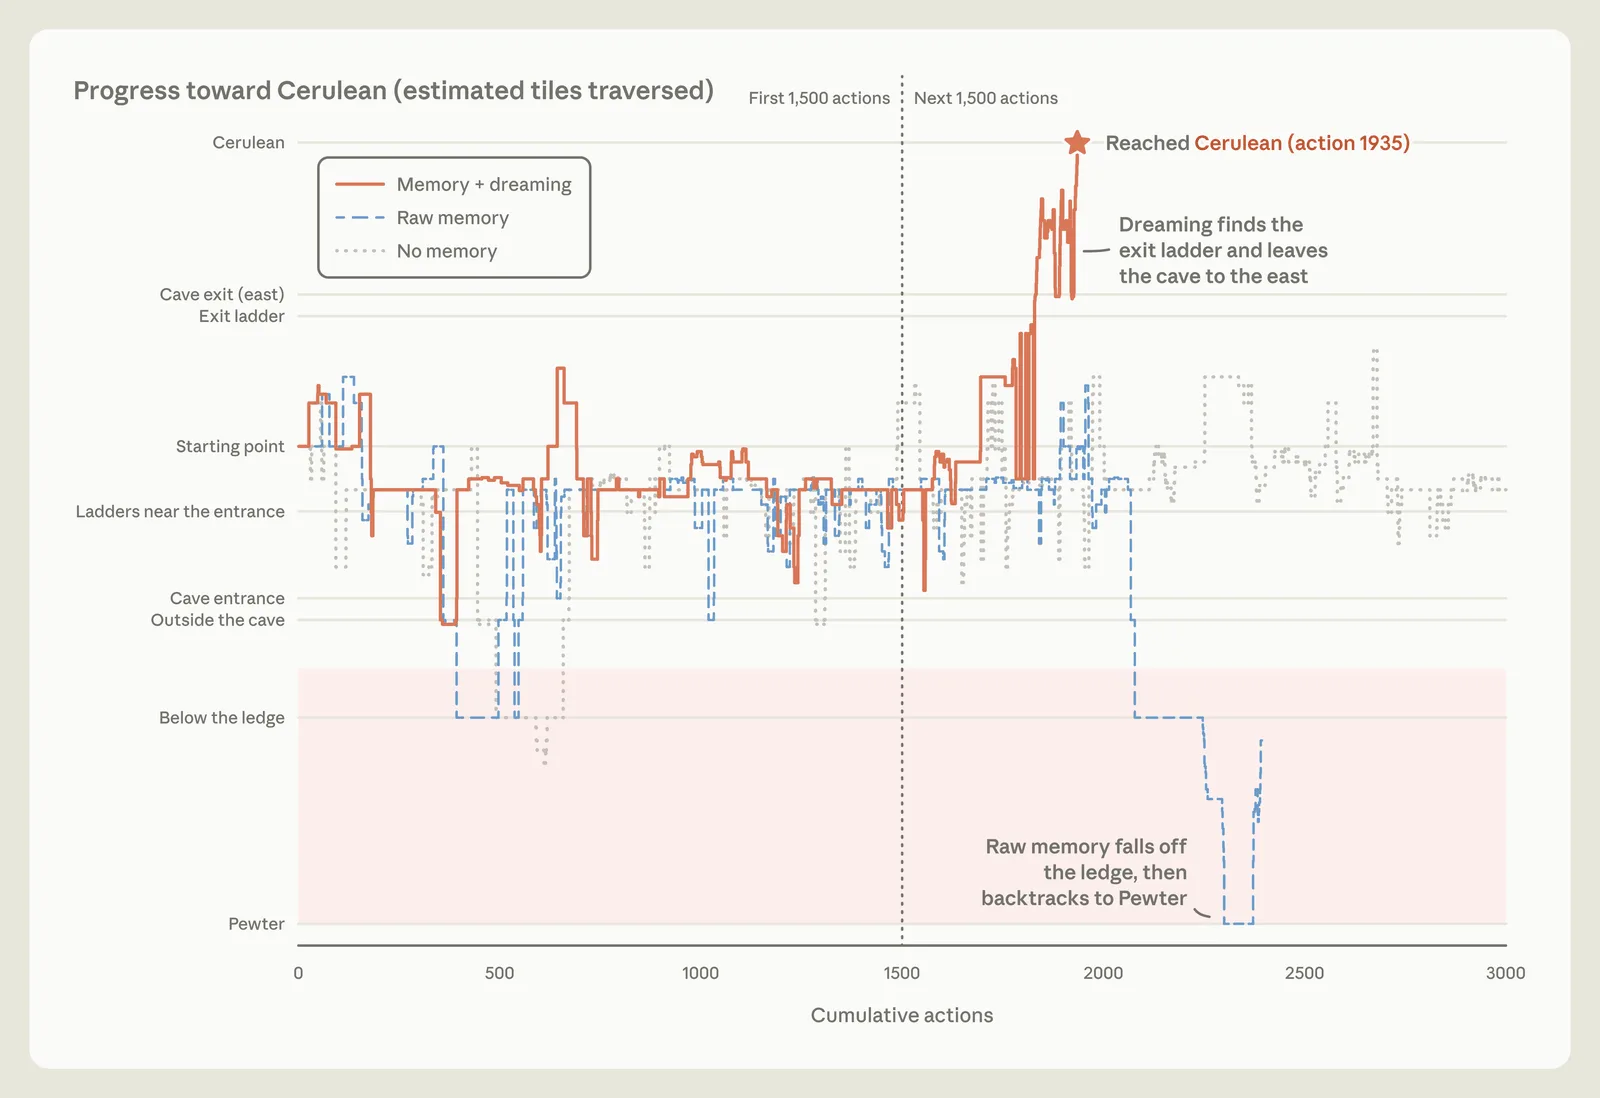
비교 그래프에서 메모리를 아예 쓰지 않은 실행도 블루시티에 닿지 못했습니다. 그러니 이 장면에서 "틀린 메모가 메모가 없는 것보다 나빴다"고 말할 근거는 없고, 원문도 둘을 비교해 판정하지 않았습니다. dev.to의 한 해설은 고친 경로가 다음 도시에 닿은 것은 "이 예에서" 그랬다는 것이며, 파일 속 문장이 참인지를 저장 장치는 스스로 알지 못한다고 짚었습니다(dev.to).
제품으로 쓸 수 있는 dreaming은 따로 있습니다. Claude 앱 채팅이나 Claude Code에 새로 생긴 버튼이 아니라, Claude Managed Agents의 연구 미리보기 기능 Dreams입니다(Dreams 문서). Anthropic은 5월에 이 기능을 연구 미리보기로 내놓으면서, dreaming이 메모리를 자동으로 고치게 할 수도 있고 바뀐 내용을 사람이 검토한 뒤 반영할 수도 있다고 밝혔습니다(Claude 블로그).
문서에 적힌 사용법은 이렇습니다. POST /v1/dreams로 기존 메모리 저장소 하나와 지난 세션 1개에서 100개까지를 넘기면, 중복은 합치고 낡거나 모순된 항목은 최신 값으로 바꾸고 새로 발견한 내용을 더한 새 저장소를 만듭니다. 입력 저장소는 절대 바꾸지 않습니다. 한 번 도는 데 보통 몇 분에서 몇 시간이 걸리고, 요금은 일반 API 토큰 요금으로 매깁니다. 11월 2일 공개된 dreaming 쿡북 예제는 샘플 기록 11개를 정리하는 데 약 0.36달러와 2.5분, 50개 넘는 긴 기록(약 12MB)에 약 8달러와 10분이 들었다고 적었습니다(dreaming 쿡북).
일부 보도는 Claude Code에서 /dream 명령으로 dreaming을 부를 수 있다고 썼습니다. 하지만 이 명령은 Claude Code 공식 문서와 명령 목록에서 확인되지 않습니다(Claude Code 명령 문서). 필자 설치본 2.1.319의 실행 파일에는 auto-dream 관련 로그 문자열과 autoDreamEnabled 설정 키, /memory 화면의 Auto-dream 항목 문자열이 들어 있습니다. 하지만 어떻게 동작하는지는 문서로 정해지지 않았으니, 공식 기능으로 기대하고 쓰지 않는 편이 안전합니다.
커뮤니티에서는 dreaming의 기준 사실 자체를 의심하는 목소리도 나왔습니다. r/ClaudeCode의 한 댓글은 대화 기록과 대조해 메모를 검증하면, 에이전트가 "테스트 통과"라고 말한 세션이 곧 테스트가 통과했다는 증거가 되어 사실로 굳는다고 지적했습니다(r/ClaudeCode). 그 결과는 "더 잘 정리된, 자신만만한 낡은 정보"라는 것입니다. 이 댓글은 종료 코드나 diff처럼 실제로 실행된 근거만 사실로 쓰고 나머지는 "에이전트 주장"으로 표시하자고 제안했습니다.
위키는 언제 도움이 되고 언제 부풀까
dreaming으로 만든 위키는 여러 문서를 엮어야 답이 나오는 질문에서 도움이 됐고, 한 문서만 찾으면 되는 과제에서는 뚜렷한 이득이 없었으며, 때로는 바탕 문서보다 커졌습니다. 원문의 위키는 Claude가 쓰고 관리하는 페이지 모음으로, 한 주제에 대해 아는 것을 모으고 다른 노트로 링크를 겁니다. 링크가 일종의 지도가 되어 필요한 메모를 빨리 찾게 해 준다는 설명입니다.
첫 실험은 Stainless의 내부 문서로 했습니다. Stainless는 Anthropic이 5월에 인수한 SDK 생성 회사입니다(Anthropic 인수 발표). 문서는 약 35만 개, 약 4억 2천만 토큰이었고, Anthropic은 이 문서들에 관한 질문 25개로 평가 세트를 만들어 Claude에게 검색 도구를 줬습니다.
그리고 Opus 5 에이전트들에게 128세션에 걸쳐 파일을 탐색하고, 서로 링크된 위키 페이지를 쓰고 고치고, 중복을 합치고, 주장을 바탕 문서와 대조하게 했습니다. 각 세션은 공유 로그로 앞선 세션의 진행을 이어받았습니다.
- 위키만 쓸 때: dreaming을 2세션에서 128세션으로 늘리자 13%에서 48%로 올랐습니다.
- 위키와 검색을 함께 쓸 때: 위키가 커지면서 54%에서 61%로 올랐습니다. 이것이 최고 점수입니다.
- 검색만 쓸 때: 위키 없이 53%로 그대로였습니다.
- 토큰: 검색과 위키를 함께 쓰면 질문당 약 2만 토큰을 아꼈습니다.
헷갈리기 쉬운 점이 둘 있습니다. 첫째, 13%에서 48%로 오른 것은 "위키만" 쓴 조건입니다. 검색만 쓴 조건은 53%에서 움직이지 않았고, 위키만 쓴 최고점 48%는 검색만 쓴 53%보다 낮습니다. 둘째, 이 퍼센트는 정답률이 아니라 채점 기준 가운데 충족한 항목의 비율(graded criteria)입니다. 필자가 보기에 이 결과는 위키가 검색을 대신한다기보다 검색에 보태는 지도라는 뜻에 가깝습니다.
어떤 과제에 위키가 맞는지는 Harvey LAB으로 따로 봤습니다. LAB은 문서 묶음을 주고 법률 브리프를 쓰게 한 뒤 기준 목록으로 채점하는 벤치마크로, Harvey는 1,200개 넘는 과제와 24개 법률 분야를 담았다고 소개합니다(Harvey). Anthropic은 여기에 합병 관련 문서를 더해 위키를 만들게 하고, 위키를 쓸 때와 파일 검색만 쓸 때를 비교했습니다.
합병에 관한 질문 24개는 절반 넘게 여러 문서의 정보를 엮어야 했고, 상당수는 판단이나 계산도 필요했습니다. 이런 항목에서 Claude는 위키를 참고할 때 87%, 검색만 쓸 때 73%를 받았습니다. 반대로 한 LAB 과제는 채점 기준 대부분을 문서 한 개에서 텍스트 검색으로 찾을 수 있었고, 여기서는 위키가 검색보다 뚜렷한 이득을 주지 못했습니다.
위키가 바탕 문서보다 커진 경우도 있었습니다. 또 다른 LAB 과제에서 문서 10개, 115KB를 바탕으로 만든 위키가 68쪽, 링크 255개, 203KB로 바탕 문서의 1.77배가 됐습니다. Anthropic은 이를 보르헤스의 짧은 소설 「과학의 엄밀함에 대하여」에 빗댔습니다. 제국만큼 큰 지도를 그린 지도 제작자들처럼, Claude가 너무 자세해서 아무것도 추리지 못한 위키를 만들었다는 것입니다.
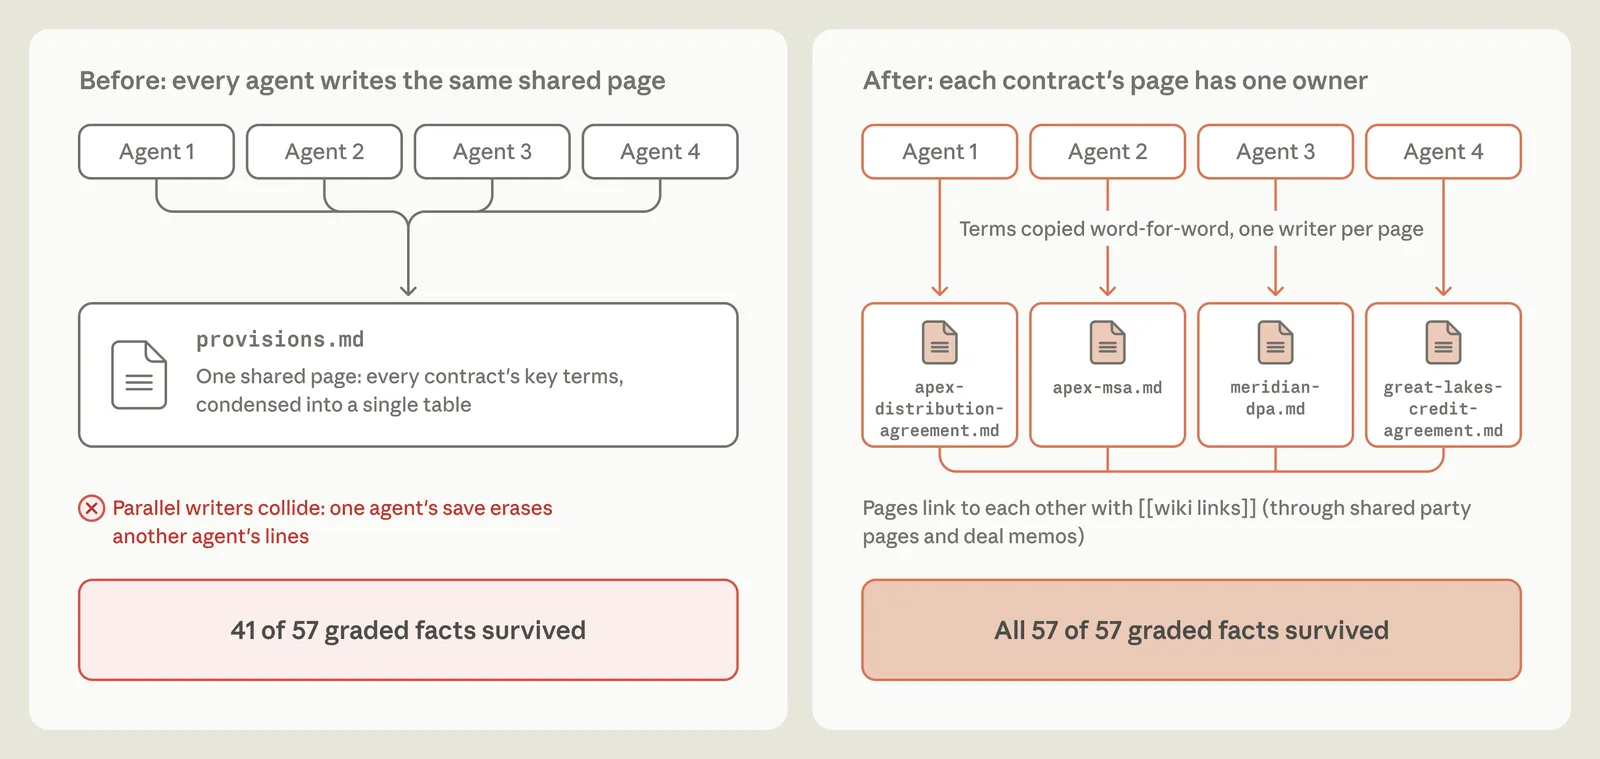
위키를 무엇에 맞춰 키우느냐도 결과를 갈랐습니다. 회사 인수를 흉내 낸 LAB 과제는 계약서 묶음을 주고 브리프가 계약 조건을 정확히 설명하는지 채점합니다. 처음에는 여러 에이전트가 공유 계약 조건 표(provisions.md)에 동시에 쓰다가 서로의 내용을 덮어써, 그 위키로 쓴 브리프에는 채점 대상 사실 57개 중 41개(72%)만 들어갔습니다. Claude가 실패를 돌아보며 지시를 고치는 루프를 돌리자 Claude는 계약 조건이 이 위키의 핵심이라는 점을 찾아 지시를 다시 썼고, 계약마다 에이전트 하나가 자기 페이지를 맡아 계약서 문구를 요약하지 않고 그대로 인용하게 되자 브리프는 57개 사실을 모두(100%) 담았습니다.
두 번째 dreaming은 세션이 남긴 빈틈도 메웠습니다. 한 과제에서 없는 페이지를 가리키던 링크 9개를 같은 문서를 다룬 기존 페이지로 돌리고, 색인을 포함한 새 페이지 3개를 더했습니다.
비용도 따져야 합니다. 그래프에서 dreaming에 쓴 토큰은 2M에서 128M까지 늘었고, 원문도 dreaming에는 계산이 들어 모든 메모리를 늘 검사하기는 어려우니 바뀔 가능성이 큰 정보에 집중하거나 주기를 조절하는 편이 나을 수 있다고 적었습니다.
직접 재 보니: MEMORY.md는 200줄, 25,000자에서 잘린다
원문과 공식 문서는 Claude Code가 MEMORY.md를 "첫 200줄 또는 25KB 중 먼저 닿는 쪽"까지만 싣는다고 적었는데, 필자가 재 보니 200줄은 그대로였고 25KB는 바이트가 아니라 25,000자였습니다. 원문은 이 앞부분이 Claude가 무엇을 알고 어디서 찾을지 보여 주는 색인 역할을 한다고 설명합니다(Anthropic). 공식 문서도 그 한도 뒤의 내용은 세션 시작 때 싣지 않는다고 적었습니다(Claude Code 메모리 문서).
필자가 궁금했던 것은 한국어 사용자에게 걸린 문제였습니다. 한글은 UTF-8에서 한 글자가 3바이트라서, 25KB를 바이트로 잰다면 한글 색인은 영어 색인보다 훨씬 적은 분량에서 잘립니다. 한글만으로 쓴 줄이라면 3분의 1 분량입니다.
그래서 2026년 11월 9일 필자 맥에서 Claude Code 2.1.319로 직접 재 봤습니다. 시험용 빈 프로젝트 4개를 만들고 각 메모리 폴더에 인공 색인을 넣었습니다. 색인 줄마다 L001부터 시작하는 번호와 sha1로 만든 6자리 코드를 붙여, 모델이 추측으로 답할 수 없게 했습니다. 그다음 claude -p --model sonnet으로 파일을 읽는 도구(Read, Bash, Grep, Glob, Edit, Write)를 모두 막은 채, 세션 시작 때 실린 MEMORY.md에서 보이는 가장 높은 번호와 그 코드, 잘림 안내가 있다면 그 원문을 물었습니다. 시험마다 한 번씩 물었습니다.
| 시험 | 넣은 색인 | 보인 마지막 줄 |
|---|---|---|
| A | 영어 짧은 줄 300줄 (11,484자, 11,484바이트) | L200, 잘림 경고 있음 |
| B | 한글 줄 180줄 (14,904자, 29,664바이트) | L180, 전부 보임, 경고 없음 |
| C | 영어 긴 줄 180줄 (26,604자, 26,604바이트) | L169, 잘림 경고 있음 |
| D | 한글 긴 줄 180줄 (32,004자, 71,604바이트) | L140, 잘림 경고 있음 |
네 시험 모두 마지막 줄의 코드(A 70485f, B 622025, C 748b45, D 66563c)까지 정확히 맞혔습니다. 실제로 그 줄까지 읽혔다는 뜻입니다. 잘린 시험에서 모델이 옮겨 준 경고 원문은 이렇습니다. 시험 A는 줄 수 한도, 시험 D는 크기 한도에 걸렸습니다(D의 줄표는 "…"로 바꿔 옮겼습니다).
A: WARNING: MEMORY.md is 300 lines (limit: 200). Only part of it was loaded: 100 of 300 lines were cut off, starting at line 201 (...). Keep index entries to one line under ~200 chars; move detail into topic files.

D: WARNING: MEMORY.md is 31.3KB (limit: 24.4KB) … index entries are too long. Only part of it was loaded: 40 of 180 lines were cut off, starting at line 141 (...)
결과를 정리하면 두 가지입니다. 첫째, 200줄 한도는 문서대로 작동했습니다(A). 둘째, 크기 한도는 바이트가 아니라 글자 수 25,000자입니다.
B는 29,664바이트로 25KB를 넘지만 14,904자라서 잘리지 않았습니다. D의 경고가 말한 "31.3KB"는 32,004자를 1,024로 나눈 31.25와 맞고, 바이트(71,604)로 치면 69.9KB입니다. 경고의 "limit: 24.4KB"도 25,000을 1,024로 나눈 값입니다.
잘린 위치도 25,000자 기준과 맞았습니다. C는 한 줄 평균 147.8자라 169줄 근처에서, D는 177.8자라 140줄 근처에서 누적 25,000자를 넘습니다. 줄 중간을 자르지 않고, 25,000자를 넘기는 줄부터 통째로 빠지는 방식으로 보입니다. 그러니 한글 색인이 3바이트라서 빨리 잘린다는 걱정은 맞지 않습니다. 한글 한 글자도 한 글자로 셉니다.
국내에서도 비슷한 관찰이 먼저 나왔습니다. 한 블로그는 Claude Code 2.1.310에서 바이트가 아니라 글자 수 25,000자 언저리에서 줄 단위로 잘렸다고 적었습니다(aicoding-claude 블로그). 필자 결과는 다른 버전에서 같은 결론에 닿은 셈입니다.
잘렸을 때 알려 주느냐는 보고가 엇갈립니다. 2.1.319에서는 잘린 시험마다 모델이 위와 같은 경고를 옮겨 줬습니다. GitHub 이슈 #99403 본문에 붙은 세션 시작 메시지에도 잘림 경고가 있어, 경고 자체는 뜨는 것으로 보입니다(GitHub 이슈 #99403). 다만 경고가 인용하는 것은 첫 잘린 줄 하나뿐입니다. 이 이슈도 제목에서 "조용히 잘리고 어떤 항목이 빠졌는지 알 수 없다"고 불만을 적었고, 새 항목이 붙을 때마다 잘리는 구간이 커진다고 지적했습니다.
국내 몽무 블로그는 9월에 색인이 한도인 24.4KB를 넘겨 앞쪽만 읽히고 있었는데 경고가 없었다고 적었습니다(몽무 블로그). 필자 결과와 다른 것은 버전 차이일 수 있다는 것이 필자의 해석이고, 확인하지는 않았습니다.
실험 뒤에 필자 맥의 실제 메모리를 내용은 열지 않고 개수와 크기만 셌습니다. ~/.claude/projects/ 아래 프로젝트 폴더 159개 중 31곳에 메모리 파일이 있었고, 합치면 743개였습니다. 그중 29곳은 색인이 79줄 이하로 넉넉했지만 나머지 두 곳이 문제였습니다.
가장 긴 업무 프로젝트 하나는 색인이 264줄, 31,038자였고 메모리 파일이 265개였습니다. 위 규칙대로라면 200줄 한도에 걸려 아래 64줄이 세션 시작 때 실리지 않습니다. 이 숫자는 계산한 것이고, 이 프로젝트에 직접 물어 확인하지는 않았습니다.
두 번째로 긴 프로젝트는 177줄, 24,605자로 25,000자 한도까지 395자가 남아 있었습니다. 색인 항목이 몇 줄만 더 붙으면 색인 맨 아래 항목부터 빠지기 시작할 상태입니다.
단서도 하나 있습니다. 이 실험은 세션 시작 때 실리는 색인만 봤고, 색인에서 잘린 항목이라도 그 메모리 파일 자체는 디스크에 남아 있으니, Claude가 필요할 때 직접 찾아 읽을 수는 있습니다. 이번 시험은 도구를 막았기 때문에 그 경로는 확인하지 않았습니다. 다만 색인에 없는 파일은 Claude가 그런 파일이 있다는 사실부터 모르기 쉬우니, 잘리지 않게 관리하는 편이 낫습니다.
내 클로드 코드 메모리 정리하는 법
원문 실험과 필자 재현에서 나온 교훈을 Claude Code 자동 메모리에 옮기면, 색인을 짧게 지키고 다시 읽을 수 있는 것은 적지 않으며 규칙보다 목적을 알려 주는 것으로 요약됩니다. 먼저 내 색인이 한도에 얼마나 가까운지부터 봅니다. 아래 명령은 프로젝트마다 MEMORY.md의 줄 수와 글자 수를 차례로 보여 줍니다.
wc -lm ~/.claude/projects/*/memory/MEMORY.md
첫 숫자가 줄 수, 둘째 숫자가 글자 수입니다. 글자 수는 터미널 로캘이 UTF-8일 때 한글 한 글자를 한 글자로 셉니다. 줄 수 200이나 글자 수 25,000 가운데 하나라도 넘었다면 그 프로젝트는 색인 아래쪽이 세션 시작 때 빠지고 있습니다. wc -m은 줄바꿈도 한 글자로 세고 Claude Code가 줄바꿈을 세는지는 확인하지 못했으니, 경계 근처라면 여유를 둡니다. 몽무 블로그는 뒤에 붙은 가장 새로운 메모부터 모르는 상태가 됐다고 적었으니, 한도에 가깝다면 넘기 전에 정리하는 편이 낫습니다.
- 색인 한 줄은 짧게 쓰고, 자세한 내용은 주제 파일로 내립니다. 2.1.319의 잘림 경고 자체가
Keep index entries to one line under ~200 chars; move detail into topic files.라고 권합니다. 색인 항목은 200자 안쪽 한 줄로, 자세한 내용은 주제 파일로 옮기라는 뜻입니다. 원문의 dreaming도 맨 위층을 작게 지키려고 세부를 아래층으로 내리고 링크만 남깁니다. - 화면이나 코드에서 다시 읽을 수 있는 것은 적지 않습니다. 포켓몬에서 돈과 위치를 적은 메모가 쓸모없었듯, 코드와 저장소에서 바로 확인할 수 있는 정보는 메모로 남길 이유가 적습니다. 특히 PR 상태나 이슈 상태처럼 바뀌는 상태는 금방 낡은 메모가 됩니다. 요즘IT의 한 기고는 이미 머지된 PR이 메모리에 "리뷰 대기 중"으로, 닫힌 이슈가 "조사 진행 중"으로 남아 있었다며 없는 정보보다 오래된 잘못된 정보가 더 위험할 수 있다고 적었습니다(요즘IT).
- CLAUDE.md는 200줄 아래로 둡니다. 공식 문서는 CLAUDE.md 파일마다 200줄 아래를 목표로 하라며 "긴 파일은 컨텍스트를 더 쓰고 지시를 덜 따르게 한다(Longer files consume more context and reduce adherence.)"고 적었습니다(Claude Code 메모리 문서). 200줄·25,000자 한도는 MEMORY.md에만 걸리고, CLAUDE.md는 4MiB 이하라면 시작할 때 통째로 실립니다. 길어도 잘리지 않는 대신 그 길이만큼 토큰과 지시 준수율로 값을 치를 수 있습니다. 설정 파일과 CLAUDE.md를 어디에 두는지는 Claude Code 팁 11가지에서 정리했습니다.
- 규칙을 미리 정해 주기보다 목적을 알려 줍니다. CL-Bench에서 Opus 5와 Opus 4.7은 "실패만 기록하라" 같은 고정 규칙을 받자 메모리 이득의 상당 부분을 잃었습니다. CLAUDE.md에 메모 쓰는 법을 시시콜콜 적기보다 이 프로젝트에서 기억이 왜 필요한지 알려 주는 편이 원문 결과에 맞습니다. 다만 Sonnet 4.6 같은 이전 세대 모델은 "답하기 전에 메모리를 읽고 추측을 시험하라"는 지시가 도움이 됐습니다. 모델을 둘러싼 지시와 도구 설계를 어디까지 사람이 정할지는 AI 하네스 뜻에서 다룬 논쟁과 이어집니다.
- 메모리도 입력이라 오염될 수 있다는 점을 기억합니다. Managed Agents 메모리 문서는 프롬프트 인젝션이 성공하면 공격자가 저장소에 악의적인 내용을 써 넣을 수 있다고 경고합니다(Managed Agents 메모리 문서). 메모리는 다음 세션이 믿고 읽는 입력이니, 외부 문서나 웹 페이지를 많이 다루는 프로젝트일수록 가끔 열어 볼 필요가 있습니다. 기밀 프로젝트나 공용 컴퓨터처럼 쌓이는 것 자체가 부담이라면
/memory에서 자동 메모리를 끄거나 환경 변수CLAUDE_CODE_DISABLE_AUTO_MEMORY=1로 끌 수 있습니다.
Claude Code 공식 문서에는 아직 dreaming에 대한 설명이 없습니다. /memory 화면에 Auto-dream 항목이 보인다는 사용자 보고는 있지만(daleseo 블로그) 동작이 문서로 정해지지 않았으니, 당분간은 사람이 그 역할을 맡는 편이 확실합니다. 앞의 요즘IT 기고 저자는 평소에는 /memory로 보고, 스프린트가 끝날 때마다 직접 만든 정리 스킬을 돌려 낡은 메모를 지우지 않고 보관 폴더로 옮긴다고 소개했습니다. 가끔 /memory 화면에서 CLAUDE.md가 아니라 자동 메모리 폴더 항목을 골라 MEMORY.md를 훑고, 이미 바뀐 경로나 설정처럼 지금은 틀린 메모를 지우거나 고치면 됩니다. dreaming이 자동으로 하는 일을 사람이 대신하는 셈입니다.
출처
- Anthropic: anthropic.com/research/components-of-agent-memory
- 해커 뉴스: news.ycombinator.com/item?id=50402212
- Claude Code 메모리 문서: code.claude.com/docs/en/memory
- UC 버클리 Sky Lab: sky.cs.berkeley.edu/?p=3683
- sleep-time compute 논문: arxiv.org/abs/2504.13171
- dev.to: dev.to/axrisi/agent-memory-how-claude-repairs-wrong-notes-with-dreaming…
- Dreams 문서: platform.claude.com/docs/en/managed-agents/dreams
- Claude 블로그: claude.com/blog/new-in-claude-managed-agents
- dreaming 쿡북: platform.claude.com/cookbook/managed-agents-cma-dreaming-with-a-dynamic…
- Claude Code 명령 문서: code.claude.com/docs/en/commands
- r/ClaudeCode: reddit.com/r/ClaudeCode/comments/1xqdxdp/borrowed_anthropics_dreaming_i…
- Anthropic 인수 발표: anthropic.com/news/anthropic-acquires-stainless
- Harvey: harvey.ai/blog/introducing-harveys-legal-agent-benchmark
- aicoding-claude 블로그: m.blog.naver.com/aicoding-claude/224454242600
- GitHub 이슈 #99403: github.com/anthropics/claude-code/issues/99403
- 몽무 블로그: m.blog.naver.com/mummumni/224433579999
- 요즘IT: yozm.wishket.com/magazine/detail/3985
- Managed Agents 메모리 문서: platform.claude.com/docs/en/managed-agents/memory
- daleseo 블로그: daleseo.com/claude-code-memory