Laya는 Jev를 "대체"한다기보다 "같은 API로 로컬에서 돌릴 수 있는 미세조정용 바탕"에 가깝습니다. 2026년 9월 15일 TypeSafe AI가 텍스트를 생성하지 않고 확률만 돌려주는 모델 Jev를 공개하자, 사흘 뒤인 9월 18일 인도 ConvAI Innovations의 Nandakishor M이 같은 종류의 모델 Laya를 Apache-2.0으로 풀었습니다. 저장소는 3주가 채 안 돼 별 3만 개를 넘겼고, "오픈소스가 Jev를 이겼다"는 글이 쏟아졌습니다. 이 글은 Laya와 TypeSafe의 공식 자료, 독립 벤치마크, 필자가 Mac에서 한국어 문장으로 돌려 본 결과를 바탕으로 두 모델이 어디서 갈리는지 정리합니다.
필자는 『클로드 코드 제대로 시작하기』를 썼고, 어비스에서 경제 분석 AI와 에이전트 파이프라인을 만듭니다. 이 글의 Laya 실험은 2026년 10월 6일에 필자의 Apple Silicon Mac(메모리 32GB)에서 laya 0.3.28로 직접 돌린 것이고, Jev는 필자가 직접 호출하지 않았으므로 공식 문서와 제3자 측정으로만 다룹니다.
핵심 요약
- 속도는 Laya가 앞서고, 비용은 GPU가 있을 때만 Laya가 유리합니다. T4 GPU에서 질문 하나에 32.8ms, 필자의 Mac에서도 30~53ms였습니다. Jev는 호스팅 API라 제3자 측정에서 236~552ms가 나왔고, 입력 100만 토큰당 0.042달러를 냅니다.
- 제로샷 정확도와 옵션이 많은 분류는 Jev가 앞섭니다. 독립 벤치마크 49개 과제에서 Jev 0.966 대 Laya 0.583이었고, 옵션 77개짜리 Banking77에서는 Jev 0.870 대 Laya 0.425였습니다. Laya가 내세우는 0.766은 그 벤치마크의 학습 데이터로 미세조정한 체크포인트 점수이고, 기본 체크포인트는 0.362입니다.
- 한국어는 둘 다 검증 없이 쓸 수 없습니다. Laya 다국어 체크포인트의 한국어 의도 분류 정확도는 0.47(20지선다, 무작위 0.05)이고, 필자 실험에서는 부서 분류만 쓸 만했습니다. TypeSafe도 CJK는 "영어만큼은 아니다"라고 밝힙니다.
- API는 서로 호환됩니다. Laya 서버는 Jev와 같은
POST /v1/systemone규격을 받아 클라이언트의 baseUrl만 바꾸면 되지만, confidence 공식과 옵션 수 제한이 달라 임계값은 다시 잡아야 합니다.
목차
- 결정 모델(System One)이란 무엇인가요?
- Laya는 무엇이고 왜 나왔나요?
- 한눈에 보는 Laya vs Jev 비교표
- 속도와 비용: 속도는 Laya, 비용은 장비에 달렸습니다
- 정확도: 옵션 수에 따라 승자가 바뀝니다
- 확률의 신뢰도: 둘 다 깨끗하지 않습니다
- 한국어 지원: 둘 다 검증이 먼저입니다
- 필자가 Mac에서 돌려 본 결과
- Jev 클라이언트를 Laya로 옮기는 법
- 언제 Laya, 언제 Jev, 언제 둘 다 아닌가
- 이 글의 자료를 고른 방법
- 자주 묻는 질문
결정 모델(System One)이란 무엇인가요?
결정 모델은 텍스트를 생성하지 않고, 미리 정해 둔 선택지 위의 확률 분포만 돌려주는 모델입니다. TypeSafe AI는 이 부류를 "System One 모델"이라고 부르는데, 카너먼의 『생각에 관한 생각』에 나오는 빠르고 직관적인 System 1에서 따온 이름입니다(TypeSafe Docs: System One, 2026-10-06 확인). LLM이 토큰을 하나씩 생성하는 동안 결정 모델은 모든 답을 한 번의 순전파로 동시에 내놓으므로, 응답을 파싱할 필요도 없고 JSON이 깨질 일도 없습니다.
두 모델이 받는 질문은 세 가지로 같습니다.
| 질문 유형 | 묻는 것 | 돌려주는 것 | 예 |
|---|---|---|---|
choice |
선택지 중 하나를 고르라 | 고른 키, 선택지별 확률, confidence | 어느 팀이 이 티켓을 맡아야 하나 → billing |
score |
순서가 있는 단계 위에 놓으라 | 기대 단계(실수), 단계별 확률 | 고객이 얼마나 화났나 → 1.4 |
noul |
예/아니오 | 예일 확률 0~1 | 환불을 요구하나 → 0.95 |
TypeSafe는 Jev를 2026년 9월 15일에 제한된 얼리 액세스로 공개하면서 DCVC가 이끈 4,000만 달러 시드 투자를 함께 발표했습니다. 창업자 디오고 알메이다(Diogo Almeida)는 OpenAI에서 InstructGPT와 ChatGPT의 바탕이 된 지시 따르기 연구를 했던 사람입니다(Introducing System One Models & Jev, TypeSafe AI, 2026-09-15). 투자 내용은 BusinessWire 배포 기사(Yahoo Finance, 2026-09-15)와 Wikipedia: Jev가 인용한 Forbes 보도로 확인했습니다. 공식 발표문은 Jev가 "System One 과제에서 기존 LLM과 비슷한 지능을 내면서 100배 규모로 빠르고 효율적"이며 "문자열 생성을 포기한 대신 환각을 일으킬 수 없다"고 썼습니다. 가격은 입력 100만 토큰당 0.042달러이고 출력 토큰은 무료입니다.
중요한 전제가 하나 있습니다. TypeSafe는 Jev의 아키텍처, 가중치, 논문을 공개하지 않았습니다. 모델은 jev-1.13.0 하나이고, 고객 데이터로 미세조정하지 않으며 같은 가중치가 모든 계정에 제공됩니다(TypeSafe Docs: Models, 2026-10-06 확인).
Laya는 무엇이고 왜 나왔나요?
Laya는 Jev와 같은 세 가지 질문을 받는 오픈 가중치 결정 모델입니다. ModernBERT-large 위에 결정 헤드를 얹은 4억 2,100만 파라미터짜리 영어 체크포인트와, mmBERT-base 기반 3억 2,200만 파라미터 다국어 체크포인트, 그리고 특정 벤치마크로 미세조정한 체크포인트까지 세 개를 한 Hugging Face 저장소에 묶어 배포합니다(Hugging Face: convaiinnovations/laya, 2026-10-06 확인). 라이선스는 Apache-2.0이라 상업 서비스에 넣어도 됩니다.
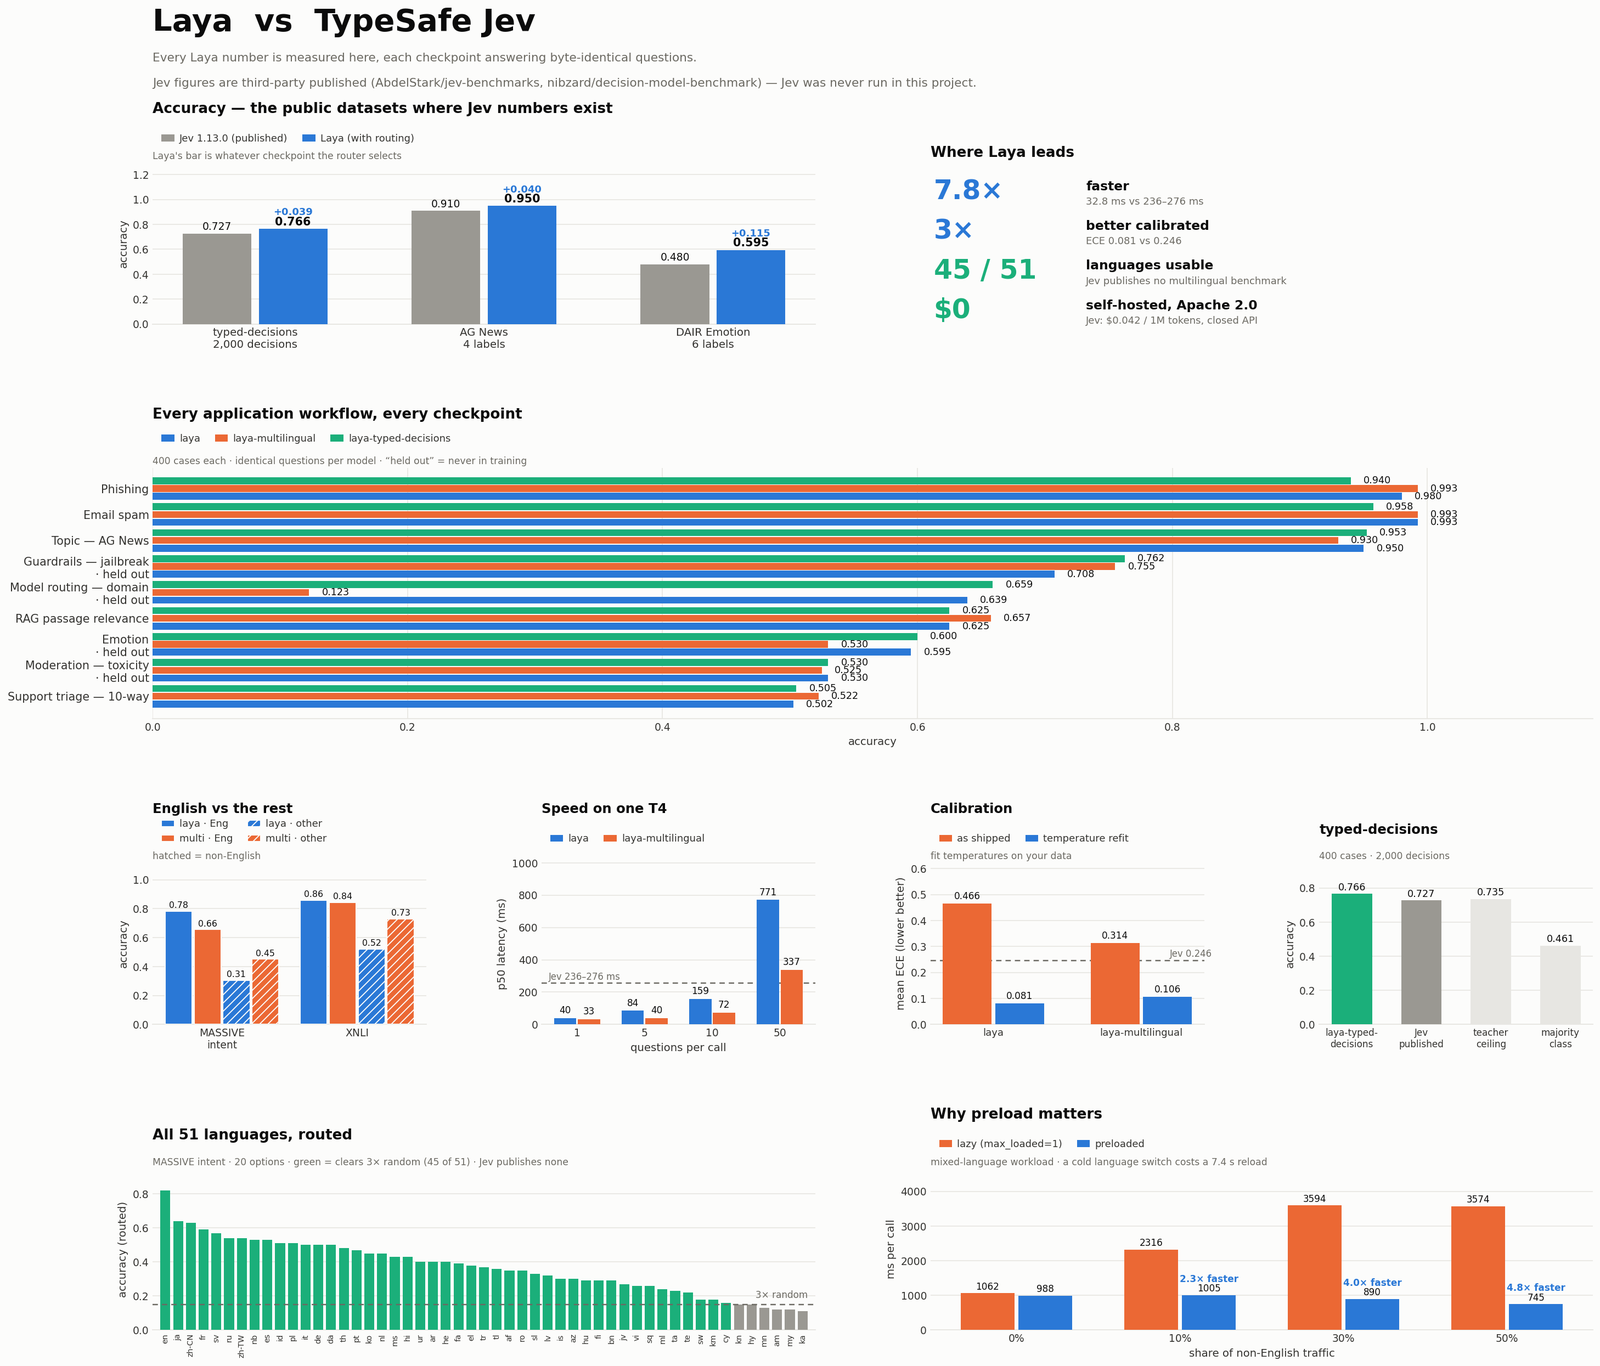
Laya의 등장 배경에는 선행 연구 논쟁이 있습니다. 저자 Nandakishor M은 2025년 3월에 세일즈 대화의 전환 확률을 강화학습으로 예측하는 비자기회귀 모델 논문(arXiv:2503.23303)을 냈고, Jev 발표 사흘 뒤 "1년 전에 같은 개념을 만들었는데 자금력 있는 연구소가 새 발견처럼 발표했다"는 글과 함께 Laya를 공개했습니다(dev.to, Nandakishor M, 2026-09-18). 커뮤니티 반응은 갈렸습니다. Hacker News에서 이 글은 97점을 받았지만, r/LocalLLaMA에서는 이전 모델이 데이터 누수가 있는 회귀였다는 반박과 "Salty Schmidhubering"이라는 비꼼도 나왔습니다(r/LocalLLaMA, 2026-09).
속도는 분명히 빨랐습니다. GitHub 저장소는 2026년 9월 18일에 만들어져 10월 6일 기준 별 30,964개, 포크 2,726개를 기록했고, PyPI에는 18일 동안 0.1.0에서 0.3.28까지 올라갔습니다(GitHub: NandhaKishorM/laya, GitHub API로 확인). 0.3.28 릴리스 노트는 기여자 12명의 PR 28개를 합쳤다고 적고 있어, 개인 프로젝트에서 커뮤니티 프로젝트로 넘어가는 중입니다.
한눈에 보는 Laya vs Jev 비교표
2026년 10월 6일 기준입니다. 굵은 글씨가 그 줄에서 앞서는 쪽입니다.
| 항목 | Laya | Jev (jev-1.13.0) |
|---|---|---|
| 가중치와 라이선스 | Apache-2.0, Hugging Face에서 내려받음 | 비공개, API만 제공 |
| 실행 위치 | 로컬 CPU, CUDA, Apple MPS, ONNX | TypeSafe 호스팅(미국) |
| 가격 | 0달러(자체 호스팅 비용만) | 입력 100만 토큰당 0.042달러, 출력 무료 |
| 크기 | 영어 421M(약 808MB), 다국어 322M(약 647MB) | 미공개 |
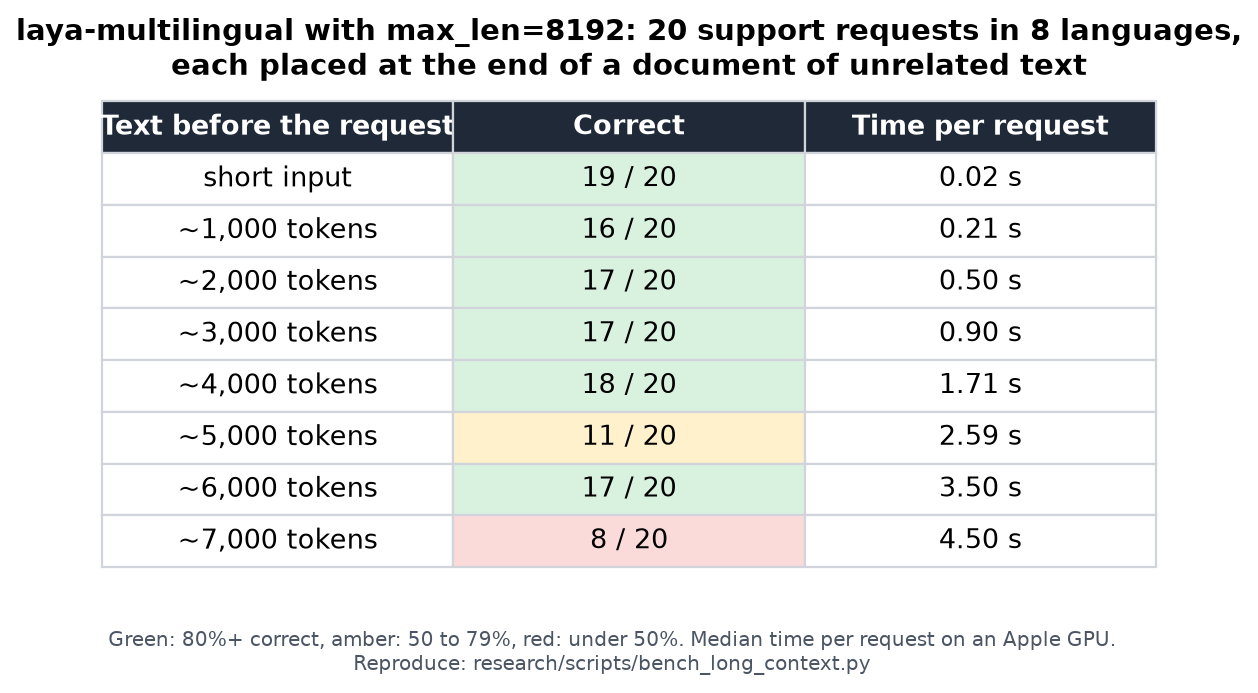
| 컨텍스트 | 영어 512토큰, 다국어 1,024(최대 8,192) | 요청당 64k, state 32k |
| choice 옵션 수 | 토큰 예산에 묶임, 20개 넘으면 급락, 서버는 100개까지 | 최대 255개 |
| 지연(질문 1개, p50) | T4 32.8ms, 필자 Mac 30~53ms | 제3자 측정 236~552ms, 공식 주장 70~500ms |
| 4~6옵션 분류(AG News, DAIR) | 0.950, 0.595 | 0.910, 0.480(제3자 측정) |
| 77옵션 분류(Banking77) | 0.425 | 0.870 |
| 독립 49과제 벤치마크(jabr v2) | 0.583 | 0.966 |
| 한국어 | 다국어 체크포인트, MASSIVE 의도 분류 0.47 | 공식 문서 "CJK는 영어만큼은 아님", 수치 없음 |
| 미세조정 | CSV 하나로 laya-train, Kaggle 무료 GPU 4시간 |
불가(요청의 instructions와 criteria로만 조정) |
| 데이터 처리 | 밖으로 나가지 않음 | 고객 요청으로 학습 안 함, 엔터프라이즈 ZDR |
| 운영 주체 | 개인 창업자 + 기여자 135명(2026-10-06 GitHub API) | 4,000만 달러 투자받은 회사 |
출처: Laya README와 BENCHMARKS.md, TypeSafe Models와 API 문서, jabr/classifier-benchmark, AbdelStark/jev-benchmarks. 기여자 수는 GitHub API의 contributors 목록을 센 값입니다.
속도와 비용: 속도는 Laya, 비용은 장비에 달렸습니다
지연에서는 Laya가 6~10배 빠릅니다. 다만 이 비교는 로컬 GPU와 바다 건너 API를 견주는 것이라 모델 자체의 속도 차이라기보다 배포 방식의 차이에 가깝습니다.
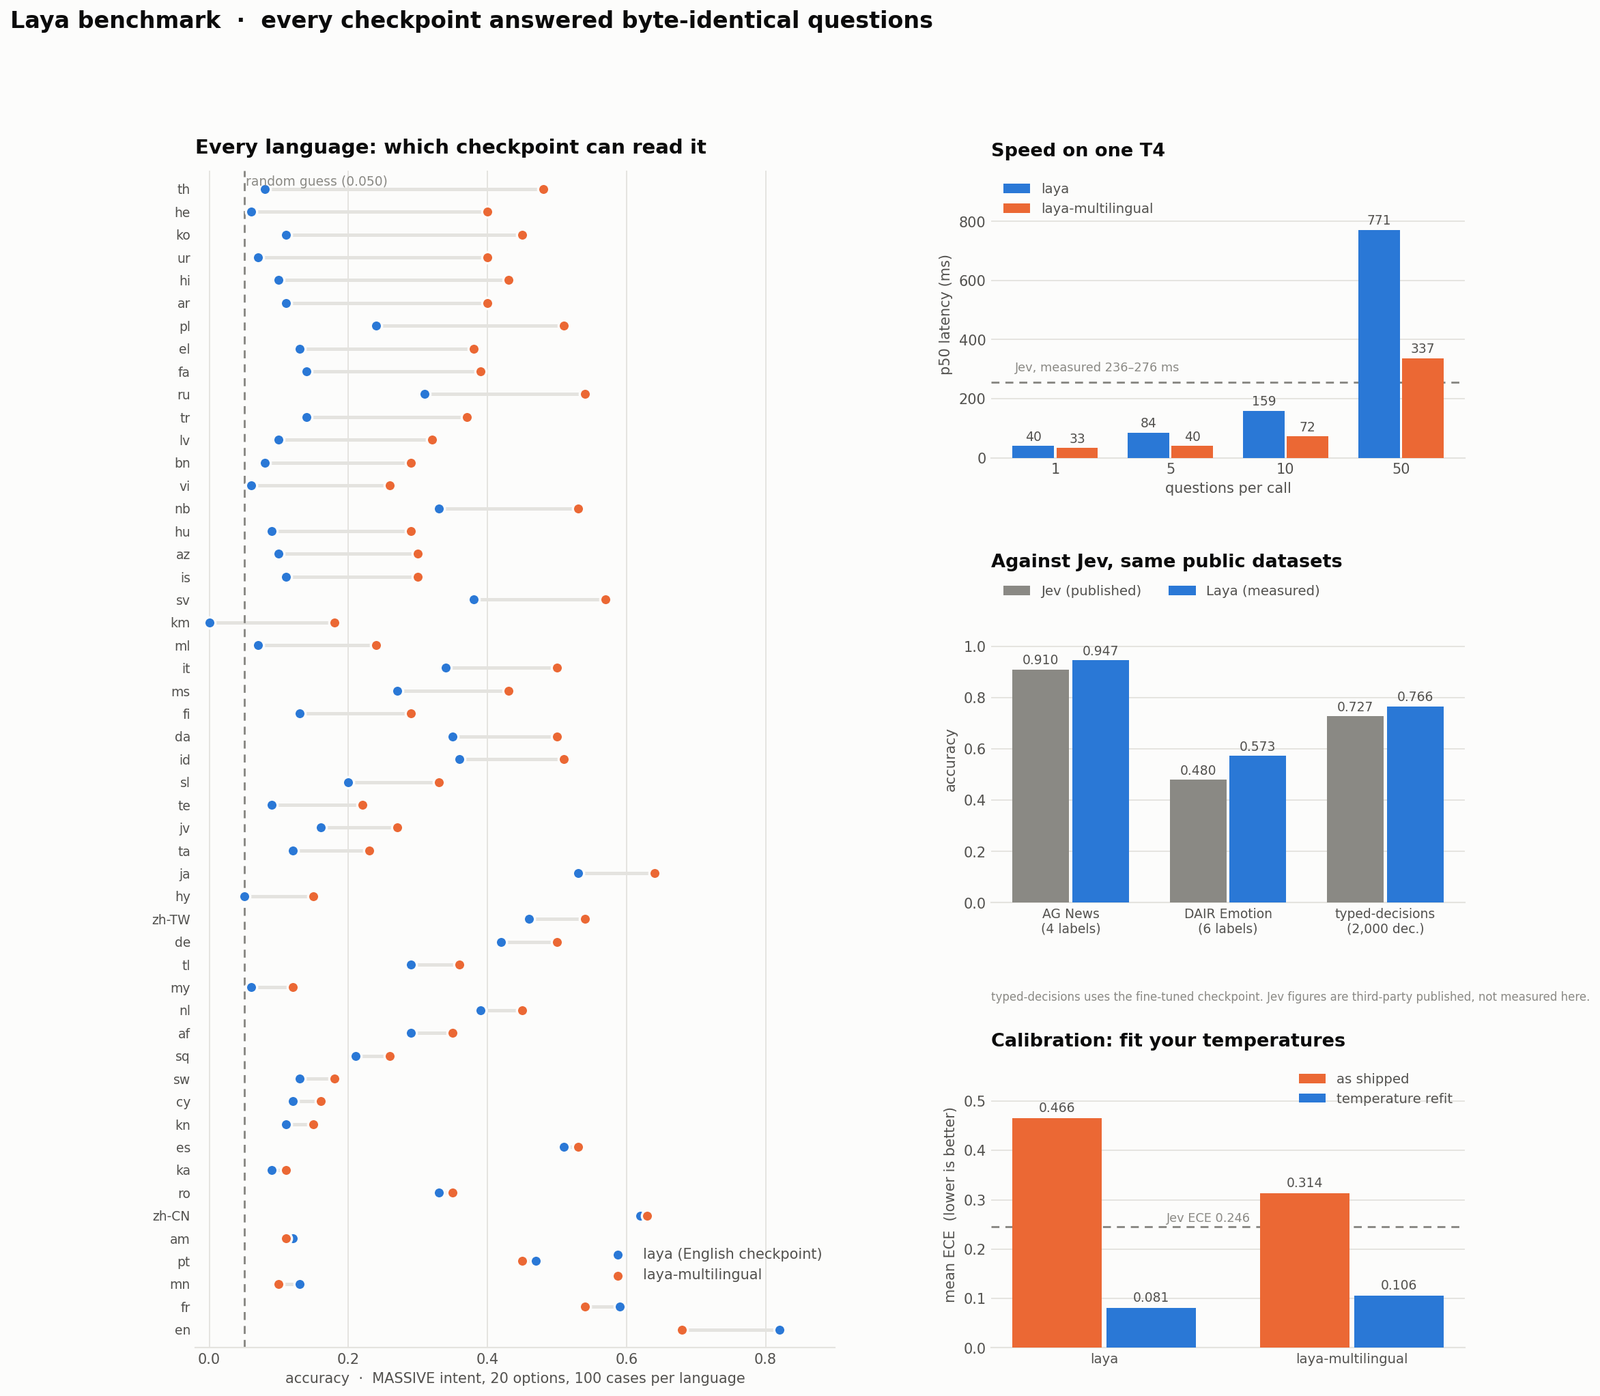
Laya 저장소가 Tesla T4 한 장에서 잰 값은 질문 하나에 영어 체크포인트 39.5ms, 다국어 체크포인트 32.8ms이고, 질문 10개를 한 번에 물으면 72.3ms로 질문당 7.2ms까지 내려갑니다(README: Benchmarks). 필자의 Mac에서는 질문 세 개를 묶어 물었을 때 영어 체크포인트 53ms, 다국어 체크포인트 30~35ms가 나왔습니다. Jev는 개발자 AbdelStark가 프랑스에서 호출했을 때 236~256ms, nibzard가 9월 29일 4만 건을 돌렸을 때 267~316ms, 동아시아에서 호출한 jevaiguide 테스트에서는 523~552ms였습니다(AbdelStark/jev-benchmarks, nibzard/decision-model-benchmark, jevaiguide). TypeSafe는 자사 측정이 서비스가 있는 미국 서부 해안에서 이뤄졌다고 밝히며 70~500ms를 주장합니다.
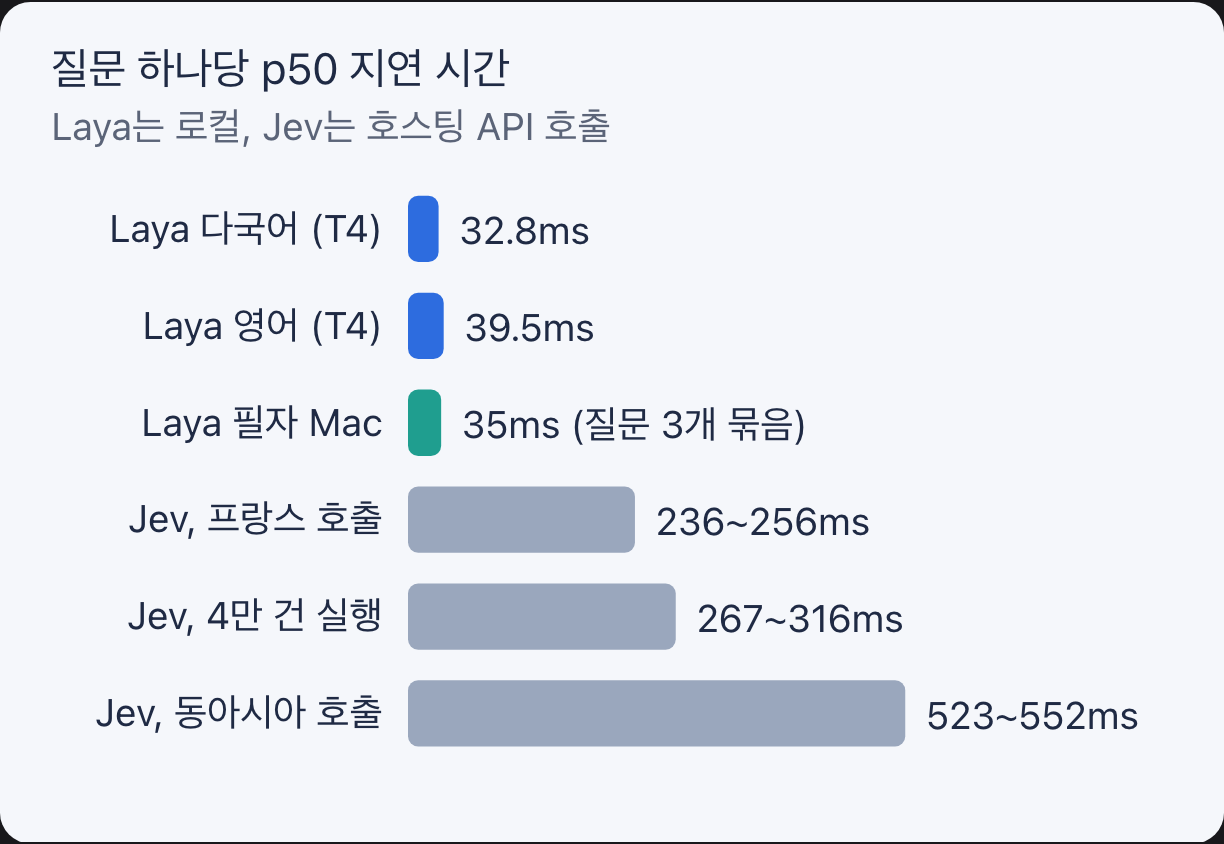
비용은 비교가 어렵습니다. Jev는 토큰당 과금이라 nibzard의 4만 226건 실행에 1.71달러가 들었습니다. Laya는 모델 값이 0이지만 GPU나 CPU를 직접 운영해야 하고, 한 블로거는 저가 CPU VPS에서 예열 후에도 평균 49초가 걸렸다고 썼습니다(flowtivity.ai, 2026-09-21). 저장소 문서도 CPU에서는 193~464ms라고 적고 있습니다. "0달러"는 GPU가 이미 있거나 Apple Silicon Mac에서 돌릴 때 이야기입니다.
판정: 지연과 데이터 주권이 중요하면 Laya, 서버를 관리하기 싫으면 Jev입니다. 비용은 트래픽과 보유 장비에 따라 다릅니다.
정확도: 옵션 수에 따라 승자가 바뀝니다
선택지가 적은 분류는 Laya가 비슷하거나 앞서고, 선택지가 많거나 과제가 다양해지면 Jev가 크게 앞섭니다. Laya가 내세우는 숫자와 독립 벤치마크의 숫자가 다른 그림을 그리는 이유가 여기에 있습니다.
Laya 저장소의 비교표는 AG News(4개 라벨) 0.950 대 0.910, DAIR Emotion(6개) 0.595 대 0.480으로 Laya가 앞선다고 보여 줍니다. 그러나 같은 표에 Banking77(77개 라벨)은 Jev 0.870 대 Laya 0.425로 적혀 있습니다. 저자는 선택지들이 192~256토큰짜리 예산을 나눠 쓰는 구조라 77개면 라벨당 3~4토큰밖에 남지 않는다고 설명하고, 20개 이하로 줄이거나 두 단계로 나누라고 권합니다(README: Where Jev leads). Jev는 선택지 255개까지 받습니다.
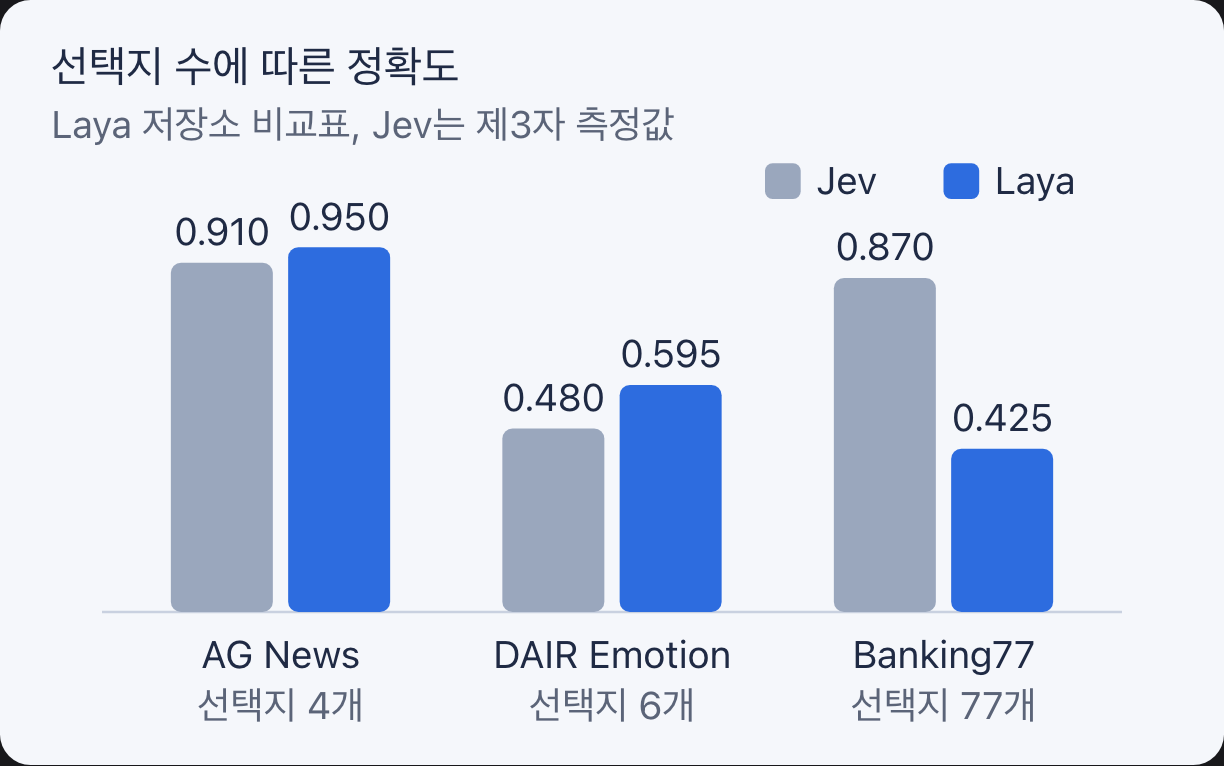
제3자가 양쪽을 같은 조건에서 돌린 결과는 Jev 쪽으로 더 기웁니다. 개발자 jabr가 49개 과제 866건으로 만든 벤치마크에서는 Jev 0.966, Von 0.720, GLiNER2 0.684, Laya 0.583이었고(jabr/classifier-benchmark v2), Mac mini M4 Pro에서 78건을 돌린 다른 테스트도 Jev 0.972 대 Laya 0.591이었습니다(Ap[e]Chat, 2026-09-20). bks-lab은 송장에서 날짜를 뽑는 과제에서 Laya 8~15% 대 Jev 83%, 117개 스킬 중 하나를 고르는 라우팅에서 Laya 5.5% 대 Jev 92.9%를 기록했습니다(bks-lab, 2026-09-24).
가장 널리 인용되는 "Laya 0.766 대 Jev 0.727"에도 단서가 있습니다. 이 0.766은 typed-decisions 벤치마크의 학습 분할 1,200건으로 미세조정한 laya-typed-decisions 체크포인트 점수입니다. 미세조정 전 기본 체크포인트는 0.362로, 다수 클래스만 찍는 기준선 0.461보다 낮습니다. 저자도 README에 "Laya is a fast base to specialise, not a zero-shot decision engine"이라고 적었습니다(README: Honest limits).
판정: 선택지 20개 이하의 영어 분류를 자체 데이터로 미세조정할 수 있으면 Laya, 과제가 다양하거나 선택지가 많고 미세조정할 데이터가 없으면 Jev입니다.
확률의 신뢰도: 둘 다 깨끗하지 않습니다
결정 모델의 핵심 약속은 "확률이 믿을 만하다"는 것인데, 두 모델 모두 조건부로만 그렇습니다. 확률을 믿고 자동 처리와 사람 검토를 가르려면 이 부분을 먼저 확인해야 합니다.
Laya는 출하 상태에서 과신합니다. 저장소가 밝힌 기대 보정 오차(ECE)는 영어 체크포인트 0.466, 다국어 0.314이고, 질문 유형과 선택지 수마다 온도(temperature) 하나씩을 자기 데이터로 다시 맞춰야 0.081과 0.106으로 내려갑니다. 다국어 체크포인트는 보정 온도 없이 출하됩니다(README: Calibration). 필자가 모델을 불러올 때도 "이 체크포인트는 유효하지 않은 온도를 담고 있으니 해당 항목의 confidence는 보정되지 않은 것으로 보라"는 경고가 떴습니다. 게다가 README의 51개 언어 ECE 표가 현재 코드로 재현되지 않는다는 이슈가 열려 있습니다(Issue #208). 긱뉴스에 실린 한 국내 개발자의 실측기도 같은 경고를 받았고, GPU 없는 PC에서 23건 중 18건을 맞혔지만 틀린 답에 confidence 0.8~0.9가 붙고 맞은 답에 0.01대가 붙어 채택을 보류했다고 썼습니다. 호출당 1.3초로 "33ms"는 T4 GPU 기준이라는 점도 짚었습니다(긱뉴스, decipher99, 2026-10-02).
Jev도 완벽하지 않습니다. AbdelStark의 측정에서 Jev는 DAIR Emotion의 16% 사례에서 정답 라벨에 확률 0을 줬고, nibzard는 "Jev의 confidence는 제공자가 정의한 점수이지 정답일 확률이 아니다"라고 결론지었습니다. TypeSafe 문서도 "보정은 예측 집단 전체에서 측정되는 것이며 개별 답이 맞는다는 보장은 아니다"라고 씁니다(TypeSafe Docs: System One).
실무자 보고 중 가장 눈에 띄는 것은 개발자 란 아루시(Ran Aroussi)의 글입니다. 그는 자기 서비스 MUXI에서 요청을 거르는 게이트에 Laya를 붙였다가 정상 요청의 93%를 오탐했고, 95MB짜리 임베딩 모델에 예시 몇 개를 붙인 분류기가 Laya와 Jev를 모두 이겼다며 "Jev의 주장은 옳지만 모델은 요점이 아니다"라고 썼습니다(@aroussi, 2026-09-22). 라벨이 많은 과제에서 MiniLM 임베딩과 로지스틱 회귀가 Banking77 90.3%로 오픈소스 결정 모델 셋을 모두 앞섰다는 측정도 있습니다(sotaaz.com, 2026-09-23).
판정: 어느 쪽이든 확률 임계값은 자기 데이터로 다시 맞춰야 하고, 학습 데이터가 충분하면 작은 분류기가 둘 다를 이길 수 있습니다. 사람 검토로 넘기는 기준을 먼저 정하고 자동 처리 범위를 서서히 넓히는 방식은, 필자가 메타 뮤즈 사용법 글에서 정리한 권한 설정 순서와 같은 사고방식입니다.
한국어 지원: 둘 다 검증이 먼저입니다
한국어로 쓰려면 Laya는 다국어 체크포인트로 라우팅되고 Jev는 "영어만큼은 아니다"라는 공식 경고가 붙습니다. 어느 쪽도 한국어 성능을 보장하지 않습니다.
Laya 저장소는 51개 언어에서 20지선다 의도 분류(MASSIVE)를 돌렸습니다. 한국어는 영어 체크포인트에서 0.110, 다국어 체크포인트에서 0.470(재실행마다 0.45~0.49)이었고 무작위는 0.050입니다. ECE는 0.680에서 0.311로 내려갔습니다(BENCHMARKS.md). 다국어 체크포인트가 네 배 넘게 낫지만, 같은 벤치마크의 영어 0.783과 견주면 절반 수준입니다. 저자는 영어 체크포인트의 confidence가 읽지 못하는 문자 체계에서도 0.885 아래로 내려가지 않는다는 점을 들어, 어느 체크포인트를 쓸지는 순전파 전에 정해야 한다고 강조합니다. 그래서 Laya의 Router는 22개 문자 체계를 감지해 한국어를 자동으로 다국어 체크포인트에 보냅니다.
Jev 쪽은 공식 문서가 "영어가 주 학습 언어이며 정확도가 가장 좋은 곳이고, CJK를 포함한 다른 언어는 처리되지만 같은 수준은 아니니 자기 콘텐츠로 테스트하라"고 적고 있습니다(TypeSafe Docs: Models). 한국어 수치는 없습니다.
국내 커뮤니티에서도 같은 결론이 나왔습니다. 파이토치 한국 사용자 모임 운영자는 Laya 소개 글에서 한국어가 두 체크포인트의 차이가 큰 언어에 속한다고 짚고, 한국어 서비스에 쓰려면 자체 데이터로 미세조정과 온도 재추정을 거치는 것이 전제라고 썼습니다(PyTorchKR, 2026-09-29). 그 글은 Apple Silicon용 Laya-MLX와 CoreML 포트도 함께 소개합니다.
한국어로 직접 미세조정해 본 사람들도 있습니다. 유튜브 채널 코드팩토리는 M4 Pro 맥북에서 한국어 쇼핑몰 고객 문의를 6개로 분류하는 합성 데이터로 Laya를 학습시켰는데, 기본 상태에서 250문항 중 82개(32.8%)를 맞히던 모델이 100건 학습 뒤 68.8%, 1,000건 뒤 86.4%, 1만 건을 약 8시간 학습한 뒤에는 검증 600문항에서 99.7%가 됐다고 보고했습니다. 같은 문항에서 Jev는 학습 없이 250문항을 모두 맞혔고, 응답은 Jev 약 0.5초 대 로컬 Laya 0.11초였습니다(코드팩토리, 2026-10-01). 개발자 멍개도 laya-multilingual로 한국어 문의 5분류를 미세조정하는 과정과 코드를 공개했는데, RTX 5070 Ti에서 2만 건이 약 20분 걸렸다고 합니다(멍개, 2026-10-02). 두 글의 결론은 같습니다. 가르치면 따라잡지만, 가르치기 전에는 쓸 수 없다는 것입니다.
Jev의 한국어 실측도 하나 있습니다. 인제대 의대 약리학교실의 안상진은 셀마다 100문항씩 검사해 Belebele 독해에서 한국어 96점, 영어 97점으로 차이가 거의 없었고, 한국 의사 국가시험 435문항에서는 Jev 86% 대 GPT-5.6 Luna 92%였다고 공개했습니다. 확신도 상위 절반만 쓰면 국시 오류가 20%에서 2%로 줄었다는 관찰도 있습니다(MahlerLab, 2026-09-17; 벤치마크 페이지). 100문항 표본이라 참고용이지만, 공식 문서의 경고보다는 나은 그림입니다.
필자가 Mac에서 돌려 본 결과
세 질문 유형 가운데 기본 체크포인트에서 바로 믿을 만한 것은 choice뿐이었습니다. score와 noul은 README가 미리 적어 둔 한계가 한국어에서 그대로 나타났습니다.
설치는 명령 하나입니다. 필자는 2026년 10월 6일 Apple Silicon Mac(메모리 32GB)에서 laya 0.3.28을 uv로 받아 돌렸고, 첫 호출에서 영어 체크포인트를 내려받는 데 189초, 다국어 체크포인트에 114초가 걸렸습니다. 그 뒤로는 질문 세 개 묶음이 30~53ms였습니다.
from laya import Router

router = Router()  # 첫 호출 때 체크포인트를 내려받는다
questions = {
    "department": {"type": "choice", "instructions": "Which department should handle this?",
                   "criteria": {"billing": "invoices, payments, refunds",
                                "technical": "bugs, outages, system errors",
                                "other": "everything else"}},
    "urgency": {"type": "score", "instructions": "How urgent is this?",
                "criteria": ["not urgent", "soon", "blocking"]},
    "churn_risk": {"type": "noul", "instructions": "Does the user threaten to cancel or leave?"},
}
r = router.predict("3월 요금이 두 번 결제됐어요. 오늘 중으로 환불해 주지 않으면 구독을 해지하겠습니다.", questions)
print(r["routing"]["model"])                      # multilingual (한국어를 감지해 자동 선택)
print(r["answers"]["department"]["choice"])       # billing
print(r["answers"]["churn_risk"]["noul"])         # 0.026 (해지 위협을 놓침)
한국어 문장 일곱 개와 영어 문장 세 개를 같은 질문으로 돌린 결과입니다. 실험 스크립트와 원본 JSON은 글 폴더의 experiments/에 두었습니다.
| 입력 문장 | 부서(choice) | 긴급도(score, 0~2) | 해지 위협(noul) |
|---|---|---|---|
| 3월 요금이 두 번 결제… 환불 안 하면 구독 해지 | billing 0.96 (맞음) | 1.82 | 0.089 (틀림) |
| 이번 달로 구독 해지할게요 | technical 0.50 (틀림) | 1.84 | 0.086 (틀림) |
| 서비스 잘 쓰고 있어요. 계속 결제할게요 | billing 0.998 | 1.74 (틀림) | 0.039 (맞음) |
| 로그인하면 500 에러, 급하진 않은데 확인 부탁 | technical 0.93 (맞음) | 1.84 (틀림) | 0.028 (맞음) |
| 결제 페이지 먹통, 매출 멈춤, 당장 봐 주세요 | billing 0.65 | 1.82 (맞음) | 0.082 (맞음) |
| 회원가입 혜택이 뭐가 있나요? | billing 0.90 (틀림) | 1.78 (틀림) | 0.028 (맞음) |
| 사무실 주소가 어디예요? | other 0.57 (맞음) | 1.69 (틀림) | 0.054 (맞음) |
| I will cancel my subscription at the end of this month. | billing 0.77 | 0.36 (맞음) | 0.799 (맞음) |
| Love the service, will keep paying next month too. | billing 0.91 | 0.70 | 0.821 (틀림) |
| Where is your office located? | billing 0.42 (틀림) | 1.07 | 0.787 (틀림) |
세 가지가 보입니다.
- 부서 분류는 쓸 만합니다. 환불과 오류 문장은 높은 확률로 맞췄고, 틀린 경우(회원가입 혜택을 billing으로)는 사람이 봐도 애매한 문장이었습니다.
- 한국어 긴급도는 문장과 무관하게 1.7~1.8이었습니다. "급하진 않은데"도, "서비스 잘 쓰고 있어요"도 최고 단계에 확률 0.73~0.86을 몰아줬습니다. 저장소 이슈 #131이 보고한 다국어 체크포인트의 위치 편향(첫 단계를 고르지 않음)과 일치합니다. 영어 체크포인트는 0.36에서 1.07까지 분산됐습니다.
- 해지 위협(noul)은 양쪽 모두 못 믿을 상태였습니다. 한국어는 "구독 해지할게요"도 0.09로 놓쳤고, 영어는
criteria로 예와 아니오를 설명해 주자 "Love the service"까지 0.82로 모두 '예'가 됐습니다. README의 Honest limits가 적은 대로 noul이 상태 대신 라벨 문구를 따라가는 문제(#156)입니다.
표본이 열 문장뿐인 필자 실험이라 일반화할 수는 없습니다. 다만 "설치해서 바로 한국어 서비스에 넣는다"는 시나리오가 성립하지 않는다는 점은 분명했고, 저자가 제공하는 laya-train으로 자기 데이터를 넣는 단계가 사실상 필수입니다.
Jev 클라이언트를 Laya로 옮기는 법
Laya 서버는 Jev와 같은 POST /v1/systemone 규격을 받으므로 기존 클라이언트는 주소만 바꾸면 돌아갑니다. 다만 응답의 의미가 다른 곳이 세 군데 있어 그대로 두면 조용히 틀립니다.
pip install "laya[serve]"
LAYA_DEVICE=mps LAYA_PRELOAD=1 laya-serve      # 0.0.0.0:8000, 체크포인트 미리 적재

curl -s localhost:8000/v1/systemone -H 'content-type: application/json' -d '{
  "state": {"body": "두 번 결제됐어요. 환불 안 해 주면 해지합니다"},
  "questions": {"dept": {"type": "choice", "instructions": "which team?",
                "criteria": {"billing": "refunds", "tech": "bugs"}}}
}'
Jev용 Python SDK나 Haskell 클라이언트 hs-jev는 baseUrl을 이 주소로 바꾸면 되고, LAYA_API_KEY를 두면 Bearer 토큰 인증도 같은 방식으로 받습니다(README: Self-Hosting). 옮길 때 README가 경고하는 차이는 다음과 같습니다.
| 항목 | Jev | Laya 서버 |
|---|---|---|
| choice 선택지 수 | 최대 255개 | 토큰 예산(192~256토큰)을 나눠 씀, 100개 넘으면 413, 20개 넘으면 정확도 급락 |
| score 단계 설명 | 생략 가능 | 모든 단계에 설명 필수, null이면 422 |
confidence 계산 |
(n·p_max − 1)/(n − 1) |
1 − 정규화 엔트로피. Jev에서 쓰던 임계값이 옮겨지지 않음 |
| 권장 게이트 값 | confidence |
answer_confidence(답으로 고른 항목의 확률) |
세 번째 줄이 가장 중요합니다. 같은 이름의 필드가 다른 공식으로 계산되므로, Jev에서 0.8로 잡았던 자동 처리 임계값을 Laya에 그대로 쓰면 자동 처리 비율이 달라집니다. 저장소는 선택지 수마다 임계값을 따로 맞추는 fit_abstention_thresholds를 제공합니다.
LangChain, LangGraph, LlamaIndex, CrewAI 래퍼와 MCP 서버, TypeScript와 .NET, Java 포트도 있어 에이전트 파이프라인에 넣기는 어렵지 않습니다. 필자는 Claude Code로 블로그 파이프라인을 운영하는데(Claude Code 팁 11가지, Claude Opus 5.5 잘 쓰는 법), 리서치 결과를 "원문 확인 / 스니펫"으로 가르는 것 같은 단순 분류를 이런 모델에 맡길 수 있는지 시험해 볼 생각입니다.
언제 Laya, 언제 Jev, 언제 둘 다 아닌가
Laya를 고르세요. 데이터가 밖으로 나가면 안 되거나, 응답 수십 ms가 필요하거나, 선택지 20개 이하의 분류를 자체 라벨 데이터로 미세조정할 수 있을 때입니다. GPU 한 장이나 Apple Silicon Mac이 있고, 온도 보정과 임계값 재측정을 할 각오가 있어야 합니다.
Jev를 고르세요. 과제가 다양해 미세조정 데이터를 모으기 어렵거나, 선택지가 수십 개 이상이거나, 서버 운영 없이 바로 쓰고 싶을 때입니다. 한 국내 블로거가 약관을 읽고 전한 바로는 선불 크레딧이 환불되지 않고 구매 12개월 뒤 만료된다는 점(m84vlog, 2026-09-25), 수요에 따라 바뀌는 요청 한도, 미국 리전만 있다는 점(innfactory.ai, 2026-10-04 확인)은 감수해야 합니다. TypeSafe가 공개한 1.13 버전의 약점 목록(숫자 세기, 날짜 비교, 간접 참조, 선택지 순서 민감)도 미리 읽어 두세요(Jev 1.13 jaggedness).
배수 숫자는 걸러 읽어야 합니다. 지디넷코리아의 안광섭 칼럼은 TypeSafe가 내세우는 "193배 빠르고 444배 싸다"가 가장 느린 모델과 가장 비싼 모델을 분모로 삼은 값이고, 정확도가 같은 모델 기준이면 약 25배와 76배라고 계산했습니다(지디넷코리아, 2026-09-20). Laya의 "7.8배 빠름"도 로컬 GPU 추론과 네트워크 왕복이 포함된 API 지연을 견준 것입니다. 요즘IT 기고는 Jev의 호스팅 API가 미국 리전뿐이라 국내 데이터 보관 요건이 있는 팀은 쓰기 어려울 수 있다고 짚었습니다(요즘IT, 2026-09-23).
둘 다 아닐 수 있습니다. 라벨이 정해져 있고 예시가 수백 건 이상 있으면, 작은 임베딩 모델에 로지스틱 회귀를 붙인 분류기가 더 정확하고 더 쌉니다. 결정 모델의 장점은 "학습 없이 자연어로 적은 질문을 받는다"는 것이지 정확도 자체가 아닙니다. Red Hat이 10월 2일에 공개한 가드레일 벤치마크도 "Jev 같은 결정 모델이 LLM 심판이나 기존 예측 모델, 오픈소스 결정 모델을 속도나 정확도에서 안정적으로 앞서지 못한다"고 결론지었습니다(Red Hat Developer, 2026-10-02).
그리고 Laya 외의 선택지도 있습니다. Jev 호환 API를 내는 오픈 모델로는 Qwen에 LoRA를 얹은 Kev, 동결된 Qwen의 로짓을 읽는 SemIf, Laya처럼 ModernBERT로 만든 Von 등이 있습니다. 커뮤니티가 만든 JevBench 종합 순위에서는 SemIf가 Laya보다 앞섰고, Kev는 자체 보고에서 Jev에 근접한 점수를 냈습니다. Laya의 차별점은 1GB 안팎의 크기에 다국어 라우터가 붙어 있다는 점과 가장 큰 커뮤니티입니다.
10월 들어서는 llama.cpp가 /v1/systemone 엔드포인트를 지원하기 시작해 M1 Pro 맥북에서 한국어 문의로 시험한 국내 후기가 나왔고(테크줍줍, 2026-10-03), 한국 개발자가 만든 Jev 호환 서빙과 벤치마크 도구 oh-my-jev는 한국어와 영어의 격차를 재는 표본과 한국어 특화 결정 모델을 함께 공개했습니다(긱뉴스, 2026-10-02). 아마존의 Strands Decider 2B처럼 큰 회사의 결정 모델도 나오기 시작해(ic8apa의 소개, 2026-10-03), Laya는 이제 "최초의 오픈 대안"이지 "유일한 대안"은 아닙니다.
이 글의 자료를 고른 방법
이 글은 2026년 10월 6일에 확인한 자료로 썼습니다. Laya 쪽 숫자는 GitHub README와 BENCHMARKS.md, Hugging Face 모델 카드, 공식 페이지에서, Jev 쪽 숫자는 TypeSafe 블로그와 docs.typesafe.ai에서 가져왔고 각 페이지를 직접 열어 확인했습니다. Jev의 정확도는 TypeSafe가 발표한 값이 아니라 AbdelStark, nibzard, jabr 등 제3자가 공개 저장소에 올린 측정값이며, Laya 저장소의 비교표 역시 이 값들을 옮긴 것임을 저장소가 명시합니다.
Jev 출시 경위는 TypeSafe 블로그와 TechCrunch, The Register 기사로, 투자 내용은 BusinessWire 배포 기사와 위키백과가 인용한 Forbes 보도로 확인했습니다. 커뮤니티 반응은 Hacker News, Reddit, X, dev.to의 최근 30일 글 66건을 모아 정리했고, 국내 자료는 긱뉴스, 파이토치 한국 사용자 모임, OKKY, 네이버 블로그, 유튜브 한국어 영상과 지디넷코리아, IT조선, 요즘IT 기사를 읽었습니다. 국내 블로그와 영상의 수치는 그 사람의 실험 결과(경험담)로만 소개했고, 모델 사양이나 가격의 근거로는 쓰지 않았습니다.
필자의 한계. Jev는 직접 호출하지 않았습니다. Laya 실험은 한 대의 Mac에서 열 문장으로만 돌린 것이라 통계적 의미는 없고, "설치 직후 상태가 어떤가"를 보여 주는 용도입니다. Laya 저자의 초기 글에 있던 "83.8% 대 67.8%"는 Jev 쪽 수치의 출처를 찾지 못해 쓰지 않았습니다.
자주 묻는 질문
Laya는 Jev의 오픈소스 버전인가요?
아닙니다. 두 모델은 같은 세 가지 질문 유형과 같은 API 규격을 쓰지만, Jev는 아키텍처와 가중치가 비공개이고 Laya는 ModernBERT와 mmBERT 인코더 위에 결정 헤드를 얹어 따로 학습한 모델입니다. Laya 저자는 Jev보다 1년 먼저 같은 개념의 논문을 냈다고 주장하고, 필자가 확인한 TypeSafe 공식 자료에는 Laya 언급이 없습니다.
노트북에서 돌아가나요?
돌아갑니다. 필자는 Apple Silicon Mac에서 GPU(MPS)로 질문 세 개를 30~53ms에 처리했고, 저장소는 CUDA, CPU, ONNX Runtime도 지원합니다. 체크포인트는 영어 약 808MB, 다국어 약 647MB입니다. 다만 CPU만 있으면 저장소 문서 기준 193~464ms이고, 저가 VPS에서는 수십 초가 걸렸다는 보고도 있으니 서비스용이라면 GPU를 권합니다. 공식 메모리 요구 사양은 문서에 없습니다.
Jev는 지금 바로 쓸 수 있나요?
2026년 9월 15일에 제한된 얼리 액세스로 시작했고, 국내 블로거가 약관과 공지를 확인한 바로는 9월 20일부터 대기 명단 없이 가입해 선불 크레딧을 충전하면 쓸 수 있습니다(m84vlog, 2026-09-25). 공식 퀵스타트도 콘솔에 로그인해 API 키를 받는 절차만 안내합니다(Quick start, 2026-10-06 확인). 요청 한도는 공식 문서에 초당 10만 토큰, 초당 80요청으로 적혀 있지만 수요에 따라 예고 없이 바뀐다는 경고가 붙어 있습니다. 가격은 입력 100만 토큰당 0.042달러이고 출력은 무료입니다(TypeSafe Docs: Models, 2026-10-06 확인).
한국어 고객 문의 분류에 바로 써도 되나요?
바로 쓰지는 마세요. 필자 실험에서 부서 분류는 맞췄지만 긴급도와 해지 위협은 틀렸고, 다국어 체크포인트의 한국어 의도 분류 정확도는 20지선다에서 0.47입니다. 코드팩토리의 실측처럼 한국어 데이터 1,000건이면 86%, 1만 건이면 99%대까지 올라간 사례가 있으니, 자기 문의 데이터로 laya-train을 돌려 미세조정하고 온도를 다시 맞춘 뒤, 확률 임계값을 검증 데이터로 정하는 과정이 필요합니다. 파이토치 한국 사용자 모임도 같은 전제를 달았습니다.
마무리: 대체가 아니라 다른 선택지
Laya가 Jev를 "대체"한다는 말은 API 호환성에 한해서만 맞습니다. 속도, 비용, 데이터 주권, 미세조정 가능성에서는 Laya가 앞서고, 설치 직후의 정확도와 선택지가 많은 과제, 운영 편의에서는 Jev가 앞섭니다. 한국어는 어느 쪽이든 자기 데이터로 검증해야 합니다.
- 선택지 20개 이하, 자체 라벨 데이터 있음, 로컬 실행 필요 → Laya를 미세조정해서 씁니다.
- 과제가 다양하고 데이터가 없음, 운영 부담 싫음 → Jev에 가입해 선불 크레딧으로 시작합니다.
- 라벨이 고정이고 예시가 충분함 → 임베딩 모델과 작은 분류기를 먼저 시험합니다.
- 어느 쪽이든
confidence임계값은 자기 데이터로 다시 잡습니다.
두 프로젝트 모두 출시 3주째라 숫자가 빠르게 바뀝니다. Jev가 새 버전을 내거나 Laya가 재학습한 체크포인트를 내면 이 글을 갱신하겠습니다.
글쓴이
주홍철은 네이버 출신 개발자이자 AI 핀테크 스타트업 어비스(AVISS)의 대표입니다. 경제·증시 분석 AI, AI 에이전트, 데이터 파이프라인을 직접 설계하고 개발하며, 『면접을 위한 CS 전공지식 노트』와 『클로드 코드 제대로 시작하기』(길벗)를 썼습니다. 회사 소개는 어비스 홈페이지에, 다른 글은 어비스 블로그에 있으며, 글에 대한 정정 요청이나 문의는 [email protected]으로 보내 주세요.