티맵 길찾기가 빨라진 이유는 길을 "더 빨리" 찾아서가 아니라 "덜" 찾아서입니다. 길을 묻기 전에 지름길을 미리 깔아 두고, 질문이 오면 양쪽에서 위층으로만 올라가 만나는 축약 계층(Contraction Hierarchies, CH) 계열 알고리즘 덕분입니다. 2026년 10월 7일 올라온 조코딩의 쇼츠 「네비게이션이 미친속도로 길을 찾아내는 비밀」은 이 이야기를 1분 안에 담았습니다. 서울역에서 부산역까지 3~6초 걸리던 길찾기가 즉시 끝나고, 1,800만 교차로짜리 유럽 도로망에서 확인하는 곳이 약 500만 곳에서 약 280곳으로 줄며, 티맵은 지름길 뼈대를 둔 채 도로별 소요 시간만 1분마다 바꿔 끼운다는 내용입니다. 영상에는 출처가 없어서, 이 글에서는 쇼츠의 숫자를 원논문과 티맵의 공식 기술 블로그에 하나씩 대 보고, 작은 격자 도로망에서 다익스트라와 CH를 직접 돌려 탐색 노드 수를 쟀습니다.
필자는 AI 핀테크 스타트업 어비스(AVISS)의 대표로 서비스를 직접 설계하고 개발합니다. 이 글의 자료는 Claude Code로 모으고 원문을 열어 확인했으며, 실험 코드는 설명용 예시로 만들어 2026년 10월 9일 로컬에서 돌린 결과입니다.
핵심 요약
- 쇼츠의 숫자는 대부분 맞고 하나가 틀립니다. 서유럽 도로망 정점 1,800만 개, 양방향 다익스트라 약 491만 곳, CH 280곳은 Bast 외 서베이(2015)의 표와 일치합니다. 다만 CH 질의 시간은 "1ms"가 아니라 110마이크로초(약 0.11ms)입니다.
- "100배"는 장거리 이야기입니다. 티맵모빌리티는 400km 이상 장거리에서 "거의 100배 이상" 빨라졌다고 밝혔고, 차트 값으로는 약 143배입니다. 전체 경로 평균으로는 응답시간이 92.02% 줄어 약 12.5배입니다.
- 티맵이 쓰는 것은 CH 그대로가 아니라 CCH(Customizable Contraction Hierarchies)입니다. 지름길 구조는 약 2주에 한 번 만들고, 실시간 교통이 바뀌면 지름길의 숫자만 다시 채웁니다. 쇼츠의 "지름길 뼈대는 두고 시간만 바꿔 끼운다"는 이 구조를 정확히 설명합니다.
- 교통 반영 주기는 자료마다 다릅니다. 2021년 공식 블로그는 "보통 5분에 한 번", 2022년 글은 "1분, 5분 단위", 2024년 인터뷰는 "1분마다"라고 했습니다.
- 직접 재 보니 도로망이 클수록 격차가 벌어졌습니다. 교차로 2,500개에서 4만 개로 늘리는 동안 다익스트라가 확정한 노드는 1,187곳에서 19,844곳으로 늘었고, CH는 95곳에서 437곳으로 늘었습니다. 배수로는 약 12배에서 45배입니다.
목차
- 쇼츠의 숫자를 원문과 맞춰 봤습니다
- 내비게이션 눈에 지도는 점과 선입니다
- 물결을 줄이는 첫 시도: 양방향 탐색과 A*
- 축약 계층: 길을 찾기 전에 지름길부터 깝니다
- 질의: 양쪽에서 위층으로만 올라갑니다
- 직접 재 봤습니다: 다익스트라와 CH의 탐색 노드 수
- 서유럽 도로망에서는 280곳, 0.11ms
- 실시간 교통이 들어오면 CH는 다시 지어야 합니다
- 티맵 Thor 엔진: A*에서 CCH로
- 내 서비스에 길찾기를 넣는다면
- 이 글의 한계와 주의할 점
- 이 글의 자료를 고른 방법
- 자주 묻는 질문
- 마치며
- 출처
쇼츠의 숫자를 원문과 맞춰 봤습니다
쇼츠가 든 숫자는 두 갈래에서 왔습니다. 유럽 도로망 숫자는 경로 탐색 분야의 대표 서베이 논문에서, 티맵 숫자는 티맵모빌리티의 기술 블로그와 언론 인터뷰에서 나왔습니다. 유럽 숫자의 원출처는 Hannah Bast, Daniel Delling, Andrew Goldberg, Peter Sanders, Dorothea Wagner 등 8명이 쓴 「Route Planning in Transportation Networks」의 Table 1입니다(arXiv 1504.05140, 2015-04-20). 이 표는 PTV가 제공한 서유럽 도로망(정점 1,800만 개, 방향 간선 4,250만 개)에서 무작위 출발지와 도착지를 골라 Intel X5680 3.33GHz 단일 코어로 잰 값입니다.
티맵 숫자는 2021년 12월 티맵모빌리티 공식 브런치 글(네비 개발자여, 번개처럼 빠른 경로탐색엔진을 만들라, 2021-12-21)과 2024년 2월 지디넷코리아 인터뷰(티맵 길찾기 더 빨라진다…"토르 알고리즘 적용", 2024-02-01)에 있습니다.
| 쇼츠 주장 | 원문 | 판정 |
|---|---|---|
| 서울역→부산역 길찾기 3~6초 | 지디넷 인터뷰에서 김재순 그룹장이 "에이스타 알고리즘은 계산량에 따라 짧게는 3초, 최악의 경우 6초"라고 설명. 2021년 브런치 글은 "요청당 2~3s 정도 혹은 그 이상, 간헐적" | 맞음(인터뷰 발언 기준) |
| 100배 빨라짐 | 브런치: "400km 이상 장거리 구간에서는 거의 100배이상". 전체 경로는 응답시간 -92.02% | 장거리에 한해 맞음 |
| 지금은 눈 깜짝할 새 | 실시간 내비게이션 응답시간은 비공개. 미래시간 길찾기는 평균 50ms, 400km 이상 평균 300ms 이하 | 부분 확인 |
| 교차로 1,800만 개 유럽 도로망 | 서유럽 정점(vertex) 1,800만 개 | 맞음 |
| 양쪽에서 찾아도 약 500만 곳 | 양방향 다익스트라 4,914,804곳 | 맞음(약 491만) |
| 축약 계층은 약 280곳 | CH 280곳 | 정확히 일치 |
| 1ms면 끝 | CH 110µs(약 0.11ms). 1.65ms는 CRP라는 다른 기법의 값 | 틀림 |
| 지름길 뼈대는 두고 시간만 바꿔 끼움 | 티맵은 CCH를 써서 지름길 구조와 가중치를 분리 | 맞음(정확히는 CCH) |
| 1분마다 실시간 교통 반영 | 2024년 인터뷰 "1분마다", 2022년 블로그 "1분, 5분 단위", 2021년 블로그 "보통 5분에 한번" | 시기마다 다름 |
틀린 것은 하나지만 방향이 흥미롭습니다. 쇼츠는 CH를 실제보다 9배쯤 느리게 말했습니다. 그리고 "100배"는 장거리 숫자라는 단서가 빠졌습니다. 다만 쇼츠가 예로 든 서울에서 부산은 티맵모빌리티가 느린 장거리 경로의 예로 직접 든 구간이라, 예시 자체는 그 조건에 들어맞습니다. 나머지는 원문과 거의 정확히 맞아서, 짧은 영상치고 꼼꼼하게 만든 편입니다.
내비게이션 눈에 지도는 점과 선입니다
내비게이션은 지도를 교차로라는 점과 도로라는 선으로 된 그래프로 보고, 선마다 걸리는 시간을 적어 둔 뒤 출발점에서 도착점까지 시간의 합이 가장 작은 경로를 찾습니다. 이 문제의 고전적인 답이 1959년 에츠허르 다익스트라가 발표한 알고리즘입니다(A Note on Two Problems in Connexion with Graphs, Numerische Mathematik, 1959). 출발점에서 가장 가까운 교차로부터 하나씩 "여기까지는 이 시간이 최단"이라고 확정하며 물결처럼 넓혀 가다가, 도착점이 확정되면 멈춥니다.
이 방식은 정확하지만 먼 길에 약합니다. 물결은 목적지 방향을 모르고 사방으로 퍼지기 때문에, 서울에서 부산을 찾는 동안 강릉과 목포 쪽 골목도 똑같이 훑습니다. 서베이 Table 1에서 다익스트라는 서유럽 도로망의 무작위 질의 한 번에 평균 9,326,696곳을 확정했고 2.2초가 걸렸습니다. 전체 정점 1,800만 개의 절반쯤을 훑은 셈입니다.
물결을 줄이는 첫 시도: 양방향 탐색과 A*
물결을 줄이는 가장 쉬운 방법은 출발점과 도착점 양쪽에서 동시에 물결을 일으켜 가운데서 만나게 하는 것입니다. 반지름이 절반인 원 두 개는 큰 원 하나보다 면적이 작기 때문입니다. 그러나 실제 도로망에서는 효과가 생각보다 작습니다. 서베이의 양방향 다익스트라는 평균 4,914,804곳을 확정해 단방향의 절반 남짓이었고, 1.2초가 걸렸습니다. 쇼츠의 "양쪽에서 찾아도 약 500만 곳"이 이 값입니다.
다른 방법은 물결에 방향을 주는 것입니다. A*는 "여기서 목적지까지 직선거리로 최소 이만큼은 걸린다"는 추정치를 더해 목적지 쪽 교차로를 먼저 확정합니다. 티맵이 2021년까지 쓰던 엔진이 A*였습니다. 티맵모빌리티는 A*가 휴리스틱으로 탐색 범위를 줄였지만 결국 노드를 방문하며 퍼지는 방식이라 그래프가 커질수록 느려졌고, 택시 배차나 택배 경유지 계산처럼 출발지 n곳과 도착지 m곳 사이를 한꺼번에 구하는 n×m 경로 계산에는 쓸 수 없었다고 적었습니다(티맵모빌리티 브런치, 2021-12-21). 도로가 개통되고 상세해질수록 그래프가 커졌고 사용자도 늘면서, 서울에서 부산 같은 경로는 요청당 2~3초 이상 걸리는 경우가 간헐적으로 생겼다는 설명입니다.
축약 계층: 길을 찾기 전에 지름길부터 깝니다
축약 계층은 질문이 오기 전에 덜 중요한 교차로를 하나씩 지우고, 그 교차로를 지나던 최단 경로를 지름길 선 하나로 이어 두는 전처리 기법입니다. 2008년 카를스루에 공과대학(KIT)의 Robert Geisberger, Peter Sanders, Dominik Schultes, Daniel Delling이 발표했습니다(Contraction Hierarchies: Faster and Simpler Hierarchical Routing in Road Networks, WEA 2008). 이름 그대로 "축약(contraction)"을 반복해 "계층(hierarchy)"을 만듭니다.
과정은 세 단계로 요약됩니다.
- 중요도 순서를 정합니다. 동네 골목 교차로처럼 지워도 영향이 적은 노드가 먼저, 고속도로 분기점처럼 많은 경로가 지나는 노드가 나중입니다. 원논문은 노드를 지웠을 때 늘어나는 지름길 수와 사라지는 간선 수의 차이(edge difference) 같은 여러 항을 섞어 우선순위를 매기고, 축약이 진행되며 바뀌는 우선순위를 그때그때 다시 계산합니다.
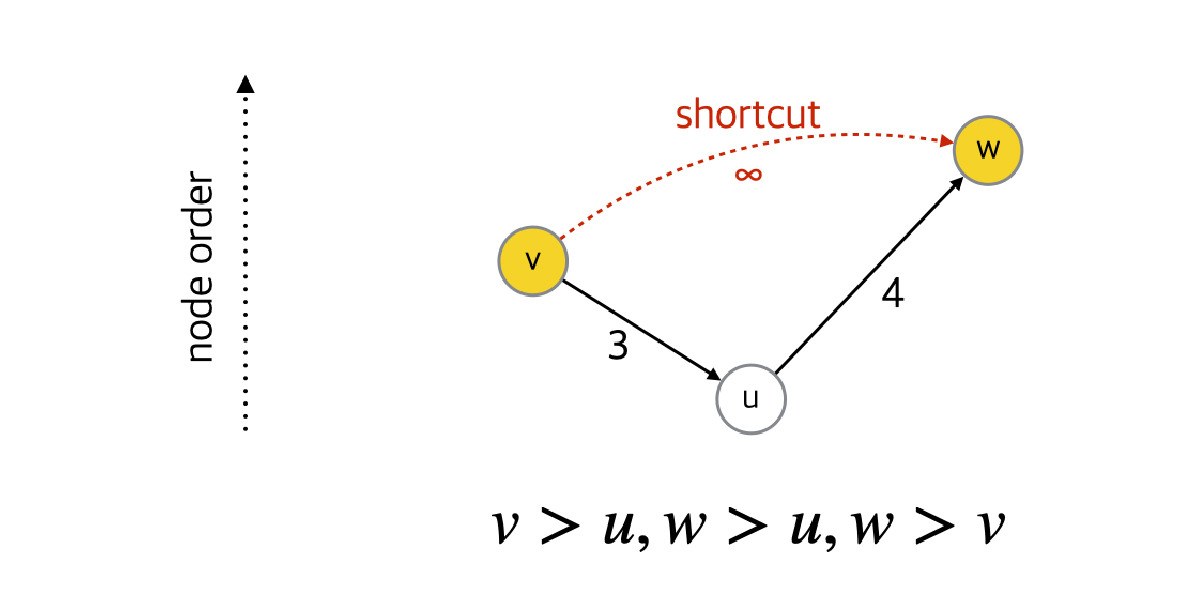
- 노드 u를 지우면서 이웃 v와 w 사이를 확인합니다. v→u→w가 v에서 w로 가는 유일한 최단 경로라면, 그 길이를 그대로 담은 지름길 v→w를 추가합니다.
- u를 거치지 않는 다른 길이 같거나 더 짧으면 지름길을 만들지 않습니다. 이 다른 길을 증인 경로(witness path)라고 부르고, u를 뺀 채 가까운 범위만 훑는 국소 탐색으로 찾습니다.
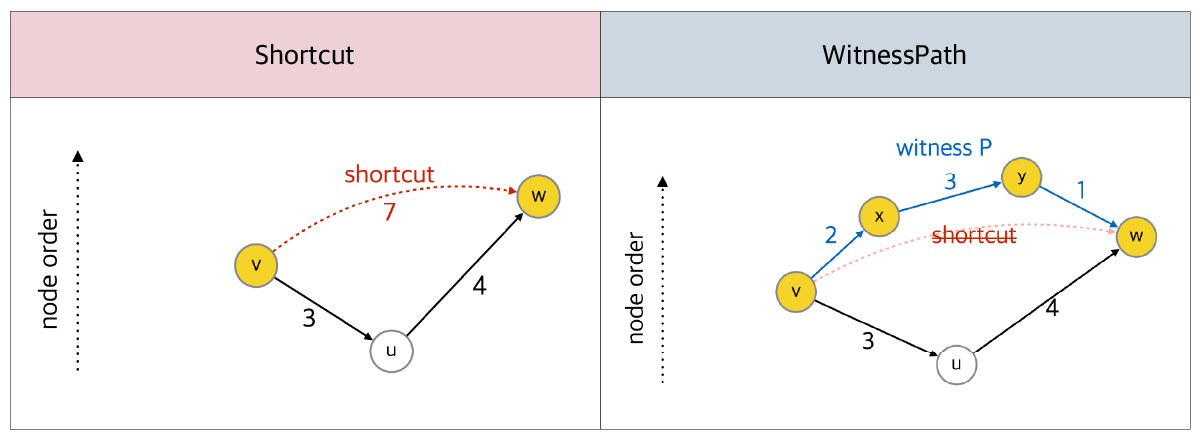
이렇게 지우고 잇기를 끝까지 반복하면 골목 위에 큰길, 큰길 위에 고속도로가 얹힌 층이 생깁니다. 원래 도로는 하나도 사라지지 않고, 지름길이 덧붙을 뿐입니다. 지름길은 "이 두 지점 사이 최단 시간은 이만큼"이라는 요약이므로, 경로를 보여 줄 때는 지름길을 원래 도로로 다시 풀어(unpack) 안내합니다.
질의: 양쪽에서 위층으로만 올라갑니다
CH의 질의는 출발점과 도착점에서 각각 다익스트라를 돌리되, 자기보다 중요도가 높은 노드로 가는 선만 따라가는 양방향 탐색입니다. 두 물결은 아래층으로 내려가지 않고 위층으로만 올라가다가 가장 높은 곳 근처에서 만나며, 만난 지점 가운데 합이 가장 작은 곳이 답입니다.
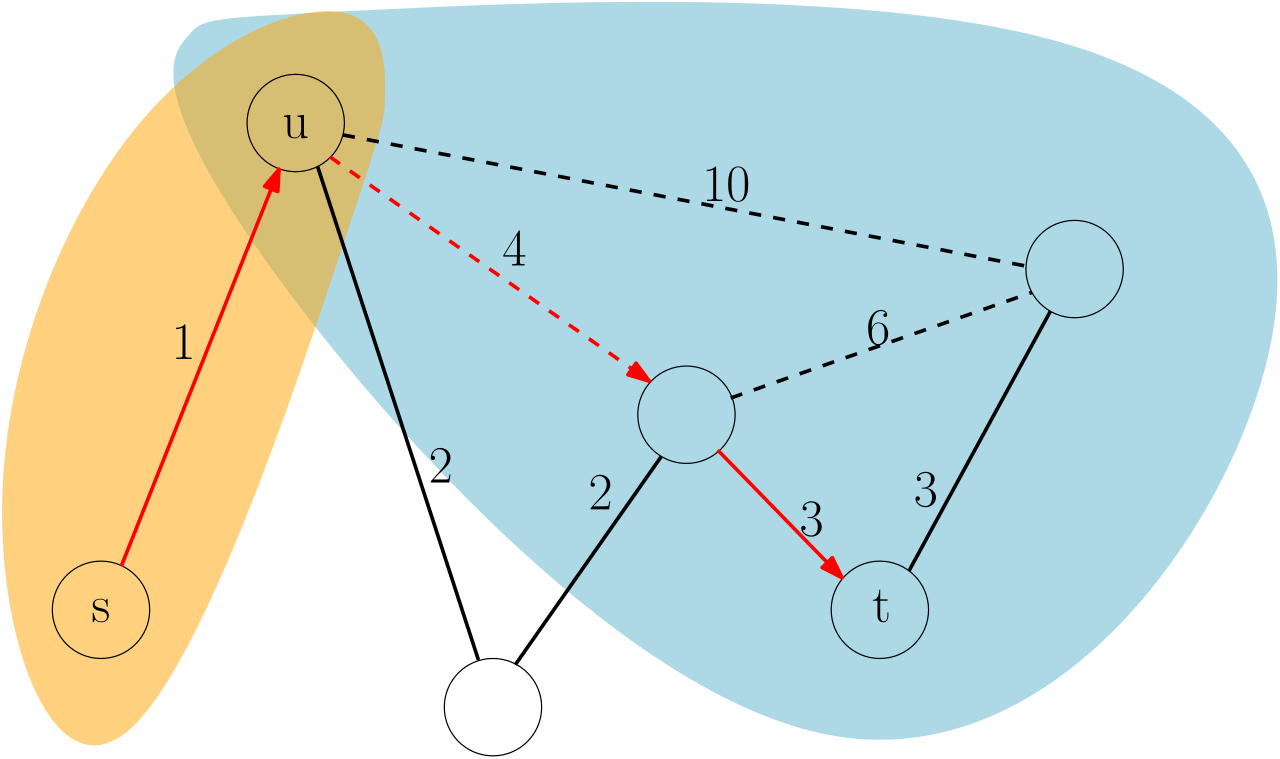
위로만 올라가도 답이 틀리지 않는 이유는 지름길 덕분입니다. 어떤 최단 경로든 그 위에서 가장 중요한 노드가 하나 있습니다. 그 노드보다 덜 중요한 노드는 모두 먼저 지워졌고, 지워질 때마다 그 노드를 지나는 최단 경로는 지름길로 이어졌습니다. 그래서 출발점에서 꼭대기까지는 오르막만으로, 꼭대기에서 도착점까지는 내리막만으로 같은 길이의 경로가 반드시 존재합니다. 역방향 탐색이 도착점에서 오르막을 타는 것은 이 내리막을 거꾸로 걷는 것입니다.
위층으로 갈수록 노드 수가 급격히 줄어들기 때문에, 두 물결이 훑는 범위는 그래프 크기에 비해 아주 작습니다. 이것이 쇼츠가 말한 "확인하는 곳 약 280곳"의 정체입니다.
직접 재 봤습니다: 다익스트라와 CH의 탐색 노드 수
설명이 맞는지 보려고 파이썬으로 작은 도로망을 만들어 세 가지 방법이 확정하는 노드 수를 쟀습니다. 교차로 1만 개짜리 격자에서 다익스트라는 평균 4,875곳, 양방향 다익스트라는 2,189곳, CH는 174곳을 확정했습니다. 도로망은 격자 모양 골목(소요 시간 6~12)에 10칸마다 빠른 간선도로(소요 시간 1~3)를 깐 것이고, 무작위 출발지와 도착지 200쌍으로 평균을 냈습니다. 세 방법이 내놓은 최단 거리가 200쌍 모두 같은지 assert로 확인했습니다. 아래 코드는 필자가 Claude Code와 함께 만든 설명용 예시로, 표준 라이브러리만 씁니다. 실제 엔진에 있는 stall-on-demand 같은 가지치기와 경로 풀기는 뺐습니다.
import heapq
import random
import time

random.seed(7)
N = 100  # N x N 격자, 교차로 1만 개

def build_grid(n):
    graph = {v: {} for v in range(n * n)}
    for r in range(n):
        for c in range(n):
            v = r * n + c
            for dr, dc in ((0, 1), (1, 0)):
                rr, cc = r + dr, c + dc
                if rr < n and cc < n:
                    w = rr * n + cc
                    fast = (dr == 0 and r % 10 == 0) or (dc == 0 and c % 10 == 0)
                    t = random.randint(1, 3) if fast else random.randint(6, 12)
                    graph[v][w] = graph[w][v] = t
    return graph

def dijkstra(graph, s, t):
    dist, pq, settled = {s: 0}, [(0, s)], set()
    while pq:
        d, v = heapq.heappop(pq)
        if v in settled:
            continue
        settled.add(v)
        if v == t:
            return d, len(settled)
        for w, c in graph[v].items():
            if d + c < dist.get(w, float("inf")):
                dist[w] = d + c
                heapq.heappush(pq, (d + c, w))
    return float("inf"), len(settled)

def bidirectional(graph, s, t, rank=None):
    """양방향 다익스트라. rank가 있으면 CH 질의처럼 순위가 높은 쪽으로만 올라간다."""
    dist = [{s: 0}, {t: 0}]
    pq = [[(0, s)], [(0, t)]]
    done = [set(), set()]
    best = float("inf")
    while pq[0] or pq[1]:
        if rank is None and pq[0] and pq[1] and pq[0][0][0] + pq[1][0][0] >= best:
            break  # 두 물결의 반지름 합이 best를 넘으면 더 짧은 길은 없다
        for side in (0, 1):
            if not pq[side]:
                continue
            d, v = heapq.heappop(pq[side])
            if v in done[side]:
                continue
            if d >= best:  # CH: 이 방향에서는 더 나은 만남이 나올 수 없다
                pq[side] = []
                continue
            done[side].add(v)
            for w, c in graph[v].items():
                if rank and rank[w] < rank[v]:
                    continue  # CH 질의는 위층으로만 간다
                if d + c < dist[side].get(w, float("inf")):
                    dist[side][w] = d + c
                    heapq.heappush(pq[side], (d + c, w))
                if w in dist[1 - side]:
                    best = min(best, dist[side][w] + dist[1 - side][w])
    return best, len(done[0]) + len(done[1])

def witness(graph, u, skip, limit, max_settle=60):
    """skip을 거치지 않고 u에서 limit 이하로 갈 수 있는 거리를 찾는 국소 탐색."""
    dist, pq, n = {u: 0}, [(0, u)], 0
    while pq and n < max_settle:
        d, v = heapq.heappop(pq)
        if d > limit:
            break
        n += 1
        for w, c in graph[v].items():
            if w != skip and d + c < dist.get(w, float("inf")):
                dist[w] = d + c
                heapq.heappush(pq, (d + c, w))
    return dist

def shortcuts_needed(graph, v):
    out = []
    nbrs = list(graph[v].items())
    for i, (u, cu) in enumerate(nbrs):
        limit = cu + max(c for _, c in nbrs)
        dist = witness(graph, u, v, limit)
        for w, cw in nbrs[i + 1:]:
            if dist.get(w, float("inf")) > cu + cw:  # 증인 경로가 없으면 지름길이 필요하다
                out.append((u, w, cu + cw))
    return out

def contract(graph):
    """덜 중요한 교차로부터 지우고, 필요한 곳에만 지름길을 깐다."""
    g = {v: dict(e) for v, e in graph.items()}
    rank, ch, added = {}, {v: {} for v in graph}, 0
    pq = [(len(shortcuts_needed(g, v)) - len(g[v]), v) for v in g]
    heapq.heapify(pq)
    while pq:
        _, v = heapq.heappop(pq)
        sc = shortcuts_needed(g, v)
        prio = len(sc) - len(g[v])  # 간선 차이: 늘어날 지름길 수 - 사라질 간선 수
        if pq and prio > pq[0][0]:  # 우선순위가 바뀌었으면 다시 줄 세운다(lazy update)
            heapq.heappush(pq, (prio, v))
            continue
        rank[v] = len(rank)
        for u, c in g[v].items():  # 남은 이웃은 모두 v보다 나중에 지워진다(순위가 높다)
            ch[v][u] = ch[u][v] = c
        for u, w, c in sc:
            if c < g[u].get(w, float("inf")):
                added += w not in g[u]
                g[u][w] = g[w][u] = c
        for u in g[v]:
            del g[u][v]
        g[v] = {}
    return rank, ch, added

if __name__ == "__main__":
    graph = build_grid(N)
    t0 = time.time()
    rank, ch, added = contract(graph)
    roads = sum(len(e) for e in graph.values()) // 2
    print(f"교차로 {len(graph):,}개, 도로 {roads:,}개, 지름길 {added:,}개, 전처리 {time.time() - t0:.1f}초")

    pairs = [tuple(random.sample(range(N * N), 2)) for _ in range(200)]
    totals = {"dijkstra": 0, "bidirectional": 0, "ch": 0}
    for s, t in pairs:
        d1, n1 = dijkstra(graph, s, t)
        d2, n2 = bidirectional(graph, s, t)
        d3, n3 = bidirectional(ch, s, t, rank)
        assert d1 == d2 == d3, (s, t, d1, d2, d3)  # 세 방법의 답은 같아야 한다
        totals["dijkstra"] += n1
        totals["bidirectional"] += n2
        totals["ch"] += n3
    for name, total in totals.items():
        print(f"{name:>13}: 평균 {total / len(pairs):,.0f}곳 확정")
N을 50, 100, 200으로 바꿔 돌린 결과는 아래와 같습니다. 실행 시간은 비교하지 않았습니다. 파이썬 딕셔너리로 짠 코드의 시간은 C++ 엔진과 비교할 수 없어서, 알고리즘의 일거리를 나타내는 확정 노드 수만 봤습니다.
| 격자 | 교차로 | 원래 도로 | 추가된 지름길 | 전처리 | 다익스트라 | 양방향 | CH | 다익스트라 ÷ CH |
|---|---|---|---|---|---|---|---|---|
| 50×50 | 2,500 | 4,900 | 4,969 | 0.5초 | 1,187곳 | 387곳 | 95곳 | 약 12배 |
| 100×100 | 10,000 | 19,800 | 21,304 | 2.3초 | 4,875곳 | 2,189곳 | 174곳 | 약 28배 |
| 200×200 | 40,000 | 79,600 | 85,793 | 10.0초 | 19,844곳 | 11,257곳 | 437곳 | 약 45배 |
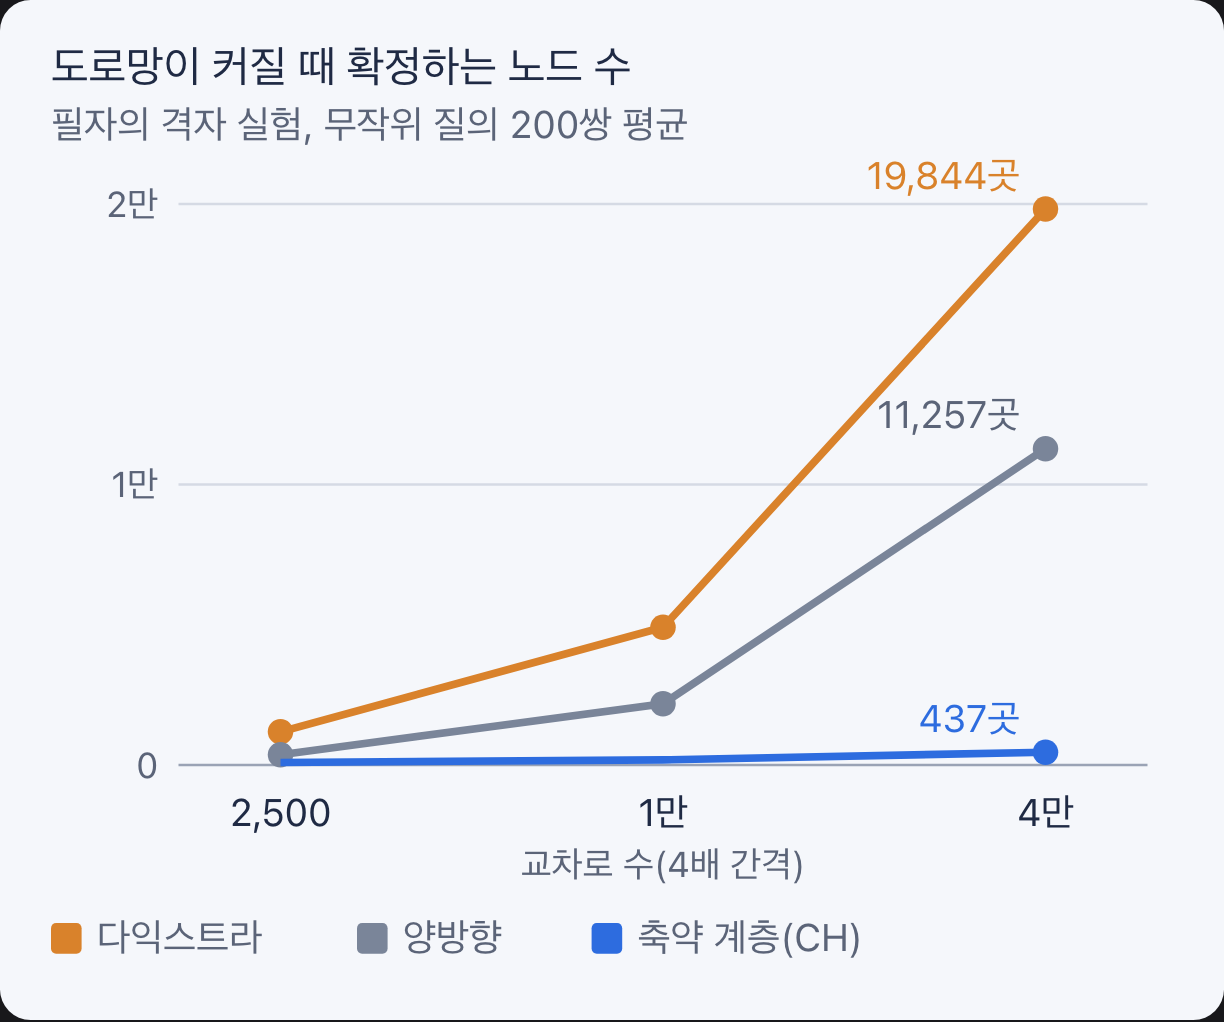
결과에서 읽을 것은 두 가지입니다. 첫째, 다익스트라의 일거리는 도로망 크기에 거의 비례해 늘지만 CH는 훨씬 느리게 늘어서, 도로망이 클수록 격차가 벌어집니다. 장거리일수록 효과가 크다는 티맵의 결과와 같은 방향입니다. 둘째, 공짜가 아닙니다. 원래 도로만큼의 지름길이 더 생겼고, 질의 전에 전처리를 따로 돌려야 했습니다. 티맵도 원본 간선 약 2천만 개에 지름길 약 7천만 개를 더해 약 9천만 개의 그래프를 다룬다고 밝혔습니다(티맵, 3시간 뒤 출발하면 얼마나 걸려?, 티맵모빌리티, 2023-01-06).
이 실험은 격자라서 실제 도로망보다 CH에 불리한 편입니다. 실제 도로망은 고속도로라는 뚜렷한 위계가 있어 CH가 더 잘 듣습니다. 정점(교차로) 1,800만 개에서 280곳이라는 서베이 값이 그 차이를 보여 줍니다.
서유럽 도로망에서는 280곳, 0.11ms
같은 서유럽 도로망에서 CH는 다익스트라보다 확정 노드가 약 3만 3천 분의 1이고, 질의 시간은 약 2만 분의 1입니다. 서베이 Table 1의 값을 로그 눈금으로 그리면 아래와 같습니다.
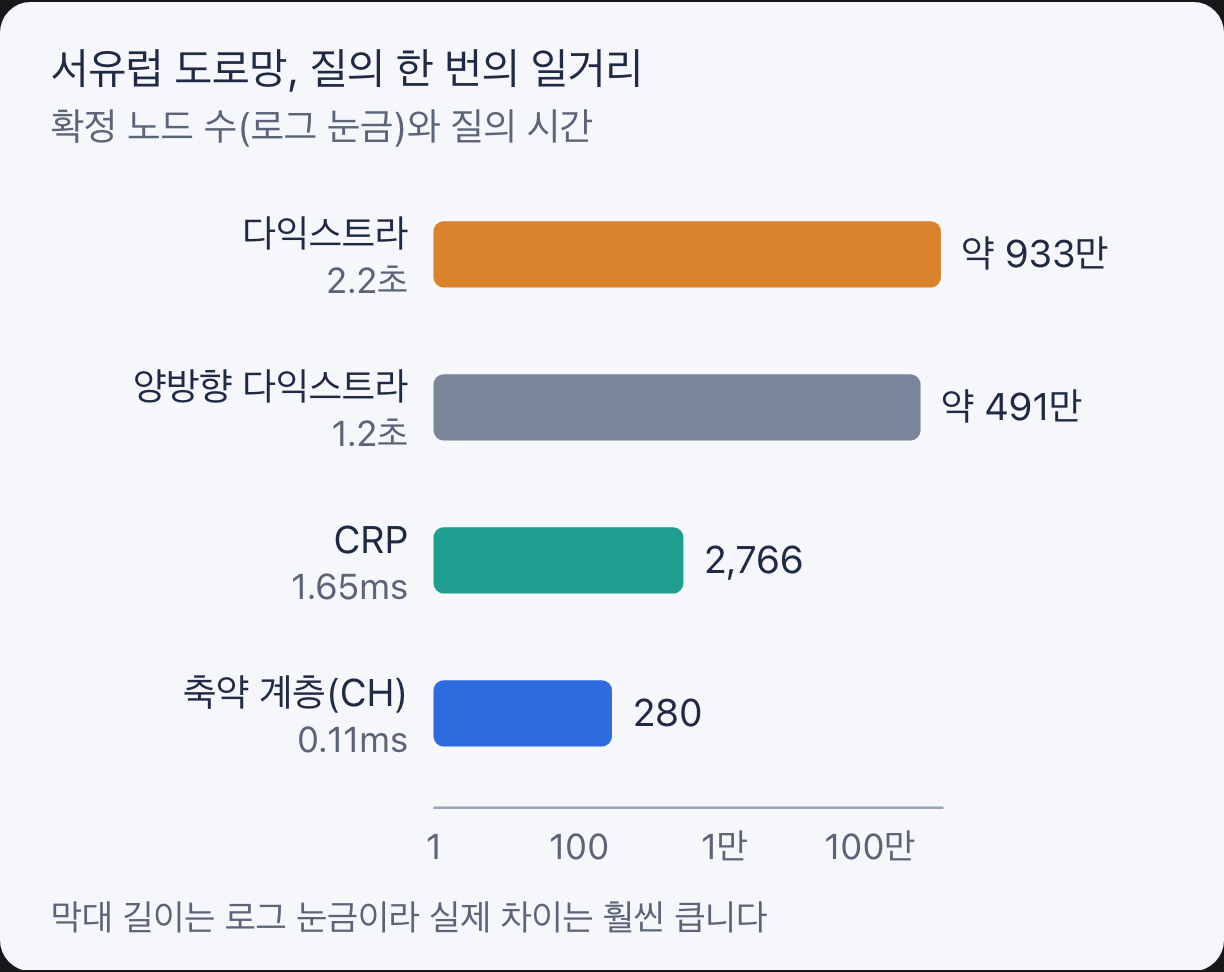
여기서 쇼츠의 "1ms"가 어디서 왔는지 짐작할 수 있습니다. 같은 표에서 1ms대 값은 CH가 아니라 CRP(1,650µs)입니다. CH는 110µs입니다. 참고로 2008년 원논문에서는 노드 순서를 공들여 정하는 변형(aggressive)이 더 오래된 AMD Opteron 270(2.0GHz) 단일 코어에서 368곳, 159µs를 기록했습니다(CH 원논문 PDF, KIT). 280곳과 110µs는 이후 개선된 구현의 값이라 두 숫자를 섞으면 안 됩니다.
표에는 CH보다 빠른 기법도 있습니다. 허브 라벨링(HL)은 0.56µs로 CH보다 약 200배 빠르지만 메모리를 18.8GiB 씁니다(CH는 0.4GiB). 모든 쌍의 답을 미리 표로 만들어 두면 0.06µs지만 120만 GiB가 넘게 필요합니다. 결국 경로 탐색 엔진 설계는 전처리 시간, 메모리, 질의 속도 사이에서 자리를 고르는 일이고, CH는 그 가운데 적은 메모리와 짧은 전처리(서베이 기준 5분)로 아주 빠른 질의를 얻는 균형점입니다.
실시간 교통이 들어오면 CH는 다시 지어야 합니다
CH의 약점은 지름길에 "지금의 소요 시간"이 박혀 있다는 점입니다. 교통 체증으로 도로 하나의 시간이 바뀌면 그 도로를 품은 지름길의 값이 틀어지고, 어떤 지름길이 필요한지도 달라질 수 있어 축약을 다시 해야 합니다. 오픈소스 라우팅 엔진 OSRM의 문서는 이 점을 직접 적습니다. CH는 교통 정보를 반영할 때마다 osrm-contract를 다시 돌려야 하는데, 큰 데이터셋에서는 의미 있는 갱신 주기를 내기에 너무 느리다는 것입니다. 그래서 실시간 업데이트가 필요하면 MLD라는 다른 파이프라인을 쓰라고 권합니다. MLD는 경로 계산이 CH보다 느리지만 교통 반영은 훨씬 빠르다는 설명입니다(OSRM wiki: Traffic).
이 문제를 푸는 길은 "구조"와 "숫자"를 떼어 내는 것입니다. 지도의 모양(어떤 도로가 어디를 잇는가)은 몇 주에 한 번 바뀌지만, 소요 시간은 몇 분마다 바뀝니다. 그러니 무거운 계산은 모양에만 하고, 가벼운 계산으로 숫자를 채우면 됩니다. 이 생각을 구현한 대표적인 기법이 두 가지입니다.
- CRP(Customizable Route Planning): 마이크로소프트 연구소의 Daniel Delling 등이 만든 기법으로, 지도를 여러 층의 구역으로 나눠 두고 새 가중치를 1초 안쪽에 반영해 실시간 교통을 지원합니다. 논문은 이것이 Bing Maps 라우팅 엔진의 핵심이라고 밝혔습니다(Customizable Route Planning in Road Networks, Microsoft Research, 2017). OSRM의 MLD(Multi-Level Dijkstra)도 지도를 구역으로 나눈 뒤(
osrm-partition) 가중치만 따로 반영하는(osrm-customize) 같은 발상입니다. - CCH(Customizable Contraction Hierarchies): KIT의 Julian Dibbelt, Ben Strasser, Dorothea Wagner가 CH를 이 방식으로 바꾼 기법입니다(Customizable Contraction Hierarchies, arXiv 1402.0402, 2014-02-03). 세 단계로 나뉩니다.
CCH의 세 단계는 다음과 같습니다.
- 가중치와 무관한 전처리: 지도를 균형 잡힌 두 조각으로 자르는 일을 반복하는 nested dissection으로 노드 순서를 정하고, 그 순서대로 축약해 지름길을 만듭니다. 이때 지름길에는 값을 넣지 않습니다. 소요 시간을 모르니 증인 경로를 따질 수도 없어서, 필요할 수 있는 지름길을 모두 만들어 둡니다.
- customization: 실제 소요 시간이 들어오면 순위가 낮은 노드부터 올라가며, 지름길 v→w의 값을 "v→u→w 가운데 가장 짧은 값"으로 채웁니다. 논문은 서유럽 도로망을 16스레드로 0.74초에 customize했습니다(단일 스레드 3.22초).
- 질의: CH와 똑같이 양쪽에서 위층으로만 올라갑니다.
대가는 질의 속도입니다. CCH 논문이 같은 유럽 그래프로 관련 연구를 비교한 표(Table 15)에서 CH 질의는 110µs, CCH는 413µs였고, 논문의 질의 실험(Table 13)에서 CCH 변형들은 107~161µs를 기록했습니다. 대신 가중치를 바꾸는 데 CH는 축약 전체(12스레드 109초)가 필요하고, CCH는 16스레드 기준 0.74초(단일 스레드 3.22초)면 됩니다. 쇼츠가 말한 "지름길 뼈대는 그대로 두고 도로마다 걸리는 시간만 바꿔 끼운다"는 정확히 CCH의 customization입니다. 순수한 CH로는 이렇게 할 수 없습니다.
티맵 Thor 엔진: A*에서 CCH로
티맵은 A* 기반 엔진을 CCH 기반의 Thor 엔진으로 바꾸면서, 400km 이상 장거리 경로의 응답시간을 약 143분의 1로 줄였습니다. 티맵모빌리티는 2021년 12월 공식 브런치에 그 과정을 자세히 공개했습니다. CCH와 CRP를 모두 검토한 뒤, 나중에 시간에 따라 비용이 바뀌는 그래프(time-dependent graph)를 지원하기 쉽고 구현이 쉽다는 이유로 CCH를 골랐고, "번개처럼 빠른 경로탐색 엔진"이라는 뜻에서 Thor라는 이름을 붙였습니다. 노드 순서는 Inertial Flow로 전국 도로망을 균형 있게 나누고 최소 절단에 Dinic 알고리즘을 써서 정했습니다(티맵모빌리티 브런치, 2021-12-21).
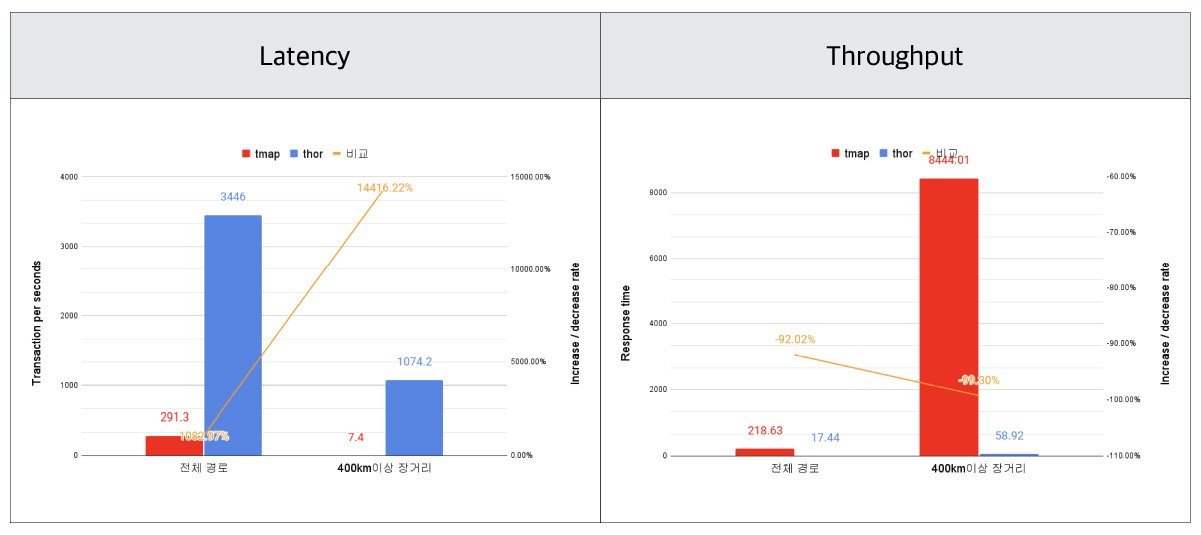
차트의 숫자를 나눠 보면 "100배"의 범위가 분명해집니다.
| 구간 | 응답시간(기존 → Thor) | 배수 | 초당 처리 건수(기존 → Thor) | 배수 |
|---|---|---|---|---|
| 전체 경로 | 218.63 → 17.44 | 약 12.5배 | 291.3 → 3,446 | 약 11.8배 |
| 400km 이상 장거리 | 8,444.01 → 58.92 | 약 143배 | 7.4 → 1,074.2 | 약 145배 |
배수는 필자가 차트 값으로 계산했습니다. 티맵모빌리티도 본문에 "400km 이상 장거리 구간에서는 거의 100배이상"이라고 적었고, 2024년 지디넷 기사도 "장거리 경로의 경우 응답시간이 100배 이상 빨라진다"고 썼습니다. 그러니 "티맵 길찾기가 100배 빨라졌다"는 장거리에 한정하면 맞고, 평균으로 말하면 열 배 남짓입니다. 차트에 응답시간 단위가 없어서 이 값을 밀리초라고 단정하지는 않았습니다.
도입은 한 번에 이뤄지지 않았습니다. 공개 자료를 시간순으로 놓으면 다음과 같습니다.
- 2021년 12월: Thor를 티맵 내비게이션에 바로 넣지 않고, 빠른 성능이 필요한 고객을 대상으로 티맵 Open API부터 적용했습니다. 이때 전처리는 "보통 2주에 한 번", customization은 "보통 5분에 한 번"이라고 적었습니다(브런치 3편).
- 2022년 5월: Thor의 customizer가 "1분, 5분 단위로 변경된 맵 데이터"를 최적화한다고 설명했습니다(AWS Graviton2 출시 후 바로 도입해본 후기, 티맵모빌리티, 2022-05-25).
- 2023년 1월: 출발 시각을 미래로 정하는 길찾기를 Thor로 전환했습니다. CPU 사용률 90% 이상에서도 평균 응답속도 50ms, 400km 이상 장거리도 평균 300ms 이하였고, 같은 해 실시간 내비게이션 경로안내로 넓힐 준비를 한다고 밝혔습니다(브런치 17편, 2023-01-06).
- 2024년 2월: 김재순 그룹장이 지디넷 인터뷰에서 서울역에서 부산역까지 A*로는 3~6초가 걸렸다고 설명하고, 커스터마이제이션으로 실시간 교통정보와 유고정보를 반영해 "1분마다" 최단경로를 최신화하며 전처리는 "보통 1~2주에 한 번" 한다고 말했습니다. 인프라 비용은 이전의 5분의 1로 줄었다고 했습니다(지디넷코리아, 2024-02-01).
지금도 티맵모빌리티의 데이터 상품 페이지는 길안내를 "실시간 교통정보와 CCH 알고리즘 기반"이라고 소개합니다(티맵모빌리티 길안내, 2026-10-09 확인). 쇼츠의 "1분마다"는 2024년 인터뷰의 표현이고, 2021년에는 5분이었습니다. 주기가 짧아진 것인지, 데이터 종류에 따라 주기가 다른 것인지는 공개 자료만으로는 알 수 없습니다.
티맵 사례에서 눈여겨볼 점은 속도만이 아닙니다. 티맵모빌리티는 택시 배차(승객 주변 n대의 택시)와 택배 경유지 사이 경로처럼 출발지 n곳과 도착지 m곳을 한꺼번에 계산하는 요구가 있었지만, 목적지 방향으로 탐색하는 A*로는 이런 n×m 경로를 구할 수 없었다고 적었습니다. 지디넷 기사에서 김재순 그룹장은 Thor의 특장점으로 n개 출발지와 m개 도착지의 경로값을 한 번에 내주는 매트릭스 API를 꼽았고, 기사는 오픈 API로 택배업체의 화물 단가 계산 등에도 활용할 수 있으며 티맵 대리운전 서비스에도 점차 적용될 예정이라고 전했습니다(지디넷코리아, 2024-02-01). 알고리즘을 바꾼 효과가 더 빠른 길찾기에서 새로 내놓을 수 있는 API로 이어진 셈입니다.
국내 경로 탐색 엔진 가운데 이렇게 내부를 자세히 공개한 곳은 드뭅니다. 카카오모빌리티는 운전자 반응으로 도로 비용을 학습하는 연구를 공개했지만(운전자 반응 기반 AI 경로 안내 기술, SCI 저널 등재, 카카오, 2025-07-14) 탐색 알고리즘 이름은 밝히지 않았고, 네이버 지도의 경로 탐색 알고리즘을 설명한 공식 자료는 찾지 못했습니다.
내 서비스에 길찾기를 넣는다면
경로 탐색을 직접 구현할 일은 드뭅니다. 오픈소스 엔진에서 CH 모드와 customizable 모드 가운데 무엇을 고를지가 실제 결정입니다. 기준은 하나입니다. 가중치가 얼마나 자주 바뀌는가입니다.
- 가중치가 거의 안 바뀐다면 CH: 도보, 자전거, 고정 속도 기반 차량 경로처럼 가중치가 지도 갱신 때만 바뀌면 CH가 가장 빠르고 메모리도 적게 씁니다. GraphHopper는 CH를 "speed mode"로 부르고, 요청마다 가중치 규칙을 바꾸는 custom model은 flex나 hybrid 모드에서만 허용합니다(GraphHopper profiles.md).
- 실시간 교통을 넣는다면 customizable 계열: OSRM에서는 MLD를 쓰고 교통 속도가 바뀔 때마다
osrm-customize만 다시 돌립니다. CCH는 OSRM에 들어 있지 않습니다. OSRM의 CCH 파이프라인 이슈는 2023년 3월부터 열려 있습니다(OSRM issue #6574).
OSRM 문서에 나온 두 파이프라인을 나란히 놓으면 차이가 보입니다. 파일 이름은 예시입니다.
# CH: 질의가 가장 빠르지만, 교통 속도를 바꾸면 축약 전체를 다시 돌린다
osrm-extract data.osm.pbf -p profile.lua
osrm-contract data.osrm --segment-speed-file updates.csv
osrm-routed --algorithm ch data.osrm

# MLD: 구역 나누기는 한 번, 교통 속도가 바뀌면 customize만 다시 돌린다
osrm-extract data.osm.pbf -p profile.lua
osrm-partition data.osrm
osrm-customize data.osrm --segment-speed-file updates.csv
osrm-routed --algorithm mld data.osrm
updates.csv는 서로 이어진 OSM 노드 ID 두 개와 속도(km/h)를 한 줄에 적는 형식이고, 방향마다 따로 적어야 합니다(OSRM wiki: Traffic). 국내에서도 긱뉴스에 소개된 경유지 추천 서비스 「가다가」가 OSRM으로 경로를 계산하고 도로 정체 정보를 OSRM의 링크에 매핑했다고 밝혔습니다(Show GN: 가다가, 긱뉴스). 티맵처럼 직접 엔진을 만드는 경우가 아니라면, 이 정도 조합으로 시작해 교통 반영 주기와 질의 지연을 재 보는 편이 현실적입니다.
이 글의 한계와 주의할 점
벤치마크 숫자는 조건이 다른 실험에서 왔으므로 서로 직접 비교하면 안 됩니다. 서베이의 CH 110µs와 CRP 1.65ms는 같은 서버 단일 코어에서 잰 질의 값이지만, CRP의 가중치 반영 약 0.37초는 12코어, CCH의 0.74초는 16스레드 값입니다. 티맵 차트는 기존 엔진과 Thor를 같은 장비에서 비교한 것이지만 단위와 하드웨어가 공개되지 않았습니다. 티맵이 실시간 내비게이션 경로의 응답시간을 밀리초로 공개한 자료는 찾지 못했고, 공개된 50ms와 300ms는 미래시간 길찾기의 값입니다.
필자의 실험은 격자 1만~4만 교차로 규모라 실제 도로망과 다르고, stall-on-demand 같은 실전 최적화를 넣지 않았습니다. 확정 노드 수의 경향을 보여 주는 용도이며 실행 시간은 재지 않았습니다. 또 이 글은 "가장 빠른 길"만 다룹니다. 실제 내비게이션은 회전 비용, 통행료, 운전자가 실제로 따르는 경로 같은 요소를 함께 다루고, 카카오모빌리티의 연구처럼 비용 자체를 어떻게 매기느냐가 탐색 속도만큼 중요합니다.
이 글의 자료를 고른 방법
쇼츠의 주장 아홉 개를 먼저 뽑아 첫 절의 표에 올리고, 주장마다 원출처를 찾았습니다. 유럽 도로망 숫자는 Bast 외 서베이(arXiv 1504.05140)의 Table 1을 HTML판으로 열어 행 값을 두 번 대조했고, CH 원논문, CCH 논문, CRP 논문, DIMACS 챌린지 데이터 페이지도 원문으로 확인했습니다. 티맵 숫자는 티맵모빌리티 공식 브런치 3편, 11편, 17편과 지디넷코리아 기사의 본문을 직접 내려받아 문장을 대조했고, 성능 차트는 이미지에서 값을 읽었습니다. 국내 개인 블로그는 사례와 반응을 보는 데만 썼고 숫자의 근거로 쓰지 않았습니다. 최근 30일의 Hacker News, GitHub, OSM 포럼 글도 살폈지만 CH를 깊이 다룬 토론 스레드는 없었고 CH 엔진을 새로 만들려는 GitHub 이슈 정도가 있었습니다. 같은 기간 OSRM, GraphHopper, Valhalla가 낸 새 버전도 성능 개선과 버그 수정 중심이었습니다.
자주 묻는 질문
티맵은 축약 계층(CH)을 쓰나요?
정확히는 CH를 확장한 CCH(Customizable Contraction Hierarchies)를 씁니다. 티맵모빌리티는 2021년 공식 블로그에서 A* 기반 엔진을 CCH 기반 Thor 엔진으로 바꾼 과정을 공개했고, 지금도 길안내 데이터 상품을 "실시간 교통정보와 CCH 알고리즘 기반"이라고 소개합니다. CCH는 지름길 구조를 먼저 만들고 실시간 교통으로 값만 다시 채울 수 있어서 교통이 자주 바뀌는 내비게이션에 맞습니다.
티맵 길찾기는 정말 100배 빨라졌나요?
400km 이상 장거리에 한해서입니다. 티맵모빌리티가 공개한 차트에서 장거리 응답시간은 8,444.01에서 58.92로 약 143배 줄었지만, 전체 경로 평균은 218.63에서 17.44로 약 12.5배 줄었습니다. 서울에서 부산 같은 먼 길일수록 효과가 크고, 가까운 길은 원래도 빨랐기 때문에 배수가 작습니다.
축약 계층은 정확한 최단 경로를 주나요?
네. CH는 근사 알고리즘이 아니라 다익스트라와 같은 최단 거리를 줍니다. 지름길은 원래 경로의 길이를 그대로 담은 요약이고, 어떤 최단 경로든 오르막과 내리막으로 표현할 수 있도록 지름길을 깔기 때문입니다. 필자의 실험에서도 무작위 200쌍 모두에서 다익스트라와 CH의 거리가 같았습니다.
CH와 A*는 무엇이 다른가요?
A*는 질의할 때 목적지까지의 추정 거리로 탐색 방향을 잡는 기법이고, 전처리가 없습니다. CH는 질의 전에 지름길을 깔아 두는 전처리 기법입니다. A*는 그래프가 커질수록 느려지고 여러 출발지와 도착지를 한 번에 계산하기 어렵지만, CH 계열은 질의 범위가 아주 작고 n×m 경로 계산에도 쓸 수 있습니다. 대신 전처리 시간과 지름길을 담을 메모리가 듭니다.
마치며
티맵 길찾기가 빨라진 비결을 한 줄로 줄이면 "계산을 질문 전에 옮겼다"입니다. 다익스트라는 질문이 올 때마다 전국에 물결을 일으키고, CH는 그 일거리를 전처리로 옮겨 질문 하나에 수백 곳만 봅니다. 그리고 CCH는 그 전처리를 다시 둘로 쪼개, 몇 주에 한 번 바뀌는 지도 모양과 몇 분마다 바뀌는 교통을 따로 계산합니다. 쇼츠는 이 이야기를 정확하게 압축했고, 틀린 곳은 CH를 실제보다 느리게 말한 "1ms" 하나와 "100배"가 장거리 숫자라는 단서가 빠진 것 정도였습니다.
직접 해 보고 싶다면 위 코드에서 N만 바꿔 돌려 보면 됩니다. 도로망을 키울수록 다익스트라의 숫자는 빠르게 불어나고 CH의 숫자는 거의 그대로인 것을 볼 수 있습니다.
출처
- 네비게이션이 미친속도로 길을 찾아내는 비밀: youtube.com/shorts/huKrw8Z6_5Y
- Route Planning in Transportation Networks, Bast 외, Table 1, 2015-04-20: arxiv.org/abs/1504.05140
- 네비 개발자여, 번개처럼 빠른 경로탐색엔진을 만들라, 티맵모빌리티, 2021-12-21: brunch.co.kr/@tmapmobility/3
- 티맵 길찾기 더 빨라진다…"토르 알고리즘 적용", 2024-02-01: zdnet.co.kr/view/?no=20240201160036
- A Note on Two Problems in Connexion with Graphs, Numerische Mathematik: doi.org/10.1007/BF01386390
- Contraction Hierarchies: Faster and Simpler Hierarchical Routing in Road Networks, WEA 2008: doi.org/10.1007/978-3-540-68552-4_24
- Search space of CH, WhereAreMyPointersAt, Wikimedia Commons: commons.wikimedia.org/wiki/File:Search_space_of_CH.svg
- 티맵, 3시간 뒤 출발하면 얼마나 걸려?, 티맵모빌리티, 2023-01-06: brunch.co.kr/@tmapmobility/20
- CH 원논문 PDF, KIT: ae.iti.kit.edu/1536.php
- OSRM wiki: Traffic: github.com/Project-OSRM/osrm-backend/wiki/Traffic
- Customizable Route Planning in Road Networks, Microsoft Research: microsoft.com/en-us/research/publication/customizable-route-planning-in…
- Customizable Contraction Hierarchies, arXiv 1402.0402, 2014-02-03: arxiv.org/abs/1402.0402
- AWS Graviton2 출시 후 바로 도입해본 후기, 티맵모빌리티, 2022-05-25: brunch.co.kr/@tmapmobility/14
- 티맵모빌리티 길안내: tmapmobility.com/support/data/path/about
- 운전자 반응 기반 AI 경로 안내 기술, SCI 저널 등재, 카카오, 2025-07-14: kakaocorp.com/page/detail/11762
- GraphHopper profiles.md: github.com/graphhopper/graphhopper/blob/master/docs/core/profiles.md
- OSRM issue #6574: github.com/Project-OSRM/osrm-backend/issues/6574
- Show GN: 가다가, 긱뉴스: news.hada.io/topic?id=31688
글쓴이
주홍철은 네이버 출신 개발자이자 AI 핀테크 스타트업 어비스(AVISS)의 대표입니다. 경제·증시 분석 AI, AI 에이전트, 데이터 파이프라인을 직접 설계하고 개발하며, 『면접을 위한 CS 전공지식 노트』와 『클로드 코드 제대로 시작하기』(길벗)를 썼습니다. 회사 소개는 어비스 홈페이지에, 다른 글은 어비스 블로그에 있으며, 글에 대한 정정 요청이나 문의는 [email protected]으로 보내 주세요.