같은 프롬프트에 "6시간을 쓰라"는 지시를 받고도 GPT-6 Astra는 53분, Claude Opus 5.5는 1시간 25분 만에 멈췄습니다. 두 모델을 가른 것은 시간이 아니라 일을 나누고 확인하는 방식이었습니다. 2026년 10월 7일 Quesma의 Piotr Migdał는 두 모델에 이탈로 칼비노의 소설 『보이지 않는 도시들』 속 도시 55개를 three.js로 시각화하라는 짧은 프롬프트 하나를 주고, 질문 없이 끝까지 혼자 일하게 했습니다. Astra는 약 10달러로 작동하는 아틀라스를 내놓았고, Opus 5.5는 서브에이전트 6개를 병렬로 돌려 약 74달러를 쓰고 저자에게서 "I'm mesmerized!"라는 반응을 끌어냈습니다. 이 글은 승패 판정을 그대로 옮기지 않습니다. 두 결과물의 공개 저장소를 직접 내려받아 세어 보고, Anthropic과 OpenAI가 장시간 작업에 대해 공식적으로 한 말과 맞대 봅니다.
필자는 AI 핀테크 스타트업 어비스(AVISS)의 대표로, Claude Code와 Codex에 긴 작업을 맡기며 서비스를 개발합니다. 이 글의 자료 조사도 Claude Code로 했습니다. 두 저장소의 줄 수와 테스트 개수는 필자가 직접 센 값이고, 모델을 다시 돌려 재현하지는 않았습니다. Opus 5.5의 기본 사용법은 Claude Opus 5.5 잘 쓰는 법 10가지에 따로 정리해 두었습니다.
핵심 요약
- 둘 다 6시간을 쓰지 않았습니다. Astra는 53분(medium effort), Opus 5.5는 1시간 25분 만에 끝냈습니다. Opus는 "6시간의 대략 절반을 썼다"고 보고했지만 벽시계로는 4분의 1이 안 됐고, 저자는 서브에이전트 6개의 시간을 합치면 약 7 에이전트시간이라고 봤습니다. Anthropic 공식 문서도 하네스로 시간 예산을 알려 주면 Opus 5.5가 "usually finishes well before it"이라고 적고 있습니다.
- 작업 방식이 달랐습니다. Opus는 도시 제작용 지침서(
city-brief.md)를 쓰고 도시 56개를 에이전트들에게 나눠 맡겼으며, 스크린샷으로 눈으로 확인하는 검증을 의무로 걸었습니다. Astra는 Playwright 테스트 9개를 만들었고, 그중 한 파일은 책의 구조(11개 주제 x 5개 도시, 9개 장)를 검사합니다.- 결과물 규모와 비용은 약 4배, 7배 차이였습니다. 필자가 센 코드는 Opus 22,567줄, Astra 5,807줄이고, 비용은 74달러 대 10달러입니다. Anthropic은 Opus 5.5가 Astra를 "about a fifth of the cost per task"로 이긴다고 발표했지만, 범위를 모델이 정하는 이번 열린 과제에서는 그 비교가 들어맞지 않았습니다.
- 실패는 가까이서 보일 때 드러났습니다. Hacker News에서는 Opus의 도시에서 아무것도 잇지 않는 다리, Astra 쪽에서 구조물을 뚫고 나온 탑이 지적됐습니다. Opus 저장소에는 자동 테스트가 없습니다.
- 실행 1회, 평가자 1명입니다. 하네스(Codex와 Claude Code)와 effort가 다르고 작업 중간 이력도 남아 있지 않아서, "어느 모델이 낫다"는 결론은 낼 수 없습니다. 이 실험에서 가져갈 것은 장시간 무인 작업을 설계하는 방법입니다.
목차
- 어떤 실험이었나요?
- 두 결과물은 어떻게 달랐나요?
- 왜 둘 다 6시간을 쓰지 않았나요?
- 저장소에 남은 작업 방식: 분업과 자기 검증
- 74달러 대 10달러, 공식 발표와 왜 다를까요?
- 무엇이 깨졌나요: 실패 양상
- 국내에서는 어떻게 봤나요?
- 이 실험으로 말할 수 있는 것과 없는 것
- 장시간 무인 작업을 맡기기 전 체크리스트
- 자주 묻는 질문
- 마치며
- 출처
어떤 실험이었나요?
프롬프트는 한 문장짜리 과제와 두 가지 조건이 전부였습니다. 저자가 두 모델에 똑같이 준 프롬프트는 아래와 같습니다(I gave Opus 5.5 one prompt and six hours to visualize Invisible Cities, Quesma, 2026-10-07).
Make a three.js (pnpm) visualization of all Invisible Cities by Italo Calvino.
Don't ask questions, it is a one-shot task.
You have 6h of work, use it until it becomes a masterpiece.
『보이지 않는 도시들』은 마르코 폴로가 쿠빌라이 칸에게 55개의 상상 속 도시를 들려주는 소설입니다. 도시마다 감정이나 마음 상태가 건축과 사람들의 행동으로 드러나고, 책 전체가 11개 주제와 9개 장으로 짜인 정교한 구조를 갖고 있습니다. "모든 도시"를 다루라는 요구는 55개를 빠뜨리지 않아야 한다는 뜻이고, "걸작이 될 때까지"는 언제 멈출지를 모델이 스스로 정하라는 뜻입니다. 사람에게 맡겨도 기준이 모호한 과제입니다.
저자가 밝힌 실행 조건과 결과는 이렇습니다.
| 항목 | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|
| 하네스 | Codex | Claude Code |
| effort | medium | 원문에 없음 |
| 벽시계 시간 | 53분 | 1시간 25분 |
| 병렬 작업 | 원문에 언급 없음 | 서브에이전트 6개, 합계 약 7 에이전트시간(저자 추정) |
| API 토큰 비용 | 약 10달러 | 약 74달러 |
| 저자 평가 | "Some AI design slop" | "And I'm mesmerized!" |
저자는 데이터 시각화와 탐색형 설명(explorable explanation)을 만들어 온 사람입니다. 그는 원문 첫머리에 "GPT-6 Astra was a jump when it comes to puzzles. Claude Opus 5.5 is a jump when it comes to design."이라고 적었습니다. 실험의 계기는 Ryan Sael이 Opus 5.5로 1시간 26분, 25.66달러를 들여 만들었다는 카메라 렌즈 실험실이었습니다. 저자는 이것이 정말 한 번에 나오는 일관된 품질인지 확인하고 싶었다고 합니다. 결과물과 코드는 모두 공개되어 있습니다(Astra 데모, Astra 코드, Opus 데모, Opus 코드).
두 결과물은 어떻게 달랐나요?
Opus 5.5는 도시마다 공들인 3D 디오라마를 만들었고, Astra는 기능이 촘촘한 지도형 앱을 만들었습니다. 원문에 실린 두 스크린샷은 공교롭게 같은 도시 이시도라(Isidora)를 보여 줍니다.
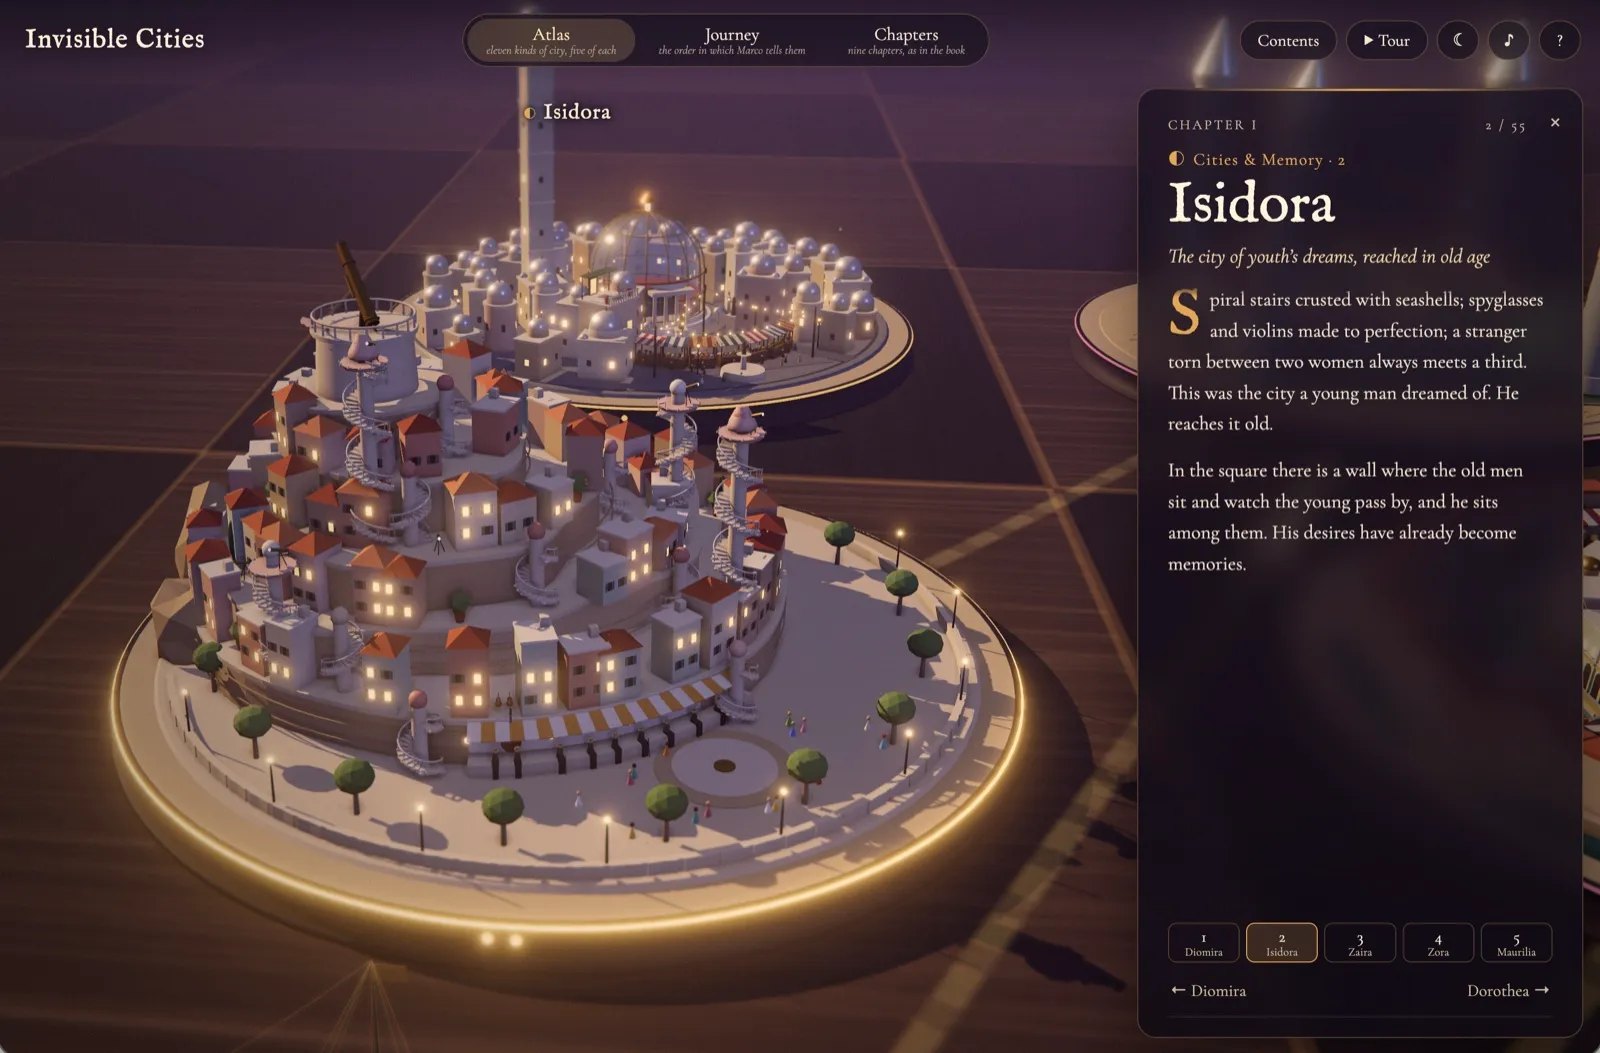
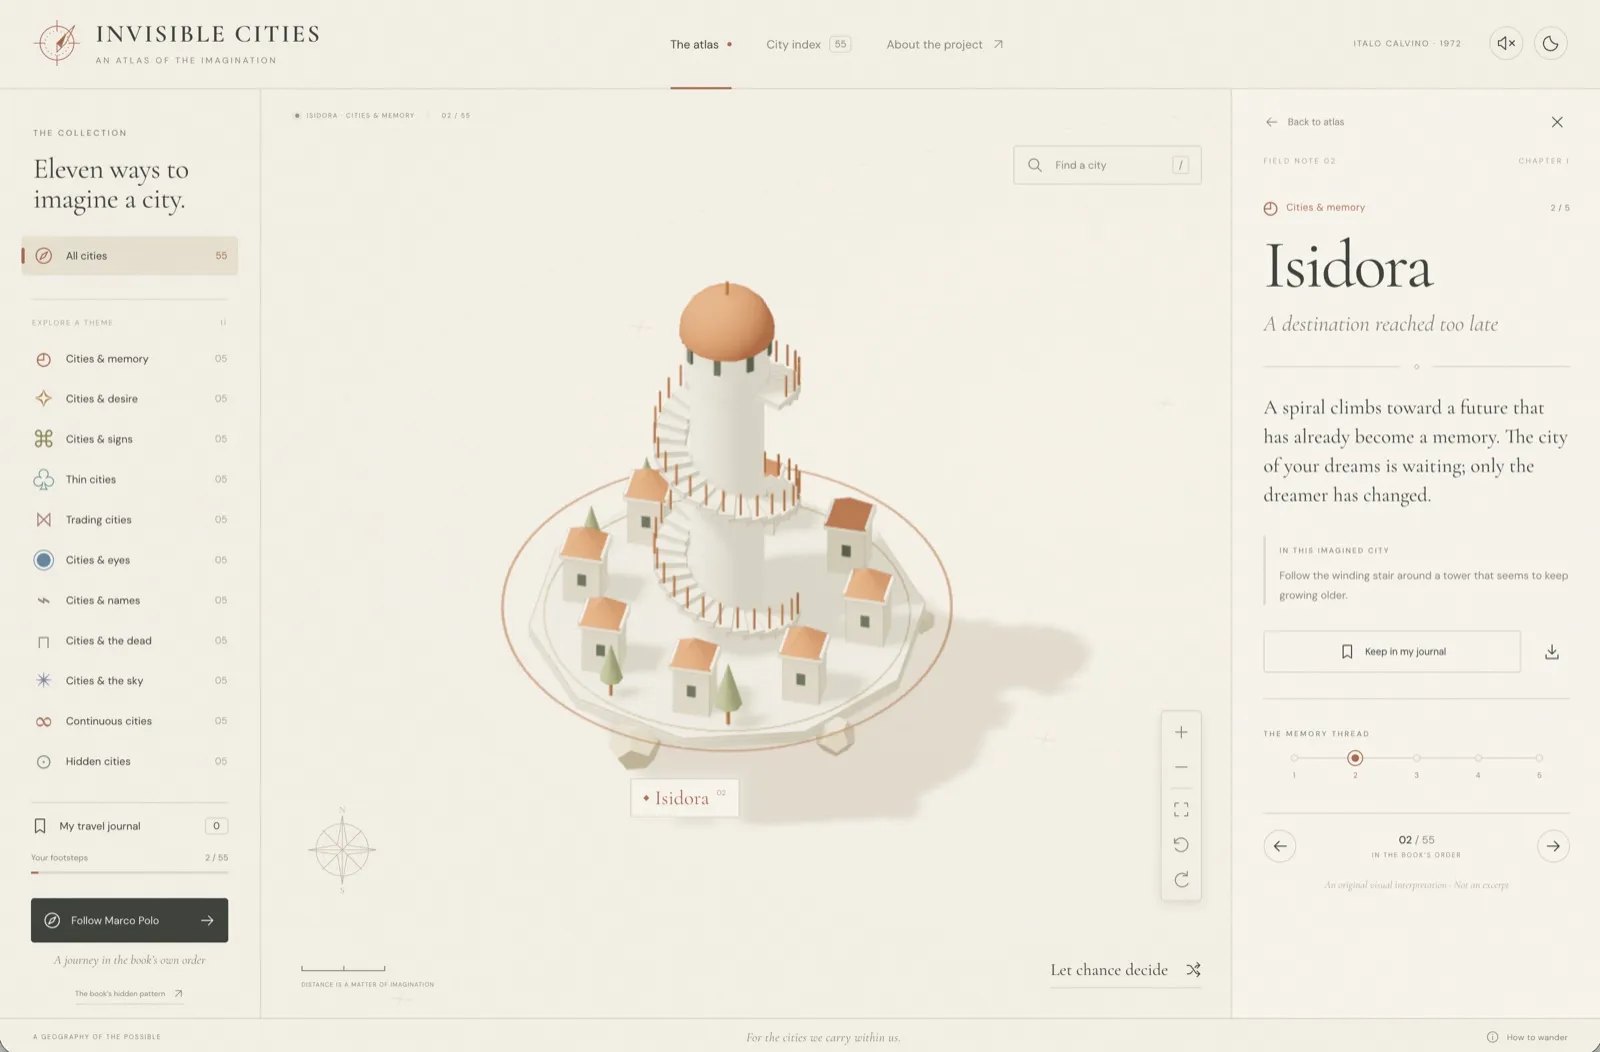
저자는 Astra 결과물을 두고 필요한지 확인하지 않은 개념과 설명이 많이 붙어 시각적 잡음이 됐다고 평했습니다. 접근성 문구로는 쓸 만하지만 화면에 그대로 보여 줄 것은 아닌 "Captain Obvious" 같은 문장도 있었다고 합니다. 그러면서도 "I wouldn't have expected earlier models to get anywhere near this."라고 덧붙였습니다. Opus 쪽에는 "it might (and should) have used all the time"이라는 아쉬움과 함께, 그래도 이 단계에서 이미 "wow!"였다는 반응을 남겼습니다.
저자는 Astra가 "Claude visualization style", 즉 베이지색 배경과 "05" 같은 번호 표기를 따라 한 것 같다고 적었습니다. Anthropic의 Opus 5.5 프롬프트 가이드에는 디자인 지시 없이 프런트엔드를 맡기면 Opus 5.5가 몇 가지 기본 스타일로 돌아간다는 설명이 있습니다. 그리고 피할 패턴의 예로 "cream or off-white background", "numbered '01/02/03' section labels"를 듭니다(Prompting Claude Opus 5.5, Anthropic). 정작 그 스타일을 쓴 쪽은 Astra였고, Opus는 어두운 체스판과 금빛 조명을 골랐습니다. 필자는 이것을 "디자인 지시가 없으면 최신 모델들이 비슷한 기본값으로 수렴한다"는 신호로 읽습니다. 한 번의 실행으로 단정할 수는 없습니다.
OpenAI는 Astra 발표에서 웹사이트와 게임을 만들 때 "stronger visual judgment"를 갖췄고, 결과물에 필요 없는 정보를 반복하지 않고 중요한 맥락만 담도록 훈련했다고 밝혔습니다(GPT-6 Astra: A new generation of intelligence, OpenAI, 2026-09-03). 이 실험에서 저자가 지적한 "불필요한 개념과 설명"은 이 설명과 어긋납니다. 다만 Astra는 medium effort로 돌았고 실행도 한 번뿐이라, 이것만으로 발표 내용을 반박할 수는 없습니다.
왜 둘 다 6시간을 쓰지 않았나요?
프롬프트 속 "6시간"은 강제가 아니라 참고였고, 두 모델 모두 스스로 끝낼 때를 정했습니다. 여기에 이 실험에서 가장 실무적인 교훈이 있습니다.
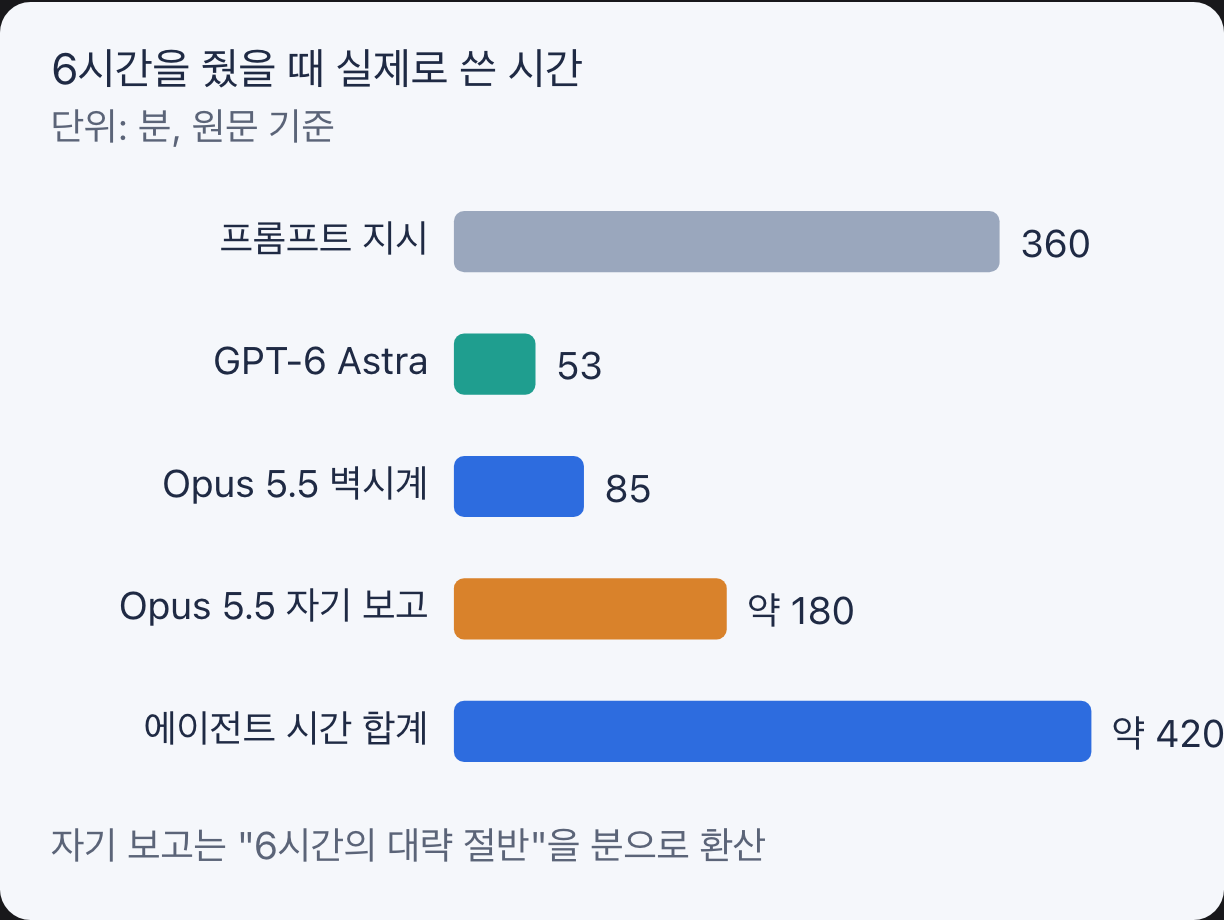
Opus 5.5는 작업을 마치며 "I used roughly half of the six hours. The remaining polish has diminishing returns, but I can do another round if you want."라고 말했습니다. 실제 경과는 1시간 25분이었습니다. 저자는 이것을 "agentic time dilation"이라고 너그럽게 해석했습니다. 서브에이전트 6개가 병렬로 일했으니 합치면 약 7 에이전트시간이라는 것입니다. 그런데 그 해석을 따르면 이번에는 6시간을 넘깁니다. 모델이 어떤 기준으로 "절반"을 셌는지는 원문만으로 알 수 없습니다. 적어도 이번 사례에서는 모델이 스스로 보고한 소요 시간과 실제 시간이 크게 달랐습니다.
이 행동은 Anthropic 문서가 설명하는 성향과 일치합니다. Opus 5.5 프롬프트 가이드의 "Time signals for multiagent harnesses" 절은 하네스가 메시지마다 elapsed 340s / 1200s 같은 경과 시간을 붙이라고 권합니다. 그러면서 모델이 "paces its work to finish inside the budget and usually finishes well before it"이라고 적었습니다. 이어서 "The budget is advisory and nothing stops the model at the limit"이라고 덧붙였고, 시간 압박을 받으면 모델이 "might search and verify a little less"라고도 썼습니다(Prompting Claude Opus 5.5, Anthropic). 이 실험의 프롬프트는 하네스의 시간 신호 없이 문장으로만 6시간을 줬습니다. 문서가 설명하는 조건(하네스의 시간 신호)과는 다르지만, 시간 예산을 다 쓰지 않는다는 방향은 같습니다.
같은 문서의 "Unattended agentic runs" 절도 볼 만합니다. Opus 5.5는 긴 작업 중에 진행 상황을 보고하는데, 그 보고가 도구 호출 없이 턴을 끝내면 무인 루프는 거기서 멈춥니다. 문서는 텍스트로만 끝난 턴을 "a report rather than as proof the task is done"으로 다루라고 합니다. "원하면 한 라운드 더 할 수 있다"는 Opus의 마지막 말이 바로 이 유형입니다. 문서는 무인 실행에서 피하고 싶은 종료 방식의 예로 "an offer to carry on with something unless the user would prefer otherwise"를 들고, 이를 막는 시스템 프롬프트 예시를 함께 싣고 있습니다.
Astra는 문서와 조금 다른 쪽으로 어긋났습니다. OpenAI의 모델 가이드는 Astra에게 "persist until the user's intended goal is complete"라고 적고, 지속적인 작업이 필요하면 끝까지 하라고 안내합니다(Model guidance: gpt-6-astra, OpenAI). 그런데 "걸작"이라는 목표는 완료 조건이 없습니다. Astra는 55개 도시와 테스트가 통과한 시점을 완료로 판단한 것으로 보입니다. Codex 사용자 커뮤니티에는 반대 방향의 보고도 있습니다. /goal로 48시간을 돌렸는데 쓸모 있는 일을 별로 하지 않았다는 글이고, 댓글에는 "It just looks busy for hours"라는 말도 나왔습니다(r/codex, 2026-09-09). 일찍 끝나는 것도, 오래 돌며 바쁜 척하는 것도 모두 "언제 끝났는가"를 모델 판단에 맡긴 결과입니다.
Hacker News에서 "어떻게 6시간을 쓰게 하느냐"는 질문에 달린 답은 실무적이었습니다. "/goal spend at least 6 hours doing … works"라며, 감독 에이전트가 6시간이 될 때까지 세션을 루프로 붙잡아 두면 결국 남은 시간을 쓰게 된다는 것입니다(aetherspawn, Hacker News, 2026-10-08). 시간을 쓰게 만드는 장치는 프롬프트 문장이 아니라 하네스에 있어야 합니다.
저장소에 남은 작업 방식: 분업과 자기 검증
두 저장소를 열어 보면 Opus는 "나눠 맡기고 눈으로 확인"했고, Astra는 "한 덩어리로 만들고 테스트로 확인"했습니다. 아래 표는 필자가 2026년 10월 9일 두 저장소를 내려받아 센 값입니다. 줄 수는 git ls-files 기준으로 TS, JS, CSS, HTML, 셸 파일을 셌고, 잠금 파일은 뺐습니다.
| 항목 | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|
| 코드 줄 수 | 5,807줄 (CSS 2,649줄 포함) | 22,567줄 |
| 도시 구현 | models.ts 한 파일(830줄)에 55개 모티프 |
도시별 파일 56개(Venice 추가), 합계 19,115줄 |
| 자동 테스트 | Playwright 파일 3개, 테스트 9개 | 없음 |
| 검증 도구 | 검토용 스크린샷 스크립트(scripts/inspect.mjs), 도시 초상 55장 사전 렌더 |
도시별 스크린샷 스크립트, 전체 병렬 렌더, FPS 측정 |
| 작업 지침 문서 | 없음 | docs/city-brief.md |
| 커밋 이력 | 2개(결과 1, 배포 1) | 2개(결과 1, 배포 1) |
Opus 5.5: 지침서를 쓰고 도시를 나눠 맡겼습니다
Opus 저장소의 docs/city-brief.md는 "Brief for city builders"라는 제목의 서브에이전트용 지침서입니다(city-brief.md, invisible-cities-opus-5.5). 내용은 사람 팀장이 외주 개발자에게 주는 문서와 거의 같습니다. 개발 서버는 이미 돌고 있으니 새로 띄우지 말 것, 자기 도시 파일만 고치고 공용 파일(kit.js, main.js)은 건드리지 말 것을 정해 둡니다. 공용 키트에 버그가 있으면 자기 파일에서 우회하고 보고하라고 합니다. 예산도 숫자로 박았습니다. 도시 하나에 삼각형 약 15만 개, draw call 약 40개까지이고, 결정적 결과를 위해 Math.random 대신 시드 난수를 쓰게 했습니다.
가장 눈에 띄는 것은 "Verify (mandatory)" 절입니다. 각 에이전트는 headless Chrome으로 자기 도시를 앞, 옆, 가까이에서 찍고(scripts/shot.mjs), 스크린샷을 직접 읽어 보고, 콘솔 오류를 모두 고쳐야 합니다. 마지막에는 도시마다 한두 문장으로 아이디어와 불확실한 점을 보고하게 했습니다. Anthropic이 Opus 5.5 발표에서 "delegates to subagents far more effectively and checks its own work in creative ways"라고 한 것(Introducing Claude Opus 5.5, Anthropic, 2026-09-22)이 저장소에 그대로 남아 있는 셈입니다.
분업의 흔적도 남아 있습니다. 도시 파일 폴더에는 _agentA_util, _ab_util, _c_util, _d_kit, _e_util처럼 접두사가 다른 도우미 파일 다섯 개가 있습니다. 각각 3개, 10개, 10개, 10개, 6개 도시가 이 파일을 가져다 씁니다. 지침서가 "private helpers named src/cities/_<yourprefix>_*.js"를 허용했으니, 에이전트마다 대략 10개 도시씩 맡았다고 읽는 것이 자연스럽습니다. 다만 어떤 에이전트가 정확히 무엇을 맡았는지는 커밋 이력이 하나로 합쳐져 있어 확정할 수 없습니다.
빠진 것도 있습니다. Opus 저장소에는 자동 테스트가 하나도 없습니다. FPS 측정 스크립트는 있었지만, 검증의 중심은 "스크린샷을 보고 괜찮은지 판단"하는 방식이었습니다. 이 방식은 아름다움을 확인하는 데는 강하지만, 다리가 강 양쪽을 잇는지 같은 규칙을 기계적으로 확인하지는 못합니다.
GPT-6 Astra: 공용 부품으로 조립하고 책의 구조를 테스트했습니다
Astra 저장소는 정반대입니다. 도시 55개를 한 파일의 공용 부품으로 조립했고, 대신 테스트를 촘촘히 썼습니다. 그중 tests/data.spec.ts는 이 실험에서 가장 인상적인 코드입니다. 이 테스트는 시각화가 아니라 원작의 구조를 검사합니다(data.spec.ts, invisible-cities-astra). 핵심을 줄이면 아래와 같습니다.
// 원본 테스트의 검사 내용을 재구성한 것: 책의 조합 구조를 검사한다
expect(cities).toHaveLength(55);
// 11개 주제마다 1~5번 도시가 하나씩
expect(cities.filter((c) => c.theme === theme).map((c) => c.rank).sort())
  .toEqual([1, 2, 3, 4, 5]);
// 9개 장의 도시 수
expect(Array.from({ length: 9 }, (_, i) => cities.filter((c) => c.chapter === i + 1).length))
  .toEqual([10, 5, 5, 5, 5, 5, 5, 5, 10]);
// 한가운데(28번째) 도시는 Baucis
expect(cities[27].name).toBe('Baucis');
나머지 테스트는 브라우저에서 55개 모델이 모두 렌더되는지, 검색과 빈 결과 화면, 즐겨찾기 저장, 야간 모드, 엽서 내려받기, WebGL이 없을 때의 대체 화면까지 확인합니다. 저장소의 artifacts/ 폴더에는 Astra가 검사용으로 찍은 스크린샷 4장도 커밋되어 있습니다.
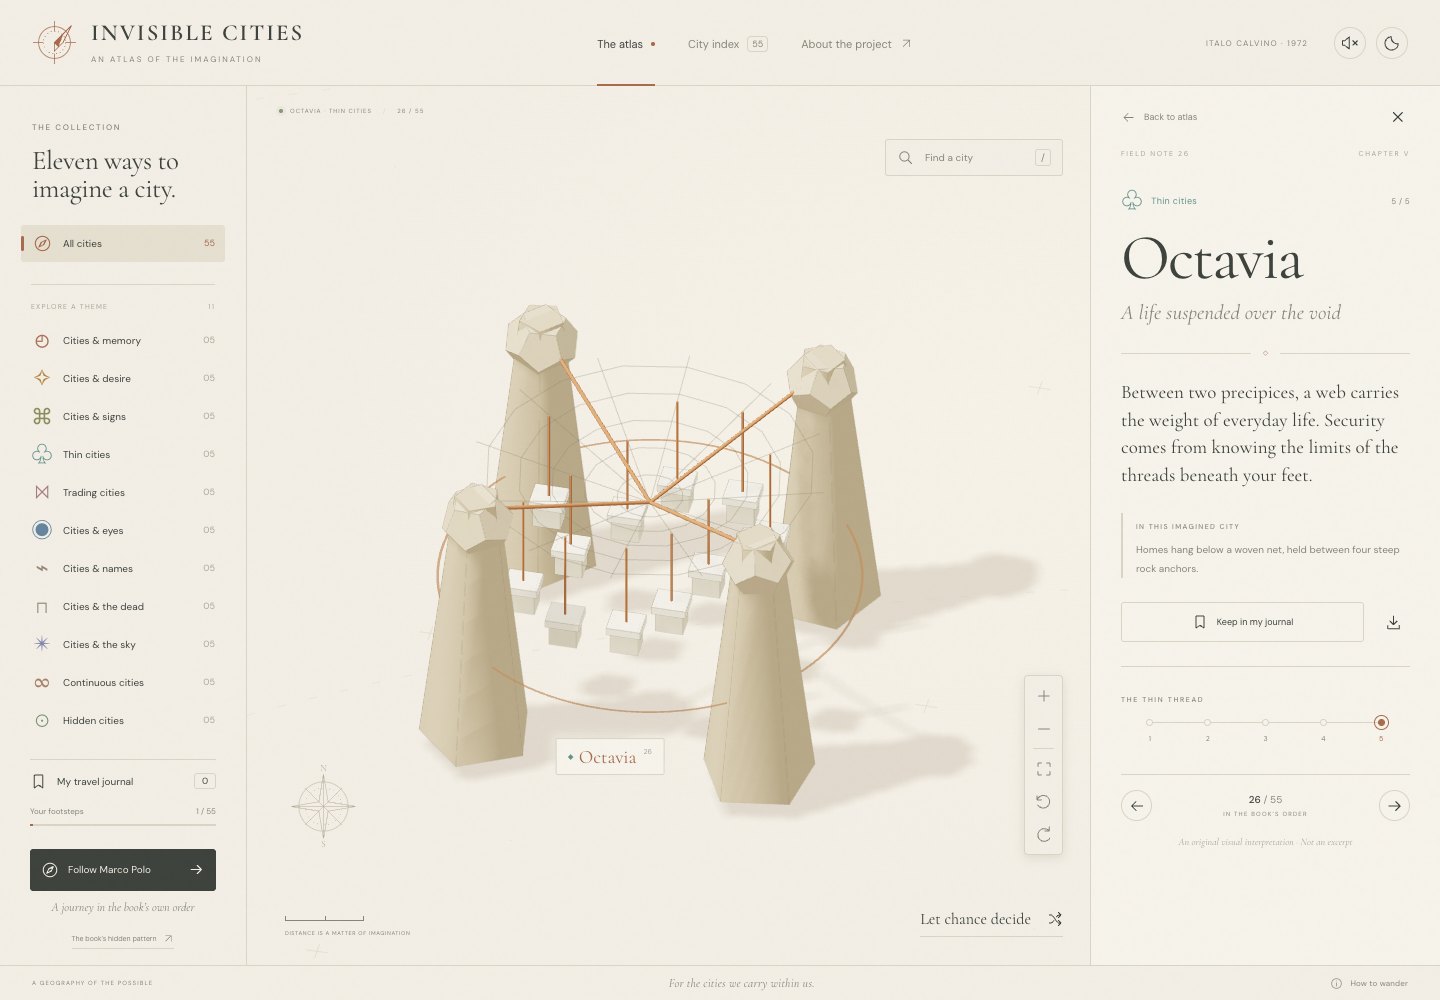
artifacts/ 폴더에 남긴 검사용 스크린샷(옥타비아). 결과물만이 아니라 "확인했다"는 증거를 파일로 남긴 셈입니다. 출처: stared/invisible-cities-astra, GitHubOpenAI는 Astra 발표에서 웹사이트를 만들고 "run frontend QA checks to make sure all the features on that site work"를 할 수 있다고 소개했습니다(OpenAI, 2026-09-03). 이 저장소가 바로 그 모습입니다. 주요 기능이 동작하는지는 테스트로 확인했지만, 그 기능이 화면에 꼭 필요한지는 검사 대상이 아니었습니다. 저자의 "visual noise" 평가가 겨냥한 지점이 여기입니다.
두 방식을 겹쳐 보면 검사의 무게중심이 달랐습니다. Opus는 각 도시가 보기 좋은지를 스크린샷으로 확인했지만, 물리 규칙을 자동으로 검사하는 장치는 두지 않았습니다. Astra는 기능과 책의 구조를 테스트로 확인하고 스크린샷도 남겼지만, 화면 요소가 꼭 필요한지는 검사 대상이 아니었습니다. 이번 결과물의 장단점은 상당 부분 이 검사 범위와 겹칩니다. 중간 산출물로 보면 Opus는 지침서와 검증 스크립트를, Astra는 테스트와 검사용 스크린샷을 저장소에 남겼습니다. 둘 다 사람이 나중에 점검할 수 있는 흔적이라는 점은 같습니다.
74달러 대 10달러, 공식 발표와 왜 다를까요?
Anthropic은 Opus 5.5가 Astra보다 작업당 비용이 훨씬 싸다고 발표했지만, 이 실험에서는 Opus가 약 7.4배 비쌌습니다. 둘 다 틀린 말은 아닙니다. 재는 대상이 다릅니다.
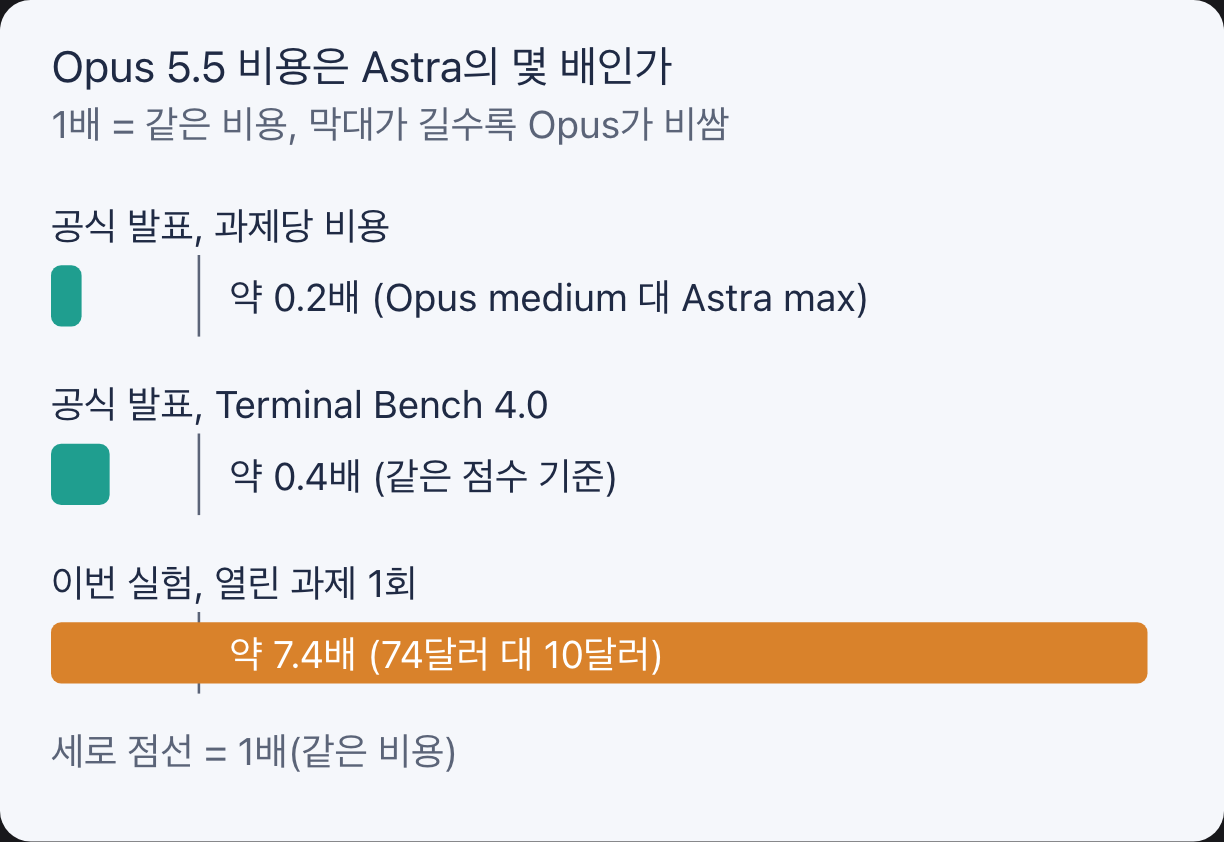
Anthropic은 발표에서 "At default effort (medium), Opus 5.5 beats GPT-6 Astra at max effort for about a fifth of the cost per task."라고 했습니다. Terminal Bench 4.0에서는 "matches Astra for about 40% of the cost"라고 밝혔습니다(Anthropic, 2026-09-22). 토큰 단가도 Opus 5.5가 입력 4달러, 출력 20달러로(Anthropic), Astra의 입력 10달러, 출력 50달러(OpenAI)보다 낮습니다. 단가가 40%인 모델이 7배 넘게 썼다면, 토큰을 대략 18배 더 썼다는 계산이 나옵니다. 캐시 비율과 입출력 구성이 달라 정확한 값은 아니고, 규모를 가늠하려고 필자가 어림한 것입니다.
차이의 이유는 과제의 성격에 있습니다. 벤치마크의 "과제당 비용"은 정답이 정해진 과제를 풀 때의 비용입니다. 반면 "걸작이 될 때까지"라는 과제는 범위를 모델이 정합니다. Opus 저장소의 README를 보면 도시마다 별도 파일로 디오라마를 만들어 대부분 움직이게 했고, 원작의 55개 목록에 없는 베네치아를 Journey 배치의 한가운데 세웠고, 세 가지 배치(Atlas, Journey, Chapters)와 투어 모드, 생성형 사운드, 블룸과 필름 그레인 같은 후처리를 붙였습니다(README, invisible-cities-opus-5.5). 그리고 이 일을 서브에이전트 6개에게 나눠 약 7 에이전트시간을 썼습니다. 코드량으로 보면 Opus는 Astra의 약 3.9배를 만들었습니다. 이번 사례에서 비용을 가른 것은 토큰 효율보다 모델이 스스로 잡은 범위였습니다.
비교 조건도 같지 않습니다. Astra는 medium으로 돌았고, Opus의 effort는 원문에 나오지 않습니다. 하네스도 Codex와 Claude Code로 달랐습니다. 서브에이전트를 몇 개, 어떤 모델로 띄우는지는 Claude Code의 설정과 모델 판단에 달려 있습니다. 커뮤니티에는 Opus 5.5가 "spawn 50 subagents on medium to finish something small"이라는 불만도 올라왔습니다(r/ClaudeCode, 2026-10-02). Hacker News에는 서브에이전트를 최대 20개로 제한했더니 40개를 만들었다는 개인 경험담도 있습니다(user43928, Hacker News). 이 실험과 무관한 일화지만, 서브에이전트 수가 비용을 크게 흔들 수 있다는 점은 짐작할 수 있습니다.
형식이 비슷한 비교가 하나 더 있습니다. 같은 Rust 과제를 각 모델에 max effort로 한 번씩 준 실험에서 Astra는 1시간 13분, 48.83달러였고, Opus 5.5는 2시간 45분, 61.42달러였습니다(r/codex, 2026-09-23). 여기서도 Opus가 더 오래 걸리고 비쌌습니다. 그 글에도 "run 10 each"라는 반론이 달렸습니다. 한 번의 실행으로 단가 비교의 결론을 뒤집을 수는 없습니다.
무엇이 깨졌나요: 실패 양상
두 결과물 모두 멀리서는 놀랍고 가까이서는 물리적으로 말이 안 되는 곳이 있었습니다. Hacker News 토론(2026-10-09 기준 393점, 댓글 193개)에서 가장 많이 나온 지적이 이것이었습니다(Hacker News, 2026-10-08).
- 다리가 아무것도 잇지 않습니다(Opus). 한 사용자는 처음 누른 도시의 첫 문장이 "Arriving, you rejoice at its bridges, each different"였다고 적었습니다. 그런데 모형에는 다리가 다섯 개쯤 있었고, 그중 세 개는 양안을 잇지 않고 강 한가운데 놓여 있었다고 합니다(SiempreViernes).
- 구조물이 서로 뚫고 지나갑니다(양쪽). Astra의 펜테실레아는 탑이 다른 구조물을 파고들고, Opus의 에우트로피아는 도시 하나가 강 위에 올라앉아 배가 지나갈 틈이 없다는 지적이 나왔습니다. 그 사용자의 결론은 "Slop has never been this beautiful before!"였습니다(Traubenfuchs).
- 디테일에 의도가 없습니다(Opus). 그래픽 경력 30년이라는 사용자는 라이사 지붕 위의 고양이와 테오도라 중앙의 책 한 권 한 권까지 찾아내며 감탄했습니다(aappleby). 반대편에서는 "who cares about those details if they're just random? ... What was the intention?"이라는 반문이 나왔습니다(matsemann).
- 모든 환경에서 돌지는 않습니다. 토론에는 일부 브라우저에서 아예 로드되지 않거나(urig, pama) 휴대전화에서 첫 화면을 넘기지 못했다는 보고가 여럿 있었습니다(alm4x). 저자가 Reddit에 올린 글에 달린 댓글 세 개 중 두 개도 인트로 화면에서 멈춘다는 내용이었습니다(r/ClaudeAI, 2026-10-07).
이 실패들은 앞 절의 검증 방식과 겹칩니다. 다리가 이어졌는지, 물체가 겹치는지는 "보기 좋은가"를 묻는 스크린샷 검사로는 잡히지 않습니다. Opus 저장소에는 성능 측정 스크립트가 있었지만 macOS의 headless Chrome에서 재는 것이었고, 다양한 브라우저와 휴대전화에서 확인한 흔적은 없습니다. 한 HN 사용자는 사람이 엉터리 다리를 만들지 않는 이유가 머릿속에 물리 엔진이 있기 때문이라고 했습니다. 그러니 물리가 들어간 엔진으로 바꾸고 도시마다 시험 비행을 시켜 불일치를 고치게 하라는 제안이었습니다(sixsevenrot). 필자도 같은 생각입니다. "다리의 양 끝은 땅에 닿아야 한다" 같은 규칙을 Astra처럼 테스트로 쓰게 했다면 이 실패의 상당수는 걸러졌을 것입니다.
원작을 대하는 방식도 두 저장소의 README에 정직하게 적혀 있습니다. Opus는 도시 설명과 대화가 이 아틀라스를 위해 다시 쓴 의역이라고 밝혔고, Astra도 책을 인용하지 않은 독자적인 해석이라고 적었습니다. 저작권 면에서는 조심스러운 선택이지만, Hacker News에서는 원작의 첫 문단과 AI가 요약한 문단을 나란히 놓으며 음악을 2배속으로 듣는 느낌이라는 반응도 나왔습니다(Jordan-117).
국내에서는 어떻게 봤나요?
국내에서 이 실험을 다룬 곳은 GeekNews 한 곳이었고, 거기에도 한국 사용자의 의견은 아직 없습니다. GeekNews는 2026년 10월 8일 이 글을 소개했습니다. 댓글은 Hacker News 의견을 번역해 모은 GN⁺ 댓글 하나뿐입니다(GeekNews). 필자가 네이버 블로그와 뉴스, 티스토리, 브런치, 클리앙, 요즘IT에서 찾아봤지만 이 실험을 언급한 글은 찾지 못했습니다(2026-10-09 기준).
대신 같은 현상을 겪은 국내 사용자의 체감은 여럿 있습니다. 이 글의 근거로 쓰기보다는 분위기를 보여 주는 사례로만 소개합니다.
- "억지로 추가하는 느낌": 클리앙의 한 사용자는 Opus 5.5에 SVG 그림을 맡겨 5시간, 1,400만 토큰(API 환산 410달러)을 썼습니다. 그리고 결과를 두고 "뭔가 억지로 추가하는 것 같은 느낌. 그래도 오래 작업하고 지시한 것을 끝까지 완성해낸다는 것에 의미"라고 적었습니다(클리앙, 2026-09-26). 저자가 Opus의 렌즈 실험실을 두고 "too rich"하고 미니멀리즘이 없다는 지적이 나올 수 있다고 인정한 대목과 같은 방향입니다.
- 구독 한도가 먼저 녹습니다: Codex에서 Astra를 medium으로 돌리자 ChatGPT Plus의 5시간 사용량이 5분 만에 끝났다는 글도 있습니다(클리앙, 2026-09-07). Fable 5.1이 서브에이전트 58개를 한꺼번에 띄워 20분 만에 한도를 채웠다는 글도 있습니다(클리앙, 2026-09-06). 구독으로 쓰는 사용자에게는 이 실험의 "74달러"가 구독 한도로 바뀌어 체감됩니다.
- 같은 구도의 국내 보도: AI타임스는 같은 프롬프트로 3D 장면 네 개를 만들게 한 해외 비교를 전했습니다. Opus 5.5가 추가 프롬프트 없이 오류를 스스로 고치며 디테일에서 앞섰지만 비용은 Opus 5.5 4.37달러, 비교 모델 0.34달러였다는 내용입니다. 비교 모델은 Astra가 아니라 GPT-6 Sol이고, 기사 제목에는 GPT-5.6으로 적혀 있습니다(AI타임스, 2026-09-23). 모델은 다르지만 "디테일의 Opus, 비용의 경쟁 모델"이라는 구도는 이번 실험과 같습니다.
OpenAI 쪽의 국내 발언도 대비해 볼 만합니다. 김경훈 오픈AI코리아 대표는 간담회에서 Astra 개발의 초점이 "정말 일을 끝까지 스스로 해낼 수 있느냐"였다고 말했습니다(뉴시스, 2026-09-12). 이번 실험의 Astra는 끝까지 해내기는 했습니다. 다만 그 "끝"을 6시간 중 53분 지점으로 스스로 정했습니다. 국내 개발자 기고에는 정반대의 위험도 실려 있습니다. 에이전트가 실패한 테스트 세 개를 환경변수 뒤로 숨기고 "12/12 통과"로 보고했는데, 들키기까지 28일이 걸렸다는 사례입니다(요즘IT, 2026-09-28). 무인 작업에서 "끝났다"는 보고는 언제나 검증할 대상입니다.
이 실험으로 말할 수 있는 것과 없는 것
이 실험은 모델 순위를 정하는 근거가 아니라, 장시간 무인 작업에서 무엇이 갈리는지 보여 주는 사례 하나입니다. 적대적으로 읽으면 한계가 많습니다.
- 실행은 모델당 한 번입니다. 같은 프롬프트라도 다시 돌리면 결과가 크게 달라질 수 있습니다. 저자도 다른 모델과 하네스로 직접 해 보라고 권했지만, 2026년 10월 9일까지 같은 프롬프트를 다른 최신 모델로 돌려 결과를 공개한 재현은 찾지 못했습니다.
- 평가자는 한 명입니다. "mesmerized"와 "slop"은 데이터 시각화를 해 온 저자 한 사람의 취향입니다. Hacker News에서는 Opus 결과물도 과하고 요란하다는 반응과 Astra 쪽이 UI에 짓눌렸다는 반응이 함께 나왔습니다(hitekker).
- 조건이 같지 않습니다. 하네스(Codex와 Claude Code), effort(Astra medium, Opus 미상), 병렬 실행 여부가 다릅니다. 모델의 차이와 하네스의 차이를 분리할 수 없습니다.
- 과정이 남아 있지 않습니다. 두 저장소 모두 결과 커밋 하나와 배포 커밋 하나뿐입니다. 이 글의 "작업 방식" 분석은 최종 파일에 남은 흔적으로 거꾸로 짐작한 것입니다. Opus 지침서의 프로젝트 경로가
invisible-opus-more인 것을 보면 저자 쪽에서 몇 번 돌려 봤을 가능성도 있지만, 확인할 방법은 없습니다. - 배포 커밋은 사람이 요청한 작업일 수 있습니다. 두 저장소의 두 번째 커밋은 GitHub Pages 배포와 하위 경로 대응입니다. 6시간 실행 안에 들어간 일인지, 나중에 따로 시킨 일인지는 원문에 나오지 않습니다.
- 기준이 된 사례도 조건이 다릅니다. 저자가 계기로 든 Ryan Sael의 렌즈 실험실은 "one shot"이라고 소개됐습니다. 하지만 작성자는 답글에서 프롬프트에 자기 파일과 미공개 프로젝트를 훑게 하는 지시가 들어 있었다고 밝혔습니다(Ryan Sael, X, 2026-09-23). 프롬프트를 완전히 공개한 이번 실험이 오히려 더 깨끗한 조건입니다.
그래도 이 사례에서 말할 수 있는 것은 있습니다. 첫째, 두 최신 모델 모두 프롬프트로 준 시간 예산을 다 쓰지 않았습니다. Opus 쪽은 Anthropic 문서가 설명하는 성향과 일치하고, Astra 쪽은 "끝까지 하라"는 OpenAI 가이드와 오히려 어긋납니다. 둘째, 같은 과제에서 한 모델은 분업과 시각 검증을, 다른 모델은 한 파일 중심의 구현과 자동 테스트를 택했고, 지적된 결함의 상당수가 각자 자동으로 검사하지 않은 영역에서 나왔습니다. 셋째, 이번처럼 범위가 열린 과제에서는 벤치마크의 "과제당 비용"이 실제 청구액을 예측하지 못했습니다.
장시간 무인 작업을 맡기기 전 체크리스트
모델에게 "6시간 동안 걸작을 만들어"라고 말하는 대신, 시간과 완료 조건과 검증을 하네스에 둡니다. 이 실험과 두 회사의 공식 문서를 겹쳐 필자가 정리한 순서입니다.
- 시간은 문장이 아니라 신호로 줍니다. Opus 5.5에는 하네스가 메시지마다 경과 시간을 붙이고, 원하는 시간보다 넉넉하게 예산을 잡습니다. 예산은 권고일 뿐이니 하드 타임아웃은 따로 둡니다.
- 완료 조건을 문장으로 적습니다. "걸작"이 아니라 "55개 도시 모두 렌더, 콘솔 오류 0, 모바일에서 첫 화면 통과, 아래 규칙 테스트 통과"처럼 확인할 수 있는 조건으로 씁니다. 텍스트로만 끝난 턴은 완료가 아니라 보고로 다루고, 자동 계속은 두세 번까지만 합니다.
- "보기 좋은가"와 "맞는가"를 둘 다 검사합니다. Opus가 쓴 스크린샷 검토와 Astra가 쓴 구조 테스트를 함께 요구합니다. 3D라면 "다리의 양 끝은 땅에 닿는다", "구조물끼리 겹치지 않는다" 같은 물리 규칙을 테스트로 쓰게 합니다.
- 서브에이전트 수와 비용에 상한을 둡니다. 프롬프트로 개수를 정해도 넘길 수 있다는 보고가 있으니, 훅이나 하네스 설정으로 막습니다. 탐색처럼 가벼운 일은 작은 모델에 맡깁니다.
- 디자인 기본값을 이름으로 금지합니다. "AI 티 나지 않게"보다 "크림색 배경, 01/02/03 번호 라벨, 알약 모양 버튼 금지"처럼 피할 패턴을 구체적으로 적습니다. Anthropic 문서도 일반적인 지시는 기본값을 다른 기본값으로 바꿀 뿐이라며 이런 예시를 듭니다.
- 모델의 자기 보고를 로그와 대조합니다. 소요 시간, 통과한 테스트 수, 만든 에이전트 수는 하네스 로그로 확인합니다. 이 실험의 "절반을 썼다"가 그 예입니다.
1번과 2번을 하네스 쪽에서 구현하면 대략 아래 모양이 됩니다. 특정 SDK의 실제 API가 아니라 흐름을 보여 주는 설명용 예시입니다.
# 설명용 예시: 경과 시간 신호, 하드 타임아웃, 완료 조건 확인을 하네스가 맡는다
import time

# 모델에게 알려 줄 예산
BUDGET_S = 6 * 3600
# 예산은 권고일 뿐이므로 별도 하드 타임아웃
HARD_STOP_S = 7 * 3600
# 자동 계속은 두세 번까지
MAX_NUDGES = 3

def run(agent, task, checks):
    start, nudges = time.time(), 0
    reply = agent.send(task)
    while time.time() - start < HARD_STOP_S:
        elapsed = int(time.time() - start)
        if reply.has_tool_call:
            # 도구는 하네스가 실행
            result = execute(reply.tool_call)
            reply = agent.send(f"{result}\nelapsed {elapsed}s / {BUDGET_S}s")
            continue
        # 모델 보고가 아니라 하네스가 완료 조건을 검사
        failed = [c.name for c in checks if not c.passed()]
        if not failed:
            return "done"
        if nudges >= MAX_NUDGES:
            # 사람이 검토
            return f"stuck: {failed}"
        nudges += 1
        reply = agent.send(f"완료 조건이 남았습니다: {failed}. 계속하세요.\nelapsed {elapsed}s / {BUDGET_S}s")
    return "timeout"
4번의 서브에이전트 상한은 Claude Code라면 도구 호출 전에 실행되는 훅으로 걸 수 있습니다. 훅을 쓰는 방법은 Claude Code Mods 구조와 10가지 활용과 Claude Code 팁 11가지에 정리해 두었습니다.
자주 묻는 질문
그래서 Opus 5.5와 GPT-6 Astra 중 무엇이 낫나요?
이 실험만으로는 답할 수 없습니다. 실행 한 번, 평가자 한 명이고 하네스와 effort가 달랐습니다. 이 실험에서 Opus 5.5는 더 화려한 결과물을 더 비싸게 만들었고, Astra는 더 싸고 테스트가 촘촘한 결과물을 만들었습니다. Anthropic의 발표 표에서도 Terminal-Bench Science와 AutomationBench처럼 Astra가 앞서는 항목이 있어, 과제마다 앞서는 모델이 다릅니다(Anthropic). 내 작업에 맞는지는 내 과제로 여러 번 돌려 보고 정해야 합니다.
모델에게 6시간을 다 쓰게 하려면 어떻게 하나요?
프롬프트 문장으로는 잘 되지 않습니다. 하네스가 경과 시간을 알려 주고, 완료 조건을 검사해 남은 항목이 있으면 다시 일을 시키는 루프를 둡니다. Codex의 /goal처럼 목표가 이뤄질 때까지 세션을 붙잡는 기능도 같은 원리입니다. 다만 시간을 채우는 것 자체가 목표가 되면 바쁜 척만 하는 경우도 보고되었으니, 시간보다 완료 조건을 먼저 정합니다.
74달러는 비싼 건가요?
과제에 따라 다릅니다. Hacker News에서는 "사람이 거의 손대지 않고 약 100달러로 얻을 수 있는 새로운 바닥"이라는 반응이 나왔습니다(twoodfin). 반대로 같은 프롬프트로 10달러짜리 결과도 나왔습니다. 중요한 것은 범위가 열린 과제에서 비용 상한을 모델이 아니라 사람이 정해야 한다는 점입니다. 서브에이전트 수와 하드 타임아웃이 사실상 예산 상한 역할을 합니다.
같은 프롬프트를 직접 돌려 봐도 되나요?
저자가 직접 권했습니다. 두 결과물의 코드가 공개되어 있으니 내 결과와 나란히 비교할 수 있습니다. 비교할 때는 effort, 하네스, 병렬 실행 여부, 실제 경과 시간과 비용을 함께 기록해야 의미가 있습니다. 여러 번 돌려 결과가 얼마나 흔들리는지도 함께 보면 좋습니다.
마치며
이 실험을 한 줄로 줄이면 두 모델 모두 시간이 아니라 자기가 정한 기준으로 일을 끝냈고, 그 기준이 결과물의 장점과 결함을 함께 만들었다는 것입니다. Opus 5.5는 일을 나누고 눈으로 확인해 아름다운 도시를 만들었지만, 다리가 이어졌는지 자동으로 검사하지는 않았습니다. GPT-6 Astra는 책의 구조까지 테스트했지만, 화면 요소가 꼭 필요한지는 검사 대상이 아니었습니다. 그리고 둘 다 사람이 준 6시간을 한참 남기고 멈췄습니다.
장시간 무인 작업을 맡길 때 사람의 몫은 그 기준을 대신 정해 주는 일입니다. 다음에 에이전트에게 긴 일을 맡긴다면, 프롬프트에 시간을 적기 전에 완료 조건 세 줄과 검사 하나를 먼저 써 보시길 권합니다. 저자가 남긴 "what is my place in creating interactive media?"라는 질문에 대한 지금의 답도 아마 거기에 있을 것입니다.
sources:auto출처
- I gave Opus 5.5 one prompt and six hours to visualize Invisible Cities, Quesma, 2026-10-07: quesma.com/blog/invisible-cities-one-shot
- Astra 데모: p.migdal.pl/invisible-cities-astra
- stared/invisible-cities-astra, GitHub: github.com/stared/invisible-cities-astra
- Opus 데모: p.migdal.pl/invisible-cities-opus-5.5
- README, invisible-cities-opus-5.5: github.com/stared/invisible-cities-opus-5.5
- Prompting Claude Opus 5.5, Anthropic: platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompt…
- GPT-6 Astra: A new generation of intelligence, OpenAI, 2026-09-03: openai.com/index/gpt-6-astra
- Model guidance: gpt-6-astra, OpenAI: developers.openai.com/api/docs/guides/latest-model?model=gpt-6-astra
- r/codex, 2026-09-09: reddit.com/r/codex/comments/1wb5rof
- aetherspawn, Hacker News, 2026-10-08: news.ycombinator.com/item?id=50005313
- city-brief.md, invisible-cities-opus-5.5: github.com/stared/invisible-cities-opus-5.5/blob/main/docs/city-brief.md
- Introducing Claude Opus 5.5, Anthropic, 2026-09-22: anthropic.com/claude-opus-5-5
- data.spec.ts, invisible-cities-astra: github.com/stared/invisible-cities-astra/blob/main/tests/data.spec.ts
- r/ClaudeCode, 2026-10-02: reddit.com/r/ClaudeCode/comments/1wvi5ar
- user43928, Hacker News: news.ycombinator.com/item?id=50005419
- r/codex, 2026-09-23: reddit.com/r/codex/comments/1wnx8i9
- Hacker News, 2026-10-08: news.ycombinator.com/item?id=50004790
- SiempreViernes: news.ycombinator.com/item?id=50005329
- Traubenfuchs: news.ycombinator.com/item?id=50005572
- aappleby: news.ycombinator.com/item?id=50009861
- matsemann: news.ycombinator.com/item?id=50010045
- urig: news.ycombinator.com/item?id=50008570
- pama: news.ycombinator.com/item?id=50005223
- alm4x: news.ycombinator.com/item?id=50009365
- r/ClaudeAI, 2026-10-07: reddit.com/r/ClaudeAI/comments/1wzycg6
- sixsevenrot: news.ycombinator.com/item?id=50014191
- Jordan-117: news.ycombinator.com/item?id=50014324
- GeekNews: news.hada.io/topic?id=35013
- 클리앙, 2026-09-26: clien.net/service/board/park/19269919
- 클리앙, 2026-09-07: clien.net/service/board/park/19259888
- 클리앙, 2026-09-06: clien.net/service/board/park/19259289
- AI타임스, 2026-09-23: aitimes.com/news/articleView.html?idxno=215618
- 뉴시스, 2026-09-12: newsis.com/view/NISX20260910_0003784830
- 요즘IT, 2026-09-28: yozm.wishket.com/magazine/detail/3966
- hitekker: news.ycombinator.com/item?id=50015123
- Ryan Sael, X, 2026-09-23: x.com/RyanSael/status/2102591147927654847
- twoodfin: news.ycombinator.com/item?id=50007584
글쓴이
주홍철은 네이버 출신 개발자이자 AI 핀테크 스타트업 어비스(AVISS)의 대표입니다. 경제·증시 분석 AI, AI 에이전트, 데이터 파이프라인을 직접 설계하고 개발하며, 『면접을 위한 CS 전공지식 노트』와 『클로드 코드 제대로 시작하기』(길벗)를 썼습니다. 회사 소개는 어비스 홈페이지에, 다른 글은 어비스 블로그에 있으며, 글에 대한 정정 요청이나 문의는 [email protected]으로 보내 주세요.