프론트엔드의 고가용성은 서버 가동률이 아니라 "사용자가 화면에서 핵심 작업을 끝낼 수 있는가"입니다. 서버가 멀쩡해도 화면은 죽고, 지난 1년의 큰 장애가 그 경로를 하나씩 보여 줬습니다. 2025년 10월 AWS us-east-1은 약 14.5시간 동안 흔들렸고, 11월 18일 Cloudflare는 스스로 "worst outage since 2019"라고 부른 장애를 냈습니다. 12월 5일에는 업비트, 배달의민족, 무신사가 같은 시각에 멈췄고, 2026년 9월 28일에는 Firebase iOS SDK가 이미 사용자 기기에 깔린 앱을 깨뜨렸습니다. 이 사례들을 겹쳐 보면 화면이 죽는 경로는 셋입니다. 내가 고칠 수 없는 의존성, 내 배포, 그리고 내 클라이언트의 재시도입니다. 이 글은 공식 사후 분석과 국내 기업이 밝힌 사례로 그 세 경로를 막는 일곱 가지 방어선을 정리합니다.
필자는 AI 핀테크 스타트업 어비스(AVISS)의 대표로 서비스를 직접 설계하고 개발합니다. 이 글도 Claude Code로 자료를 모았고, 글에 나오는 코드는 모두 설명용 예시입니다. 어느 클라우드에 서비스를 올릴지에 대한 판단은 서버를 이제 AWS에 올리지 않는 이유에, Next.js 쪽 이야기는 Next.js 링크가 느린 이유에 따로 정리해 두었습니다.
핵심 요약
- 고가용성의 단위는 서버가 아니라 화면입니다. 서버 지표가 초록이어도 CDN, SDK, 배포, 재시도 때문에 화면은 죽습니다. Google SRE 기준으로 99.99%는 한 달 4.32분, 99.999%는 25.9초의 중단을 허용하지만, 99% 신뢰도의 스마트폰을 쓰는 사용자는 둘을 구분하지 못합니다.
- 화면이 죽는 경로는 셋입니다. 고칠 수 없는 의존성(AWS 약 14.5시간, Cloudflare 11월 18일 약 5시간 46분, 12월 5일 국내 서비스 동시 정지), 내 배포(버전 스큐, 카카오페이 카나리 배포 중 약 20% 오류), 내 클라이언트(Cloudflare 대시보드의
useEffect반복 호출과 재인증 폭주)입니다.- 캐시와 배포 순서가 가장 싼 방어선입니다. 해시 자산은
immutable장기 캐시, HTML은no-cache, CDN에는stale-if-error를 두되 CDN마다 다른 기본값을 확인합니다. 이전 청크는 지우지 않고 HTML은 마지막에 올리며, 새로고침에 견디는 상태 구조를 만듭니다.- 재시도는 예산 안에서만 합니다. 5계층이 3회씩 재시도하면 맨 아래 부하는 243배가 됩니다. 지터와 재시도 예산이 그 곱셈을 끊고, 쓰기 요청은 멱등 키로 중복 처리를 막습니다. Uber는 홉마다 10% 재시도 예산과 오류 소유권 헤더로 2025년 11월 18일 장애 중 불필요한 요청 950만 건을 막았습니다.
- 이중화는 넘겨 봐야 이중화입니다. 국정자원 화재 때 709개 시스템 가운데 재해복구시스템을 갖춘 곳은 54개, 실제 복구에 쓴 것은 7개였습니다. 폴백 경로, 킬 스위치, 상태 페이지는 평소에 눌러 보고 본 서비스와 다른 인프라에 둡니다.
목차
- 프론트엔드의 고가용성은 무엇을 지키는 일인가요?
- 최근 장애가 보여 준 세 가지 실패 경로
- 방어선 1. 캐시로 버팁니다
- 방어선 2. 오리진과 CDN을 갈아탈 길을 둡니다
- 방어선 3. 배포가 장애가 되지 않게 합니다
- 방어선 4. 클라이언트가 장애를 키우지 않게 합니다
- 방어선 5. 부분 실패를 화면 단위로 가둡니다
- 방어선 6. 서버가 아니라 사용자 쪽에서 잽니다
- 방어선 7. 장애를 알릴 길은 다른 인프라에 둡니다
- 어디서부터 시작할까요: 체크리스트
- 방어 장치도 장애가 됩니다
- 이 글의 자료를 고른 방법
- 자주 묻는 질문
- 마치며
- 출처
프론트엔드의 고가용성은 무엇을 지키는 일인가요?
프론트엔드의 고가용성은 "서버가 응답하는가"가 아니라 "사용자가 로그인하고, 상품을 담고, 결제를 끝낼 수 있는가"로 잽니다. 이 차이는 생각보다 큽니다. Splunk는 2021년 Fastly 장애를 돌아보며, CDN이 죽으면 트래픽이 오리진까지 오지 않기 때문에 인프라 대시보드는 오히려 초록색으로 보인다고 지적했습니다(What the Fastly Outage Can Teach Us About Observability, Splunk, 2021-06-10). 서버 입장에서는 요청이 줄었을 뿐 오류를 낸 적이 없습니다. 그동안 사용자는 오류 화면을 보고 있었습니다.
목표를 몇 나인으로 잡을지도 같은 관점에서 정합니다. Google SRE 책의 가용성 표에 따르면 각 목표가 한 달에 허용하는 중단 시간은 아래와 같습니다(Availability Table, Google SRE Book, 2016).
| 가용성 목표 | 한 달에 허용되는 중단 시간 |
|---|---|
| 99.9% | 43.2분 |
| 99.95% | 21.6분 |
| 99.99% | 4.32분 |
| 99.999% | 25.9초 |
같은 책은 99% 신뢰도의 스마트폰을 쓰는 사용자는 99.99%와 99.999% 서비스를 구분하지 못한다고 적었습니다(Embracing Risk, Google SRE Book, 2016). 사용자와 서버 사이에 놓인 기기, 네트워크, 브라우저가 이미 그만큼 실패하기 때문입니다. 프론트엔드에서 나인을 하나 더 붙이려면 큰 비용이 들고, 그 효과는 사용자가 느끼지 못하는 구간에 들어가기 쉽습니다.
그래서 모든 화면에 같은 목표를 두지 않습니다. 행정안전부가 2026년 4월 제정한 정보시스템 안정성 고시는 등급 기준을 "사용자 수"에서 "국민 생활에 미치는 영향"으로 바꾸고, 재해복구 목표시간을 A1 1시간 이내, A2 3~12시간, A3 1~5일, A4 3주 이내로 나눴습니다(연합뉴스, 2026-10-02, 뉴시스, 2026-10-02). 프론트엔드도 같은 방식이 맞습니다. 결제, 로그인, 주문 확인 같은 핵심 여정에는 엄격한 목표와 이중 경로를 두고, 추천, 배너, 리뷰 위젯 같은 부가 기능은 실패하면 조용히 사라지게 만듭니다. 이 글의 일곱 방어선도 결국 핵심 여정을 지키고 부가 기능을 버릴 수 있게 하는 장치입니다.
최근 장애가 보여 준 세 가지 실패 경로
지난 1년의 공식 사후 분석을 모아 보면, 서버 코드가 멀쩡한데도 화면이 죽는 경로는 세 갈래로 정리됩니다. 첫째는 CDN, 클라우드, SDK처럼 내가 고칠 수 없는 의존성이고, 둘째는 내가 한 배포, 셋째는 내 클라이언트가 보낸 요청입니다. 셋은 원인도 막는 방법도 다르지만, 사용자에게는 똑같이 "안 되는 화면"입니다.
1. 내가 고칠 수 없는 의존성이 멈춥니다
가장 길고 넓은 장애는 내 코드 밖에서 시작했습니다. AWS us-east-1 장애는 2025년 10월 19일 오후 11시 48분(PDT)부터 다음 날 오후 2시 20분까지 약 14.5시간 이어졌습니다. 원인은 DynamoDB의 DNS 관리 자동화에 숨어 있던 race condition으로, 리전 엔드포인트의 DNS 레코드가 비어 버렸습니다. 눈여겨볼 점은 DNS를 새벽 2시 25분에 복구했는데도 그 위에 얹힌 서비스들의 연쇄 영향이 오후까지 이어졌다는 것입니다(Summary of the Amazon DynamoDB Service Disruption, AWS, 2025-10). 원인을 고친 시각과 사용자가 다시 쓸 수 있게 된 시각 사이에 열 시간 넘는 간격이 있었습니다.
CDN도 마찬가지였습니다. 10월 29일 Azure Front Door는 15:41 UTC부터 다음 날 00:05까지 약 8시간 24분 동안 장애를 겪었고, 마지막으로 정상이던(last known good) 설정으로 되돌려 복구했습니다(Azure 사후 분석 YKYN-BWZ, Microsoft, 2025-10). 3주 뒤인 11월 18일 Cloudflare는 11:20 UTC부터 17:06까지 약 5시간 46분 동안 5xx를 냈고, 핵심 트래픽은 14:30쯤 대부분 정상으로 돌아왔습니다. 중복된 행 때문에 봇 관리용 feature 파일의 크기가 두 배로 커졌고, 그 안의 feature 수가 프록시가 정해 둔 상한 200개(평소 사용량 약 60개)를 넘은 것이 원인이었습니다. Cloudflare는 이를 "worst outage since 2019"라고 불렀습니다(Cloudflare outage on November 18, 2025, Cloudflare, 2025-11-18). 한국에서는 오후 8시 48분쯤 오류 공지가 올라왔습니다(중앙일보, 2025-11).
국내에서 더 크게 느껴진 것은 12월 5일입니다. Cloudflare는 08:47~09:12 UTC, 25분 동안 HTTP 트래픽의 약 28%에 오류를 냈습니다. React Server Components 취약점에 대응하는 설정을 킬 스위치로 처음 적용하다 구형 프록시(FL1)에서 오류가 난 것입니다(Cloudflare outage on December 5, 2025, Cloudflare, 2025-12-05). 한국 시각으로 저녁 피크 시간이었고, 업비트는 오후 6시 3분에 접속 장애를 공지했다가 23분 뒤 해소를 알렸습니다. 배달의민족, 무신사, CJ올리브영, CGV, 리멤버, 리그 오브 레전드도 같은 시각에 영향을 받았고, 대부분은 10분에서 20분 안에 복구됐습니다(천지일보, 2025-12-05, 헤럴드경제, 2025-12-05). 업종이 전혀 다른 서비스들이 같은 순간 함께 멈춘 장면은, 이들이 같은 CDN 하나에 기대고 있었다는 사실을 보여 줍니다. 유럽 기업 44,143곳을 조사한 독립 분석에서도 CDN을 쓰는 기업의 89.6%가 Cloudflare를 쓰고 있었습니다(European CDN concentration, ciphercue, 2026-09).
2026년에도 이어졌습니다. 2월 20일 Cloudflare에서는 고객이 가져온 IP 대역(BYOIP) 4,306개 가운데 약 1,100개가 철회되며 6시간 7분 동안 장애가 났고(Cloudflare outage on February 20, 2026, Cloudflare, 2026-02-21), 8월 20일 Google Cloud us-west1에서는 08:00~10:22(PT) 2시간 22분 동안 30개 넘는 서비스가 영향을 받았습니다(us-west1 인시던트 보고, Google Cloud Service Health, 2026-08). 9월 28일(PDT)에는 앱 안의 SDK가 문제였습니다. Firebase 공식 사후 분석에 따르면 서버 쪽에서 레거시 설정 플래그를 지웠는데 iOS SDK가 그 플래그를 계속 가리키고 있어, 약 2시간 11분 동안 앱이 치명적 오류를 냈습니다(Firebase 공식 사후 분석, Firebase Blog, 2026-10). 앱 개발자가 아무것도 배포하지 않았는데, 이미 배포된 앱이 깨진 것입니다.
아래 차트는 이 글에서 다루는 여덟 건의 지속 시간을 공식 사후 분석 기준으로 나란히 놓은 것입니다. 다음 절에서 볼 Cloudflare 9월 대시보드 장애도 함께 넣었습니다.
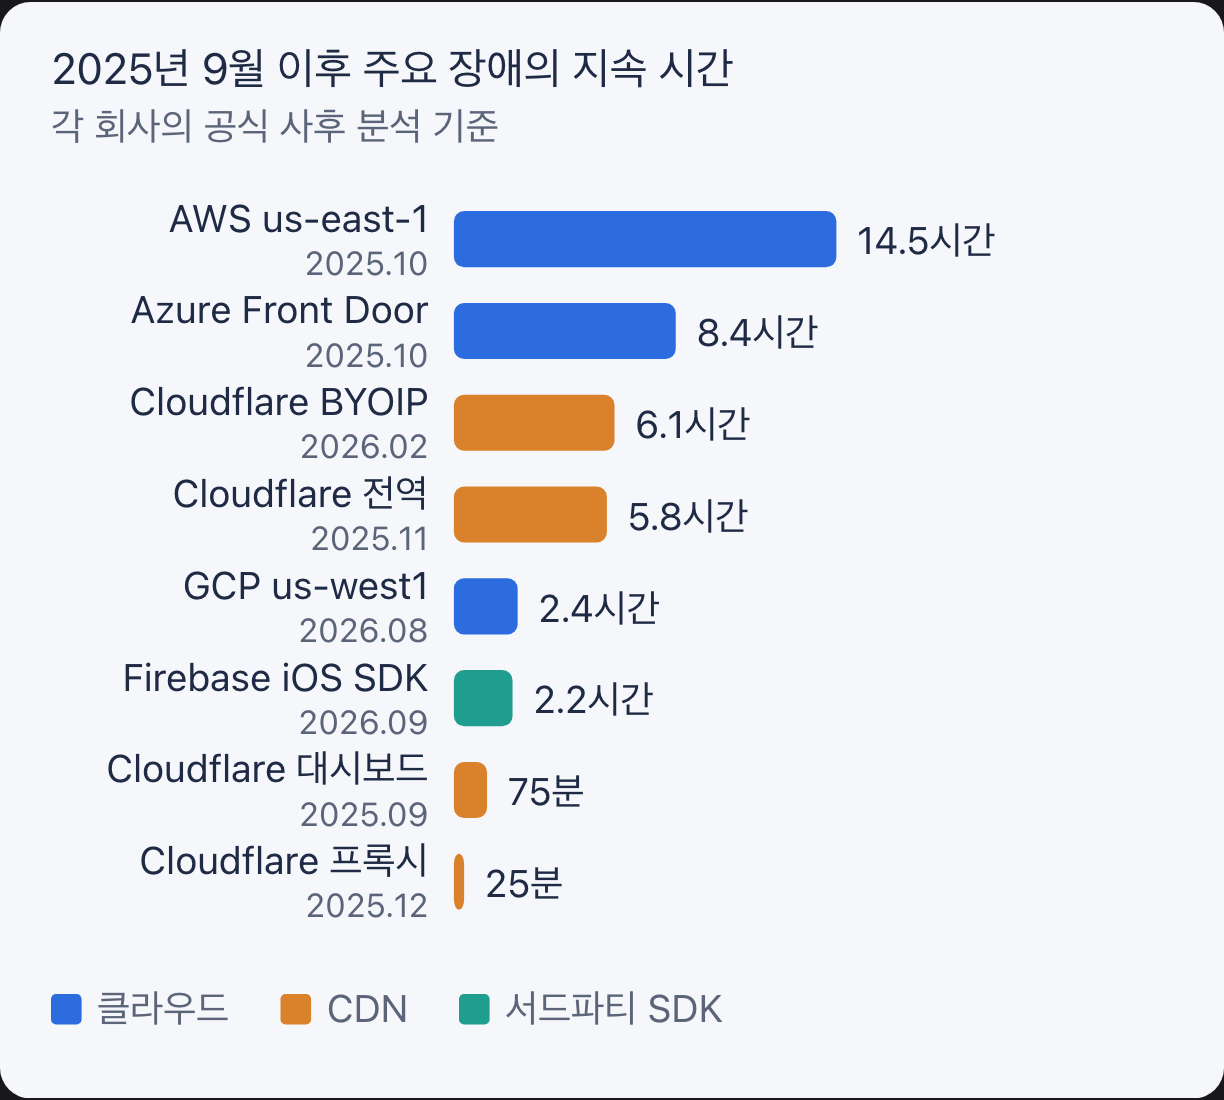
가장 긴 AWS의 약 14.5시간과 가장 짧은 Cloudflare 12월 5일의 25분 사이에는 서른 배 넘는 차이가 있습니다. 그런데 25분짜리 장애도 국내 거래소와 배달 앱을 저녁 시간에 멈춰 세웠습니다. 지속 시간보다 중요한 것은 그 시간 동안 내 화면이 무엇을 보여 주느냐입니다.
2. 내 배포가 장애가 됩니다
두 번째 경로는 내가 직접 연 것입니다. 배포 중에는 새 버전과 옛 버전이 잠시 함께 돌고, 그 틈에서 화면이 깨집니다. 말테 우블은 이를 버전 스큐(version skew)라고 부르며, 서로 의존하는 둘 이상의 시스템이 원자적으로 배포되지 않아 잠시 다른 버전으로 동작하는 상태라고 정의했습니다(Version skew, Malte Ubl, 2023-06-21). 프론트엔드에서는 브라우저에 떠 있는 옛 HTML이 서버에서 이미 사라진 옛 청크를 요청하거나, 옛 페이지가 새 서버를 부르는 모습으로 나타납니다. 흔히 보는 ChunkLoadError와 흰 화면이 그 결과입니다.
카카오페이는 머니 충전 웹뷰에서 이 문제를 겪었다고 밝혔습니다. 카나리 배포 중 두 버전이 공존하는 동안 요청이 다른 버전의 서버로 가면서 404가 났고, Next.js가 강제로 새로고침하면서 충전 결과 상태가 사라졌습니다. 에러 비율은 전체 트래픽의 약 20%로 카나리 배포 비율과 비슷했습니다(Next.js 트러블슈팅: CORS와 Version Skew 에러 원인부터 해결까지, 카카오페이 기술블로그, 2025-06-04). 이 회사가 찾은 해법은 방어선 3에서 다시 봅니다.
국내 개발자 블로그에도 이 장면이 경험담으로 자주 나옵니다. 한 개발자는 "개발자는 배포를 확인하려고 새로고침하지만 사용자는 새로고침하지 않는다"는 취지로 적었고(velog goon126, 2021-06-17), 다른 개발자는 사용자가 웹앱을 켜 둔 채 3시간 뒤 다시 누르면 서버에는 이미 옛 파일이 사라져 있다고 설명했습니다(velog heina-effect, 2025-05-09). 배포 직후 개발자가 보는 화면은 늘 새 버전이고, 사용자가 들고 있는 화면은 늘 조금 옛 버전입니다. 이 비대칭이 두 번째 경로의 핵심입니다.
3. 내 클라이언트가 장애를 키웁니다
세 번째 경로는 가장 덜 이야기되지만 가장 프론트엔드다운 장애입니다. 내가 짠 클라이언트 코드가 우리 백엔드를 두드리는 경우입니다. Cloudflare의 2025년 9월 12일 대시보드와 API 장애는 17:57~19:12 UTC, 약 75분 이어졌습니다. 대시보드의 React useEffect 의존성 배열에 렌더할 때마다 새로 만들어지는 객체가 들어가, Tenant Service API를 불필요하게 반복 호출한 것이 원인이었습니다. 이를 수습하려고 Tenant Service를 재시작하자 모든 사용자의 대시보드가 동시에 재인증을 시도하면서 thundering herd가 됐습니다(A deep dive into Cloudflare's September 12, 2025 dashboard and API outage, Cloudflare, 2025-09-13). 그동안 CDN의 data plane은 정상이었습니다. 고객 사이트는 잘 돌았는데, 회사의 관리 화면이 스스로 만든 요청에 묻힌 것입니다.
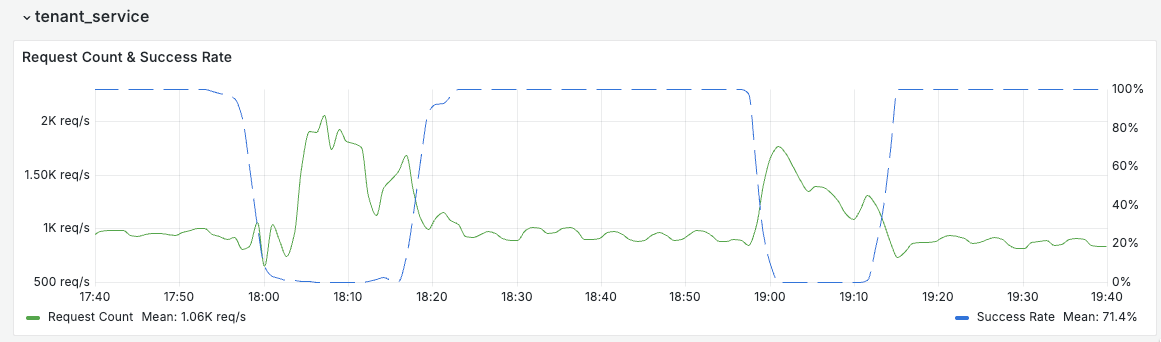
그래프에서 보듯 성공률이 0%인 동안 요청 수는 오히려 두 배 넘게 뛰었습니다. 실패한 요청이 재시도와 재인증으로 다시 돌아오는 모습입니다. Cloudflare가 재발 방지책으로 대시보드 재시도 로직에 무작위 지연을 넣은 것도 그래서이고, 배포 쪽에는 Argo Rollouts 자동 롤백을 걸었습니다. 클라우드 장애 보고에도 같은 단어가 나옵니다. Google Cloud는 2026년 8월 us-west1 장애의 증상으로 "increased retry volume"을 적었습니다(Google Cloud Service Health). 장애가 서버에서 시작해도, 재시도는 클라이언트가 보냅니다.
방어선 1. 캐시로 버팁니다
가장 싸고 효과가 큰 방어선은 캐시입니다. 해시가 붙은 정적 자산은 오래 캐시하고, HTML은 매번 재검증하며, CDN에는 오리진이 실패해도 지난 응답을 내주게 합니다. web.dev는 버전이나 해시가 URL에 들어간 자산에는 max-age=31536000을, HTML에는 no-cache를 권합니다(Prevent unnecessary network requests with the HTTP Cache, web.dev). 토스도 2021년에 같은 원칙을 밝혔습니다. JS와 CSS는 빌드마다 고유한 URL에 max-age=31536000을 붙이고, HTML은 max-age=0, s-maxage=31536000으로 브라우저에서는 매번 확인하되 CDN에는 오래 두며, 배포할 때 CDN 캐시를 무효화합니다(웹 서비스 캐시 똑똑하게 다루기, 토스 기술블로그, 2021-04-29). 이렇게 나누면 배포 때 바뀌는 것은 HTML 하나뿐이고, 해시 자산은 지우지 않는 한 언제나 같은 내용입니다.
장애 때 버티게 해 주는 것은 RFC 5861의 두 지시어입니다. stale-while-revalidate는 만료된 응답을 정해진 시간 동안 먼저 내주고 뒤에서 갱신하게 하고, stale-if-error는 오리진이 500, 502, 503, 504를 낼 때 만료된 캐시로 대신 응답하게 합니다(RFC 5861, IETF, 2010-05). Cloudflare가 2026년 5월 회복력 개선을 마무리하며 내건 원칙도 같은 방향입니다. 가능하면 마지막으로 정상이던 설정을 쓰는 "fail stale"을 택하고, 그게 불가능할 때만 fail open이나 fail close를 고른다는 것입니다(Code Orange: Fail Small is complete, Cloudflare, 2026-05-01). 오래된 화면이라도 보여 주는 편이 오류 화면보다 낫다는 판단을 HTTP 헤더로 미리 적어 두는 셈입니다.
다만 이 지시어에는 함정이 셋 있습니다. 첫째, stale-if-error는 CDN이나 공유 캐시에서 주로 쓰는 지시어입니다. MDN은 요청 지시어 쪽은 어느 브라우저도 지원하지 않는다고 적고 있고, 브라우저가 응답 지시어를 존중하는지는 이 글을 쓰며 확인하지 못했습니다(Cache-Control, MDN). 둘째, CDN마다 기본값이 다릅니다. Fastly는 오래된 콘텐츠 제공이 기본으로 꺼져 있고, 켜면 stale-on-error TTL 기본값이 43,200초(12시간)입니다(Serving stale content, Fastly Docs). 셋째, Cloudflare는 오리진이 5xx를 낼 때만 stale-if-error를 적용하고 404에는 적용하지 않으며, Always Online을 켜 두면 두 지시어를 모두 무시합니다(Cache-Control, Cloudflare Docs). 헤더를 붙인 것으로 끝나지 않고, 쓰는 CDN이 그 헤더를 어떻게 해석하는지 문서로 확인해야 합니다.
세 종류의 응답에 붙일 헤더를 설명용 예시로 정리하면 다음과 같습니다. 숫자는 서비스에 맞게 정할 값입니다. stale-while-revalidate는 Chrome 75, Firefox 68 이상 같은 브라우저도 적용하지만(web.dev), s-maxage와 stale-if-error는 CDN이 해석한다는 전제입니다.
# 설명용 예시 1. 해시가 붙은 정적 자산 (/assets/app.3f9a1c.js)
Cache-Control: public, max-age=31536000, immutable

# 설명용 예시 2. HTML 문서 (/index.html): 브라우저는 매번 재검증
Cache-Control: no-cache

# 설명용 예시 3. 자주 바뀌지 않는 공개 API 응답: 브라우저는 매번 확인(max-age=0),
# CDN은 1분 캐시, 만료 뒤 30초는 먼저 내주고 갱신, 오리진 5xx면 하루 동안 지난 응답 사용
Cache-Control: public, max-age=0, s-maxage=60, stale-while-revalidate=30, stale-if-error=86400
예시 2의 no-cache만으로는 오리진이 죽었을 때 HTML을 지켜 주지 못하고, HTML이 없으면 화면도 없습니다. 브라우저에는 no-cache를 주면서 CDN에만 오래된 HTML을 허용하려면 Cloudflare의 CDN-Cache-Control(CDN-Cache-Control, Cloudflare Docs)이나 Fastly의 Surrogate-Control(Fastly Docs)처럼 CDN 전용 헤더에 stale-if-error를 따로 두는 방법이 있으니, 쓰는 CDN의 문서에서 지원 여부를 확인합니다.
실무에서 자주 틀리는 곳은 헤더를 정하는 단계보다 붙이는 단계입니다. velog의 한 개발자는 S3와 CloudFront로 옮긴 뒤 웹뷰의 일부 사용자에게만 흰 화면이 났던 경험을 적으면서, aws s3 sync는 한 번의 명령에 --cache-control을 하나만 적용한다는 점을 짚었습니다(velog jeon-yj, 2025-05-18). HTML과 해시 자산을 같은 명령으로 올리면 같은 정책이 붙는다는 뜻입니다. 배포 스크립트에서 둘을 다른 명령으로 올리고, 배포 뒤 실제 응답 헤더를 curl -I로 확인하는 습관이 이 방어선의 절반입니다.
방어선 2. 오리진과 CDN을 갈아탈 길을 둡니다
캐시가 비어 있거나 동적인 요청이라면, 오리진이 죽었을 때 넘어갈 다른 길이 필요합니다. 그리고 그 길은 실제로 넘겨 봐야 믿을 만합니다. AWS CloudFront의 origin group은 1차 오리진이 미리 정한 오류 코드를 내면 같은 요청을 2차 오리진으로 다시 보냅니다. 별도 장비 없이 CDN 설정만으로 오리진이 이중화되니 작은 팀도 시작하기 좋습니다.
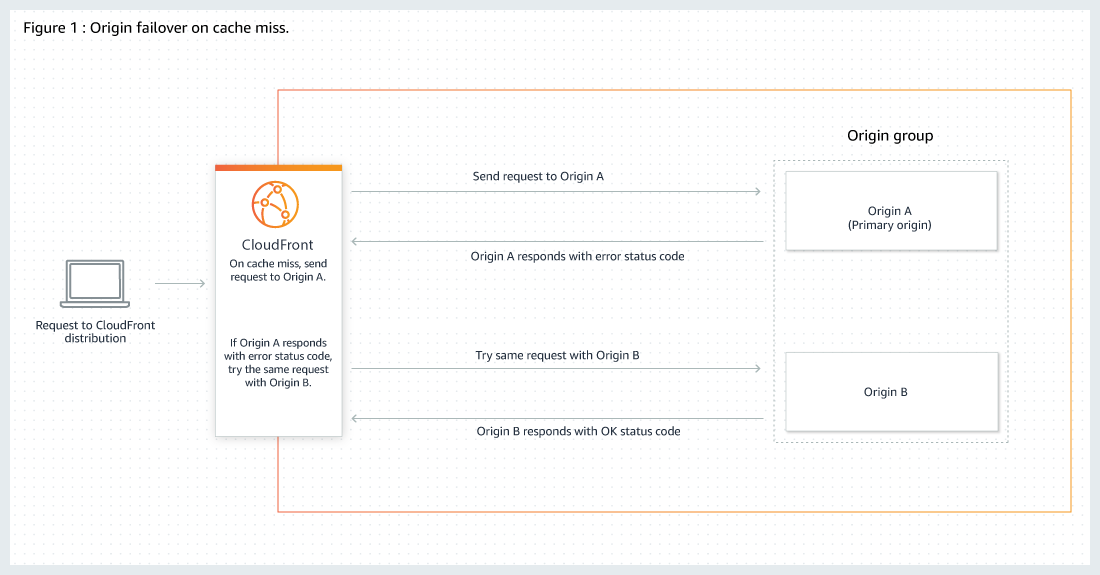
문서에는 놓치기 쉬운 조건이 둘 있습니다. 하나는 failover가 GET, HEAD, OPTIONS 요청에서만 동작한다는 점입니다. 결제나 주문 같은 POST는 넘어가지 않습니다. 다른 하나는 기본 대기 시간입니다. CloudFront는 기본으로 1차 오리진에 10초씩 세 번, 최대 30초 동안 연결을 시도한 뒤에야 2차로 넘어가고, 응답 타임아웃도 기본 30초입니다(CloudFront origin failover, AWS 문서).
이 기본값이 어떤 결과를 내는지는 2026년 7월 16일 CloudFront VPC Origins 장애에서 드러났습니다. 일본 classmethod의 로그 분석 기준으로, 장애 중 p95 응답 시간은 약 30.3초였고 이는 설정된 OriginReadTimeout과 같은 값이었습니다(CloudFront VPC Origin 장애 로그 분석, classmethod, 2026-07). AWS 원문이 아니라 한 회사가 자기 로그를 분석한 2차 자료입니다. 그래도 타임아웃을 기본값으로 두면 사용자가 그 시간만큼 기다린다는 점을 보여 주기에는 충분합니다.
그래서 failover를 켤 때는 타임아웃을 함께 줄입니다. connection timeout은 1~10초, 연결 시도는 1~3회, 응답 타임아웃은 1~120초(기본 30초) 사이에서 고를 수 있습니다. 위 사례의 30.3초는 응답 타임아웃이었으니, 연결 쪽만이 아니라 응답 타임아웃도 오리진의 평소 응답 시간을 보고 사용자가 견딜 만한 수준으로 낮춥니다. DNS 단에서 넘기고 싶다면 Route 53 health check로 엔드포인트 상태를 검사해 레코드를 바꾸는 방법도 있지만, 검사 주기와 판정이 쌓이는 만큼 전환은 즉시 일어나지 않습니다. 마지막 대비로는 정적 파일만 담은 폴백 페이지를 둡니다. 두 오리진이 모두 실패해도 "지금 무슨 일이 있고 언제 다시 오면 되는지"는 보여 줄 수 있어야 합니다.
CDN과 리전 선택이 화면 속도에 주는 영향은 바이브코딩 배포가 느린 진짜 이유에서 따로 다뤘습니다. 멀티 CDN은 그다음 단계입니다. LINE을 운영하는 LY는 GSLB와 멀티 CDN을 쓰면서 CDN마다 데이터 소스와 대시보드가 늘어, 결국 통합 모니터링을 따로 만들어야 했다고 밝혔습니다(Vector를 활용해 멀티 CDN 로그 및 트래픽 관리하기, LY 기술블로그, 2023-10-13). CDN을 하나 더 계약하는 일은 시작일 뿐이고, 두 CDN을 같은 눈으로 보는 관측 체계가 따라와야 한다는 뜻입니다. 작은 팀에게는 그마저 멀리 있습니다. Cloudflare 장애로 사이드 프로젝트가 접속 불가가 된 한 개발자는 자체 서버가 없는 작은 기업에게 멀티 클라우드는 현실적으로 쉽지 않다고 적었습니다(티스토리 gun22, 2025-11-20).
이중화는 실제로 넘겨 봐야 이중화입니다. 2025년 9월 26일 국가정보자원관리원 화재로 709개 시스템이 멈췄을 때, 재해복구시스템(DR)을 갖춘 곳은 54개(7.6%)였고 실제 복구에 쓴 것은 7개였습니다. 액티브-액티브 방식은 한 곳도 없었고, 1등급 시스템도 복구에 평균 10.8일이 걸렸습니다. 디지털데일리가 감사원 감사 결과와 함께 전한 국무조정실 관계자의 말은 이렇습니다. "클라우드 영역을 나눠도 실제 위치는 같은 건물 5층과 3층인 식이었다. 층 전원이 내려가면 둘 다 멈춘다."(디지털데일리, 2026-09-23) 반대로 인프라 점검 작업 자체가 장애가 되기도 합니다. 37signals는 2026년 9월 29일 데이터센터 전력 점검 중 설정이 잘못된 로드밸런서 때문에 Basecamp와 HEY가 약 24분 멈췄다고 밝혔습니다(37status, 2026-09-29). 2차 오리진과 폴백 페이지는 장애 날이 아니라 평일 낮에 일부러 1차를 끊어 보며 확인해야 합니다.
방어선 3. 배포가 장애가 되지 않게 합니다
배포가 장애가 되지 않게 하는 원칙은 다섯 가지입니다. 이전 청크를 지우지 않고, 사용자를 한 버전에 고정하고, 청크 로드 실패를 처리하되 그 처방을 과신하지 않고, 새로고침에 견디는 상태를 만들고, 새 버전을 조금씩 내보냅니다. 앞의 셋은 배포 스크립트와 설정 몇 줄이면 되고, 뒤의 둘은 화면 설계와 배포 체계를 건드립니다.
이전 청크를 지우지 않습니다
Vite 문서는 새 배포가 일어나면 호스팅 서비스가 이전 배포의 자산을 지울 수 있다고 경고합니다(Building for Production, Vite). 흔한 실수는 배포 스크립트에 있습니다. 최근 한 GitHub 이슈는 aws s3 rm --recursive로 버킷을 비운 뒤 sync로 올리는 방식 때문에 최대 1분 동안 청크가 사라졌다고 보고하면서, 해시 청크는 불변이니 지우지 말고 덮어쓰기만 하자고 제안했습니다(bcgov/reserve-rec-public #863). 바뀌는 것은 index.html뿐이니 그것만 바꾸면 됩니다.
순서도 중요합니다. 티스토리의 한 개발자는 Next.js 정적 배포에서 간헐적으로 나는 ChunkLoadError를 정리하며, 이전 _next/static을 남겨 두고, 새 청크를 먼저 올린 다음 HTML을 마지막에 올리고, 오래된 파일 정리는 배포와 분리된 별도 작업으로 돌리라고 적었습니다(티스토리 mksm10141015, 2026-08-08). HTML이 바뀌는 순간 그 HTML이 가리키는 새 청크는 이미 CDN에 있어야 하고, 옛 HTML을 들고 있는 탭이 찾는 옛 청크도 한동안 남아 있어야 합니다.
사용자를 한 버전에 고정합니다
Vercel의 Skew Protection은 한 사용자가 처음 연 배포로 이후 요청을 계속 보내는 방식입니다. 배포 B가 나와도 배포 A에서 페이지를 연 사용자는 A의 함수와 정적 자원을 계속 씁니다.
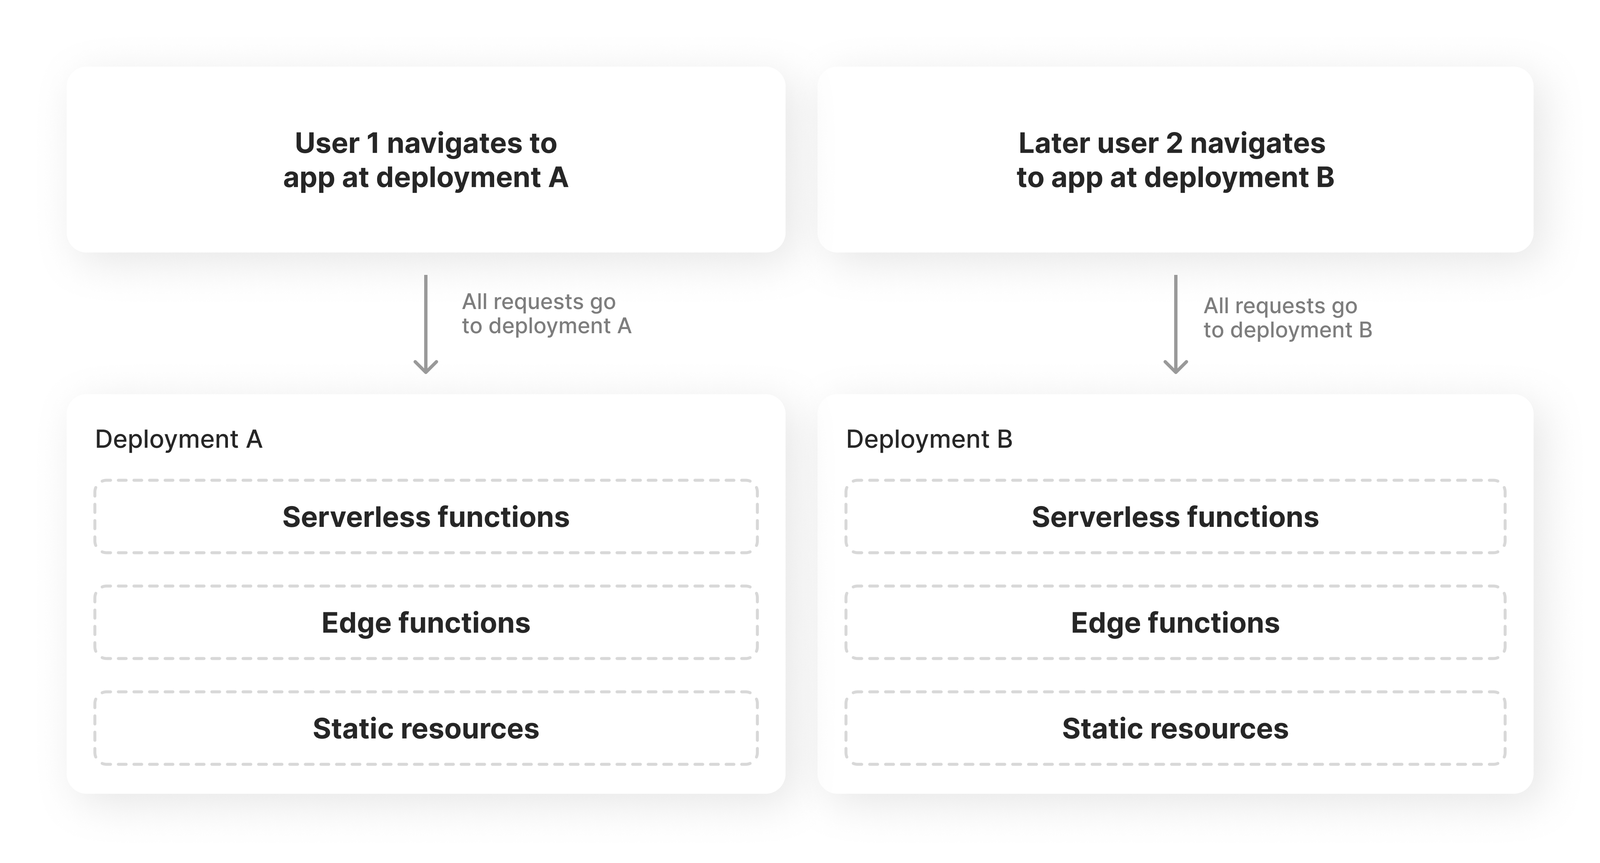
Pro와 Enterprise 요금제에서 쓸 수 있고, 고정 기간(Maximum Age)은 기본 1일이며, Next.js 14.1.4 이상은 추가 설정이 필요 없습니다. 다만 프레임워크가 관리하는 요청에만 배포 ID를 붙이므로, 개발자가 직접 짠 fetch()는 자동으로 고정되지 않습니다(Skew Protection, Vercel Docs, 2026-09-16). API 호출을 직접 짰다면 그 호출은 여전히 새 서버로 갈 여지가 남습니다.
셀프 호스팅이라면 Next.js의 deploymentId 설정으로 배포 ID를 자산과 내비게이션 요청에 붙이고, 클라이언트와 서버의 ID가 다르면 Next.js가 hard navigation으로 새 페이지를 받아 옵니다. 함정은 문서의 한 문장에 있습니다. Next.js는 들어오는 요청의 ?dpl= 값을 읽지 않으므로, 그 값을 보고 옛 배포로 보내는 일은 호스트나 CDN이 맡아야 합니다(deploymentId, Next.js Docs, 2026-08-25). 설정만 켜면 버전 불일치를 감지해 새로고침할 뿐, 옛 버전을 계속 서비스하지는 않는다는 뜻입니다. 카카오페이도 같은 문제를 풀려고 사내 배포 시스템에 Sticky Session 기능을 추가했지만, 그것만으로 버전 스큐를 완전히 해결할 수는 없다고 적었습니다(카카오페이 기술블로그).
청크 로드 실패를 처리합니다
Vite는 동적 import가 실패하면 vite:preloadError 이벤트를 내보내고, 문서 예제는 이때 페이지를 새로고침합니다(Vite). 최근 한 달 GitHub에 올라온 여러 수정은 이 처방에 안전장치를 더했습니다. 새로고침 전에 오류를 먼저 보고하고, sessionStorage에 기록을 남겨 무한 새로고침을 막고, 오프라인이면 새로고침하지 않습니다(Robbie-Palmer/hq #1759). 아래는 그 패턴을 줄인 설명용 예시입니다.
// 설명용 예시: 동적 import 실패 시 1분에 한 번만 새로고침한다
const RELOAD_KEY = "chunk-reload-at";

window.addEventListener("vite:preloadError", (event) => {
  reportChunkError(event); // 1. 새로고침 전에 오류부터 보고한다 (수집 함수는 각자 구현)

  if (!navigator.onLine) return; // 2. 명백한 오프라인이면 새로고침해도 소용없다

  try {
    const last = Number(sessionStorage.getItem(RELOAD_KEY) ?? 0);
    if (Date.now() - last < 60_000) return; // 3. 1분 안에 이미 새로고침했다면 멈춘다
    sessionStorage.setItem(RELOAD_KEY, String(Date.now()));
  } catch {
    return; // 저장소를 막은 웹뷰에서는 무한 새로고침을 피하려고 새로고침하지 않는다
  }
  window.location.reload();
});
여기서 navigator.onLine 검사는 명백한 오프라인만 거르는 용도입니다. 한 국내 개발자가 정리했듯 이 값이 true여도 API 서버까지 닿는다는 보장은 없습니다(네이버 블로그 kinhyo_-, 2026-09-10).
새로고침이 통하지 않는 경우도 있습니다
하지만 "한 번 새로고침"은 웹뷰와 상태를 가진 화면에서 자주 통하지 않습니다. 우아한형제들의 배민 주문접수 웹뷰 팀은 네트워크가 끊겼다 돌아온 뒤에도 화면 이동마다 오류가 나는 문제를 추적하다, 브라우저의 모듈 맵이 import() 실패까지 기억한다는 사실을 확인했습니다. 한 번 실패한 모듈은 다시 import()를 불러도 네트워크 요청조차 보내지 않았고, 영업 시간 내내 켜 두는 웹뷰라 새로고침도 쓸 수 없었습니다. 팀은 import() 전에 fetch()로 연결을 먼저 확인하고, 부팅 직후 주요 화면을 미리 불러 두고, React.lazy 직접 사용을 린트로 막는 방식으로 풀었습니다(집 나간 네트워크는 돌아왔는데 React.lazy는 왜 안 돌아올까, 우아한형제들 기술블로그, 2026-09-15). 글은 "실패한 뒤에 복구할 방법을 찾을 것이 아니라, 실패가 기록되는 상황을 처음부터 만들지 않아야 했습니다"라고 결론 냈습니다. 실패를 캐시하지 않도록 바꾸는 HTML 스펙 개정(whatwg/html#10327)은 2026년 7월 15일 머지됐지만, 글을 쓴 시점의 최신 크롬에서도 여전히 재현됐다고 합니다.
카카오페이의 결론은 더 근본적입니다. 충전 결과를 SessionStorage에 저장하도록 바꾼 뒤 이렇게 정리했습니다. "돌이켜보면 장애의 실제 원인도 Version Skew나 새로고침이 아니라 새로고침 했을 때 상태가 유지되지 않는 애플리케이션 구조였기 때문입니다."(카카오페이 기술블로그) 새로고침은 언제든 일어납니다. 사용자가 누르기도 하고, Next.js가 버전 불일치를 감지해 하기도 하고, 우리가 넣은 청크 오류 처리기가 하기도 합니다. 그러니 결과 화면에 필요한 상태는 메모리가 아니라 URL, sessionStorage, 서버 가운데 하나에 두어야 합니다.
모든 ChunkLoadError가 배포 탓도 아닙니다. 한 PR은 모바일 Safari의 짧은 네트워크 끊김에서도 같은 오류가 나자, 바로 새로고침하지 않고 500ms, 1초 간격으로 두 번 재시도한 뒤에 새로고침으로 넘어가게 바꿨습니다(ElusiveMonni/monni_docs #5). 오류 이름만 보고 원인을 단정하기보다, 배포 시각과 오류가 늘어난 시각을 겹쳐 보는 것이 먼저입니다.
새 버전은 조금씩 내보냅니다
토스페이먼츠는 결제 SDK처럼 모든 가맹점에 동시에 퍼지는 정적 자원에도 카나리 배포를 적용했습니다. 조건이 까다로웠습니다. 응답은 CDN 캐시로 나가야 했고 캐시 적중률은 99% 이상이어야 했습니다. 그래서 CloudFront가 주는 JA3 지문을 0~9의 코호트 헤더로 줄여 캐시 키로 쓰고, 쿠키로 사용자의 버전을 고정했습니다(프론트엔드 배포 시스템의 진화 (1), 토스 기술블로그, 2024-03-05). 정적 자원도 점진 배포와 즉시 롤백이 된다는 국내 사례입니다.
플랫폼 기능으로는 Vercel Rolling Releases가 있습니다. 예를 들어 트래픽의 5%를 새 배포로 보내고 단계를 올리며, 마지막 단계는 반드시 100%여야 합니다. Vercel은 이 기능을 Skew Protection과 함께 쓰라고 권합니다(Rolling Releases, Vercel Docs, 2026-09-15). 점진 배포는 두 버전이 공존하는 시간을 일부러 늘리는 일이라, 버전 고정 없이 쓰면 카카오페이가 겪은 문제를 스스로 만드는 셈입니다. Cloudflare Workers도 버전 사이에 트래픽을 퍼센트로 나누는 gradual deployments를 제공하고(Gradual deployments, Cloudflare Docs), Azure는 Front Door 장애 뒤 재발 방지책으로 단계적 설정 배포의 bake time을 늘렸습니다. 코드든 설정이든 한 번에 전부 내보내지 않는다는 것이 공통 교훈입니다.
방어선 4. 클라이언트가 장애를 키우지 않게 합니다
클라이언트 쪽 방어의 순서는 타임아웃, 지터를 넣은 재시도, 재시도 예산, 서킷 브레이커입니다. 그리고 쓰기 요청은 멱등 키 없이 재시도하지 않습니다. 출발점은 타임아웃입니다. 브라우저의 AbortSignal.timeout()을 쓰면 정해진 시간이 지난 요청을 TimeoutError로 끊을 수 있고, 2024년 4월부터 Baseline에 들어간 기능입니다(AbortSignal.timeout(), MDN). "Down Is Kind, Slow Is Fatal"이라는 dev.to 글은 빠르게 거절되는 장애보다 30초씩 걸리는 응답이 더 위험하다고 설명합니다(Down Is Kind, Slow Is Fatal, dev.to). 기다리는 동안 사용자는 버튼을 다시 누르고, 그 요청이 또 쌓입니다.
재시도는 공짜가 아닙니다. AWS Builders' Library의 마크 브루커는 "Retries are selfish"라고 쓰면서, 5계층이 각각 3회씩 재시도하면 맨 아래 데이터베이스의 부하가 243배가 된다고 설명했습니다(Timeouts, retries, and backoff with jitter, AWS Builders' Library). 아래 차트는 계층이 하나 늘 때마다 부하 배수가 3배, 9배, 27배, 81배, 243배로 커지는 모습입니다.
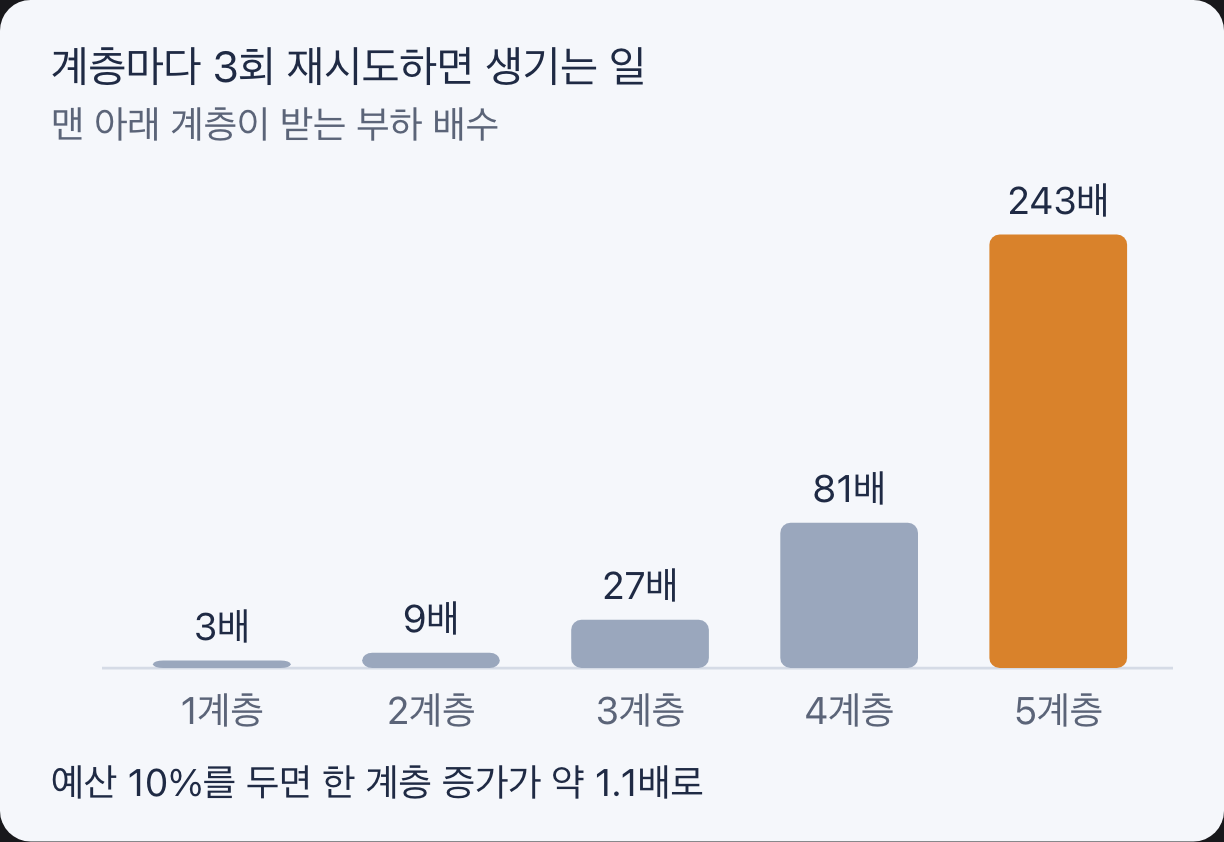
프론트엔드는 이 사슬의 맨 앞에 있습니다. 브라우저의 재시도 세 번이 BFF, API 게이트웨이, 서비스 계층의 재시도와 곱해지면, 네 계층이면 사용자의 클릭 한 번이 맨 아래에서 81번, 데이터베이스까지 다섯 계층이면 243번의 요청이 됩니다. 앞에서 본 Cloudflare 대시보드 그래프에서 성공률이 0%일 때 요청이 두 배로 뛴 것도, 실패한 요청이 다시 돌아온다는 같은 원리입니다.
재시도를 한다면 지수 백오프에 지터를 넣습니다. 대기 시간을 1초, 2초, 4초로 늘리기만 하면 같은 순간 실패한 클라이언트들이 같은 순간 다시 돌아옵니다. 0부터 상한 사이에서 무작위로 고르는 full jitter는 그 동기화된 파도를 흩어 놓습니다(Exponential Backoff And Jitter, AWS Architecture Blog, 2015-03-04). TanStack Query의 기본값을 보면 이 점이 중요해집니다. 클라이언트에서 쿼리는 기본 3회 재시도하고, 지연은 Math.min(1000 * 2 ** attemptIndex, 30000)입니다(Query Retries, TanStack Query Docs). 필자가 읽기로는 이 식에 무작위 요소가 없어서, 큰 장애 때 같은 시각에 실패한 브라우저들이 같은 간격으로 다시 요청하게 됩니다. 지터는 설정 한 줄로 넣습니다.
// 설명용 예시: TanStack Query 기본 지연에 full jitter를 더한다
const queryClient = new QueryClient({
  defaultOptions: {
    queries: {
      retry: 2, // 기본 3회에서 하나 줄였다
      retryDelay: (attemptIndex) =>
        Math.random() * Math.min(1000 * 2 ** attemptIndex, 30000),
    },
  },
});
횟수 제한만으로는 부족하고 예산이 필요합니다. Google SRE 책은 요청당 최대 3회로 제한하되, 클라이언트 전체 요청 가운데 재시도 비율이 10% 미만일 때만 재시도하게 하면 부하 증가가 3배 가까이에서 1.1배로 줄어든다고 설명합니다(Handling Overload, Google SRE Book, 2016). Uber는 2026년 9월, 홉마다 10% 재시도 예산을 두고 오류를 일으킨 서비스만 재시도하게 하는 x-uber-error-claim 헤더를 더해 2025년 11월 18일 장애 중 불필요한 요청 950만 건을 막았다고 밝혔습니다. 재시도 폭주가 번지는 범위도 최대 25홉에서 3홉으로 줄었습니다(Protecting against retry storms, Uber 블로그, 2026-09-17). 브라우저에서도 최근 1분 동안의 재시도 비율을 메모리에 세다가 기준을 넘으면 재시도를 멈추는 정도는 간단히 구현됩니다.
쓰기 요청은 다르게 다룹니다. TanStack Query는 mutation을 기본으로 재시도하지 않습니다(Mutations, TanStack Query Docs). 결제나 주문 생성 같은 POST를 무조건 재시도하면 같은 작업이 두 번 처리될 수 있다는 점은 국내 개발자 블로그에서도 실전 주의점으로 꼽힙니다(네이버 블로그 kinhyo_-). 꼭 재시도해야 한다면 멱등 키를 씁니다. Stripe는 Idempotency-Key 헤더에 V4 UUID를 권하고(최대 255자), 같은 키로 온 요청에는 500 오류를 포함한 첫 결과를 그대로 돌려주며, 24시간이 지난 키는 정리될 수 있다고 안내합니다(Idempotent requests, Stripe Docs). 키는 사용자가 결제 버튼을 누른 순간 한 번 만들고, 재시도할 때 같은 키를 다시 보냅니다.
서버가 보내는 신호도 따릅니다. Microsoft의 Retry Storm 안티패턴 문서는 잦은 클라이언트 재시도가 서비스 복구를 막는다고 경고하며, 400 응답은 재시도하지 말고 Retry-After 헤더를 존중하라고 권합니다(Retry Storm antipattern, Microsoft Learn, 2025-07-16). 아래는 지금까지의 원칙을 묶은 설명용 예시입니다. 읽기 요청만 재시도하고, 매 시도에 타임아웃을 걸고, full jitter로 기다리며, 429나 503이 Retry-After를 주면 그 값을 따릅니다.
// 설명용 예시: 읽기 요청만, 최대 3회, full jitter, Retry-After 존중
const RETRYABLE = new Set([429, 502, 503, 504]);
const sleep = (ms: number) => new Promise((r) => setTimeout(r, ms));

function backoff(attempt: number, res?: Response): number {
  const retryAfter = Number(res?.headers.get("Retry-After"));
  if ((res?.status === 429 || res?.status === 503) && retryAfter > 0) {
    return Math.min(retryAfter * 1000, 10_000); // 서버가 정한 대기를 따르되 화면이 오래 멈추지 않게 상한을 둔다
  }
  return Math.random() * Math.min(10_000, 500 * 2 ** attempt); // full jitter
}

export async function fetchWithRetry(url: string, init: RequestInit = {}, maxAttempts = 3) {
  const method = (init.method ?? "GET").toUpperCase();
  const canRetry = method === "GET" || method === "HEAD"; // 쓰기 요청은 재시도하지 않는다

  for (let attempt = 1; ; attempt++) {
    const timeout = AbortSignal.timeout(5_000);
    // AbortSignal.any는 timeout보다 늦게 지원됐다. 오래된 웹뷰를 지원한다면 분기를 둔다
    const signal = init.signal ? AbortSignal.any([init.signal, timeout]) : timeout;
    try {
      const res = await fetch(url, { ...init, signal });
      if (!canRetry || !RETRYABLE.has(res.status) || attempt >= maxAttempts) return res;
      await res.body?.cancel(); // 버릴 응답 본문을 정리한다
      await sleep(backoff(attempt, res));
    } catch (err) {
      if (!canRetry || attempt >= maxAttempts || init.signal?.aborted) throw err; // 사용자가 취소한 요청은 다시 보내지 않는다
      await sleep(backoff(attempt));
    }
  }
}
이 예시의 5초 타임아웃은 응답 본문을 읽는 동안에도 걸려 있으니, 큰 응답을 늦게 읽는 호출부라면 본문까지 읽은 뒤 반환하도록 바꿉니다.
마지막 장치는 서킷 브레이커입니다. 실패가 이어지는 의존성을 잠시 부르지 않고 바로 대체 화면을 보여 주는 장치로, 마틴 파울러가 정리한 상태 전이는 단순합니다.
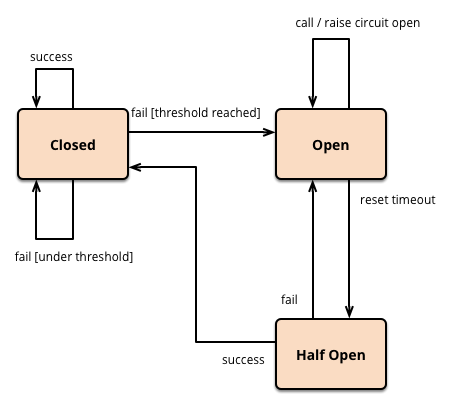
프론트엔드에서는 추천이나 리뷰처럼 부가 기능 API가 연달아 실패할 때 한동안 호출을 멈추고 빈자리를 보여 주는 용도로 씁니다(CircuitBreaker, Martin Fowler, 2014-03-06). 다만 반대 방향의 실패도 있습니다. dev.to에는 4분 만에 복구된 파트너 API를 서킷 브레이커가 3시간 동안 막아 버렸다는 경험담이 올라왔습니다(The partner recovered in four minutes and our circuit breaker kept them out for three hours, dev.to). 회로를 여는 조건만큼, 다시 닫는 조건과 시간도 신중하게 정해야 합니다.
방어선 5. 부분 실패를 화면 단위로 가둡니다
화면 하나가 여러 의존성을 부를 때, 하나의 실패가 화면 전체를 끌고 내려가지 않게 칸막이를 칩니다. 배의 격벽처럼 자원을 나눠 실패를 가두는 bulkhead 개념을 화면에 옮기면, 섹션마다 따로 실패하게 만드는 일이 됩니다. React에서는 Error Boundary가 그 칸막이입니다. 다만 Error Boundary가 잡지 못하는 것도 분명합니다. 이벤트 핸들러, 비동기 코드, 서버 렌더링, 그리고 자기 자신에서 난 오류입니다. 아직 함수 컴포넌트로 작성할 방법이 없어 react.dev는 react-error-boundary 패키지를 권합니다(Component, react.dev).
설계 원칙은 핵심 여정과 부가 기능을 나누는 것입니다. 결제 화면에서 추천 상품이 죽으면 추천 영역만 비우고 결제 버튼은 그대로 둡니다. 주의할 점은 데이터 요청 실패가 대개 비동기 오류라는 것입니다. useEffect 안의 fetch가 실패해도 Error Boundary는 움직이지 않으므로, react-error-boundary의 showBoundary, TanStack Query의 throwOnError, Suspense 기반 데이터 로딩처럼 오류를 렌더 단계로 끌어올리는 방법을 함께 써야 칸막이가 동작합니다. 설명용 예시로 보면 다음과 같습니다.
// 설명용 예시: 추천 영역이 죽어도 결제 버튼은 남는다
import { ErrorBoundary } from "react-error-boundary";

export function CheckoutPage() {
  return (
    <main>
      <OrderSummary />
      <PayButton />
      <ErrorBoundary fallback={null} onError={reportToMonitoring /* 수집 함수는 각자 구현 */}>
        <Recommendations />
      </ErrorBoundary>
    </main>
  );
}
칸막이가 가장 필요한 곳은 서드파티 스크립트입니다. 스티브 사우더스는 2010년에 이미 스크립트와 스타일시트를 보통 방식으로 넣으면 사이트 전체를 내리는 프론트엔드 단일 장애점(SPOF)이 된다고 지적했습니다(Frontend SPOF, Steve Souders, 2010-06-01). async나 defer가 해결책처럼 보이지만, web.dev는 서드파티 서버가 느리면 async나 defer로 넣어도 onload를 막을 수 있다고 적습니다(Load Third-Party JavaScript, web.dev). 앱에서는 SDK가 같은 자리에 있습니다. 앞에서 본 Firebase 장애처럼 번들에 넣은 SDK는 내 코드와 같은 프로세스에서 돌기 때문에, 그 SDK의 오류가 곧 내 앱의 오류가 됩니다. 서드파티 목록을 만들고, 각각이 실패했을 때 화면이 어떻게 되는지 한 번씩 막아 보는 것이 시작입니다.
실패한 기능을 끄는 스위치도 미리 만들어 둡니다. OpenFeature 명세는 플래그 평가가 예외를 던지면 안 되고, 비정상 상황에서는 항상 기본값을 돌려줘야 한다고 정합니다(요구사항 1.4.10)(Flag Evaluation, OpenFeature 명세). 플래그 서비스가 죽어도 화면은 기본값으로 떠야 한다는 뜻입니다. 그런데 킬 스위치도 코드 경로입니다. 앞에서 본 Cloudflare 12월 5일 장애는 보안 대응 설정을 킬 스위치로 처음 적용한 경로에서 났습니다(Cloudflare). 평소에 한 번도 눌러 보지 않은 스위치는, 장애 날 처음 눌러 보는 스위치입니다.
네트워크 자체가 불안할 때는 서비스 워커가 마지막 칸막이가 됩니다. Workbox의 Network First 전략은 먼저 네트워크에 요청하고, 실패하면 캐시에서 응답합니다.
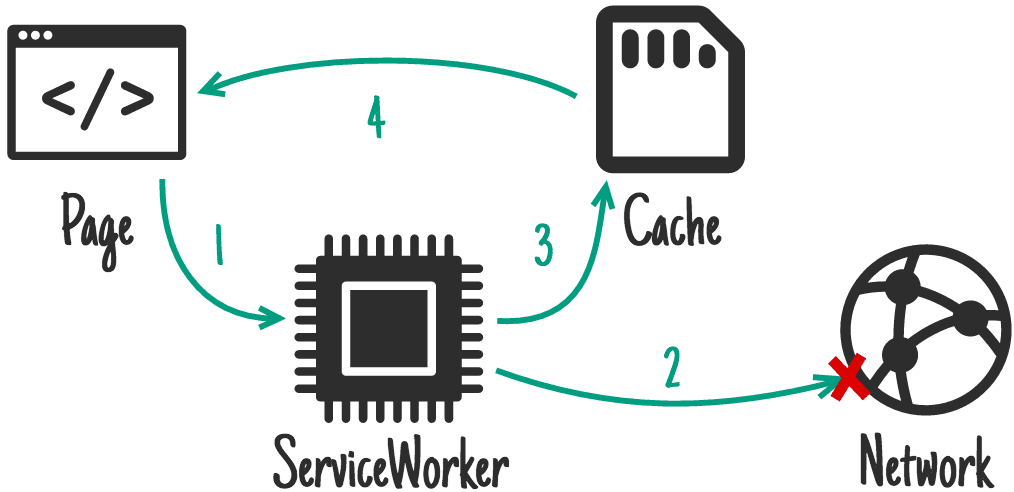
Network First에는 networkTimeoutSeconds 옵션이 있으니 네트워크가 느린 경우의 대기도 함께 설계합니다(workbox-strategies, Chrome for Developers). 캐시와 네트워크가 모두 실패하면 "오프라인이라 지금은 볼 수 없다"는 대체 페이지를 주는 generic fallback도 함께 둡니다(The Offline Cookbook, web.dev). 다만 국내 환경에서는 조건이 붙습니다. 앞의 velog 개발자는 웹뷰마다 서비스 워커 지원 범위가 달라 일부 기기에서는 완벽하게 동작하지 않았다고 적었습니다(velog jeon-yj). 최근 한 GitHub PR은 서비스 워커의 activate 핸들러가 현재 빌드 캐시만 남기고 모두 지우는 바람에 열려 있던 탭의 이전 청크까지 날렸다고 보고했습니다(molti-tasking/voice-workspaces #28). 서비스 워커는 버전 스큐를 막을 수도, 키울 수도 있는 도구입니다.
가장 오래된 방어선은 HTML 자체입니다. GOV.UK 서비스 매뉴얼은 JavaScript 계층에는 내결함성이 없다며, 핵심 기능은 HTML만으로 동작해야 한다고 권합니다(Building a resilient frontend using progressive enhancement, GOV.UK, 2024-09-27). 모든 서비스가 정부 서비스처럼 만들 필요는 없지만, 로그인과 결제 폼이 JS 번들 하나에 전부 기대고 있는지는 점검할 만합니다.
방어선 6. 서버가 아니라 사용자 쪽에서 잽니다
상태 페이지와 서버 지표가 초록이어도 사용자는 깨질 수 있으니, 가용성은 브라우저와 앱에서 잽니다. Firebase 사후 분석은 iOS SDK 장애 동안 Firebase와 Google Ads 상태 대시보드가 초록색을 유지했다고 인정했습니다. 대시보드가 서버 쪽 헬스 지표 위주로 구성돼 있었기 때문이고, 재발 방지책으로 SDK 장애 데이터를 대시보드에 통합하겠다고 밝혔습니다(Firebase). "상태 페이지는 초록인데 사용자는 깨진다"는 최근 30일 커뮤니티에서 가장 여러 곳에서 반복된 불만이기도 합니다. Hacker News의 Claude 장애 스레드에는 500이 계속 나는데 상태 페이지는 초록이었다는 댓글이 달렸고(Hacker News, 2026-09-29), dev.to에서는 같은 Firebase 장애를 상태 페이지 관점에서 분석한 글이 나왔습니다(The status page was green while apps crashed, dev.to).
그래서 프론트엔드는 자기 지표를 따로 모읍니다. 실사용자 모니터링(RUM)으로 핵심 여정의 성공률을 재고, Error Boundary, window.onerror, unhandledrejection으로 클라이언트 오류를 수집 서버로 보냅니다. 오리진에 닿지도 못한 실패는 서버 로그에 남지 않으므로, 브라우저가 DNS, TCP, HTTP 실패를 별도 엔드포인트로 보고하게 하는 Network Error Logging(NEL)도 살펴볼 만합니다. 다만 MDN은 NEL을 실험적 기능으로 분류합니다(Network Error Logging, MDN). Splunk가 말한 초록 대시보드 문제에 대한 직접적인 답이 이쪽입니다.
모니터링을 붙였다고 장애가 보이는 것은 아닙니다. 우아한형제들 프론트엔드 팀은 장애가 고객센터를 통해 먼저 보고되는 일을 겪고 원인을 찾았습니다. Sentry의 수집량 제한 때문에 에러 로그의 80%가 유실되고 있었고, 제한에 걸리면 수집되는 에러 수가 늘 일정하게 유지되어 평소와 장애를 구분할 수 없었습니다(선제적 장애 대응을 위한 Sentry 최적화 적용기, 우아한형제들 기술블로그, 2025-04-08). 카카오메이커스도 비슷한 문장을 남겼습니다. 카카오톡 채널 메시지를 대량 발송한 직후 SSR 서버가 응답 불능에 빠졌는데, "503 오류가 발생하고 있었지만, 모니터링 지표는 멀쩡했습니다." 팀은 ISR과 Redis 외부 캐시로 구조를 바꾸고, OS 수준 지표만으로는 보이지 않던 Node.js 서버의 지표를 따로 수집했습니다(SSR 지옥 탈출기 1편, 카카오 기술블로그, 2025-09-09, SSR 지옥 탈출기 2편, 카카오 기술블로그, 2025-09-09). 메시지 발송이 곧 트래픽 급증이 되는 국내 서비스 구조에서 자주 볼 장면입니다.
예고된 피크는 관측과 설계를 함께 시험합니다. 2026년 9월 11일 대입 수시 원서접수 마감 10분 전인 오후 5시 50분께 접수 시스템에 접속 오류가 나 약 30분 이어졌고, 접수 시간이 1시간 연장됐습니다. 원인은 보안 관리 시스템을 업그레이드한 뒤 생긴 버그였고, 트래픽은 전년보다 약 30% 늘었습니다(한국경제, 2026-09-14, 연합뉴스, 2026-09-14). 한국일보는 사고 직전 모의훈련에 부하 시험이 빠져 있었고, 훈련한 시스템과 실제 접수에 쓰인 시스템이 서로 달랐다고 단독 보도했습니다(한국일보, 2026-10-04). 날짜가 정해진 피크라면 프론트엔드가 맡을 일이 분명합니다. 몰릴 때는 대기열 화면으로 순서를 보여 주고, 입력한 내용은 브라우저에 보존해 오류 뒤에 다시 쓰지 않게 하고, 제출은 멱등 키로 한 번만 처리되게 하고, 마지막에 접수가 정말 끝났는지 확인하는 화면을 따로 둡니다.
방어선 7. 장애를 알릴 길은 다른 인프라에 둡니다
장애 공지 채널이 장애 난 인프라 위에 있으면, 가장 필요한 순간에 같이 사라집니다. 고전적인 사례는 2017년 2월 28일 AWS S3 장애입니다. AWS는 상태 대시보드의 관리 콘솔이 S3에 의존하고 있어서 오전 11시 37분(PST)까지 서비스별 상태를 갱신하지 못했다고 밝혔습니다(Summary of the Amazon S3 Service Disruption, AWS, 2017-03). 2025년 11월 18일 Cloudflare는 다른 방향으로 혼란을 겪었습니다. 상태 페이지를 Cloudflare 인프라와 완전히 분리해 두었는데도 같은 시각에 우연히 오류가 나서, 처음에는 공격을 의심했습니다(Cloudflare). 분리는 출발점이고, 분리된 채널이 동시에 흔들릴 때 무엇을 믿을지도 정해 둬야 합니다.
국내 사례는 더 직접적입니다. 국정자원 화재로 대국민 온라인 서비스 436개가 멈추고 정부24도 마비되자, 행정안전부는 대국민 안내문을 네이버와 다음의 공지사항으로 게재했습니다(이데일리, 2025-09-28). 피해 규모 파악도 같은 이유로 늦어졌습니다. 정부는 처음에 647개 시스템이 중단됐다고 밝혔다가, 관리 시스템 nTOPS를 복구한 뒤 전체 목록을 확인하고 709개로 정정했습니다(아주경제, 2025-10-09). 카카오도 2022년 판교 데이터센터 화재로 전체 서버의 약 34%가 영향을 받았을 때 모니터링 도구가 마비됐고, 앱 배포 도구는 판교 안에서만 이중화돼 있어 전면 장애가 났다고 밝혔습니다(우리의 재발 방지 계획, 카카오, 2022-12). 장애를 알릴 도구, 파악할 도구, 고칠 도구가 장애와 같은 곳에 있었던 셈입니다.
실무 제안은 세 가지입니다. 상태 페이지는 본 서비스와 다른 도메인, 다른 CDN에 둡니다. 점검 페이지와 장애 안내 페이지는 장애가 난 뒤에 만들지 말고 정적 파일로 미리 배포해 두어, 방어선 2의 폴백 경로로 바로 띄울 수 있게 합니다. 앱 안의 공지 배너는 원격 설정으로 내려받되, 원격 설정 호출이 실패해도 기본 안내가 뜨도록 기본값을 앱에 넣어 둡니다. OpenFeature가 기본값 반환을 의무로 둔 것과 같은 이유입니다.
어디서부터 시작할까요: 체크리스트
작은 팀이라면 비용이 작은 것부터 아래 순서대로 하나씩 하면 됩니다. 멀티 CDN이나 멀티 클라우드는 이 표에 없습니다. 일곱 줄을 다 해 본 뒤에 고민해도 늦지 않습니다.
| 방어선 | 이번 주에 할 일 | 확인 방법 |
|---|---|---|
| 1. 캐시 | 해시 자산에 immutable 장기 캐시, HTML에 no-cache를 따로 붙인다 |
배포 뒤 curl -I로 HTML과 JS의 Cache-Control을 각각 본다 |
| 3. 배포 | 배포 스크립트에서 삭제 단계를 빼고, 새 청크를 먼저 올린 뒤 HTML을 마지막에 올린다 | 옛 탭을 열어 둔 채 배포하고 화면 이동이 되는지 본다 |
| 4. 재시도 | GET에만 재시도를 허용하고 지터를 넣는다. POST에는 멱등 키를 붙인다 | 스테이징에서 API를 503으로 만들고 네트워크 탭에서 요청 간격이 흩어지는지 본다 |
| 5. 격리 | 부가 기능 섹션마다 Error Boundary를 두고 서드파티 스크립트 목록을 만든다 | 추천 API를 막았을 때 추천 영역만 비고 결제 버튼이 남는지 본다(비동기 오류가 경계까지 올라오는지 함께 확인) |
| 6. 관측 | 클라이언트 오류 수집을 켜고 수집량 제한에 걸리는지 확인한다 | 핵심 여정 성공률을 서버 지표와 나란히 놓고 비교한다 |
| 7. 공지 | 상태 페이지와 정적 점검 페이지를 다른 도메인과 다른 CDN에 둔다 | 본 서비스 도메인을 끈 상태에서 공지가 뜨는지 본다 |
| 2. 페일오버 | 2차 오리진과 짧은 타임아웃을 설정하고 1차를 일부러 끊어 본다 | 전환에 걸린 시간을 재고, 기본 30초를 그대로 쓰고 있지 않은지 본다 |
표의 순서는 방어선 번호가 아니라 비용 기준입니다. 캐시 헤더와 배포 순서는 설정과 스크립트 몇 줄로 끝나고, 재시도와 격리는 공통 모듈 하나와 컴포넌트 몇 개로 시작합니다. 페일오버는 인프라를 건드리니 마지막에 두었습니다. 가장 중요한 열은 "확인 방법"입니다. 어느 줄이든 평일 낮에 한 번 실제로 끊어 보고 결과를 기록하는 것이, 이중화는 넘겨 봐야 이중화라는 원칙을 실천하는 방법입니다.
방어 장치도 장애가 됩니다
지금까지의 장치는 모두 새로운 코드 경로이고, 새로운 코드 경로는 새로운 장애 지점입니다. Cloudflare 12월 5일 장애는 보안 대응 설정을 킬 스위치로 처음 적용한 경로에서 났습니다. 4분 만에 복구된 파트너를 3시간 막은 서킷 브레이커, 가드 없이 넣은 청크 오류 처리기가 부르는 무한 새로고침, 활성화 단계에서 옛 캐시를 지워 열린 탭을 깨뜨린 서비스 워커도 모두 방어하려고 넣은 코드가 일으킨 문제입니다. Cloudflare 11월 18일 사후 분석에서 내부에서 만든 설정 파일도 사용자 입력처럼 검증하겠다고 한 대목에, 긱뉴스의 한 국내 개발자는 "유저의 입력값은 오만가지 검증을 다 적용하면서 내부에서 만들어낸 크리티컬 데이터는 사실 이렇게까지 검증하지는 않지요"라는 댓글을 달았습니다(긱뉴스, 2025-11-18). 방어 장치의 설정과 경로도 같은 수준으로 검증해야 합니다.
비용도 있습니다. 멀티 CDN과 멀티 클라우드는 LY의 사례처럼 관측 체계를 다시 짜야 하고, 작은 팀에게는 현실적이지 않다는 경험담도 있습니다. 국내에서는 CDN 사업자를 서비스 안정성 의무 대상에 넣는 전기통신사업법 개정안이 2026년 4월 28일 발의됐지만, 이 글을 쓰는 시점에 통과 여부는 확인하지 못했습니다(뉴시스, 2026-04-28). 규제가 생기더라도 CDN 장애 때 내 화면이 어떻게 행동할지는 여전히 내가 정해야 합니다.
그래서 결론은 장치를 늘리는 것이 아니라 실패 모드를 정하는 것입니다. Cloudflare가 정리한 세 가지를 필자 식으로 프론트엔드에 옮기면 이렇습니다. fail stale은 오래된 캐시와 마지막 정상 설정이라도 보여 주는 것이고, fail open은 플래그 서비스가 죽어도 기본 기능을 켠 채 두는 것이며, fail close는 결제처럼 틀리면 안 되는 곳에서 확실히 멈추고 안내하는 것입니다. 화면마다 셋 가운데 무엇을 고를지 정하고, 정한 대로 동작하는지 평소에 훈련합니다.
이 글의 자료를 고른 방법
이 글은 2026년 10월 7일에 확인한 자료로 썼습니다. 장애의 시각과 원인은 AWS, Cloudflare, Azure, Google Cloud, Firebase, 37signals의 공식 사후 분석을 기준으로 했고, 기법은 MDN, web.dev, RFC, 각 벤더의 공식 문서를 직접 열어 확인했습니다. 영어 원문은 "worst outage since 2019", "fail stale", "Retries are selfish" 같은 짧은 표현만 원어로 두고 나머지는 한국어로 옮겼습니다.
원문을 열지 못한 자료는 2차 출처를 밝혔습니다. 2026년 7월 CloudFront VPC Origins 장애는 AWS 상태 페이지 원문을 읽지 못해 classmethod의 로그 분석 수치만 쓰고 시작 시각은 적지 않았습니다. 2026년 5월 AWS us-east-1 가용 영역의 열 이벤트, 2026년 3월 중동 AWS 데이터센터 피해, 2026년 Vercel 장애, 멀티 CDN 운영 수치는 1차 출처를 찾지 못해 뺐습니다. Firebase 장애의 크래시 배수나 추가 지속 시간처럼 커뮤니티에 돈 숫자도 공식 사후 분석에서 확인되지 않아 쓰지 않았습니다. 2025년 10월 AWS 장애는 국내 매체마다 복구 시간과 원인 서술이 달라 국내 매체의 숫자 대신 AWS 공식 요약을 따랐습니다.
국내 기업 기술 블로그(우아한형제들, 카카오페이, 토스, 카카오)와 LY의 한국어 기술블로그는 그 회사가 밝힌 자기 사례로 소개했습니다. 개인 블로그와 커뮤니티 글(velog, 티스토리, 네이버 블로그, 긱뉴스)은 개인 경험으로만 썼고 숫자의 근거로 쓰지 않았습니다. 국정자원 관련 수치는 감사원 감사 결과를 인용한 디지털데일리 보도와 정부 브리핑 기반 보도에서 가져왔습니다.
최근 30일(2026-09-07~10-07)의 Hacker News, dev.to, GitHub 토론은 따로 모아 실무자 목소리로만 썼습니다. 본문에 인용한 글, 스레드, 이슈는 2026년 10월 7일에 원문을 직접 열어 확인했고, Reddit은 접속이 403으로 막혀 이번에는 빠졌습니다.
본문 이미지는 Cloudflare, AWS, Vercel, Chrome for Developers, martinfowler.com의 원본 이미지이고, 해당 자료를 소개하려고 인용하면서 캡션에 출처를 달았습니다. 차트 2개는 공식 사후 분석과 AWS Builders' Library의 수치로 직접 만들었습니다.
필자의 한계. 이 글의 수치는 각 회사와 기관이 밝힌 값이고, 필자가 장애를 재현하거나 통제 실험을 하지는 않았습니다. TanStack Query 기본 지연에 지터가 없다는 판단과 fail open, fail close의 프론트엔드 해석은 필자의 해석입니다. 코드는 모두 설명용 예시이며, 실제 서비스에 넣기 전에 각 프레임워크와 CDN의 현재 문서로 다시 확인해야 합니다.
자주 묻는 질문
작은 팀도 멀티 CDN이 필요한가요?
대부분은 아닙니다. 멀티 CDN은 계약보다 관측과 운영이 어렵고, LY처럼 큰 조직도 CDN별 로그를 묶는 통합 모니터링을 따로 만들어야 했습니다. 작은 팀은 캐시 헤더, 정적 폴백 페이지, 재시도 규율, 클라이언트 관측부터 갖추는 편이 현실적입니다. 그다음에 CDN 장애가 매출에 주는 영향을 재 보고 판단해도 늦지 않습니다.
ChunkLoadError가 나면 무조건 새로고침하면 되나요?
첫 대응으로는 괜찮지만 무조건은 아닙니다. 새로고침 전에 오류를 보고하고, sessionStorage로 한 번만 하게 막고, 오프라인이면 하지 않아야 합니다. 웹뷰처럼 새로고침이 어려운 환경이나, 우아한형제들 사례처럼 브라우저가 실패를 기억하는 경우에는 통하지 않습니다. 근본 대책은 이전 청크를 지우지 않는 배포와 새로고침에 견디는 상태 설계입니다.
서비스 워커를 꼭 써야 하나요?
아닙니다. 오프라인 폴백이나 불안정한 네트워크 대응이 필요한 화면이라면 쓸 만하지만, 웹뷰에서는 기기마다 지원이 다르고 캐시 정리를 잘못하면 열린 탭의 옛 청크를 지워 버전 스큐를 키웁니다. 쓴다면 Network First와 타임아웃, 오프라인 폴백 페이지처럼 범위를 좁게 시작합니다. 순서상으로는 HTTP 캐시 헤더를 바르게 두는 일이 먼저입니다.
프론트엔드 SLO는 어떻게 정하나요?
서버 가동률이 아니라 핵심 여정의 성공률로 정합니다. 예를 들어 "결제 시작 대비 결제 완료 화면 도달 비율"을 RUM으로 재고, 결제와 로그인에는 엄격한 목표를, 추천과 배너에는 느슨한 목표를 둡니다. Google SRE 책이 말하듯 사용자의 기기와 네트워크가 이미 실패하는 만큼, 그보다 높은 목표는 체감되지 않습니다. 처음에는 지금 수치를 재는 것부터 시작하고, 몇 주 데이터를 본 뒤 목표를 정합니다.
마치며
프론트엔드의 고가용성을 한 줄로 줄이면 서버를 하나 더 두는 일이 아니라, 무엇이 실패했을 때 화면이 어떻게 행동할지 미리 정하는 일입니다. CDN이 멈추면 캐시로 버티고, 오리진이 죽으면 정해진 시간 안에 넘어가고, 배포 중에는 옛 버전을 지키고, 실패한 요청은 예산 안에서만 다시 보내고, 부가 기능은 조용히 사라지게 하고, 그 모든 것을 사용자 쪽에서 재고, 알릴 길은 따로 둡니다. 지난 1년의 장애 사례들은 이 일곱 자리 가운데 어디서 화면이 무너질 수 있는지를 하나씩 보여 줬습니다.
이번 주에 할 일은 하나입니다. 배포 스크립트를 열어 이전 청크를 지우는 단계가 있는지 보고, 있다면 빼는 것입니다. 그다음에 옛 탭을 하나 열어 둔 채 배포해 보면, 이 글의 방어선 가운데 어디가 비어 있는지 바로 보입니다. 클라우드 한 곳에 서비스를 얹는 선택 자체에 대한 판단은 서버를 이제 AWS에 올리지 않는 이유에서 이어서 읽을 수 있습니다.
sources:auto출처
- What the Fastly Outage Can Teach Us About Observability, Splunk, 2021-06-10: splunk.com/en_us/blog/devops/what-the-fastly-outage-can-teach-us-about-…
- Availability Table, Google SRE Book: sre.google/sre-book/availability-table
- Embracing Risk, Google SRE Book: sre.google/sre-book/embracing-risk
- 연합뉴스, 2026-10-02: yna.co.kr/view/AKR20261002018651530
- 뉴시스, 2026-10-02: newsis.com/view/NISX20261002_0003812254
- Summary of the Amazon DynamoDB Service Disruption, AWS, 2025-10: aws.amazon.com/message/101925
- Azure 사후 분석 YKYN-BWZ, Microsoft, 2025-10: azure.status.microsoft/en-us/status/history/?trackingId=YKYN-BWZ
- Cloudflare outage on November 18, 2025, Cloudflare, 2025-11-18: blog.cloudflare.com/18-november-2025-outage
- 중앙일보, 2025-11: joongang.co.kr/article/25383440
- Cloudflare outage on December 5, 2025, Cloudflare, 2025-12-05: blog.cloudflare.com/5-december-2025-outage
- 천지일보, 2025-12-05: newscj.com/news/articleView.html?idxno=3348649
- 헤럴드경제, 2025-12-05: heraldk.com/article/2025120502485151736
- European CDN concentration, ciphercue, 2026-09: ciphercue.com/blog/european-cdn-concentration-cloudflare-nine-in-ten
- Cloudflare outage on February 20, 2026, Cloudflare, 2026-02-21: blog.cloudflare.com/cloudflare-outage-february-20-2026
- us-west1 인시던트 보고, Google Cloud Service Health, 2026-08: status.cloud.google.com/incidents/utF3FMFdQfwBzJcGG6vf
- Firebase 공식 사후 분석, Firebase Blog, 2026-10: firebase.blog/posts/2026/10/firebase-analytics-outage
- A deep dive into Cloudflare's September 12, 2025 dashboard and API outage, Cloudflare, 2025-09-13: blog.cloudflare.com/deep-dive-into-cloudflares-sept-12-dashboard-and-ap…
- Version skew, Malte Ubl, 2023-06-21: industrialempathy.com/posts/version-skew
- Next.js 트러블슈팅: CORS와 Version Skew 에러 원인부터 해결까지, 카카오페이 기술블로그, 2025-06-04: tech.kakaopay.com/post/nextjs-troubleshooting-cors-version-skew
- velog goon126, 2021-06-17: velog.io/@goon126/청크-에러
- velog heina-effect, 2025-05-09: velog.io/@heina-effect/Vue-Vite-환경에서-배포후-흰화면-발생할-때
- Prevent unnecessary network requests with the HTTP Cache, web.dev: web.dev/articles/http-cache
- 웹 서비스 캐시 똑똑하게 다루기, 토스 기술블로그, 2021-04-29: toss.tech/article/smart-web-service-cache
- RFC 5861, IETF, 2010-05: rfc-editor.org/rfc/rfc5861.html
- Code Orange: Fail Small is complete, Cloudflare, 2026-05-01: blog.cloudflare.com/code-orange-fail-small-complete
- Cache-Control, MDN: developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Cache-Contr…
- Serving stale content, Fastly Docs: fastly.com/documentation/guides/full-site-delivery/performance/serving-…
- Cache-Control, Cloudflare Docs: developers.cloudflare.com/cache/concepts/cache-control
- web.dev: web.dev/articles/stale-while-revalidate
- CDN-Cache-Control, Cloudflare Docs: developers.cloudflare.com/cache/concepts/cdn-cache-control
- velog jeon-yj, 2025-05-18: velog.io/@jeon-yj/트러블-슈팅-HTTP-캐싱
- CloudFront origin failover 문서, Amazon Web Services: docs.aws.amazon.com/AmazonCloudFront/latest/DeveloperGuide/high_availab…
- CloudFront VPC Origin 장애 로그 분석, classmethod, 2026-07: dev.classmethod.jp/ja/articles/cloudfront-vpc-origin-incident-20260716-…
- Vector를 활용해 멀티 CDN 로그 및 트래픽 관리하기, LY 기술블로그, 2023-10-13: techblog.lycorp.co.jp/ko/managing-multi-cdn-logs-traffics-with-vector
- 티스토리 gun22, 2025-11-20: gun22.tistory.com/entry/CLOUDFLARE-장애로-인한-고찰
- 디지털데일리, 2026-09-23: ddaily.co.kr/page/view/2026092315522570971
- 37status, 2026-09-29: 37status.com/incidents/l1yn9n8f21p6
- Building for Production, Vite: vite.dev/guide/build
- bcgov/reserve-rec-public #863: github.com/bcgov/reserve-rec-public/issues/863
- 티스토리 mksm10141015, 2026-08-08: mksm10141015.tistory.com/entry/Nextjs-배포-후-ChunkLoadError가-간헐적으로-발생하는-이…
- Skew Protection, Vercel Docs, 2026-09-16: vercel.com/docs/skew-protection
- deploymentId, Next.js Docs, 2026-08-25: nextjs.org/docs/app/api-reference/config/next-config-js/deploymentId
- Robbie-Palmer/hq #1759: github.com/Robbie-Palmer/hq/pull/1759
- 네이버 블로그 kinhyo_-, 2026-09-10: m.blog.naver.com/kinhyo_-/224407259007
- 집 나간 네트워크는 돌아왔는데 React.lazy는 왜 안 돌아올까, 우아한형제들 기술블로그, 2026-09-15: techblog.woowahan.com/27330
- ElusiveMonni/monni_docs #5: github.com/ElusiveMonni/monni_docs/pull/5
- 프론트엔드 배포 시스템의 진화 (1), 토스 기술블로그, 2024-03-05: toss.tech/article/26057
- Rolling Releases, Vercel Docs, 2026-09-15: vercel.com/docs/rolling-releases
- Gradual deployments, Cloudflare Docs: developers.cloudflare.com/workers/versions-and-deployments/gradual-depl…
- AbortSignal.timeout(), MDN: developer.mozilla.org/en-US/docs/Web/API/AbortSignal/timeout_static
- Down Is Kind, Slow Is Fatal, dev.to: dev.to/lovestaco/down-is-kind-slow-is-fatal-circuit-breakers-and-the-th…
- Timeouts, retries, and backoff with jitter, AWS Builders' Library: builder.aws.com/content/3EumjoZascWd1oZiEgL8ORlv3qE/timeouts-retries-an…
- Handling Overload, Google SRE Book: sre.google/sre-book/handling-overload
- Exponential Backoff And Jitter, AWS Architecture Blog, 2015-03-04: aws.amazon.com/blogs/architecture/exponential-backoff-and-jitter
- Query Retries, TanStack Query Docs: tanstack.com/query/latest/docs/framework/react/guides/query-retries
- Protecting against retry storms, Uber 블로그, 2026-09-17: uber.com/us/en/blog/protecting-against-retry-storms
- Mutations, TanStack Query Docs: tanstack.com/query/latest/docs/framework/react/guides/mutations
- Idempotent requests, Stripe Docs: docs.stripe.com/api/idempotent_requests
- Retry Storm antipattern, Microsoft Learn, 2025-07-16: learn.microsoft.com/en-us/azure/architecture/antipatterns/retry-storm
- CircuitBreaker, Martin Fowler, 2014-03-06: martinfowler.com/bliki/CircuitBreaker.html
- The partner recovered in four minutes and our circuit breaker kept them out for three hours, dev.to: dev.to/sergey_shinder_ab2d943365/the-partner-recovered-in-four-minutes-…
- Component, react.dev: react.dev/reference/react/Component
- Frontend SPOF, Steve Souders, 2010-06-01: stevesouders.com/blog/2010/06/01/frontend-spof
- Load Third-Party JavaScript, web.dev: web.dev/articles/optimizing-content-efficiency-loading-third-party-java…
- Flag Evaluation, OpenFeature 명세: openfeature.dev/specification/sections/flag-evaluation
- workbox-strategies, Chrome for Developers: developer.chrome.com/docs/workbox/modules/workbox-strategies
- The Offline Cookbook, web.dev: web.dev/articles/offline-cookbook
- molti-tasking/voice-workspaces #28: github.com/molti-tasking/voice-workspaces/pull/28
- Building a resilient frontend using progressive enhancement, GOV.UK, 2024-09-27: gov.uk/service-manual/technology/using-progressive-enhancement
- Hacker News, 2026-09-29: news.ycombinator.com/item?id=49893876
- The status page was green while apps crashed, dev.to: dev.to/slabb/the-status-page-was-green-while-apps-crashed-the-postmorte…
- Network Error Logging, MDN: developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Network_Error_Logging
- 선제적 장애 대응을 위한 Sentry 최적화 적용기, 우아한형제들 기술블로그, 2025-04-08: techblog.woowahan.com/21604
- SSR 지옥 탈출기 1편, 카카오 기술블로그, 2025-09-09: tech.kakao.com/posts/743
- SSR 지옥 탈출기 2편, 카카오 기술블로그, 2025-09-09: tech.kakao.com/posts/744
- 한국경제, 2026-09-14: hankyung.com/article/202609144280i
- 연합뉴스, 2026-09-14: yna.co.kr/view/AKR20260914152652530
- 한국일보, 2026-10-04: hankookilbo.com/news/article/A2026100410370004989
- Summary of the Amazon S3 Service Disruption, AWS, 2017-03: aws.amazon.com/message/41926
- 이데일리, 2025-09-28: edaily.co.kr/News/Read?newsId=01177526642304712&mediaCodeNo=257
- 아주경제, 2025-10-09: ajunews.com/view/20251009161337759
- 우리의 재발 방지 계획, 카카오, 2022-12: kakaocorp.com/page/detail/9900
- 긱뉴스, 2025-11-18: news.hada.io/topic?id=24449
- 뉴시스, 2026-04-28: newsis.com/view/NISX20260428_0003610150
글쓴이
주홍철은 네이버 출신 개발자이자 AI 핀테크 스타트업 어비스(AVISS)의 대표입니다. 경제·증시 분석 AI, AI 에이전트, 데이터 파이프라인을 직접 설계하고 개발하며, 『면접을 위한 CS 전공지식 노트』와 『클로드 코드 제대로 시작하기』(길벗)를 썼습니다. 회사 소개는 어비스 홈페이지에, 다른 글은 어비스 블로그에 있으며, 글에 대한 정정 요청이나 문의는 [email protected]으로 보내 주세요.