AI가 코드의 다수를 쓰는 지금 도메인 주도 설계(DDD)가 더 중요해진 이유는 하나입니다. 에이전트는 코드베이스 전체를 이해하지 못하고, 사람이 준 컨텍스트와 코드 구조만큼만 일합니다. Google은 2026년 4월에 신규 코드의 75%가 AI 생성이라고 밝혔고, Anthropic 사내에서는 Claude가 사람 개입 없이 연속으로 내리는 결정의 수가 반년 사이 두 배 넘게 늘었습니다. 그런데 같은 기간의 데이터는 처리량이 오르는 만큼 배포 안정성, 리뷰 시간, 보안 통과율이 나빠졌다고 말합니다. 이 간극을 메우는 것이 모델 교체가 아니라 컨텍스트와 구조라는 점에서 DDD의 세 가지 도구가 다시 등장합니다. 유비쿼터스 언어는 프롬프트의 어휘가 되고, 바운디드 컨텍스트는 컨텍스트 창의 단위가 되며, 애그리거트의 불변식은 에이전트가 깨면 안 되는 규칙이 됩니다. 이 글은 공식 데이터, DDD 권위자의 발언, 국내 개발자의 경험담으로 그 세 지점을 정리하고 내일부터 적용할 다섯 가지를 제안합니다.
필자는 『클로드 코드 제대로 시작하기』를 썼고, 어비스 블로그 글도 Claude Code로 자료를 모으고 초안을 쓰는 파이프라인으로 만듭니다. 이 글도 Claude Code로 자료를 모았고, 글에 나오는 CLAUDE.md 용어집과 폴더 구조는 필자가 실제로 쓰는 형태를 다듬은 것이고, 애그리거트와 린터 설정은 설명용 예시입니다. Claude Code 자체의 사용법은 Claude Code 팁 11가지에, 최신 모델에 일을 맡기는 방식은 Claude Opus 5.5 잘 쓰는 법에 따로 정리해 두었습니다.
핵심 요약
- AI가 쓰는 코드는 이미 다수입니다. Google 신규 코드의 75%가 AI 생성(2026-04), Anthropic 사내 Claude 사용 비중은 28%에서 59%로, 연속 도구 호출은 9.8회에서 21.2회로 늘었습니다.
- 속도는 올랐지만 안정성, 리뷰, 보안이 나빠졌습니다. DORA 2025는 처리량은 오르고 배포 안정성은 떨어진다고 밝혔고, Faros 데이터에서 고도입 팀은 PR 병합이 98% 늘었지만 리뷰 시간도 91% 늘었습니다. Veracode가 150개 넘는 모델을 시험한 결과 보안 통과율은 55%에 머물렀습니다.
- 원인은 모델이 아니라 컨텍스트입니다. Anthropic은 컨텍스트를 "유한한 자원"으로 다루라고 하고, Claude Code 모범 사례는 CLAUDE.md에 파일별 설명 대신 아키텍처 결정을 넣으라고 합니다. 에이전트는 매 세션 새로 입사한 개발자와 같습니다.
- DDD의 세 도구가 에이전트의 컨텍스트가 됩니다. 유비쿼터스 언어는 프롬프트의 어휘, 바운디드 컨텍스트는 컨텍스트 창의 단위, 애그리거트 불변식은 테스트로 지키는 규칙입니다. Anthropic, Cursor, Kiro, GitHub, OpenAI의 가이드가 이름만 다를 뿐 같은 산출물을 요구합니다.
- DDD를 다 할 필요는 없습니다. CRUD와 일회성 도구에는 과하고, 도메인이 불확실한 초기에는 경계가 발목을 잡습니다. Eric Evans도 AI가 DDD를 증폭할지 대체할지 "지금은 알 수 없다"고 했습니다. 용어집, 컨텍스트 단위 폴더, 불변식 테스트부터 시작하면 됩니다.
목차
- AI가 쓰는 코드는 이미 다수입니다
- 빨라졌지만 무엇이 나빠졌나요?
- 원인은 모델이 아니라 컨텍스트입니다
- DDD가 에이전트의 컨텍스트가 되는 세 지점
- 벤더 가이드도 같은 것을 요구합니다
- 내일부터 할 수 있는 다섯 가지
- DDD를 다 할 필요는 없습니다
- 이 글의 자료를 고른 방법
- 자주 묻는 질문
- 마치며
AI가 쓰는 코드는 이미 다수입니다
"AI가 코드를 쓴다"는 말은 더 이상 예측이 아니라 공식 발표에 나오는 비율입니다. Google이 가장 오래 숫자를 공개해 왔습니다. 순다르 피차이는 2024년 3분기 실적 발표에서 신규 코드의 25% 이상이 AI 생성이라고 말했고(Fortune, 2024-10-30), 2025년 4월에는 "30% 이상"이라고 보도됐습니다(TechCrunch, 2025-04-29). 그리고 2026년 4월 Cloud Next 기조연설에서는 "Google 신규 코드의 75%가 AI가 생성하고 엔지니어가 승인한 코드이며, 지난 가을 50%에서 올랐다"고 밝혔습니다(Cloud Next '26, Sundar Pichai, blog.google, 2026-04-22). 1년 반 사이 25%에서 75%로, 세 배가 된 셈입니다.
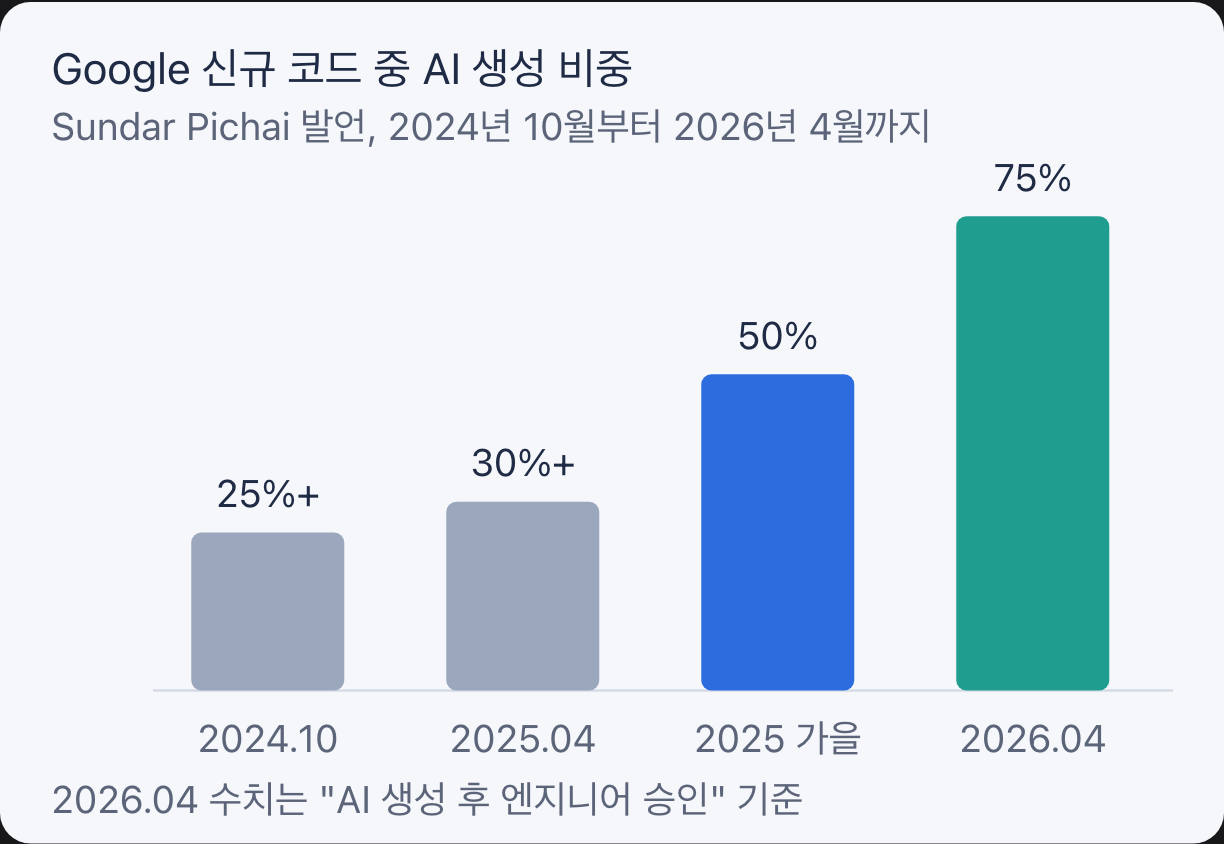
위 차트의 네 점 가운데 25%와 75%는 Google 공식 발표이고, 30%는 매체 보도, 50%는 2026년 발표문에 "지난 가을"로 언급된 값입니다. 같은 TechCrunch 기사에서 Microsoft의 사티아 나델라는 사내 저장소 코드의 20~30%가 AI로 작성된 것으로 추정한다고 말했습니다. 두 회사의 측정 기준이 같지는 않지만, 추세는 한쪽을 가리킵니다.
Anthropic은 사내 직원이 Claude를 어떻게 쓰는지 직접 조사해 2025년 12월에 공개했습니다. 설문 132명, 인터뷰 53건, Claude Code 트랜스크립트 20만 건을 분석한 결과 업무에서 Claude를 쓰는 비중은 12개월 사이 28%에서 59%로 늘었습니다(How AI is transforming work at Anthropic, Anthropic, 2025-12-02). 이 글에서 더 눈여겨볼 수치는 비중이 아니라 아래 그림의 "연속 도구 호출" 횟수입니다.
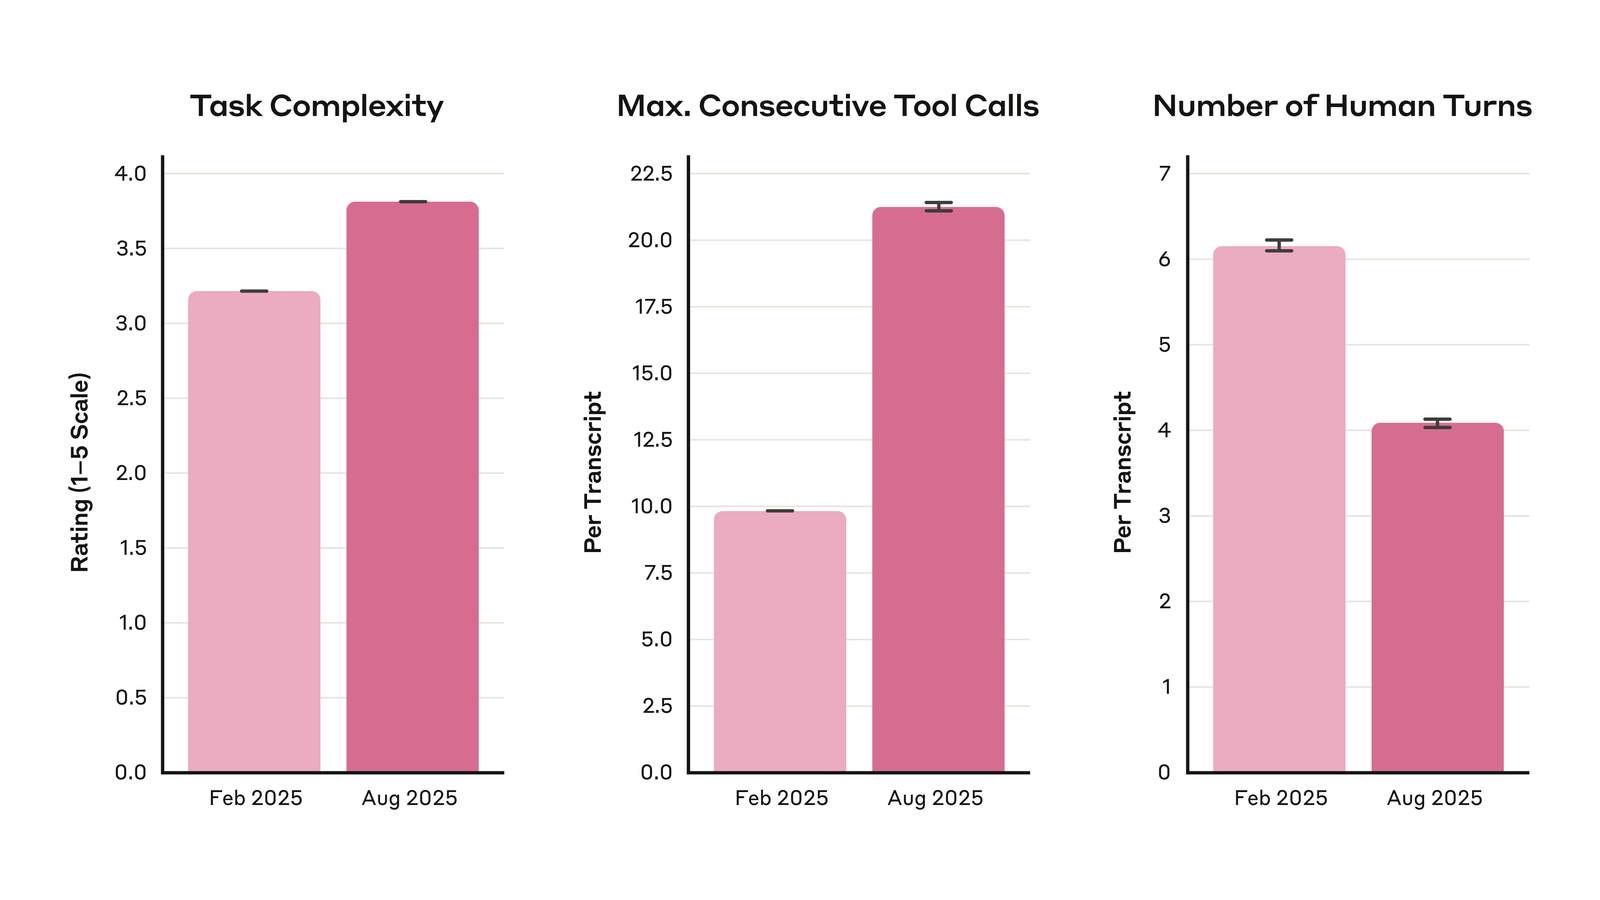
연속 도구 호출이 9.8회에서 21.2회로 늘었다는 것은, 에이전트가 사람의 확인 없이 파일을 읽고 고치고 테스트를 돌리는 결정을 전보다 두 배 이상 연달아 내린다는 뜻입니다. 결정 하나하나가 코드베이스에 대한 에이전트의 이해에 기대고 있으니, 그 이해가 어디서 오는지가 품질을 좌우합니다. Claude Code를 만든 보리스 체르니는 2026년 1월 "두 달 넘게 100%"라며 "어제 PR 22개, 그저께 27개를 보냈고 전부 Claude가 썼다"고 밝혔습니다(Fortune, 2026-01-29). 극단적인 사례지만, 방향은 그쪽입니다.
국내 개발자도 예외가 아닙니다. 한국어권을 포함한 8개 언어권 개발자 1만 5천 명 이상이 응답한 JetBrains의 2026년 개발자 생태계 설문에서 프로 개발자의 90%가 주 1회 이상 AI 에이전트를 쓰고 68%는 매일 쓴다고 답했습니다. Claude Code 사용률은 2025년 초 3%에서 39%로 뛰어 Copilot(21%)을 앞섰습니다(디지털투데이, 2026-08-24). Pragmatic Engineer 뉴스레터가 2026년 초 906명에게 물은 결과도 비슷합니다. 95%가 주 1회 이상 AI를 쓰고, 56%는 업무의 70% 이상을 AI로 하며, 55%가 에이전트를 정기적으로 씁니다(AI Tooling for Software Engineers in 2026, Pragmatic Engineer, 2026-03-03). 뉴스레터 독자 설문이라 표본이 치우쳐 있지만, "쓸지 말지"는 이미 질문이 아닙니다.
빨라졌지만 무엇이 나빠졌나요?
처리량은 분명히 올랐고, 같은 데이터가 안정성과 리뷰 부담, 보안이 나빠졌다고 말합니다. 가장 큰 표본은 Google의 DORA 2025 보고서입니다. 약 5,000명이 응답했고 90%가 업무에 AI를 쓰며 80% 이상이 생산성이 올랐다고 느낍니다. 그런데 30%는 AI가 쓴 코드를 거의 또는 전혀 신뢰하지 않는다고 답했습니다. DORA는 AI 도입이 처리량과는 양의 관계, 배포 안정성과는 음의 관계를 보인다고 밝히면서 이렇게 정리했습니다. "AI doesn't fix a team; it amplifies what's already there." AI는 팀을 고치지 않고 이미 있는 것을 증폭한다는 뜻입니다(Announcing the 2025 DORA Report, Google Cloud, 2025-09-24).
증폭의 모습은 Faros AI가 개발자 1만 명 이상, 1,255개 팀의 실제 작업 데이터를 분석한 결과에 더 구체적으로 나옵니다. AI 고도입 팀은 저도입 팀보다 과업을 21% 더 끝내고 PR을 98% 더 병합했습니다. 그런데 PR 리뷰 시간은 91% 늘었고, 개발자당 버그는 9% 늘었으며, PR 평균 크기는 154% 커졌습니다. 회사 수준의 성과 개선과 AI 도입 사이에는 유의한 상관이 없었습니다(The AI Productivity Paradox Report, Faros AI, 2025-07-23).
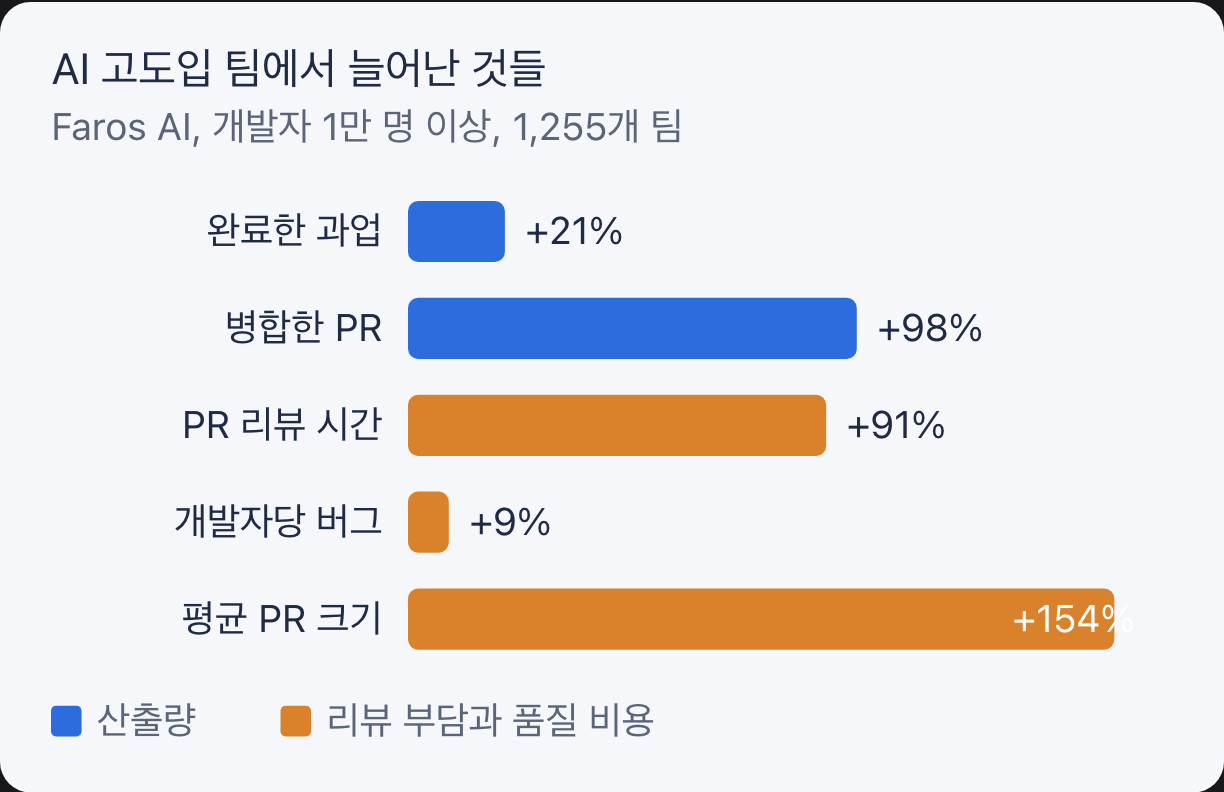
차트의 다섯 막대를 한 문장으로 줄이면 "쓰는 속도는 두 배가 됐는데 읽는 속도는 그대로"입니다. PR이 두 배로 늘고 크기가 2.5배가 되니 리뷰어가 병목이 되고, 그 틈으로 버그가 늘어납니다. 2025년 Stack Overflow 개발자 설문(응답 33,662건)에서 AI 도구의 가장 큰 불만이 "거의 맞는데 완전히 맞지는 않은 답"(66%)이었고, 45.2%가 "AI가 쓴 코드 디버깅이 더 오래 걸린다"고 답한 것과 같은 그림입니다. 이 설문에서 AI 결과의 정확성을 신뢰한다는 응답은 약 33%, 불신한다는 응답은 약 46%였습니다(2025 Developer Survey: AI, Stack Overflow, 2025-07).
보안은 모델이 좋아져도 따라오지 않았습니다. Veracode가 150개 넘는 모델에 같은 코딩 과제를 시킨 2026년 봄 보고서에서 문법 정확도는 95% 이상으로 올랐지만 보안 통과율은 55%에 머물렀습니다. 생성 코드의 45%에 취약점이 있다는 뜻입니다. 언어별로는 Python 62%, Java 29%였고, 취약점 유형별로는 XSS 15%, Log Injection 13%만 막아냈습니다(Spring 2026 GenAI Code Security Update, Veracode, 2026-03-24).
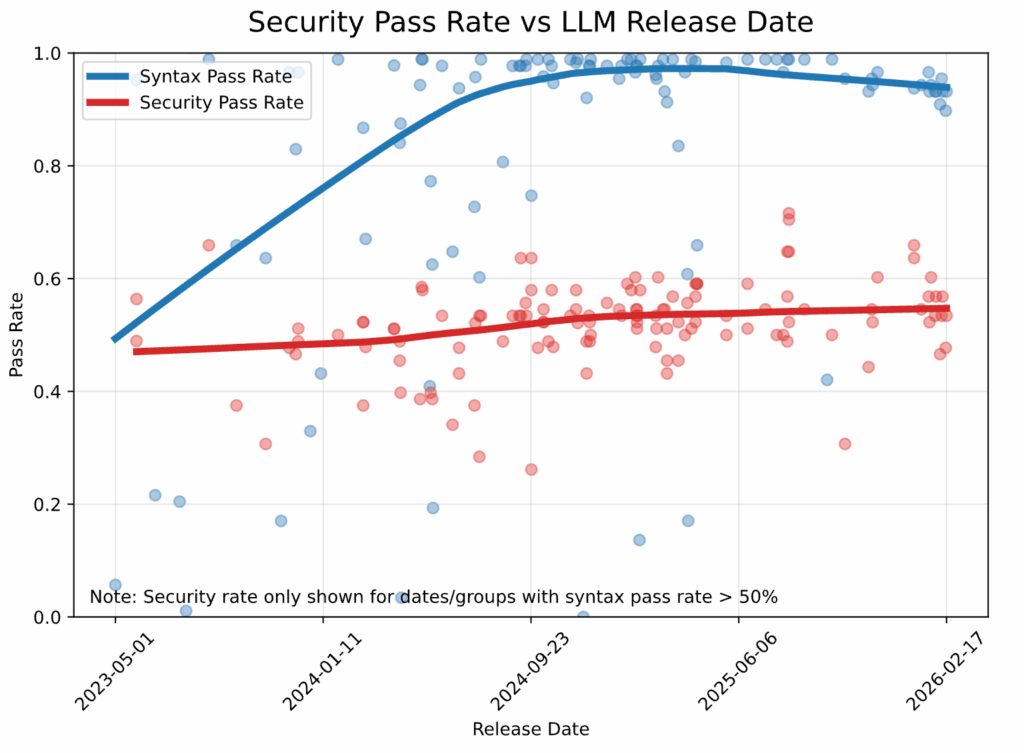
위 그림이 이 글의 전제를 한 장으로 보여 줍니다. 문법은 모델이 좋아지면 해결되지만, 보안처럼 "이 코드가 어디에 놓이고 무엇을 지켜야 하는가"가 필요한 문제는 모델 크기와 무관하게 제자리입니다. 그 정보는 모델 안에 없고 코드베이스와 사람 쪽에 있기 때문입니다. 서비스 전반의 보안 습관은 스타트업이 개발보안에 대해 노력할 때에 따로 적어 두었습니다.
코드의 모양도 바뀌고 있습니다. Sonar가 2026년 9월 블로그에서 GitClear의 2026년 보고서를 인용한 바에 따르면, 커밋 안의 복사·붙여넣기는 41%, 코드 블록 중복은 81%, 에러를 숨기는 구문은 47% 늘었습니다(The Acceptance Gap, Sonar, 2026-09-29. GitClear 2026 보고서를 Sonar가 인용). Thoughtworks의 에릭 되르넨부르크는 자기 오픈소스 앱을 에이전트로 개발하며 이 현상을 직접 관찰했습니다. 에이전트가 이미 있는 URL 생성 함수를 재사용하지 않고 같은 로직을 여러 곳에 복제했고, 필요 없는 캐시를 넣었으며, 빈 문자열 기본값으로 문제를 우회했습니다. 결론은 "AI 에이전트는 기술 부채를 들여오는 강한 경향이 있어 보이며, 이후 개발을 더 어렵게 만든다"였습니다(Assessing internal quality while coding with an agent, martinfowler.com, 2026-01-27).
국내 블로그의 경험담도 같은 장면을 묘사합니다. 한 네이버 블로거는 Cursor와 Claude Code로 밤새 코딩하다 "파일 하나 고쳤는데 다른 5군데에서 에러"가 터지고 "변수명과 함수명이 매번 제각각이라 전체 흐름을 나조차 모르는" 상태를 위험 신호로 꼽았습니다(house-it, 2026-09-11). 다른 블로거는 바이브 코딩으로 만든 코드를 "몇 주 뒤 수정하려고 열어보니 '이게 대체 무슨 코드야?'" 싶었고, 고치는 데 든 시간이 처음 만들 때보다 길었다고 적었습니다(tapenet-09). 개인 경험이라 일반화할 수는 없지만, 되르넨부르크의 관찰과 GitClear의 중복 수치가 현장에서 어떻게 느껴지는지를 보여 줍니다.
균형을 위해 METR 이야기도 해야 합니다. METR이 2025년 7월에 발표한 "경험 많은 오픈소스 개발자 16명이 246개 이슈를 처리할 때 AI를 허용하면 19% 느려졌다"는 결과는 널리 인용됐지만, METR 스스로 2026년 2월 그 결과가 "out of date"라고 공지했습니다. 2025년 후반에 다시 잰 추정치는 기존 개발자 -18%(신뢰구간 -38%에서 +9%), 신규 개발자 -4%(신뢰구간 -15%에서 +9%)로, 빨라진 방향이지만 둘 다 통계적으로 유의하지 않았습니다. 더 중요한 발견은 개발자의 30~50%가 "AI로 하고 싶은 작업"을 실험에 내놓지 않아 측정 자체가 어려워졌다는 점입니다(We are Changing our Developer Productivity Experiment Design, METR, 2026-02-24). 즉 "AI가 느리게 만든다"는 근거로 METR을 들 수는 없고, 반대로 "빠르게 만든다"는 근거로도 아직 약합니다. 확실한 것은 위에서 본 안정성, 리뷰, 보안 쪽 비용입니다.
원인은 모델이 아니라 컨텍스트입니다
에이전트가 중복 코드를 만들고 보안 규칙을 빼먹는 이유는 모델이 멍청해서가 아니라, 그 결정에 필요한 정보가 컨텍스트 창에 없기 때문입니다. Anthropic은 2025년 9월 에이전트용 컨텍스트 엔지니어링 글에서 "컨텍스트는 한계 수익이 체감하는 유한한 자원으로 다뤄야 한다"고 썼습니다. 컨텍스트 창에 토큰이 늘어날수록 모델이 그 안의 정보를 정확히 떠올리는 능력이 떨어지는 현상을 "context rot"라고 부르면서, 목표는 "원하는 결과의 가능성을 최대로 높이는 가장 작은 고신호 토큰 집합"을 찾는 것이라고 정리했습니다(Effective context engineering for AI agents, Anthropic, 2025-09-29).
Claude Code 공식 모범 사례 문서는 더 직접적입니다. "대부분의 모범 사례는 하나의 제약에서 나온다. Claude의 컨텍스트 창은 빨리 차고, 차면 성능이 떨어진다." 그래서 CLAUDE.md에 넣을 것과 뺄 것을 표로 구분하는데, 넣을 것에는 "프로젝트 고유의 아키텍처 결정"이 있고 뺄 것에는 "코드베이스의 파일별 설명"이 있습니다(Best practices for Claude Code, Claude Code Docs, 2026-10-06 확인). 파일 목록은 에이전트가 grep으로 찾을 수 있지만, "왜 결제와 주문이 다른 모듈인가"는 어디에도 쓰여 있지 않으면 알 길이 없기 때문입니다.
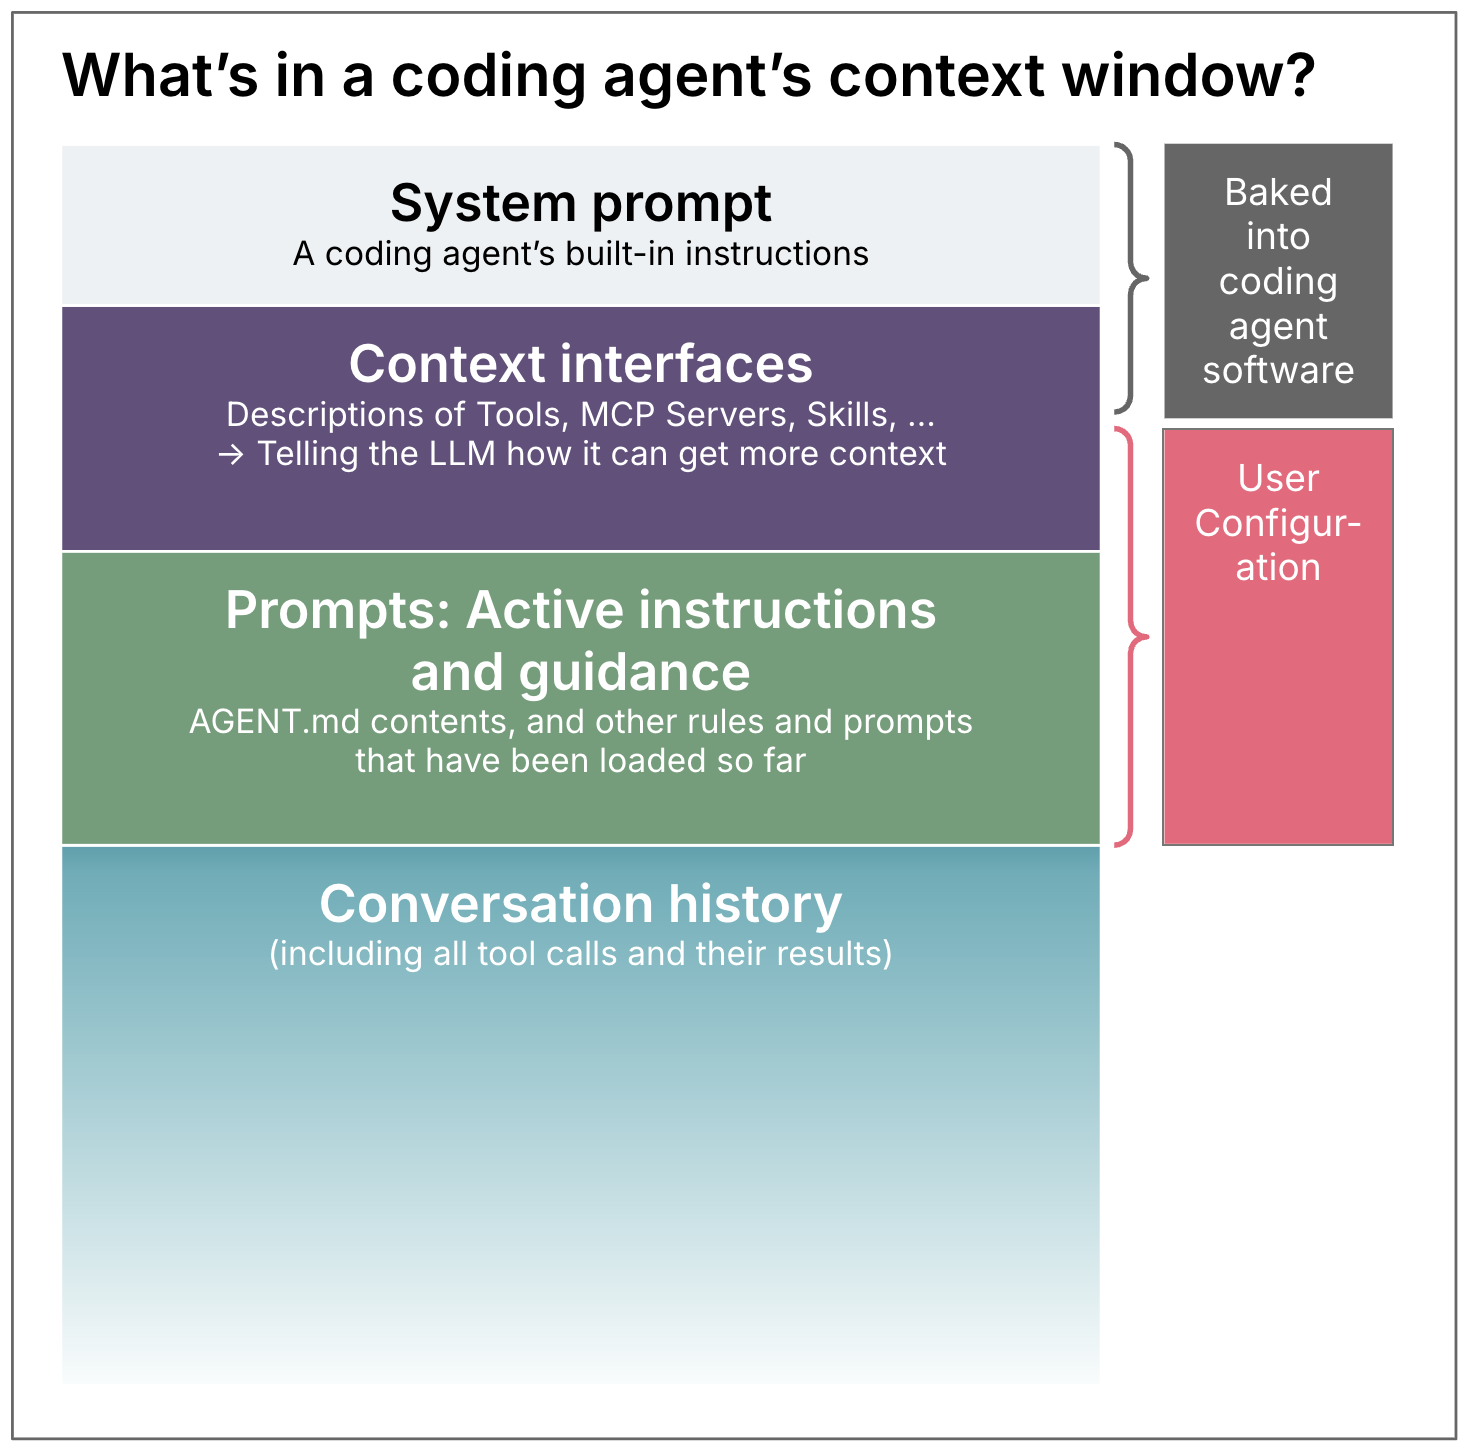
이 그림을 그린 Thoughtworks의 비르기타 뵈켈러는 컨텍스트 엔지니어링을 "더 나은 결과를 얻기 위해 모델이 보는 것을 선별하는 일"이라고 정의하고, 컨텍스트가 너무 많아도 에이전트의 효과가 떨어진다고 적었습니다(Context Engineering for Coding Agents, martinfowler.com, 2026-02-05). Thoughtworks Technology Radar는 2026년 4월호에서 Context engineering을 Adopt로 올리면서 컨텍스트 창을 "설계 표면"으로 다루라고 했고(Context engineering, Thoughtworks Radar, 2026-04), 같은 호에서 "시스템의 구현과, 그것이 어떻게 왜 동작하는지에 대한 팀의 공유된 이해 사이의 벌어지는 간극"을 Codebase cognitive debt라 이름 붙여 Caution으로 분류했습니다(Codebase cognitive debt, Thoughtworks Radar, 2026-04). 에이전트가 코드를 빨리 쓸수록 이 간극이 빨리 벌어집니다.
DDD 쪽에서는 『도메인 주도 설계 첫걸음』의 저자 블라드 호노노프가 같은 말을 모듈성의 언어로 했습니다. "모듈성은 예전에는 코드베이스의 미래를 대비하는 일이었다. 오늘날에는 코드를 AI가 접근할 수 있게 만드는 일이기도 하다." 그리고 덧붙입니다. "LLM에도 인지 한계가 있다. 컨텍스트 창은 제한돼 있고, 그 안에서도 크고 강하게 결합된 코드베이스는 온전히 이해하지 못하는 경우가 많다"(The Golden Age of Modularity, Vlad Khononov, 2025-03-30). DDD Europe 2026에서 첼시 트로이는 세션 제목을 아예 "경계 없는 컨텍스트의 저주"로 붙이고 이렇게 요약했습니다. "엔지니어가 컨텍스트를 신중하게 관리하면 LLM은 더 정확하고 유용한 답을 낸다. 그런데 도구의 어떤 것도 우리에게 그렇게 하라고 가르치거나 권하지 않는다"(DDD Europe 2026 프로그램, 2026-06).
필자가 쓰는 비유는 이렇습니다. 에이전트는 매 세션 새로 입사한 개발자입니다. 실력은 좋은데 어제 일을 기억하지 못하고, 팀의 용어와 암묵적 규칙을 모르며, 코드베이스 전체를 읽을 시간은 없습니다. 이런 개발자에게 첫날 무엇을 건네겠습니까. 파일 목록이 아니라 용어집, 모듈 경계와 그 이유, 깨면 안 되는 규칙입니다. 그것이 정확히 DDD가 수십 년 동안 "사람에게" 건네라고 해 온 산출물입니다. Thoughtworks Radar가 "사람에게 좋은 소프트웨어 설계는 AI에게도 이롭다"고 쓴 것(AI-friendly code design, Thoughtworks Radar, 2025-04)과, 67개 문헌을 검토한 2026년 5월의 한 프리프린트가 "모델 능력이 아니라 명세 규율이 AI 보조 소프트웨어 신뢰성의 구속 조건"이라고 결론 낸 것(The Productivity-Reliability Paradox, arXiv 2605.01160, 2026-05-01)이 같은 자리를 가리킵니다.
DDD가 에이전트의 컨텍스트가 되는 세 지점
DDD의 산출물 가운데 에이전트에게 바로 컨텍스트가 되는 것은 유비쿼터스 언어, 바운디드 컨텍스트, 애그리거트 불변식 세 가지입니다. 나머지 전술 패턴(리포지토리, 도메인 서비스, 도메인 이벤트)은 이 셋이 서면 따라오고, 이 셋이 없으면 있어도 소용이 없습니다. 하나씩 보겠습니다.
1. 유비쿼터스 언어는 프롬프트의 어휘입니다
에이전트에게 주는 프롬프트의 품질은 그 안에 쓰인 단어의 정확도로 결정됩니다. Go와 DDD로 알려진 Three Dots Labs의 미워시 스무카는 "Add user to CRM"이라고 시키는 것보다 "CRM에 customer 항목을 만들고, 지원 시스템에 profile을 만들어라"처럼 각 컨텍스트의 이름으로 말하는 쪽이 에이전트 결과를 바로 개선한다고 적었습니다. 그는 소프트웨어 공학에서 어려운 부분은 "문제 도메인을 이해하고 그것을 코드로 잘 모델링하는 일"이고, AI는 그 부분을 대신하지 못한다고 봅니다(Domain-Driven Design matters more when AI writes your code, Three Dots Labs, 2026-08-20). codecentric의 아네그레트 융커는 도메인 스토리텔링과 이벤트스토밍 결과를 LLM 입력으로 쓰는 실험을 하면서 더 짧게 말했습니다. "그 언어의 품질이 생성되는 출력의 품질을 직접 결정한다"(From Stories to Code, codecentric, 2026-03-04).
한국어 매체에서도 같은 진단이 나왔습니다. AI포스트는 2026년 4월 맷 포콕의 AI 엔지니어 컨퍼런스 기조연설을 보도하며 "도메인 주도 설계(DDD)의 핵심인 이 개념(유비쿼터스 언어)을 활용해 AI와 용어 사전을 공유함으로써 대화가 겉도는 현상을 막고 코드의 일관성을 유지해야 한다"고 전했습니다(AI포스트, 2026-04-26). 다모앙의 한 개발자는 자기 검색 프로젝트에서 같은 개념을 "대화 조각", "검색 점수", "결과 합치기"로 혼용했더니 AI가 매번 다른 변수명과 꼬인 데이터 흐름을 만들었고, Session, Chunk, BM25 score, RRF로 용어를 정의하고 나서야 일관된 코드가 나왔다고 적었습니다(다모앙, 2026-06-01). 용어가 흔들리면 사람은 문맥으로 알아듣지만 에이전트는 세 가지 다른 개념으로 받아들여 세 가지 이름을 만듭니다.
최근 한 달의 커뮤니티 토론도 같은 곳을 가리킵니다. 첼시 트로이는 2026년 10월 5일 공개된 DDD Europe 강연 영상에서, 에이전트에게 첫 질문을 던지기 전에 "모델이라는 말로 내가 뜻하는 것, 기능이라는 말로 뜻하는 것, 배포라는 말로 뜻하는 것"을 먼저 적어 유비쿼터스 언어를 명시하라고 권했습니다(The Curse of Unbounded Contexts, Chelsea Troy, DDD Europe 2026, 2026-10-05 공개, 자동 자막 기준). Lobsters의 한 토론에서 가장 많은 표를 받은 조언은 "에이전트가 GLOSSARY.md에 기여하고 참조하게 한다"였고, 다른 참여자는 그 이유를 이렇게 적었습니다. "개념의 공유 어휘는 모든 프로그래밍에 필수다(DDD의 핵심 기능이기도 하다). 그런데 LLM은 사람보다 훨씬 자유롭게 새롭고 헷갈리는 이름을 만들어 내고, 그 이름은 대개 더 나쁘다"(Reducing the cognitive load of AI changes, Lobsters, 2026-10-01).
그래서 CLAUDE.md나 AGENTS.md에 가장 먼저 넣을 것은 용어집입니다. 필자가 쓰는 형태는 다음과 같습니다. "쓰지 않는 말" 열이 핵심입니다. 에이전트는 코드베이스와 학습 데이터에서 흔한 이름을 끌어오기 때문에, 금지어를 적어 두지 않으면 User, Member, Account가 한 프로젝트에 공존하게 됩니다.
**용어집 (ordering 컨텍스트)**

| 용어 | 뜻 | 코드 이름 | 쓰지 않는 말 |
|---|---|---|---|
| 주문(Order) | 고객이 결제 전에 담은 상품 묶음. 결제가 끝나도 새 객체가 생기지 않고 상태만 바뀐다 | Order, OrderId | 장바구니, Cart, Purchase |
| 주문 항목(Order Line) | 주문 안의 상품 하나와 수량 | OrderLine | Item, Product(카탈로그 컨텍스트의 개념) |
| 주문 확정(Place) | 결제 완료로 주문을 더 이상 바꿀 수 없게 되는 사건 | Order.place(), OrderPlaced | 결제 완료, confirm, submit |
| 고객(Customer) | 이 컨텍스트는 CustomerId만 안다. 이름과 등급은 CRM 컨텍스트 소관 | CustomerId | User, Member, Account |
2. 바운디드 컨텍스트는 컨텍스트 창의 단위입니다
바운디드 컨텍스트는 사람의 인지 한계에 맞춰 모델을 자르는 도구였고, 지금은 에이전트의 컨텍스트 창에 맞춰 자르는 도구입니다. 호노노프가 "코드를 AI가 접근할 수 있게 만드는 모듈성"이라고 한 것이 이 뜻이고, 그는 2026년 2월 글에서 "시스템의 모듈성에 투자하지 않고 AI로 더 많은 코드를 만드는 것은 이미 과잉 생산 중인 기계의 속도를 올리는 것과 같다"고 덧붙였습니다(AI Doesn't Fix Your Real Bottleneck, Vlad Khononov, 2026-02-23). 에릭 에반스는 2024년 Explore DDD 기조연설에서 "훈련된 언어 모델은 하나의 바운디드 컨텍스트다"라고 말했습니다(InfoQ, 2024-03). 모델이 쓰는 어휘와 가정이 하나의 경계 안에 있다는 뜻이니, 그 경계와 우리 시스템의 경계가 겹치게 하는 일이 설계자의 몫입니다.
경계가 없을 때 에이전트가 무엇을 하는지는 스무카가 정확히 짚었습니다. "에이전트는 저장소 전체에 접근하고, 당신이 준 이름을 찾아다닌다. 비슷해 보이는 엔티티를 순진하게 하나로 합치려 할 수 있다"(Three Dots Labs). CRM의 Customer와 지원 시스템의 Profile은 같은 사람을 가리키지만 다른 개념인데, 에이전트는 둘을 한 클래스로 만들고 싶어 합니다. 융커는 이를 막는 원칙을 한 줄로 썼습니다. "바운디드 컨텍스트는 ID를 공유하지, 스키마를 공유하지 않는다"(codecentric). 앞의 용어집에서 ordering 컨텍스트가 CustomerId만 알고 이름과 등급은 모른다고 적은 이유입니다. 실제로 당한 사람의 기록도 있습니다. 트래비스 프리싱어는 저장소 전체를 넘겨받은 에이전트가 "세 개의 도메인을 하나로 합치고 그것을 정리(cleanup)라고 불렀다"고 적으면서, 바운디드 컨텍스트는 "이제 사람을 위한 설계 패턴이 아니라, 팀이 소유한 어휘를 팀이 고용한 도구가 통합해 버리지 않게 막는 범위 지정의 기본 단위"라고 썼습니다(The Bounded Context Is the Scope the Agent Actually Needs, dev.to, 2026-08-28). 반대편 경험도 Hacker News에 있습니다. 한 개발자는 "처음에 바운디드 컨텍스트 경계와 유비쿼터스 언어 정의를 잘 준비해 둔 덕에 아직 지저분해지지 않았고 Claude가 계속 개발하고 있다"고 썼습니다(Hacker News, Domain-Driven Agents 토론, 2026-08-29).
실무에서는 이 경계를 폴더와 문서로 드러내야 에이전트가 읽습니다. coldtake.dev의 에르네스트 베드나르치크는 바운디드 컨텍스트마다 CONTEXT.md에 용어집을 선언하고, 저장소 매니페스트에서 컨텍스트 맵을 자동 생성해 에이전트가 "지금 어느 컨텍스트에 있고 거기서 어떤 단어를 쓰는지" 알게 했습니다. 전략적 설계는 사람이, 전술적 구현은 에이전트가 맡는 분업입니다(Domain-Driven Agents, coldtake.dev, 2026-08-27). 다모앙의 개발자도 검색 코어, 파서, 출력을 바운디드 컨텍스트로 잘라 놓으니 "AI에게 전체 프로젝트를 읽힐 필요가 없었다"고 썼습니다(다모앙). 우아한형제들의 이재홍 개발자는 Cursor Rules를 globs로 경로별로만 켜지게 나눠 "개발자마다 AI에게 지시하는 방식이 달라서 코드 스타일이 어긋나던 문제가 사라졌다"고 적었습니다(우아한형제들 기술블로그, 2026-04-17). Cursor 공식 문서도 Rules에 "코드베이스에 대한 도메인 지식"과 "아키텍처와 스타일 결정"을 넣되 500줄을 넘기지 말라고 안내합니다(Rules, Cursor Docs, 2026-10-06 확인).
폴더 구조로 옮기면 다음과 같습니다. 컨텍스트마다 CONTEXT.md가 있고, 컨텍스트 사이 관계는 CONTEXT-MAP.md 한 장에 모읍니다. Claude Code는 하위 폴더의 CLAUDE.md를 시작할 때가 아니라 그 폴더의 파일을 읽을 때 불러오고, .claude/rules/의 규칙 파일에 paths를 적으면 그 경로의 파일을 다룰 때만 적용합니다(Manage Claude's memory, Claude Code Docs, 2026-10-06 확인). 컨텍스트별 규칙을 거기 두면 작업 중인 컨텍스트의 규칙만 컨텍스트 창에 올라옵니다.
src/contexts/
  ordering/
    CLAUDE.md          # 이 컨텍스트에서 작업할 때만 읽히는 규칙 (CONTEXT.md를 참조)
    CONTEXT.md         # 용어집, 책임 범위, 다른 컨텍스트와 주고받는 것
    domain/            # Order 애그리거트, 값 객체, 도메인 이벤트
    application/       # 유스케이스 (PlaceOrder, CancelOrder)
    infrastructure/    # DB, 결제 게이트웨이 어댑터
  billing/
    CLAUDE.md
    CONTEXT.md
    ...
  CONTEXT-MAP.md       # ordering은 billing에 OrderId와 금액만 넘긴다. 스키마 공유 금지
3. 애그리거트의 불변식은 에이전트가 깨면 안 되는 규칙입니다
애그리거트는 "항상 참이어야 하는 규칙"을 코드 한곳에 모아 두는 장치이고, 에이전트에게는 그것이 깨면 바로 실패하는 울타리가 됩니다. 켄트 벡은 2025년 5월 "오늘날 지니(LLM)의 마법 같지 않은 점 하나는 취향이 없다는 것"이라고 썼습니다. 지니는 자기가 복잡도를 무한히 다룰 수 있다고 가정하기 때문에 복잡도를 줄이려 하지 않고, 기능 추가와 구조 개선을 번갈아 하는 호흡을 깨뜨린다는 것입니다(Augmented Coding & Design, Kent Beck, 2025-05-03). 앞서 본 되르넨부르크의 관찰, 즉 기존 함수를 재사용하지 않고 로직을 여러 곳에 복제하는 행동이 그 결과입니다. 불변식이 서비스 코드 여기저기에 if 문으로 흩어져 있으면, 에이전트는 새 경로를 만들 때 그 if 문을 또 하나 복제하거나 빼먹습니다.
해법은 규칙을 애그리거트 안으로 옮기고 테스트로 못 박는 것입니다. "빈 주문은 확정할 수 없다", "확정된 주문은 항목을 바꿀 수 없다"가 Order 안에 있으면, 에이전트가 어디서 어떻게 호출하든 규칙은 한곳에서 지켜집니다.
export class Order {
  private constructor(
    readonly id: OrderId,
    private lines: OrderLine[],
    private status: OrderStatus,
  ) {}

  static draft(id: OrderId): Order {
    return new Order(id, [], "DRAFT");
  }

  addLine(line: OrderLine): void {
    if (this.status !== "DRAFT") throw new OrderNotEditable(this.id);
    this.lines.push(line);
  }

  place(): void {
    if (this.status !== "DRAFT") throw new OrderAlreadyPlaced(this.id);
    if (this.lines.length === 0) throw new EmptyOrder(this.id);
    this.status = "PLACED";
  }
}
여기에 expect(() => Order.draft(id).place()).toThrow(EmptyOrder) 같은 테스트가 붙어 있으면, 에이전트가 "주문 확정 API 하나 추가해 줘"라는 요청을 처리하다가 상태 검사를 우회하는 순간 테스트가 빨간불을 켭니다. Claude Code 모범 사례가 "Claude에게 자기 작업을 검증할 방법을 주라"고 하는 것(Claude Code Docs)이 이 뜻입니다. 지시문은 무시될 수 있지만 실패하는 테스트는 무시되지 않습니다. 루카스 니센은 2026년 10월 ArchUnit 같은 아키텍처 테스트를 PR마다 돌리는 "아키텍처 가비지 컬렉션"을 제안하면서 이 차이를 한 문장으로 정리했습니다. "지시는 도움이 되지만 준수 확률을 바꿀 뿐이다. 테스트는 성공의 정의를 바꾼다"(AI-Generated Technical Debt: Architecture Garbage Collection for Coding Agents, Lukas Niessen, 2026-10-02).
같은 원리를 모듈 수준으로 올리면 아키텍처 테스트가 됩니다. OpenAI의 Codex 팀은 5개월 동안 약 100만 줄의 코드를 사람이 한 줄도 직접 쓰지 않고 에이전트로만 만들면서, Types, Config, Repo, Service, Runtime, UI 순서의 레이어 의존 규칙을 정하고 이를 "structural tests"로 검증해 위반을 막았습니다. 문서 디렉터리가 에이전트의 "single source of truth"였습니다(InfoQ, 2026-02-21). 뵈켈러는 이 사례의 핵심을 "아키텍처 제약을 LLM 에이전트만이 아니라 결정적인 린터와 구조 테스트로도 감시한 것"이라고 정리했습니다(Harness Engineering - first thoughts, martinfowler.com, 2026-02-17). 닐 포드는 DDD Europe 2026에서 "에이전트(와 사람)에게 아키텍처를 명세하는 법"이라는 워크숍을 열어 피트니스 함수로 아키텍처 준수를 자동 검증하는 방법을 다뤘습니다(DDD Europe 2026 프로그램).
국내 사례로는 velog의 진현준 개발자가 NestJS DDD 백엔드를 Claude Code로 개발한 기록이 있습니다. 그는 SPEC에서 DOMAIN.md, 그다음 코드 순서를 강제하고, 바운디드 컨텍스트 경계와 애그리거트 설계를 담은 DOMAIN.md를 네 개의 검토 게이트 가운데 첫 번째로 두었습니다. 이유는 이렇습니다. "도메인 모델링이 잘못되면 그 위에 쌓이는 인프라, 프레젠테이션, 유즈케이스가 전부 무너진다." 그리고 "문서가 불명확하면 에이전트가 일관되게 잘못된 코드를 만든다"(velog 진현준, 2026-05-28). 에이전트가 틀리는 방식이 무작위가 아니라 일관되다는 점이 중요합니다. 입력이 같으면 같은 방향으로 틀리므로, 입력인 도메인 모델을 먼저 검토하는 쪽이 코드를 검토하는 것보다 싸게 먹힙니다.
벤더 가이드도 같은 것을 요구합니다
Anthropic, Cursor, Kiro, GitHub, OpenAI의 가이드를 나란히 놓으면, 이름만 다를 뿐 DDD의 산출물을 그대로 요구하고 있습니다. 어느 벤더도 DDD라는 말을 쓰지 않습니다. 그런데 "무엇을 적어 두라"는 항목을 모으면 용어집, 컨텍스트 맵, 도메인 모델, 불변식, 아키텍처 결정 기록(ADR)이 됩니다.
| DDD 산출물 | 에이전트 쪽 대응물 | 근거 |
|---|---|---|
| 유비쿼터스 언어(용어집) | CLAUDE.md, AGENTS.md, Cursor Rules의 "도메인 지식" | Cursor Docs: Rules에 "Domain-specific knowledge about your codebase"(Cursor). Thoughtworks Radar: 공유 지침 파일을 저장소에 커밋하는 Curated shared instructions를 Adopt(Thoughtworks Radar, 2026-04) |
| 컨텍스트 맵, 바운디드 컨텍스트 | 경로별 Rules, 컨텍스트 폴더의 CONTEXT.md와 하위 CLAUDE.md | 우아한형제들의 globs 기반 Rules 분리(우아한형제들), coldtake.dev의 CONTEXT.md와 자동 생성 컨텍스트 맵(coldtake.dev) |
| 도메인 모델 | Kiro의 design.md, Claude Code의 SPEC.md, velog 진현준의 DOMAIN.md | Kiro Specs는 requirements.md, design.md, tasks.md 세 파일로 구성되고 design.md에 기술 아키텍처가 들어감(Kiro Docs). Claude Code 모범 사례는 큰 기능 전에 파일과 인터페이스, 범위 밖을 명시한 SPEC.md를 쓰라고 안내(Claude Code Docs) |
| 애그리거트 불변식, 레이어 규칙 | 단위 테스트, structural tests, 아키텍처 린터 | OpenAI Codex 팀의 레이어 의존 규칙과 structural tests(InfoQ), Thoughtworks Codebase cognitive debt 블립의 대응책에 architectural fitness functions 포함(Thoughtworks Radar) |
| 아키텍처 결정 기록(ADR) | CLAUDE.md의 "Architectural decisions specific to your project" | Claude Code 모범 사례의 CLAUDE.md 포함 항목(Claude Code Docs). Cursor Rules의 "Architecture and style decisions"(Cursor) |
GitHub가 2025년 9월 공개한 Spec Kit은 이 표의 셋째 줄을 도구로 만든 것입니다. Specify, Plan, Tasks, Implement 네 단계로 진행하고, "스펙이 공유된 진실의 원천이 된다. 무언가 말이 안 되면 스펙으로 돌아가고, 프로젝트가 복잡해지면 스펙을 다듬는다"고 설명합니다(Spec-driven development with AI, GitHub Blog, 2025-09-02). DDD에서 도메인 모델이 하던 역할입니다.
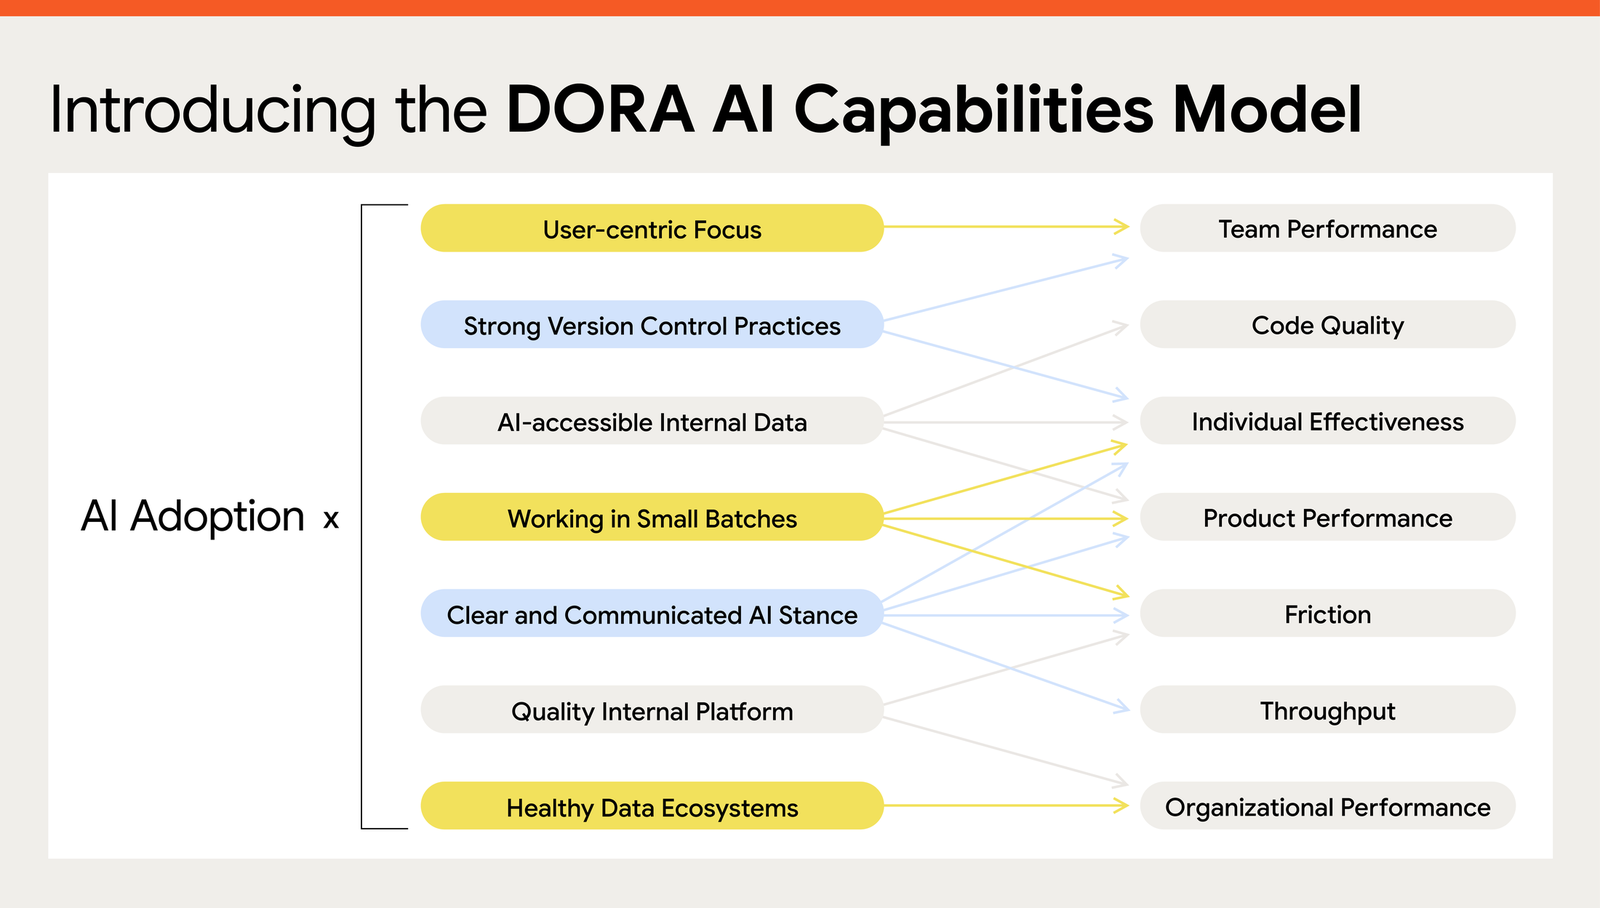
DORA 2025 보고서가 제시한 AI 역량 모델도 같은 방향입니다. AI 도입이 성과로 이어지게 하는 일곱 가지 역량 가운데 "AI-accessible Internal Data"(AI가 접근할 수 있는 내부 데이터), "Working in Small Batches"(작은 단위로 일하기), "Strong Version Control Practices"(강한 버전 관리)가 들어 있습니다. 내부 데이터란 문서, 설계, 용어이고, 작은 단위란 경계가 분명한 작업입니다.
토스와 LY Corporation의 기술 블로그도 같은 결론에 도달했습니다. 토스페이먼츠의 김용성 개발자는 Claude Code의 구성요소를 레이어드 아키텍처에 대응시키며 "Spaghetti CLAUDE.md"(구조 없이 모든 지시가 뒤섞인 파일)와 "God Skill"을 안티패턴으로 꼽았습니다. 판별 기준이 날카롭습니다. "CLAUDE.md를 자주 수정하고 있다면, 그 내용은 거기 있으면 안 되는 것일 가능성이 높습니다"(토스 기술블로그, 2026-01-26). 자주 바뀌는 것은 코드나 스킬로, 안 바뀌는 것(용어, 경계, 결정)만 CLAUDE.md로 가야 한다는 뜻입니다. LY Corporation의 Tech-Verse 2026 참관기는 30년 된 레거시와 105개 서비스의 AI 전환이 "코딩 이전 단계인 기획·설계의 구조화"에서 시작됐다고 전하며, "문제는 노드가 아니라 엣지(핸드오프)에 있다"고 적었습니다(LY Corporation 기술블로그, 2026-09-11). 바운디드 컨텍스트 사이의 관계를 먼저 그리라는 말과 다르지 않습니다.
내일부터 할 수 있는 다섯 가지
DDD 책을 다 읽지 않아도, 아래 다섯 가지는 기존 프로젝트에 하루 이틀이면 넣을 수 있습니다. 효과가 큰 순서대로 적었습니다.
-
용어집 한 장을 CLAUDE.md에 넣고, 쓰지 않는 말까지 적습니다. 앞의 표 형식이면 충분합니다. 용어, 뜻, 코드 이름, 쓰지 않는 말 네 열을 두고, 팀이 회의에서 실제로 쓰는 단어로 채웁니다. 가장 효과가 큰 열은 "쓰지 않는 말"입니다. 에이전트가 만든 코드에서 용어집에 없는 이름이 보일 때마다 한 줄씩 추가하면, 한 달 뒤에는 팀의 유비쿼터스 언어가 저절로 문서가 됩니다. Cursor 문서가 "단순하게 시작하고 에이전트가 같은 실수를 반복할 때만 넓히라"고 하는 방식입니다(Cursor).
-
폴더를 컨텍스트 단위로 자르고, 컨텍스트마다 CONTEXT.md와 경로별 규칙을 둡니다. 기술 레이어(controllers, services, models)가 최상위에 있는 구조라면 에이전트는 작업마다 세 폴더를 다 뒤져야 합니다. 최상위를 ordering, billing, catalog처럼 컨텍스트로 바꾸고 레이어는 그 아래로 내리면, 한 작업에 필요한 파일이 한 폴더에 모입니다. 컨텍스트마다 CONTEXT.md에 용어집과 책임 범위, 다른 컨텍스트와 주고받는 것을 적고, Cursor는 globs로, Claude Code는 하위 폴더 CLAUDE.md나
paths를 적은 규칙 파일로 그 폴더에서만 읽히게 합니다(Claude Code Docs). 전체 이동이 부담되면 다음에 손댈 컨텍스트 하나만 먼저 옮깁니다. -
불변식을 서비스 코드에서 애그리거트와 테스트로 옮깁니다. "확정된 주문은 바꿀 수 없다"처럼 흩어진 if 문을 찾아 엔티티의 메서드 안으로 모으고, 깨지는 경우마다 테스트를 하나씩 둡니다. 에이전트에게 "Order의 상태 전이 규칙을 전부 찾아 Order 클래스 안으로 모으고 각 규칙에 테스트를 써라"고 맡길 수 있습니다. 그다음부터는 에이전트가 규칙을 우회하는 코드를 쓰면 테스트가 잡아 줍니다. 벡이 말한 "취향"을 사람이 테스트로 대신 넣어 주는 셈입니다.
-
아키텍처 테스트를 추가합니다. 컨텍스트 사이 의존과 레이어 의존을 린터 규칙으로 못 박습니다. TypeScript라면 dependency-cruiser나 eslint-plugin-boundaries, Java라면 ArchUnit이 있습니다. 아래는 dependency-cruiser 설정 예시로, ordering이 billing의 내부에 손대지 못하게 하고 domain 레이어가 infrastructure를 참조하지 못하게 합니다. CI에 넣어 두면 OpenAI Codex 팀이 structural tests로 했던 일을 작은 규모로 하게 됩니다. 설정 예시는 목록 아래에 두었습니다.
-
문서를 먼저 씁니다. SPEC에서 DOMAIN.md, 그다음 코드 순서로. 새 기능을 에이전트에게 바로 시키지 말고, 먼저 요구사항(SPEC)을 적고 에이전트에게 바운디드 컨텍스트 경계, 애그리거트, 포트 인터페이스를 담은 DOMAIN.md를 쓰게 한 뒤, 그 문서를 사람이 검토하고 나서 코드로 넘어갑니다. velog의 진현준 개발자가 네 개 검토 게이트 중 첫 번째를 도메인 모델에 둔 이유, 즉 여기서 틀리면 위에 쌓이는 전부가 무너진다는 점을 기억하면 됩니다(velog 진현준). Claude Code 모범 사례의 SPEC.md, Kiro의 design.md, Spec Kit의 Specify 단계가 모두 이 자리입니다.
4번의 dependency-cruiser 설정 예시입니다. ordering이 billing의 public 폴더 밖을 참조하거나, domain 레이어가 infrastructure나 application을 참조하면 CI가 실패합니다.
// .dependency-cruiser.cjs
module.exports = {
  forbidden: [
    {
      name: "no-cross-context-internals",
      severity: "error",
      from: { path: "^src/contexts/ordering" },
      to: { path: "^src/contexts/billing/(?!public/)" },
    },
    {
      name: "domain-stays-pure",
      severity: "error",
      from: { path: "^src/contexts/[^/]+/domain" },
      to: { path: "^src/contexts/[^/]+/(infrastructure|application)" },
    },
  ],
};
다섯 가지의 공통점은 사람의 시간을 "쓰기"에서 "정의하기와 읽기"로 옮긴다는 것입니다. 애디 오스마니는 2026년 1월 에이전틱 코딩에 대해 "노력의 70%를 문제 정의에, 30%를 실행에 쓰라"고 권하면서 이렇게 경고했습니다. "당신의 '읽는' 능력이 에이전트의 '내놓는' 능력과 같은 속도로 커지지 않는다면, 당신은 더 이상 엔지니어링을 하고 있는 것이 아니다. 도장을 찍고 있을 뿐이다"(The 80% Problem in Agentic Coding, Addy Osmani, 2026-01-28). 용어집, 경계, 불변식은 읽는 속도를 올리는 가장 확실한 투자입니다. 국내 현장의 표현도 같습니다. 매일경제가 전한 판교 대형 IT 기업 개발자의 말은 "인간 개발자는 AI가 잘 알지 못하는 도메인 지식을 바탕으로 최적의 방안을 선별하고 도출하는 디렉팅 역할이 중요해졌다"였습니다(매일경제, 2026-02-20).
DDD를 다 할 필요는 없습니다
이 글의 주장은 "DDD를 전부 도입하라"가 아니라 "에이전트에게 컨텍스트가 되는 세 가지만 챙기라"입니다. 스무카조차 CRUD 위주의 앱과 일회성 도구에는 DDD가 필요 없다고 분명히 적었습니다(Three Dots Labs). 다모앙의 개발자도 자기 경험의 한계를 솔직히 밝혔습니다. "도메인이 불확실한 초기 탐색 단계에서는 경계를 미리 긋는 게 발목을 잡는다"(다모앙). 무엇을 만드는지 아직 모를 때는 에이전트와 빠르게 프로토타입을 만들어 도메인을 배우는 편이 낫고, 경계는 그다음에 긋는 것입니다.
"설계가 많을수록 에이전트에게 좋다"는 생각도 측정 결과 앞에서는 조심해야 합니다. 한 엔지니어가 같은 Java 서비스를 플랫 구조와 헥사고날 구조 두 벌로 만들어 31개의 변경을 에이전트에게 시킨 실험에서, 일상적인 기능 추가 9건은 헥사고날 쪽이 37.8% 오래 걸리고 입력 토큰을 70.9% 더 썼으며, 이후 15건에서도 30.3% 오래 걸렸습니다. 헥사고날이 이긴 것은 경계를 쓰도록 고른 마지막 과제(SQLite를 PostgreSQL로 교체) 하나로, 45.4% 빨랐습니다. 결론은 "다이어그램이 아니라 트레이드오프를 고르라"였습니다(How does clean architecture impact token costs and execution times?, dev.to, 2026-09-17). 이 결과는 이 글의 주장과 충돌하지 않습니다. 이 글이 챙기라고 한 것은 레이어와 인터페이스의 개수가 아니라 용어, 경계, 불변식이고, 커뮤니티에서 자주 보고되듯 에이전트는 시키지 않아도 "인터페이스, 구현체, 팩토리, 매퍼"를 교과서처럼 늘리는 경향이 있어서 그쪽을 막는 규칙이 더 필요한 경우가 많습니다.
문서 먼저 쓰는 방식에도 비용이 있습니다. 뵈켈러는 Kiro, Spec Kit, Tessl을 비교하면서 스펙 주도 개발의 우려를 세 가지로 적었습니다. 작은 문제에는 워크플로가 과하고, 생성된 마크다운을 리뷰하는 부담이 크며, 에이전트가 스펙의 지시를 자주 무시한다는 것입니다(Understanding Spec-Driven-Development, martinfowler.com, 2025-10-15). 마지막 우려가 바로 이 글이 불변식을 문서가 아니라 테스트에 두라고 한 이유이기도 합니다. velog의 Hybar는 DDD와 CQRS를 도입한 뒤 "구조적으로는 더 복잡해졌다"고 인정하면서, 지키려 한 것은 깔끔한 코드가 아니라 "변경의 방향과 책임의 경계"였다고 썼습니다(velog Hybar, 2026-05-04). DDD의 비용은 경계를 사는 값이고, 그 경계가 필요 없는 프로젝트에서는 값만 치르는 셈입니다.
DDD를 만든 에릭 에반스 본인도 결론을 내리지 않았습니다. 그는 DDD Europe 2026 기조연설 초록에 "AI가 DDD를 증폭할 것인가, 대체할 것인가? 지금은 알 수 없다. 앞으로 몇 년이 말해 줄 것이다"라고 쓰고, 자신의 작업 가설을 이렇게 밝혔습니다. "도메인 모델은 여전히 중요하고, 바운디드 컨텍스트는 여전히 중요하고, 언어는 여전히 중요하다. 다만 모델의 모습은 달라질 것이다"(Opening Keynote Eric Evans, DDD Europe 2026, 2026-06). 이 글의 세 지점은 그 작업 가설의 세 항목과 같습니다. 가설이라는 점도 같습니다.
경계가 흐려지는 것을 걱정하는 목소리도 있습니다. 바이브 코딩과 그 반대편을 꾸준히 구분해 온 개발자 사이먼 윌리슨은 2026년 5월, 코드를 안 보는 바이브 코딩과 책임지는 에이전틱 엔지니어링이 "내게도 이미 흐려지기 시작했고, 꽤 속상한 일"이라고 고백했습니다(Simon Willison, 2026-05-06). 에이전트가 좋아질수록 읽지 않고 받아들이고 싶은 유혹이 커지고, 그래서 사람이 아니라 구조와 테스트가 경계를 지켜야 합니다. 이벤트스토밍을 만든 알베르토 브란돌리니가 AI 시대의 DDD 워크숍 소개에 쓴 한 문장이 이 절의 결론으로 알맞습니다. "속도는 통제 없이는 쓸모없다"(AI-Powered Domain-Driven Design, Avanscoperta, 2026).
이 글의 자료를 고른 방법
이 글은 2026년 10월 6일에 확인한 자료로 썼습니다. 숫자는 Google, Anthropic, DORA, Veracode, Faros, Stack Overflow, METR의 발표문과 보고서 원문, 그리고 Fortune, TechCrunch, 디지털투데이의 보도에서 가져왔고, 각 페이지를 직접 열어 확인했습니다. JetBrains 2026 설문은 원문 대신 디지털투데이 보도를 출처로 달았습니다.
원문을 열지 못한 자료는 2차 출처를 밝혔습니다. GitClear 2026 보고서는 Sonar 블로그가 인용한 세 수치만 썼고, OpenAI의 Harness Engineering 글은 InfoQ 기사와 martinfowler.com의 뵈켈러 메모로 확인한 내용만 썼습니다. METR의 2025년 "19% 느려짐" 결과는 METR이 스스로 낡았다고 공지했으므로 후속 추정과 함께만 적었습니다. Stack Overflow 설문은 글을 쓰는 시점에 2026년판이 공개되지 않아 2025년 설문을 썼습니다.
국내 블로그와 커뮤니티 글은 용어 혼용, 검토 게이트, 경로별 규칙 같은 개인 경험으로만 소개했고, 숫자의 근거로는 쓰지 않았습니다. 국내 기업이 자체 측정한 효율 수치는 이 글의 논지에 필요하지 않아 뺐습니다. Three Dots Labs의 글은 2026년 10월 5일 긱뉴스에 번역이 올라와 국내에도 알려졌습니다. 이 글은 그 번역이 아니라, 같은 질문에 공식 데이터와 DDD 권위자의 발언, 국내 사례, 적용 절차를 더해 따로 쓴 것입니다.
최근 30일(2026-09-06에서 10-06)의 Hacker News, Lobsters, dev.to, Reddit, X, YouTube 토론은 따로 모아 실무자 목소리로만 썼습니다. 본문에 인용한 것은 원문 글이나 스레드를 직접 연 것이고, Reddit은 점수가 보이지 않아 본문에 링크하지 않았으며, 첼시 트로이의 발언은 YouTube 자동 자막을 옮긴 것이라 표기했습니다.
본문의 이미지는 직접 만든 차트 2개와 섬네일을 빼면 Anthropic, Veracode, martinfowler.com, Google Cloud의 원본 이미지이고, 해당 자료를 소개하려고 인용하면서 캡션에 출처를 달았습니다.
필자의 한계. 이 글의 수치는 각 기관이 측정한 값이고 필자가 통제 실험을 하지는 않았습니다. 용어집과 폴더 구조는 필자가 쓰는 형태를 글에 맞게 다듬은 것이고, 애그리거트와 린터 설정은 설명용 예시이며, 모든 프로젝트에 그대로 맞지는 않습니다.
자주 묻는 질문
DDD를 모르는데 어디서 시작하면 되나요?
용어집부터 시작하면 됩니다. 팀이 회의와 이슈에서 쓰는 단어를 표로 모아 뜻과 코드 이름, 쓰지 않는 말을 적는 것이 DDD의 유비쿼터스 언어이고, 이 한 장만으로도 에이전트의 이름 짓기가 달라집니다. 그다음에 같은 단어가 다른 뜻으로 쓰이는 지점이 보이면 그곳이 바운디드 컨텍스트의 경계입니다. 책은 그 뒤에 읽어도 늦지 않습니다.
작은 프로젝트나 혼자 하는 사이드 프로젝트에도 필요한가요?
CRUD 위주의 앱이나 한 번 쓰고 버릴 도구라면 필요 없습니다. 다만 "혼자 하는 프로젝트"라는 조건은 생각보다 약합니다. 에이전트가 코드의 대부분을 쓰는 순간 그 프로젝트에는 매 세션 새로 들어오는 동료가 생기는 것이고, 몇 주 뒤에 열어본 코드가 낯설었다는 국내 경험담이 그 비용입니다. 몇 달 이상 유지할 프로젝트라면 용어집과 불변식 테스트 두 가지는 넣어 두는 편이 결과적으로 빠릅니다.
CLAUDE.md와 AGENTS.md 중 어디에 써야 하나요?
도구에 따라 읽는 파일이 다르니, 팀이 쓰는 도구가 읽는 파일에 쓰면 됩니다. 중요한 것은 파일 이름이 아니라 내용의 종류입니다. 용어, 경계, 아키텍처 결정처럼 자주 바뀌지 않는 것만 넣고, 파일별 설명이나 자주 바뀌는 절차는 뺍니다. Claude Code 모범 사례와 토스 기술블로그의 기준이 같습니다. 자주 고치고 있다면 그 내용은 거기 있을 것이 아닙니다. 두 도구를 함께 쓴다면 한 파일을 다른 파일에서 참조하게 해 내용을 한곳에만 둡니다.
에이전트가 용어집을 무시하면 어떻게 하나요?
무시할 수 있다는 전제로 설계해야 합니다. 뵈켈러가 스펙 주도 개발의 우려로 꼽은 것이 바로 에이전트가 지시를 자주 무시한다는 점입니다. 그래서 반드시 지켜야 하는 규칙은 문서가 아니라 테스트와 린터로 옮깁니다. 용어집의 "쓰지 않는 말"은 린트 규칙으로, 불변식은 애그리거트의 테스트로, 컨텍스트 경계는 의존성 규칙으로 만들어 두면 에이전트가 무시해도 CI가 잡습니다. 문서는 에이전트가 처음부터 맞게 쓰도록 돕는 것이고, 테스트는 틀렸을 때 잡는 것입니다. 둘 다 필요합니다.
마치며
AI가 코드를 쓸수록 DDD가 중요해지는 이유를 한 줄로 줄이면 에이전트는 사람이 준 컨텍스트와 코드 구조만큼만 일하고, DDD는 그 컨텍스트와 구조를 만드는 가장 오래된 방법이라는 것입니다. 유비쿼터스 언어는 프롬프트의 어휘가 되고, 바운디드 컨텍스트는 컨텍스트 창의 단위가 되며, 애그리거트의 불변식은 테스트로 지키는 규칙이 됩니다. Google의 75%, DORA의 "증폭기", Veracode의 55%는 모두 그 세 가지가 없을 때 치르는 값을 보여 줍니다.
내일 할 일은 용어집 한 장입니다. 그다음에 손댈 컨텍스트 하나를 폴더로 자르고, 그 안의 불변식을 테스트로 옮기면 세 지점이 다 갖춰집니다. Stack Overflow 2026년 설문이 공개되거나 Evans의 기조연설 내용이 더 알려지면 이 글을 갱신하겠습니다. 에이전트에게 작업을 통째로 맡기고 완료 조건을 적는 방법은 Claude Opus 5.5 잘 쓰는 법에서 이어서 읽을 수 있습니다.
글쓴이
주홍철은 네이버 출신 개발자이자 AI 핀테크 스타트업 어비스(AVISS)의 대표입니다. 경제·증시 분석 AI, AI 에이전트, 데이터 파이프라인을 직접 설계하고 개발하며, 『면접을 위한 CS 전공지식 노트』와 『클로드 코드 제대로 시작하기』(길벗)를 썼습니다. 회사 소개는 어비스 홈페이지에, 다른 글은 어비스 블로그에 있으며, 글에 대한 정정 요청이나 문의는 [email protected]으로 보내 주세요.